

Python遍历列表时删除元素导致跳过或索引越界怎么解决
深入解析在Python中遍历列表同时删除元素引发的元素遗漏与IndexError索引越界问题,提供列表推导式、倒序索引删除、切片浅拷贝遍历及While循环等行之有效的解决方案与选型指南。
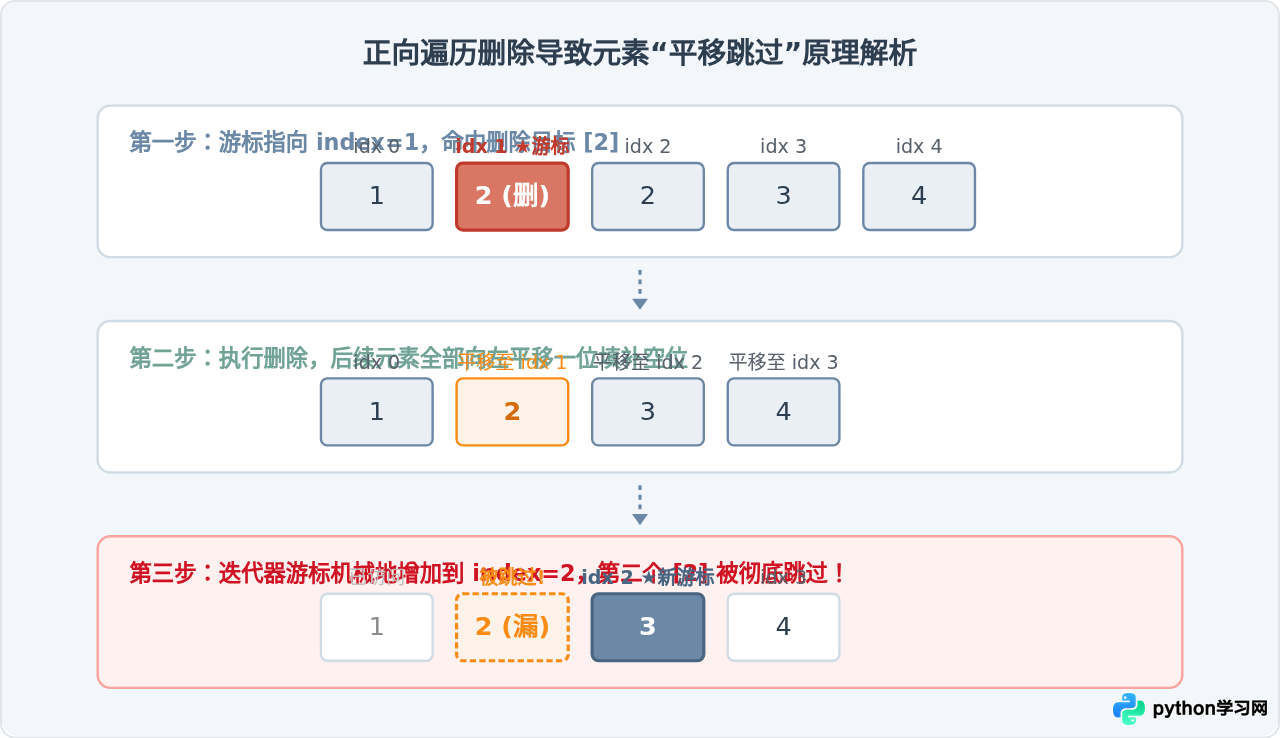
remove()、pop() 或 del 删除元素,是最容易引发 Bug 的操作之一。其核心原因在于:Python 列表是基于动态数组实现的连续内存结构,删除元素会使后续所有元素瞬间向前平移一位,而遍历迭代器的内部游标依然按步长累加向前移动。这会导致紧邻被删元素的下一个元素被直接“跳过”;若采用固定索引范围 range(len(lst)) 访问,则会在列表收缩后触发 IndexError: list index out of range 异常。解决该问题的标准策略包括:优先使用列表推导式生成新列表、通过倒序索引遍历实现安全的原地删除、基于浅拷贝切片遍历原列表,或使用 While 循环精准控制游标增减。
一、现象复现:为什么会跳过元素与报索引越界?
在日常开发中,许多初学者试图在循环中清理列表数据。常见的写法主要有两种:一种是直接使用 for item in list 进行迭代,另一种是使用 for i in range(len(list)) 依靠下标索引访问。下面分别演示这两种写法产生的异常现象。
1. 元素被跳过:连续目标项未能全部删除
假设我们需要从列表中删除所有值为 2 的偶数。直觉上的代码可能如下:
nums = [1, 2, 2, 3, 4]
for num in nums:
    if num == 2:
        nums.remove(num)

print("最终结果:", nums)
# 期望输出: [1, 3, 4]
# 实际输出: [1, 2, 3, 4] (第二个 2 被无情漏掉了!)
程序执行完成后,列表中居然还残留着一个 2。不仅没有报错,还悄无声息地得出了错误数据,这在业务逻辑中非常致命。
2. 索引越界:IndexError 崩溃的原因
有些开发者意识到 for item in list 可能会出现奇怪问题,于是转用基于下标的遍历方式:
nums = [10, 20, 30, 40]
for i in range(len(nums)):
    if nums[i] > 15:
        del nums[i]
运行上述代码会立即崩溃:
IndexError: list index out of range
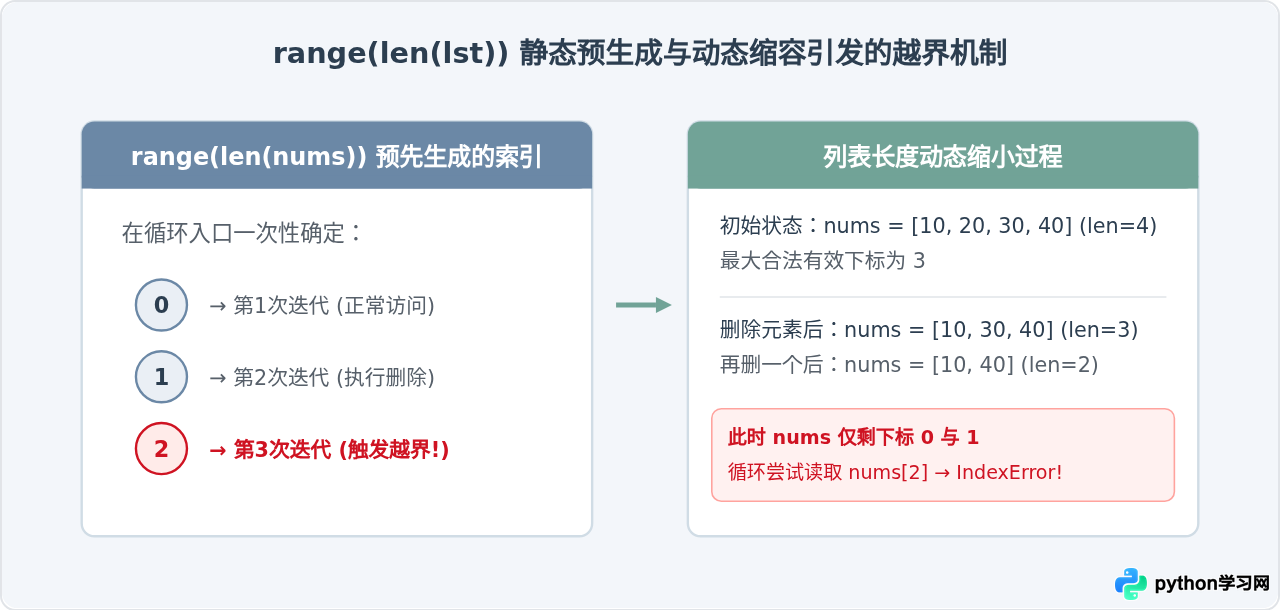
产生这个报错的原因在于:range(len(nums)) 仅在循环开启的那一瞬间被计算求值一次。当时 len(nums) 为 4,因此 range(4) 生成了序列 0, 1, 2, 3。然而在循环体内部,每次调用 del nums[i],列表的实际长度就会减 1。
二、核心解决方案与实操代码
解决该问题的核心原则只有一条:绝不在直接正向遍历原列表的同时修改原列表结构。根据业务是否需要“原地修改”,通常有以下四种成熟方案。
方案 1:列表推导式(强烈推荐,最 Pythonic)
在大多数场景下,我们并不强制要求在原内存地址上修改列表。换一个思路:与其“寻找不需要的并删除”,不如“筛选出需要保留的元素组成新列表”。
# 目标:剔除所有等于 2 的元素
nums = [1, 2, 2, 3, 4]

# 使用列表推导式重构
nums = [x for x in nums if x != 2]

print(nums)
# 输出: [1, 3, 4]for 循环配合 list.remove()。同时它消除了索引与游标不同步的问题,语义也更为声明式。
方案 2:倒序索引遍历(就地修改的最佳实践)
如果列表中包含大量数据、内存紧张,或者该列表被其他外部对象引用,必须实现真正的原地修改(In-place modification),最佳解法是从后往前倒序遍历删除。
为什么倒序删除有效?因为删除某个索引位置的元素时,只会引起其后方(更高索引)元素的左移;而位于其前方(更低索引)的元素位置绝对不会改变。我们向左移动游标,前方的索引永远是稳定可靠的。
nums = [1, 2, 2, 3, 4]

# 从最后一个索引递减到 0
for i in range(len(nums) - 1, -1, -1):
    if nums[i] == 2:
        del nums[i]

print(nums)
# 输出: [1, 3, 4]
也可以配合 reversed() 函数提高可读性:
nums = [1, 2, 2, 3, 4]

for i in reversed(range(len(nums))):
    if nums[i] == 2:
        del nums[i]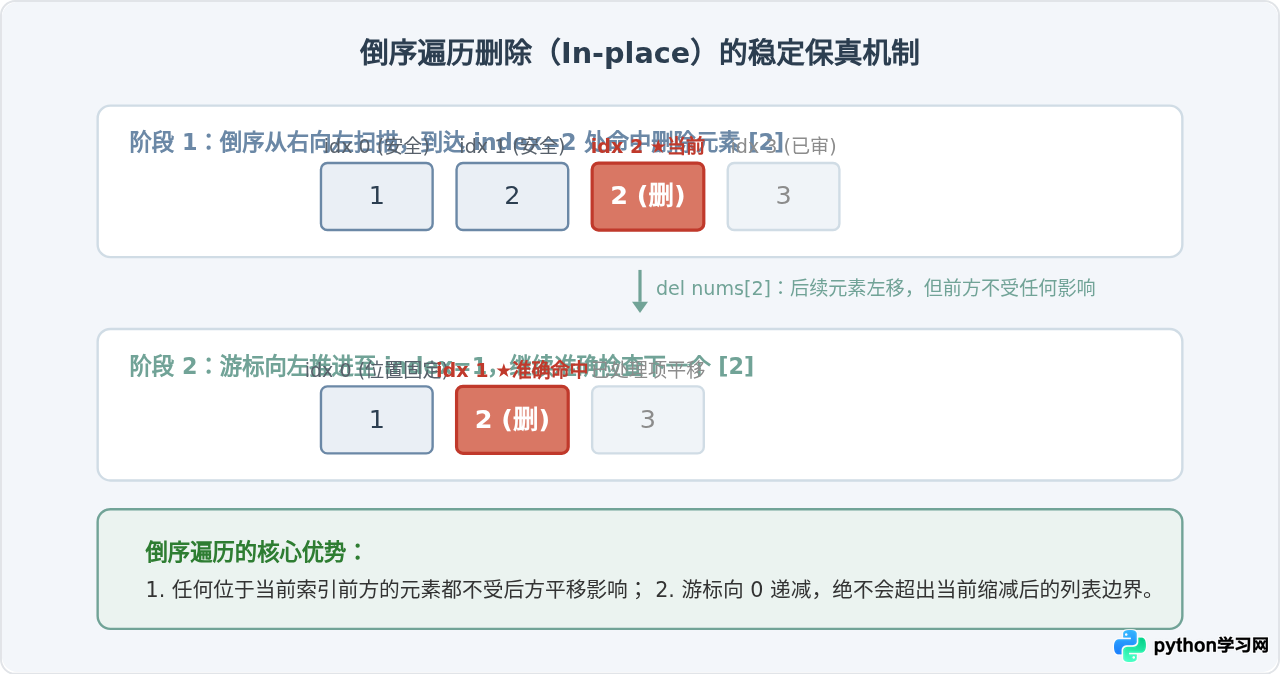
方案 3:遍历浅拷贝切片(简明直观)
如果你希望保持原本 for item in list 的语法形式,只需让循环遍历原列表的一个浅拷贝(如通过切片 [:] 或 .copy()),而删除操作直接作用于原列表:
nums = [1, 2, 2, 3, 4]

# 遍历切片创建的独立副本 nums[:],从原列表 nums 中安全删除
for num in nums[:]:
    if num == 2:
        nums.remove(num)

print(nums)
# 输出: [1, 3, 4]
运作机理:nums[:] 创建了一个临时副本,迭代器的内部游标行走在副本上,副本没有发生任何删除和平移;与此同时,nums.remove(num) 修改的是原列表。两者互不干扰。
list.remove(x) 每次调用都会从头到尾线性扫描匹配目标,在包含重复元素且列表较大时,时间复杂度会劣化到 $O(N^2)$。因此对于大列表,该方案效率不及列表推导式或倒序下标删除。
方案 4:While 循环手动控制游标步长
如果业务判断逻辑复杂,或者需要根据前后相邻元素的状态联合判断删除,可以使用 while 循环。
其关键规则在于:只有在未执行删除时,游标 i 才自增 1;一旦执行删除,游标 i 原地保持不动(因为下一个元素会自动平移到当前 i 位置):
nums = [1, 2, 2, 3, 4]
i = 0

while i < len(nums):
    if nums[i] == 2:
        del nums[i]  # 删除了当前项,后面元素补位至 i,因此 i 不变
    else:
        i += 1       # 只有保留当前项时,游标才前进

print(nums)
# 输出: [1, 3, 4]
三、方案选型与对比总结
在实际工程开发中,应根据数据量大小、是否要求原地修改、内存敏感度等条件进行合理选型。下表列出了四种主流方案的综合对比:
| 解决方案 | 是否原地修改 | 时间复杂度 | 空间复杂度 | 适用典型场景 |
|---|---|---|---|---|
| 列表推导式 | 否(生成新列表) | $O(N)$ | $O(N)$ | 日常代码首选,逻辑清晰,执行速度最快 |
| 切片浅拷贝遍历 | 是(需配 remove) | $O(N^2)$ | $O(N)$ | 小型列表、仅偶尔清理几个唯一值 |
| 倒序索引遍历 | 是(真正原地删除) | $O(N^2)$ 最差 | $O(1)$ | 内存敏感、需原地修改原有大对象、无额外内存开销 |
| While 动态游标 | 是(灵活自控) | $O(N^2)$ 最差 | $O(1)$ | 复杂联动判定条件、需动态跳步处理的场景 |
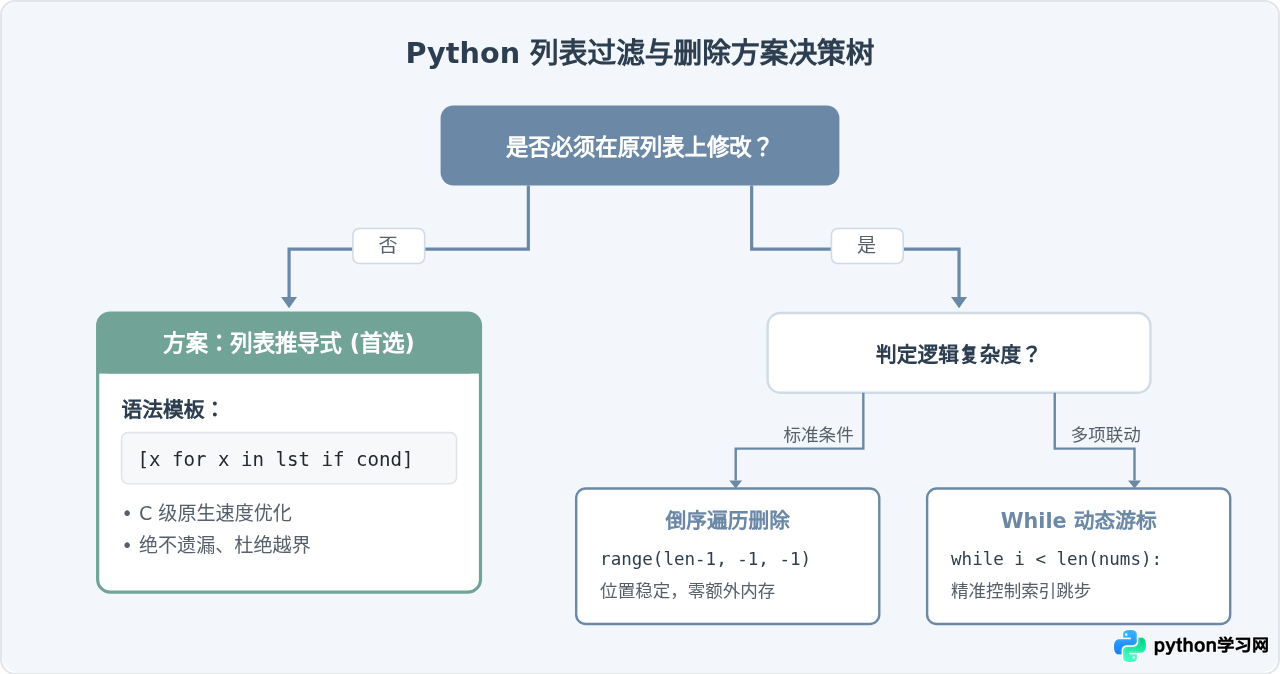
四、避坑指引与总结
在处理列表过滤与元素剔除任务时,请牢记以下开发习惯:
- 默认首选列表推导式:绝大多数场景根本不需要原地修改。写出
filtered_list = [x for x in original if condition]既健壮又易于他人阅读。 - 原地删除必须从后向前:如果必须修改原对象,切勿正向自增索引,使用
for i in range(len(lst)-1, -1, -1)可以彻底避免跳项与越界。 - 警惕
list.remove()的二重开销:在循环内部频繁调用remove()会造成 $O(N^2)$ 的时间开销,数据量过万时可能会导致程序严重卡顿。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









