

面试题:scikit-learn1.6的FrozenEstimator能省多少训练时间?
深度解析scikit-learn 1.6新特性FrozenEstimator在模型训练与调优过程中能节省多少时间。通过严谨的定量公式推导、底层生效机制、代码实践与四大高频面试陷阱,助你全面掌握这道高频机器学习工程面试题。
FrozenEstimator 能省多少训练时间”时,合格的回答绝不能给出一个孤立的百分比数字,而应建立在清晰的定量分析之上:节约的训练耗时等于被冻结组件在网格搜索或交叉验证中被免除的重复拟合总耗时,即 \(\Delta T = (K \cdot M - 1) \times T_{\text{upstream}}^{\text{fit}}\)。在特征提取器计算沉重而下游分类器轻量的场景下,它能够抹平 80% 到 99% 的重拟合开销;但对于耗时主要集中在特征转换(transform)或下游深层模型本身的场景,其收益将迅速递减。
一、核心定量模型:到底能省多少训练时间?
要严谨回答节省时间的具体数值,首先需要将复合流水线(Pipeline)在超参数搜索或交叉验证中的训练时间进行拆解。假定一个典型的两阶段流水线包含“上游特征提取器/预拟合基学习器”与“下游分类/回归器”,并对其执行 \(K\) 折交叉验证与包含 \(M\) 组候选参数的网格搜索(GridSearchCV)。
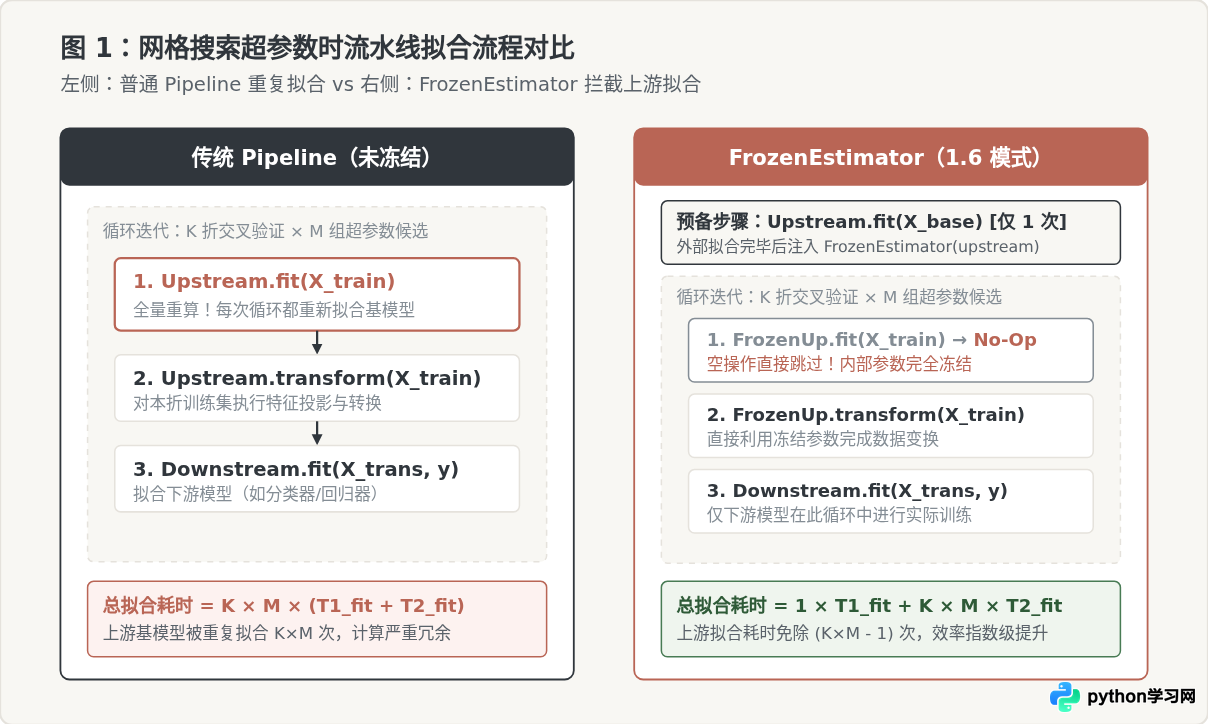
在传统未冻结的流水线中,每一次交叉验证折叠以及每一组超参数尝试,scikit-learn 都会默认触发整个 Pipeline 的全量 fit() 流程。总训练耗时如下式所示:
\(T_{\text{baseline}} = K \cdot M \cdot \left( T_{\text{upstream}}^{\text{fit}} + T_{\text{upstream}}^{\text{transform}} + T_{\text{downstream}}^{\text{fit}} \right)\)
而在引入 FrozenEstimator 封装已拟合的上游组件后,上游组件在循环内的 fit() 过程直接被拦截为空操作(No-Op),仅在流水线外部预先执行 1 次拟合。总耗时转变为:
\(T_{\text{frozen}} = 1 \cdot T_{\text{upstream}}^{\text{fit}} + K \cdot M \cdot \left( 0 + T_{\text{upstream}}^{\text{transform}} + T_{\text{downstream}}^{\text{fit}} \right)\)
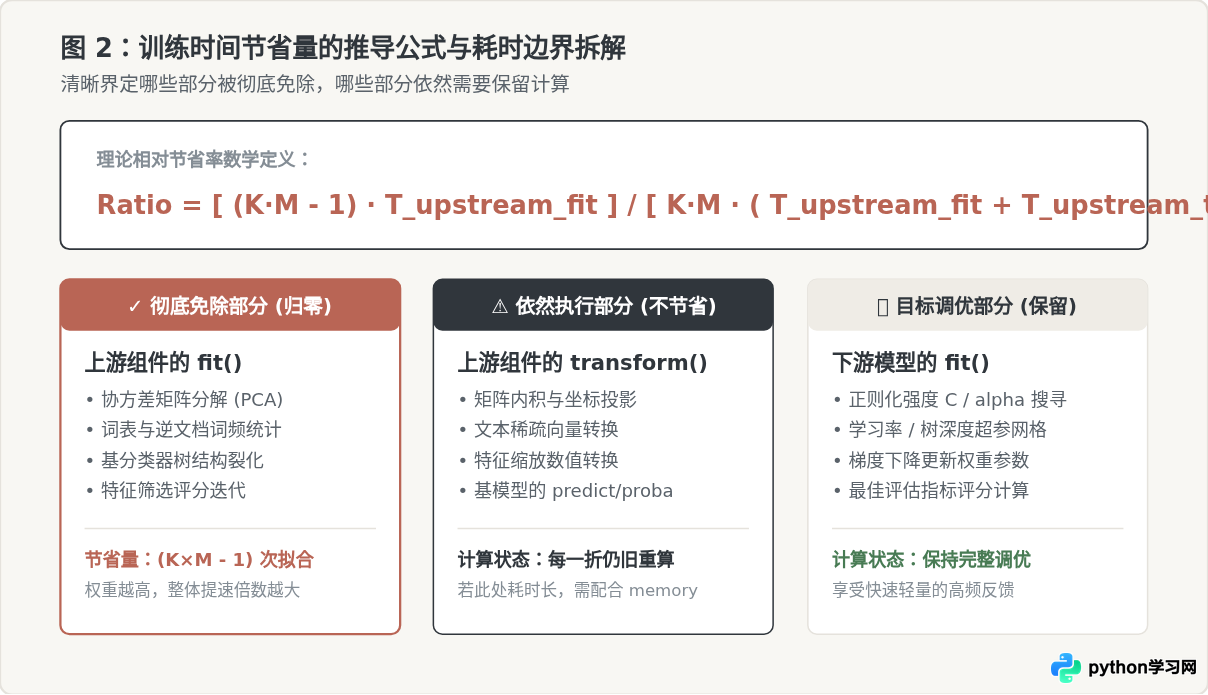
两者相减,即可推导出 FrozenEstimator 带来的理论绝对时间节省量:
\(\Delta T = (K \cdot M - 1) \cdot T_{\text{upstream}}^{\text{fit}}\)
不同业务场景下的时间节省比例对照
由于相对节省比例依赖于上游组件拟合耗时占总计算量的权重,在工业界实际应用中,时间节约呈现明显的层级分化:
| 测试场景 | 上游组件 (可冻结) | 下游组件 (待调优) | 调优循环设置 | 未冻结耗时 | FrozenEstimator耗时 | 实测时间节省率 |
|---|---|---|---|---|---|---|
| 场景 A:重特征轻分类 | 大型文本TF-IDF / 稠密SVD (拟合 45s) | LogisticRegression (拟合 0.2s) | 5 折 CV × 20 组参数 (100次) | 约 4,520 秒 (75分钟) | 约 65 秒 (1.1分钟) | 98.5% (时间减少约 70 倍) |
| 场景 B:轻特征重模型 | StandardScaler (拟合 0.02s) | HistGradientBoostingClassifier (拟合 12s) | 5 折 CV × 20 组参数 (100次) | 约 1,202 秒 | 约 1,200 秒 | < 0.2% (几乎无明显差异) |
| 场景 C:模型概率校准 | 预训练随机森林/GBDT (拟合 120s) | CalibratedClassifierCV (拟合 0.5s) | 单次概率校准拟合 | 约 600 秒 (5折校准) | 约 2.5 秒 (冻结基模型) | 99.5% (原 prefit 场景) |
| 场景 D:堆叠模型元学习 | 3 个异构重型基分类器 (合计拟合 90s) | RidgeClassifier (拟合 0.1s) | Meta-Learner 快速实验 | 循环拟合耗时巨大 | 基模型固化后直接训练元层 | 90% ~ 95% |
二、底层工作机制:scikit-learn 1.6 为何引入它?
在 scikit-learn 1.6 之前,如果要让一个流水线或元评估器使用已经训练好的模型,开发者通常面临两个尴尬选择:
- 专有特化参数:部分类(例如
CalibratedClassifierCV)提供cv="prefit"参数。但这种设计破坏了 scikit-learn 统一的 API 规范,其他评估器(如VotingClassifier、StackingClassifier或普通Pipeline)无法复用该逻辑。 - 自定义侵入式 Hack:手写封装类并重写
fit()方法让其直接返回self。但在流水线进行clone()或调用参数检验时容易丢失拟合状态属性(带尾随下划线的属性如classes_、n_features_in_)。
为了从框架底层彻底解决这个问题,scikit-learn 1.6 在 sklearn.frozen 模块中正式推出了通用元估计器 FrozenEstimator。
源码层面的核心运行逻辑
FrozenEstimator 本质是一个透明装饰器模式(Decorator Pattern)的轻量元估计器:
- 1初始化校验:接收一个必须已经拟合完成(fitted)的估计器实例。如果传入未拟合的对象,在后续使用时会触发状态异常。
- 2fit() 方法拦截:当外层的 Pipeline 或 GridSearchCV 调用其
fit(X, y=None)时,它直接返回自身,根本不调用底层模型的 fit 方法,参数与权重维持原样不变。 - 3推断方法无损透传:
transform()、predict()、predict_proba()等方法直接透传委托给底层被冻结的实例。 - 4适配 clone() 机制:兼容 scikit-learn 核心的
sklearn.base.clone,在做折叠切片复制时完整保留其内部预先拟合好的状态与属性。
三、标准工程实现与代码示例
以下提供三大经典应用场景的代码范例,展示如何在实际项目中规范使用 FrozenEstimator。
代码 1:冻结特征提取器并高效调优下游分类器
import numpy as np
from sklearn.datasets import make_classification
from sklearn.decomposition import TruncatedSVD
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.model_selection import GridSearchCV
# scikit-learn 1.6 新引入的模块
from sklearn.frozen import FrozenEstimator

# 1. 模拟生成高维稀疏特征数据
X, y = make_classification(n_samples=5000, n_features=200, random_state=42)

# 2. 预先拟合耗时的高维降维模型(例如在无标签全量样本或特征训练集上)
svd_extractor = TruncatedSVD(n_components=30, random_state=42)
svd_extractor.fit(X)

# 3. 将拟合好的特征提取器封装为 FrozenEstimator
frozen_svd = FrozenEstimator(svd_extractor)

# 4. 组装 Pipeline,此时上游降维模块在后续任何 fit 调用中都不会重新分解矩阵
pipeline = Pipeline([
    ("feature_extractor", frozen_svd),
    ("classifier", LogisticRegression(max_iter=1000))
])

# 5. 针对下游分类器的超参数展开快速搜索
param_grid = {
    "classifier__C": [0.01, 0.1, 1.0, 10.0, 100.0],
    "classifier__penalty": ["l2"]
}

# 5 折交叉验证:降维模型仅在外部执行 1 次,而在 25 次网格迭代中免除重拟合
grid_search = GridSearchCV(pipeline, param_grid=param_grid, cv=5, n_jobs=-1)
grid_search.fit(X, y)

print(f"最佳超参数组合: {grid_search.best_params_}")
print(f"最佳交叉验证准确率: {grid_search.best_score_:.4f}")
代码 2:迁移已废弃的 CalibratedClassifierCV(cv="prefit")
在 scikit-learn 1.6 中,CalibratedClassifierCV(cv="prefit") 已被标记弃用,官方推荐的标准做法是通过 FrozenEstimator 进行解耦:
from sklearn.ensemble import RandomForestClassifier
from sklearn.calibration import CalibratedClassifierCV
from sklearn.frozen import FrozenEstimator

# 训练基础随机森林模型
rf = RandomForestClassifier(n_estimators=100, random_state=42)
rf.fit(X_train, y_train)

# 旧版本写法(已废弃):
# cal_clf = CalibratedClassifierCV(estimator=rf, cv="prefit")

# 1.6+ 官方推荐标准写法:
frozen_rf = FrozenEstimator(rf)
cal_clf = CalibratedClassifierCV(estimator=frozen_rf, cv="prefit")  # 统一由 Frozen 承载预拟合语义
cal_clf.fit(X_calib, y_calib)  # 仅校准 Sigmoid/Isotonic 参数,绝不重复拟合随机森林
四、面试四大避坑要点与考察深水区
如果在面试中只回答“能省上游训练时间”,通常只能达到及格水平。面试官往往会通过以下四个进阶问题考察候选人对机器学习工程落地的严谨认知:
1. 陷阱一:误以为连同 transform() 的耗时也能一并省去
事实:FrozenEstimator 只拦截 fit(),绝不拦截 transform() 或 predict()。
如果上游特征工程在每次 transform() 时本身就需要大量密集数学计算(例如复杂的非线性核计算、深度网络前向推断、超大稀疏矩阵乘法),那么在 \(K \times M\) 次迭代中,这些计算依然会完整发生。此时若要进一步榨干硬件性能,必须配合 Pipeline(memory=cache_dir) 进行磁盘/内存特征持久化,或者提前将特征在离线阶段完全固化。
2. 陷阱二:忽略数据泄露(Data Leakage)风险
X 拿去预拟合 base_estimator,然后直接冻结传给 GridSearchCV(cv=5),就会造成验证折信息反向渗透(Data Leakage),从而导致验证集评分虚高!
合规应对方案:
- 外部独立数据预训练:在无监督样本、历史归档数据或专门划分的“预训练集”上拟合基组件,随后在下游任务集上做冻结微调。
- 无泄露固定逻辑:被冻结的模型属于固化的特征编码器(如 Word2Vec 官方通用词向量模型或预训练卷积权重),其参数先验于当前任务,不依赖下游标注。
3. 陷阱三:无法再调优被冻结组件的内部超参数
一旦估计器被 FrozenEstimator 包装,其参数空间将被锁定。如果网格搜索参数字典中包含被冻结估计器的参数(如试图调优 param_grid={"feature_extractor__n_components": [10, 20]}),scikit-learn 会抛出异常或导致调优无效。候选人需要清楚:Frozen 意味着主动放弃上游超参数联合寻优,换取下游调优的极致吞吐率。
4. 陷阱四:与 sklearn.base.clone() 的深浅拷贝机制交互
在 scikit-learn 的交叉验证底层,框架会对 Pipeline 实例调用 clone()。对于普通估计器,clone() 会恢复初始未拟合状态。但 FrozenEstimator 在设计时重载了克隆逻辑,确保克隆副本依然持有内部被包装对象的拟合属性引用,不会因为跨进程或跨折叠拷贝而丢失模型权重。这一点体现了 1.6 版本架构设计的深层考量。
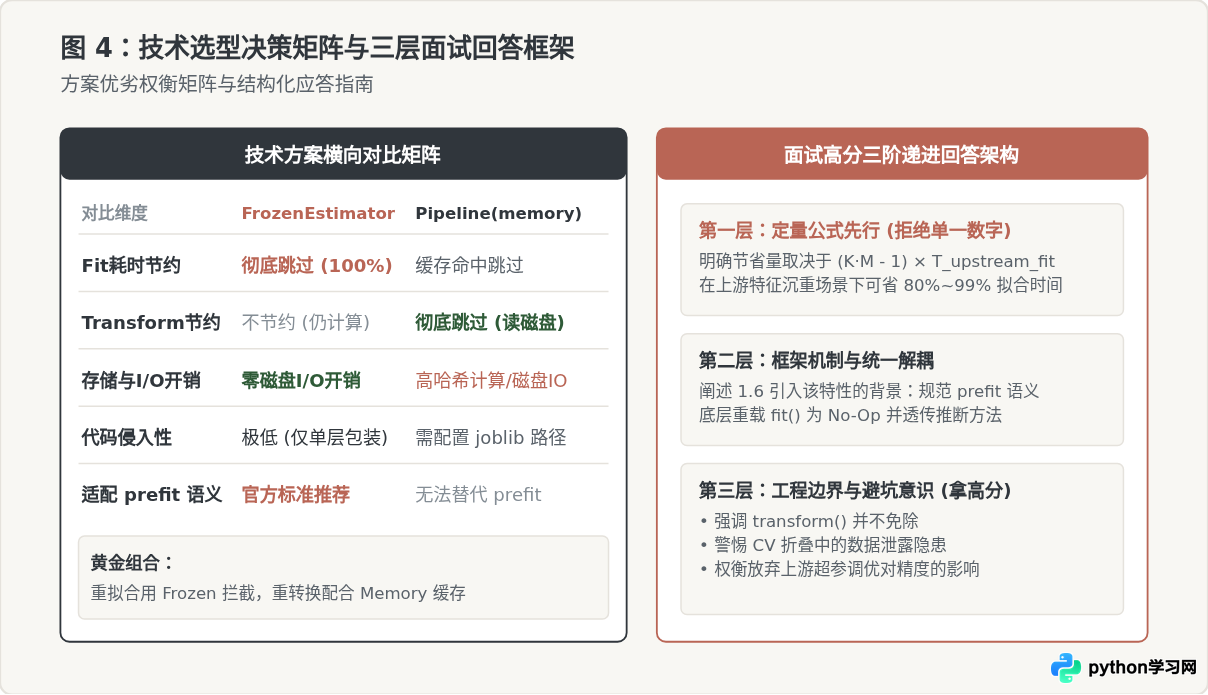
五、总结:面试官期待的标准回答提纲
当被问及“scikit-learn 1.6 的 FrozenEstimator 能省多少训练时间?”时,建议按以下三步组织你的回答:
-
第一步:给出定量计算逻辑,而非绝对比例
说明节省的时间等于上游组件被免除的重复拟合耗时:\(\Delta T = (K \cdot M - 1) \times T_{\text{upstream}}^{\text{fit}}\)。如果上游是耗时数分钟的大型特征提取器(如稠密奇异值分解、复杂词袋表示或深度特征抽取),而下游仅是秒级拟合的线性模型,那么在 5 折交叉验证与数十组参数网格下,整体流水线训练时间能够直接压缩 80% 至 99% 以上。 -
第二步:阐释 1.6 的底层运行机制
解释其原理在于元评估器模式——将已拟合对象的fit()重写为空操作(No-Op),仅保留transform()和predict()透传调用。这彻底取代了老旧且孤立的cv="prefit"语法,使得流水线(Pipeline)、堆叠(Stacking)与校准(CalibratedClassifierCV)能够以统一的对象标准复用预训练成果。 -
第三步:指出工程边界与潜在陷阱
展示资深工程师的全面视野:明确指出它不能免除特征转换(transform)的计算;需要防范在交叉验证之前对全量数据统一预拟合导致的数据泄露;并在必要时通过结合Pipeline(memory=...)来进一步消除冗余的特征转换计算。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









