

Python同时获取字典的key、value和遍历序号
本文详细讲解在Python中如何使用enumerate结合dict.items()同时获取字典的键(key)、值(value)以及遍历序号,深入剖析元组解包原理、常见报错原因及自定义起始序号等实用技巧。
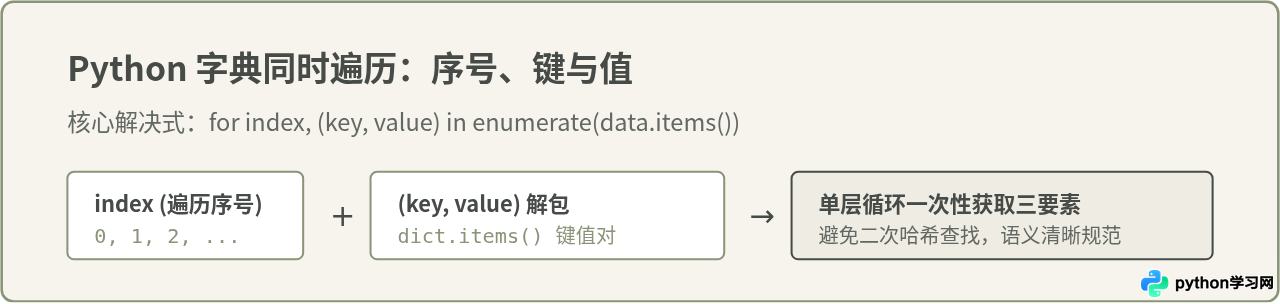
enumerate() 与字典方法 .items() 结合,并配合双层解包语法:for i, (k, v) in enumerate(my_dict.items()):。
1. 核心写法与直接示例
日常开发中,我们常常需要按顺序展示字典内容,例如生成带序号的表格、打印操作日志或记录批处理进度。此时只取 key 和 value 无法得知当前处理到第几项,单独维护计数变量又显得繁琐。
下面的代码演示了最标准的实现方式:
# 待处理的用户配置数据
user_profile = {
    "username": "alex_2026",
    "role": "administrator",
    "status": "active",
    "region": "ap-northeast-1"
}

# 同时获取遍历序号 i、键 k、值 v
for i, (k, v) in enumerate(user_profile.items()):
    print(f"[{i}] 属性名称: {k} -> 属性数值: {v}")
示例输出如下:
[0] 属性名称: username -> 属性数值: alex_2026
[1] 属性名称: role -> 属性数值: administrator
[2] 属性名称: status -> 属性数值: active
[3] 属性名称: region -> 属性数值: ap-northeast-1
在这段代码中,i 自动从 0 递增,k 对应每次迭代的键,v 对应键的值。代码没有引入额外的外部计数器,逻辑清晰且完全符合Python惯用法。
2. 深入理解:为什么必须加上圆括号 (k, v)?
初学者最容易犯的一个书写错误,是漏掉 k, v 两侧的括号,写成:
# 错误示例:缺少圆括号
for i, k, v in enumerate(user_profile.items()):
    print(i, k, v)
运行该语句会立刻抛出异常:ValueError: not enough values to unpack (expected 3, got 2)。
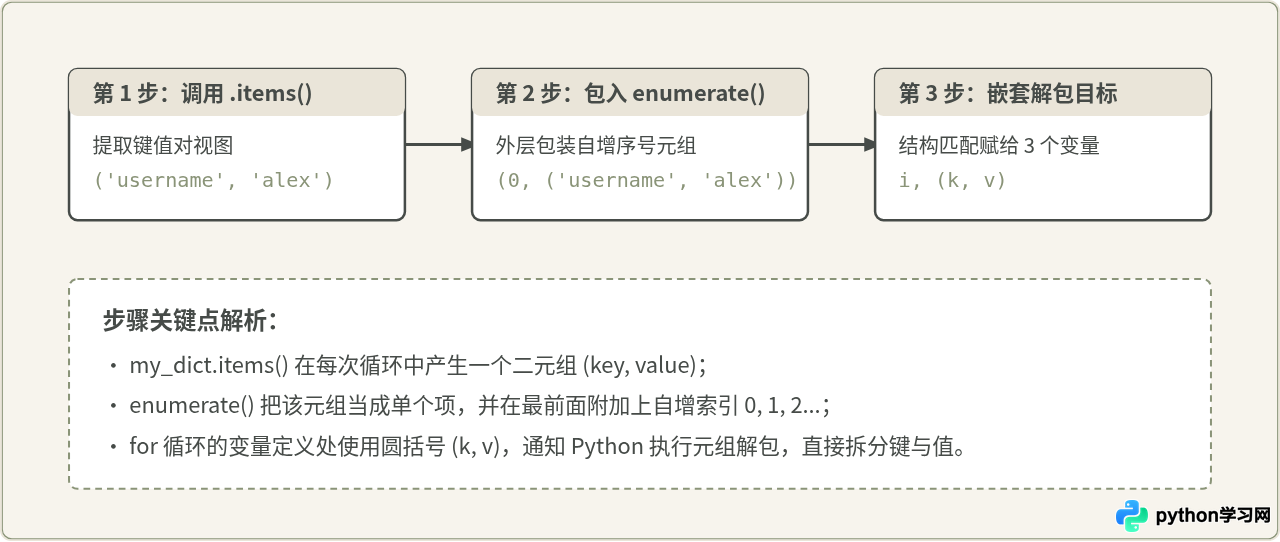
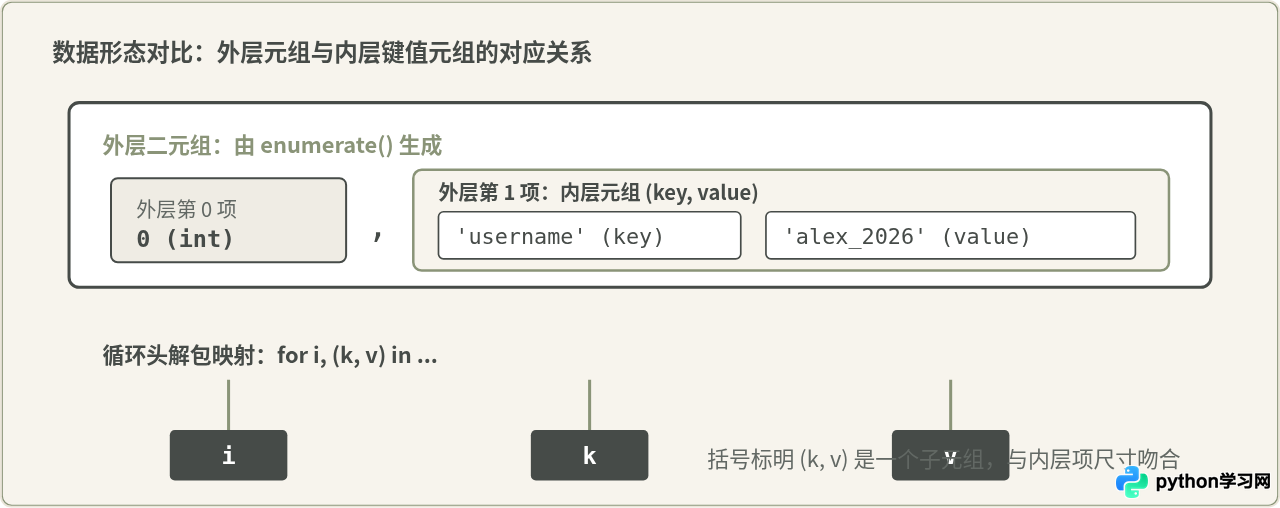
要理解这个报错,需要明确 enumerate() 返回的数据结构。enumerate(iterable) 在每次迭代时,固定返回一个长度为 2 的元组:(序号, 元素)。
当传入 user_profile.items() 时,它的每个“元素”本身就是一个元组 (键, 值)。因此,enumerate() 实际产出的完整结构是一个嵌套元组:
# enumerate(user_profile.items()) 实际生成的单项形态:
(0, ('username', 'alex_2026'))
如果写 for i, k, v in ...,Python会尝试将外层元组解包成 3 个独立变量。但外层元组实际上只有两个元素——第一项是整数 0,第二项是二元元组 ('username', 'alex_2026')。于是解释器发出抱怨:期望解出 3 个值,但实际只有 2 个(即 expected 3, got 2)。
3. 易混写法辨析与性能考量
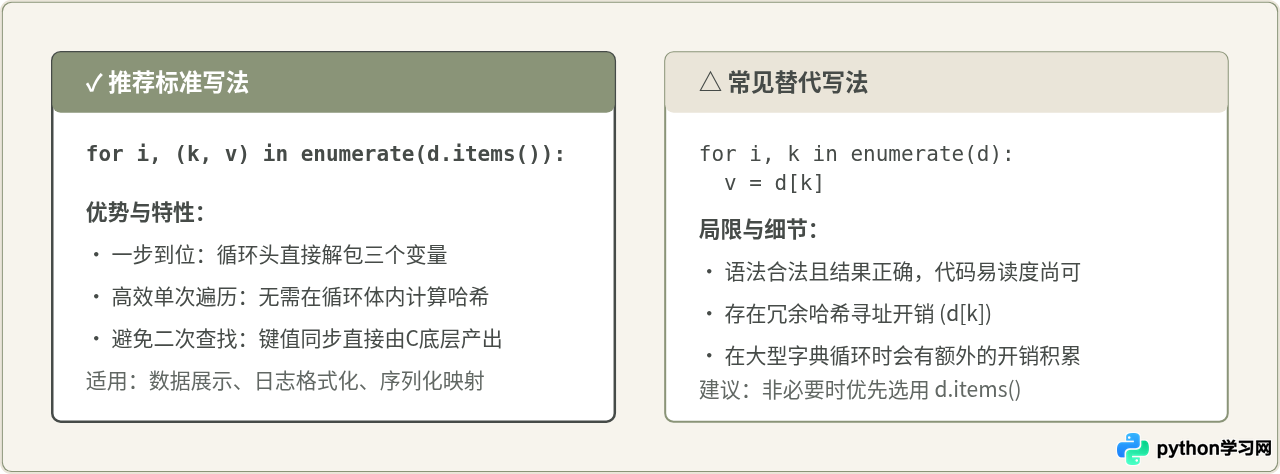
在社区讨论和一些老旧代码中,常能见到另一种同时获取三者的方式:直接对字典键使用 enumerate(),在循环体内部通过 dict[key] 来取值。
# 常见替代写法:先遍历键与序号,再二次取值
for i, k in enumerate(user_profile):
    v = user_profile[k]  # 二次哈希寻址
    print(i, k, v)
这种写法是否成立?
从功能上看,这种写法完全能够输出正确结果。在Python中直接遍历字典对象 user_profile 等同于遍历 user_profile.keys(),enumerate() 会为每个键绑定序号。因此 i 和 k 能够正常取得,随后的 user_profile[k] 也能顺利查出对应的值。
为什么推荐 enumerate(d.items())?
- 减少哈希查找开销:在
user_profile[k]发生时,Python必须计算键的哈希值、处理可能的哈希碰撞并在字典底层结构中寻址。而d.items()已经在迭代底层哈希表条目时直接拿到了值指针,无需额外的查找动作。在大型字典循环中,性能更优。 - 代码意图更聚焦:直接在循环头部完成解包,将数据准备工作收束在一处。循环体内部即可纯粹用于业务逻辑,避免在多处散落
dict[k]。
4. 实用进阶技巧:自定义起始序号
在面向用户的展示、报告打印或清单输出场景中,人类习惯阅读从 1 开始的序号,而非计算机中默认的 0。
enumerate() 内置了 start 参数,可以直接指定起始计数,无需在循环内部写 i + 1:
servers = {
    "node-01": "192.168.1.10",
    "node-02": "192.168.1.11",
    "node-03": "192.168.1.12"
}

# 从序号 1 开始计数
for rank, (name, ip) in enumerate(servers.items(), start=1):
    print(f"第 {rank} 台服务器: {name} (IP: {ip})")
示例输出如下:
第 1 台服务器: node-01 (IP: 192.168.1.10)
第 2 台服务器: node-02 (IP: 192.168.1.11)
第 3 台服务器: node-03 (IP: 192.168.1.12)
enumerate() 获取的序号 0, 1, 2... 将严格对应字典键值对首次被写入时的物理顺序。但在逻辑上,字典仍然是映射类型而不是序列类型,不支持 user_profile[0] 这类数字下标索引操作。
5. 总结与快速速查
同时获取字典的序号、键、值本质上是“内置枚举函数”与“元组解包机制”的有机组合。下面这张速查图汇总了核心模式、参数要点及排错检查项:
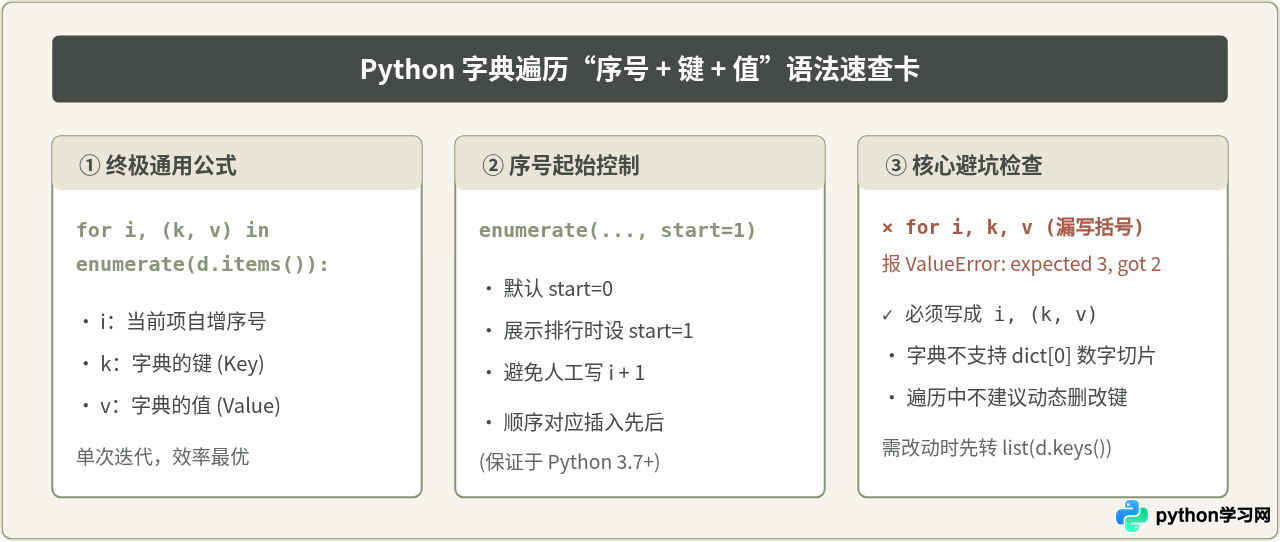
牢记核心语法 for i, (k, v) in enumerate(d.items()):,既能保持代码的紧凑优美,又能规避多余的查询与潜在的解包异常。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









