

python必背源代码遍历文件夹os.walk代码
深入解析Python必背源代码:使用os.walk遍历文件夹的标准模板与底层机理。详细说明(root, dirs, files)三元组解构、os.path.join跨平台拼接、topdown动态剪枝以及与pathlib的对比选型。
在 Python 中遍历多层嵌套的文件夹时,最通用且稳健的标准解决方案是使用 os.walk()。它是一个内置生成器,能够自动完成深层目录树的递归展开。开发者不需要自己编写任何递归函数或栈队列,只需在一个简单的 for 循环中解构出 (root, dirs, files) 三元组,配合 os.path.join() 即可安全获取每一个文件的规范完整路径。
一、标准必背源代码模板
下面这段代码是 Python 工程师处理文件批处理、数据清洗、静态资源归档时出现频率最高的标准骨架:
import os

# 1. 指定目标扫描根目录(推荐使用原始字符串 r"..." 防止 Windows 转义)
target_dir = r"./my_workspace"

# 2. 核心必背遍历模板
for root, dirs, files in os.walk(target_dir):
    for file in files:
        # 必须通过 os.path.join 动态拼接完整绝对或相对路径
        file_path = os.path.join(root, file)
        print(file_path)
很多初学者会尝试使用 os.listdir() 自己写递归函数遍历多层目录,但自己写递归极易遇到死循环、符号链接软链接环路、目录递归深度超过最大调用栈(RecursionError)以及 Windows/Linux 斜杠不兼容等问题。os.walk() 在底层以迭代方式实现,内存开销恒定,无论目录嵌套多少层都能稳定运行。
二、解构三元组:root、dirs 与 files 的真实含义
在每次循环迭代时,os.walk() 都会 yield 一个由三个元素构成的元组 (root, dirs, files)。理解这三者的具体数据结构是避免常见 Bug 的前提:
root(str):当前正在被访问的目录路径。如果传入的target_dir是相对路径,root就是相对路径;如果是绝对路径,root就是绝对路径。dirs(list[str]):当前root文件夹下包含的所有一级子目录名(纯名称,不含路径)。此列表不仅反映当前目录结构,还具备动态修改剪枝的特权。files(list[str]):当前root文件夹下包含的所有非目录文件名(纯文件名,如data.csv,同样不含路径)。
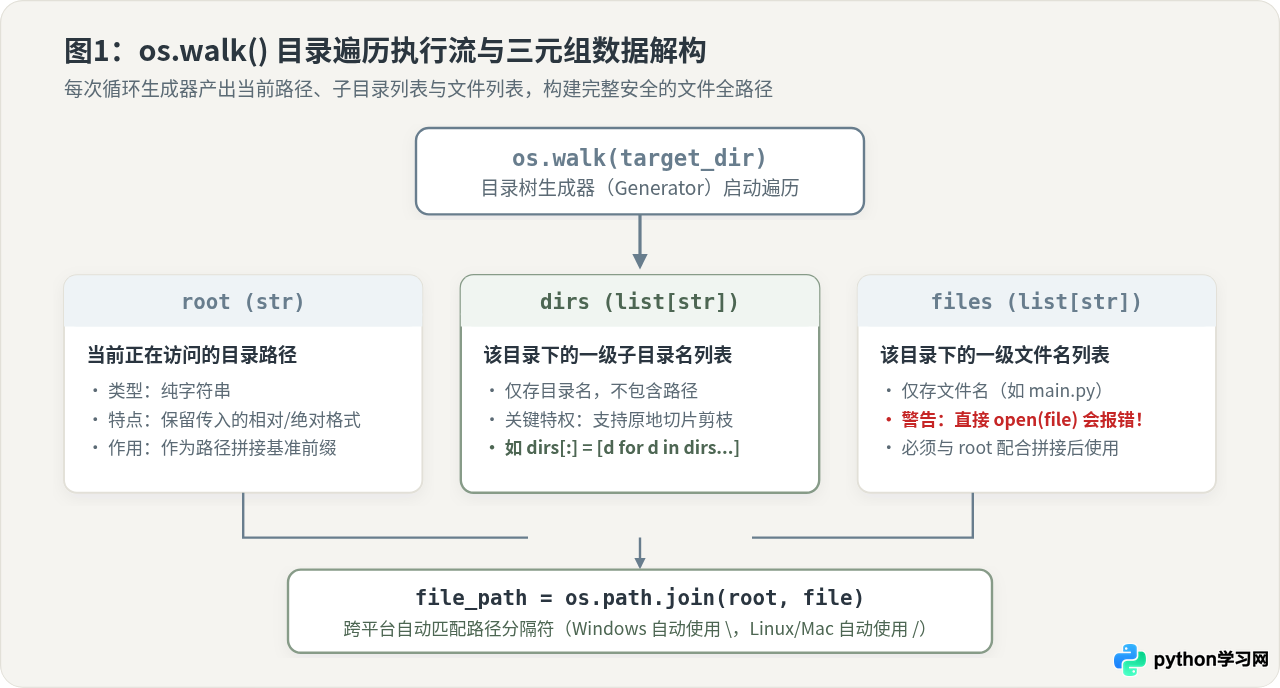
files 列表中存储的只是纯文件名(如 ['config.ini', 'app.py']),并没有附带上级目录信息。如果在循环中直接执行 open(file),Python 会在“当前工作目录(Current Working Directory)”查找该文件,而非该文件实际所在的子目录,从而抛出 FileNotFoundError。因此,任何对文件的 I/O 操作都必须先经过 os.path.join(root, file) 拼接!
三、核心机制与关键对比:topdown 参数与动态剪枝
os.walk() 拥有一个极其关键的布尔参数 topdown,默认值为 True。很多人在使用时忽略了这个参数,但它直接决定了遍历时序以及是否具备原地剪枝能力。
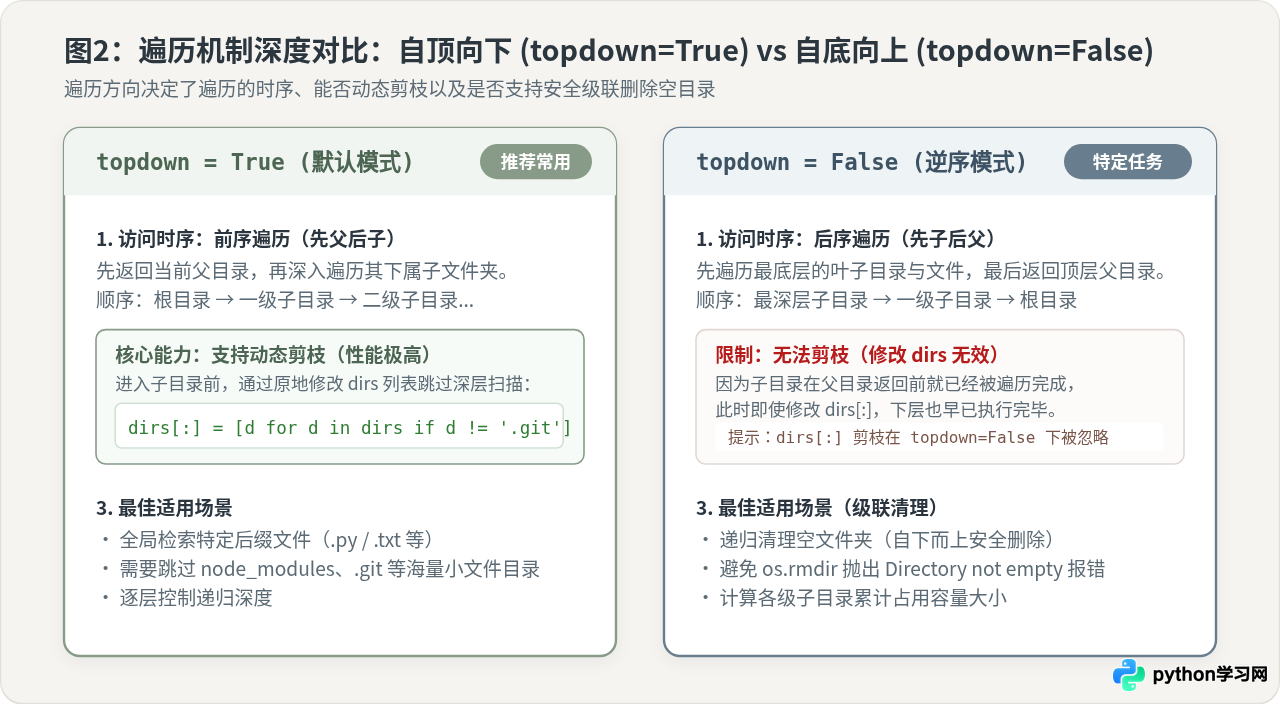
1. 自顶向下模式 (topdown=True,默认):支持切片赋值剪枝
在默认的 topdown=True 模式下,算法采用前序遍历,先访问顶层父目录,再访问其内部子目录。在访问父目录时,Python 尚未深入其下属的子目录,这赋予了我们一个巨大的能力:通过原地修改 dirs 列表直接跳过不想访问的目录分支。
在大型工程或爬虫项目中,通常存在 .git、__pycache__、node_modules 或大型临时日志缓存文件夹,内部可能嵌套了成千上万个无用的小文件。如果全部扫描,I/O 开销极大。此时必须使用切片赋值进行动态剪枝:
import os

for root, dirs, files in os.walk(r"./my_project", topdown=True):
    # 关键:使用切片赋值 [:] 原地修改 dirs 列表
    # 排除所有不需要下钻扫描的文件夹名称
    dirs[:] = [d for d in dirs if d not in {'.git', '__pycache__', 'node_modules', '.venv'}]

    for file in files:
        full_path = os.path.join(root, file)
        print("处理文件:", full_path)
dirs 是 os.walk 传递给外层循环的同一个列表对象的引用。如果写成 dirs = [...],只是在当前循环体内创建了一个新的局部变量引用,原本在 os.walk 生成器内部维护的目录队列并没有被改变,生成器仍然会毫无阻碍地遍历 .git 等文件夹。只有通过切片赋值 dirs[:] = [...],才能在原地修改列表内存块,真正实现让生成器跳过指定子树!
2. 自底向上模式 (topdown=False):安全级联删除空目录
如果将 topdown 设置为 False,算法将切换为后序遍历。它会先深入遍历最底层的叶子节点文件与子目录,最后才回溯返回顶层父目录。
在 topdown=False 模式下,修改 dirs 无法达到剪枝目的(因为下层子目录早已在上一轮迭代中访问完毕)。但它拥有另一个不可替代的场景:自下而上清理空文件夹。在操作系统中,直接调用 os.rmdir() 删除非空目录会抛出 OSError: Directory not empty 错误;而自底向上遍历保证了子文件和子文件夹先被删除,父目录变成空目录后即可被安全移除:
import os

# 递归清理目录下的所有空文件夹
for root, dirs, files in os.walk(r"./temp_dir", topdown=False):
    for sub_dir in dirs:
        dir_path = os.path.join(root, sub_dir)
        # 如果当前子目录内部已为空,安全删除
        if not os.listdir(dir_path):
            os.rmdir(dir_path)
            print("已安全移除空目录:", dir_path)
四、实战演练:真实目录树遍历追踪
为了让读者直观理解代码执行过程中的每一轮变量变化,假设存在如下真实文件结构:
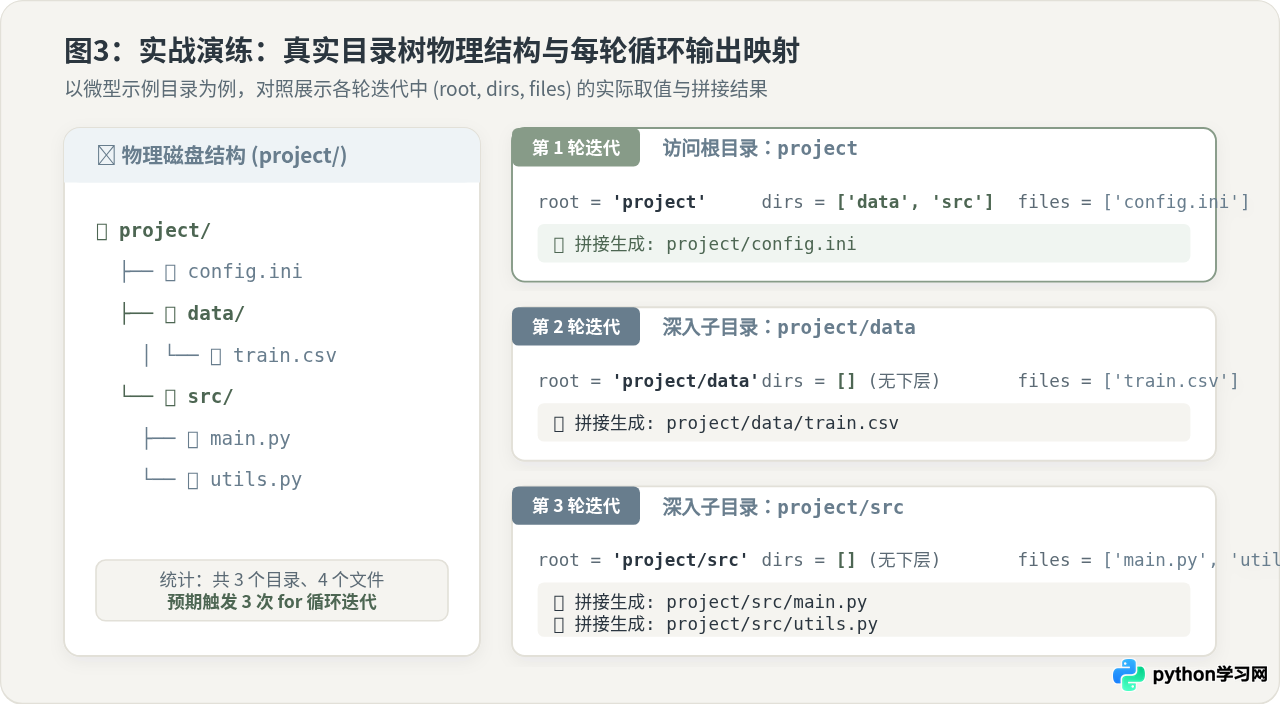
当执行 for root, dirs, files in os.walk('project'): 时,三轮循环的具体执行状态如下表所示:
| 迭代轮次 | 当前 root 取值 | dirs 列表 | files 列表 | os.path.join() 生成的目标路径 |
|---|---|---|---|---|
| 第 1 轮 | project |
['data', 'src'] |
['config.ini'] |
project/config.ini |
| 第 2 轮 | project/data |
[] |
['train.csv'] |
project/data/train.csv |
| 第 3 轮 | project/src |
[] |
['main.py', 'utils.py'] |
project/src/main.pyproject/src/utils.py |
五、高频实用衍生代码片段
1. 筛选指定扩展名文件(如图片或数据文件)
import os

target_extensions = ('.png', '.jpg', '.jpeg')
matched_files = []

for root, dirs, files in os.walk(r"./dataset"):
    for file in files:
        # endswith 支持传入元组,匹配任一后缀即可
        if file.lower().endswith(target_extensions):
            matched_files.append(os.path.join(root, file))

print("共检索到文件数量:", len(matched_files))
2. 递归统计文件夹总大小与文件总数
import os

total_size_bytes = 0
total_file_count = 0

for root, dirs, files in os.walk(r"./source_code"):
    for file in files:
        file_path = os.path.join(root, file)
        try:
            # 累加文件大小(字节)
            total_size_bytes += os.path.getsize(file_path)
            total_file_count += 1
        except OSError:
            # 针对特殊权限或死链的容错跳过
            pass

total_mb = total_size_bytes / (1024 * 1024)
print(f"总文件数: {total_file_count},总占用空间: {total_mb:.2f} MB")
六、常见避坑指南与生产级防崩溃配置
-
Windows 路径转义灾难:在 Windows 下写入路径字符串时,诸如
"C: est ew"中的r(例如r"C: est ew"),或者统一使用正斜杠"C:/test/new"(Python 原生支持跨平台自动转换)。 -
无权限目录导致整个任务崩溃:在扫描系统盘根目录或网络共享盘时,遇到受保护文件夹(如
System Volume Information)会默认抛出PermissionError并终止循环。此时应配置onerror参数:def handle_walk_error(err): print(f"[警告] 无法访问目录 {err.filename}: {err}") # 传入 onerror 回调,受限目录仅打印警告而不中断整体任务 for root, dirs, files in os.walk(r"C:", onerror=handle_walk_error): pass -
直接加号拼接路径产生双斜杠:若
root末尾已经带有斜杠(如根目录"/"或"C:\"),使用root + '/' + file会拼出类似//file.txt的异常路径。os.path.join()内部具备完整的去重与规范化逻辑,因此永远是首选。
七、技术选型:os.walk 与 pathlib.Path 的对照总结
在 Python 3 现代化代码库中,pathlib 越来越受欢迎。那么它与 os.walk 该如何抉择?
| 对比维度 | os.walk() | pathlib.Path.rglob() |
|---|---|---|
| 所属范式 | 过程式函数(传统经典标准库) | 面向对象(Python 3.4+ 现代化组件) |
| 返回数据类型 | 纯字符串三元组 (str, list, list) |
Path 对象生成器 |
| 动态分支剪枝 | 强支持(切片原地修改 dirs[:]) |
不支持(必须全量递归后再逐个判断) |
| 大数据量性能 | 纯 C 底层调用,微小字符串开销,速度更快 | 每个节点都需要封装为 Path 对象,内存略多 |
| 推荐使用场景 | 工程级海量文件检索、需剔除大型忽略目录、目录树删除 | 轻量日常脚本、快速按文件名模式匹配(如 *.json) |
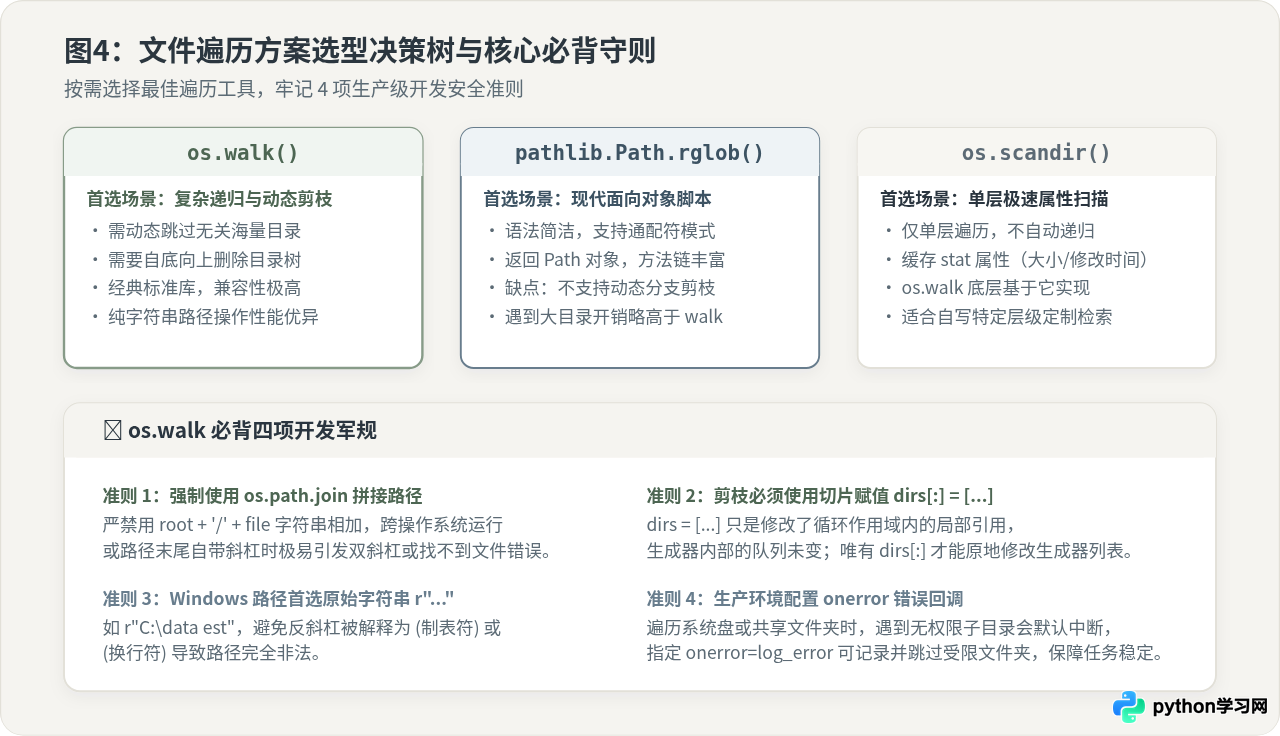
总结而言,对于简单的按文件名匹配脚本,pathlib.Path('.').rglob('*.py') 语法更加现代化且连贯;而在需要精准控制访问方向(自顶向下/自底向上)、动态剪枝忽略庞大子目录、处理大规模生产文件系统的场景下,os.walk() 凭借其低内存占用、灵活剪枝与无可比拟的稳定性,仍然是每一位 Python 开发者必须牢记于心的标准代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









