

Python遍历字典时怎么同时获取索引序号
详细讲解在Python遍历字典时如何使用enumerate函数同时获取递增索引序号,涵盖items()键值解包、仅键或仅值遍历、自定义起始序号及常见避坑技巧。
在 Python 中遍历字典并同步获取自增的索引序号,最直接且地道的方法是使用内置函数 enumerate()。当需要同时获取键和值时,结合字典的 items() 方法,并采用嵌套元组解包语法 for index, (key, value) in enumerate(my_dict.items()): 即可实现。本文将详细解析这种写法的底层机制、单侧遍历(仅键或仅值)时的简化形式、自定义起始序号技巧,以及实际开发中的常见误区。
核心解法:使用 enumerate() 配合 items() 解包
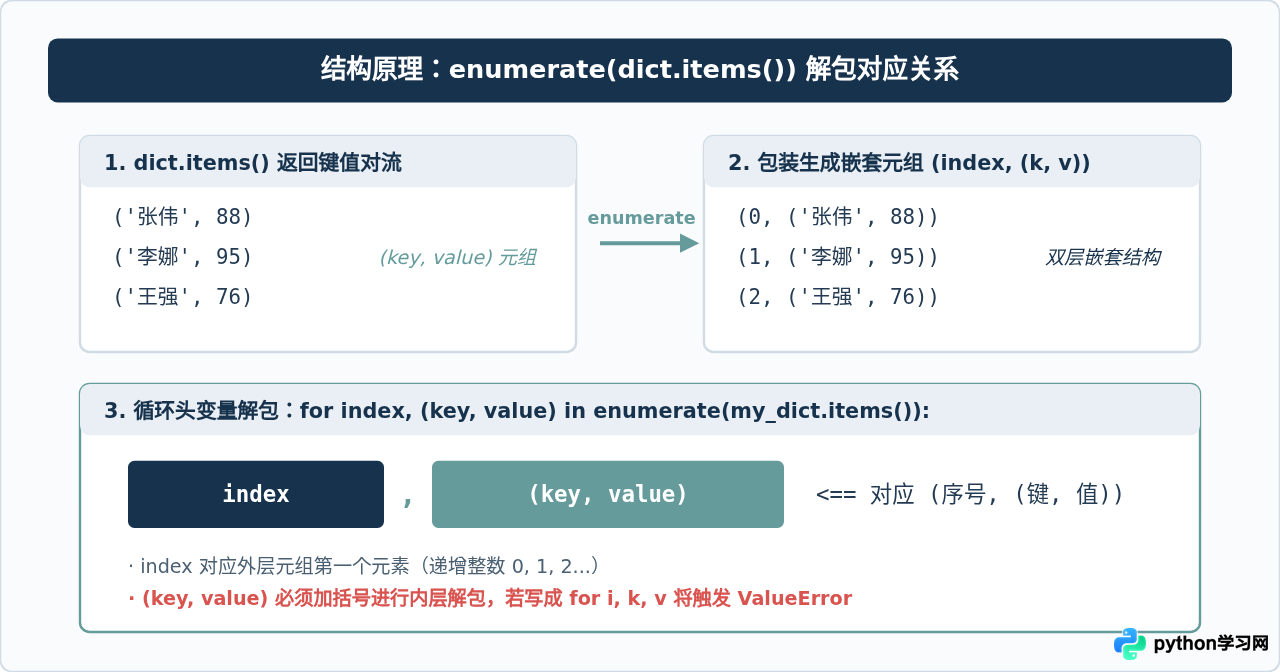
Python 的内置函数 enumerate(iterable, start=0) 能够接收任意可迭代对象,并返回一个产生 (index, item) 元组的枚举迭代器。而字典的 items() 方法返回的是包含每个键值对的元组 (key, value)。
将两者结合时,enumerate(my_dict.items()) 产生的每一项数据结构实际上是形如 (index, (key, value)) 的嵌套元组。因此,在 for 循环的变量解包中,必须使用括号将 (key, value) 括起来,以便 Python 准确地将内层元组拆解为两个变量:
# 示例代码:遍历字典同时获取序号、键和值
student_scores = {
    "张伟": 88,
    "李娜": 95,
    "王强": 76,
    "赵敏": 92
}

for index, (name, score) in enumerate(student_scores.items()):
    print(f"序号 {index}: 姓名 = {name}, 成绩 = {score}")
该代码的输出结果如下:
序号 0: 姓名 = 张伟, 成绩 = 88
序号 1: 姓名 = 李娜, 成绩 = 95
序号 2: 姓名 = 王强, 成绩 = 76
序号 3: 姓名 = 赵敏, 成绩 = 92
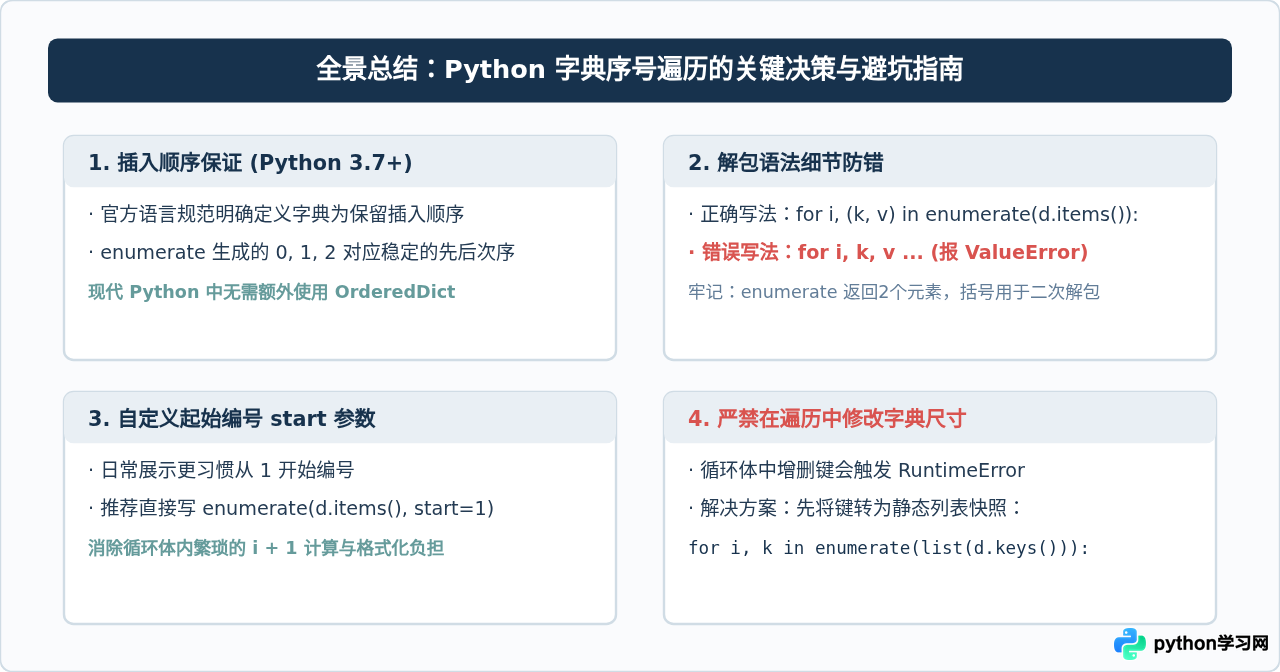
注意:如果遗漏了内层括号写成 for index, name, score in enumerate(student_scores.items()):,Python 会尝试将外层含有 2 个元素的元组直接解包给 3 个变量,从而抛出 ValueError: not enough values to unpack (expected 3, got 2) 异常。
单侧遍历与自定义起始序号
在实际编码中,业务往往并不需要同时使用键和值。针对特定场景,可以通过选择不同的遍历目标来提升代码简洁性与可读性。
1. 仅获取索引与字典的键
直接对字典对象本身进行迭代时,默认迭代的就是字典的键。因此无需显式调用 .keys(),代码非常清爽:
# 仅获取序号和键
for index, key in enumerate(student_scores):
    print(f"索引 {index}: 键 = {key}")
2. 仅获取索引与字典的值
若业务逻辑只关心存储的具体数值,可以通过 .values() 方法直接获取值对象:
# 仅获取序号和值
for index, score in enumerate(student_scores.values()):
    print(f"排名项 {index}: 得分 = {score}")
3. 自定义起始序号:start 参数的应用
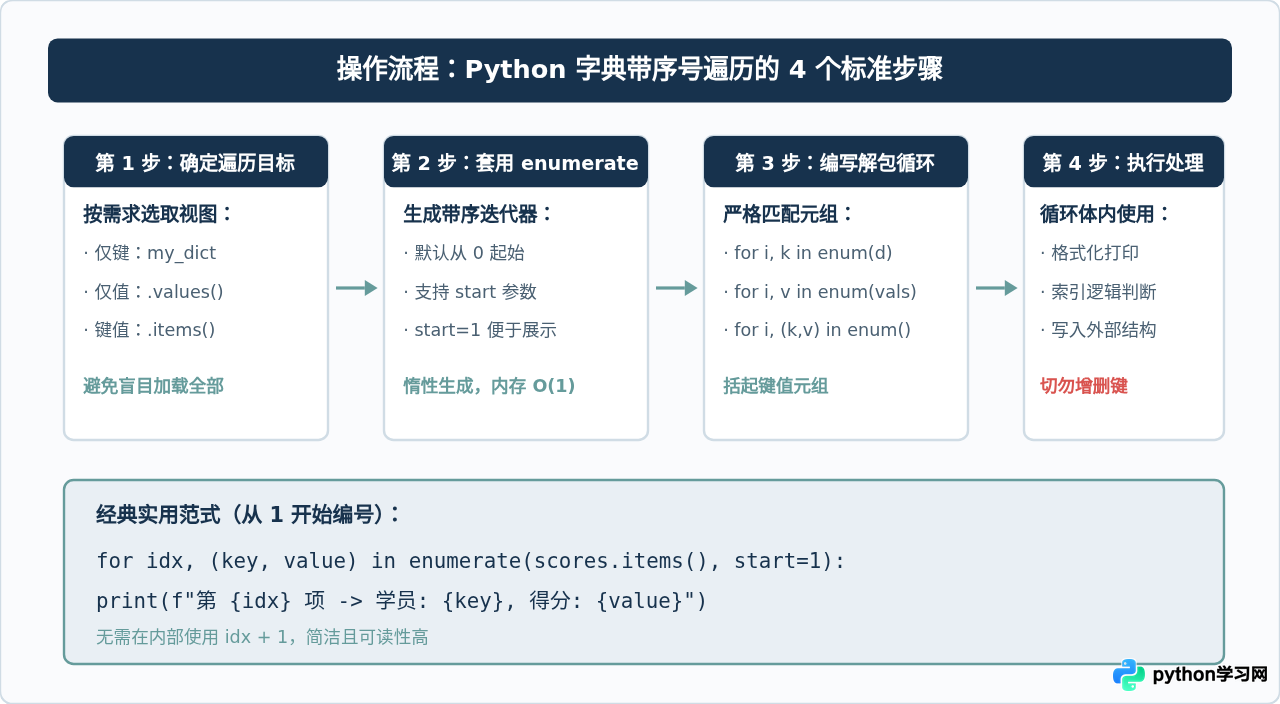
在默认情况下,enumerate() 的索引计数从 0 开始。但在制作报表、日志打印或控制台交互时,更习惯从 1 开始展示编号。此时只需在 enumerate() 中传入 start=1 参数,即可免去在循环体内部重复编写 index + 1 计算:
# 从序号 1 开始计数
for rank, (name, score) in enumerate(student_scores.items(), start=1):
    print(f"第 {rank} 名: {name} ({score} 分)")
为什么不建议用手动计数器或下标模拟?
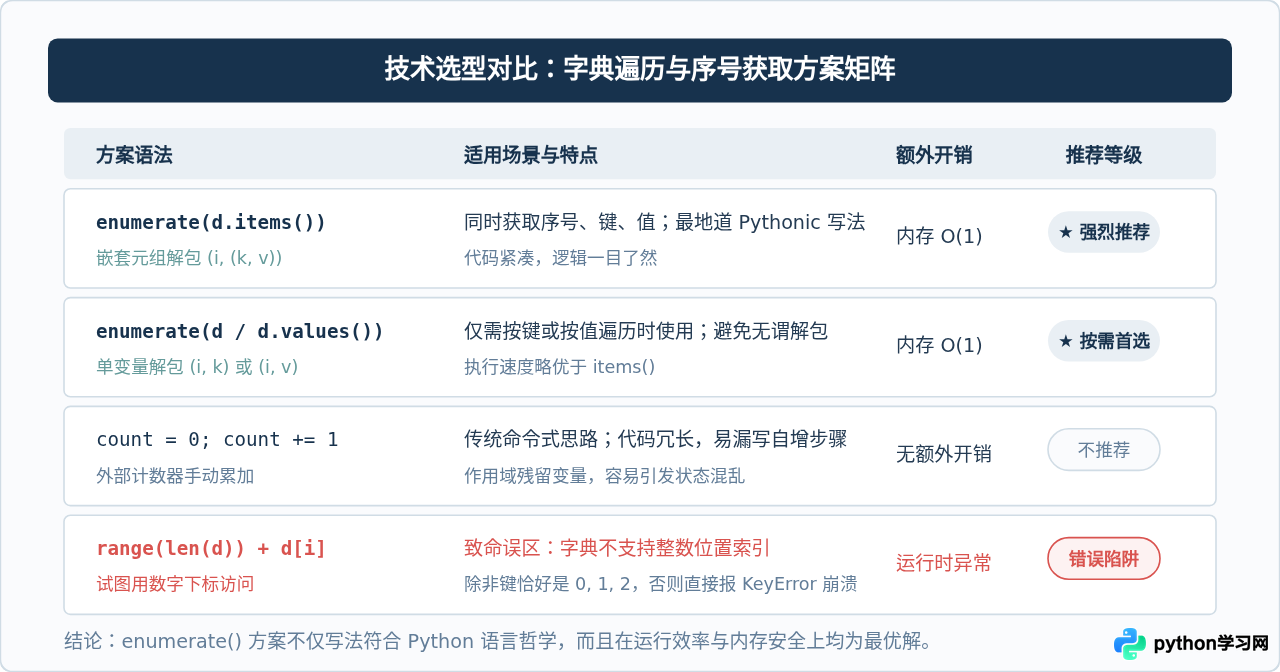
初学者在面对这个问题时,经常会尝试另外两种思路,但它们都存在明显缺陷:
- 缺陷一:外部变量累加(手动计数器)。定义
count = 0并在循环末尾写入count += 1。这种方式不仅代码冗长,而且容易在遇到continue或分支跳转时忘记递增,导致逻辑错误;同时计数器变量还会泄漏并污染外层命名空间。 - 缺陷二:使用
range(len(dict))模拟索引。在列表或元组中,可以用my_list[i]通过位置索引取值,但Python 字典是基于哈希表实现的映射类型,不支持位置索引。编写student_scores[i]时,除非字典里恰好存在整数键0, 1, 2,否则会直接触发KeyError异常。 - 缺陷三:先转列表再取下标
list(my_dict.items())[i]。虽然通过将字典转换为列表可以支持下标访问,但这会在内存中完整复制一份列表,时间与空间复杂度均上升为 O(N),属于低效的反模式。
运行机制与避坑要点
在使用 enumerate() 处理字典时,有以下几点底层机制与工程注意事项需要牢记:
1. Python 3.7+ 字典的有序性保障
在 Python 3.6 之前,字典的遍历顺序是不确定的;但从 Python 3.7 开始,官方语言规范明确保证字典按键的插入顺序排列。这意味着使用 enumerate() 获取的索引序号 0, 1, 2... 将严格对应每个键值对被写入字典的历史次序。在绝大多数日常场景下,无需再额外引入 collections.OrderedDict。
2. 遍历过程中严禁修改字典尺寸
如同普通的字典循环一样,在带有 enumerate() 的循环体中,绝对不能对当前遍历的字典执行新增键值或 del / pop 删除操作,否则 Python 会直接抛出:
RuntimeError: dictionary changed size during iteration如果业务逻辑确实需要边遍历边动态剔除某些键,标准的做法是先用 list() 对字典键进行一次静态快照:
# 安全删改字典的做法:对键做静态列表快照
for index, key in enumerate(list(student_scores.keys())):
    if student_scores[key] < 80:
        del student_scores[key]  # 安全删除,不会引发 RuntimeError
总结
在 Python 中遍历字典并获取索引序号,首选方案永远是 enumerate()。当仅需要键时,直接使用 for i, k in enumerate(dict);当需要键值对时,使用 for i, (k, v) in enumerate(dict.items()) 并注意使用小括号对键值元组进行嵌套解包。若需展示人类友好的序号,通过 start=1 可以让代码更加自然利落。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









