

解决在线运行Python代码超时(Timeout)和内存溢出报错
针对在线评测系统、Jupyter云端沙箱及轻量代码运行环境中常见的超时(Timeout)与内存溢出(MemoryError/Exit 137)报错,系统解析其触发机制、诊断排查流程与重构优化方案。
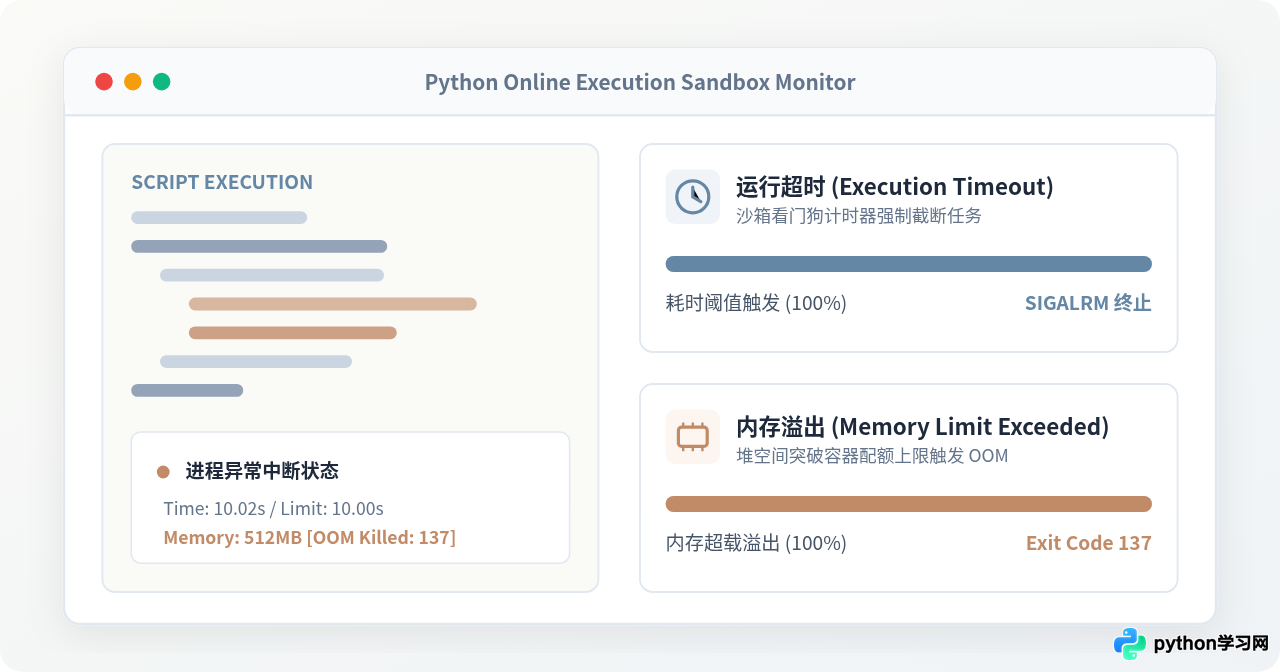
在 LeetCode、Google Colab、Jupyter Notebook 或在线代码沙箱中运行 Python 时,超时(Timeout / Time Limit Exceeded)与内存溢出(MemoryError / Exit Code 137)是最常见的两类中断报错。解决这两类问题的根本路径在于:先依据沙箱底层返回的信号区分报错成因,再通过算法复杂度降阶、惰性生成器流式处理、及时解除对象强引用来压缩资源开销,最后在本地配置资源限制完成边界压测验证。
一、现象识别:准确区分超时与内存溢出
在线代码评测平台与云端沙箱通常运行在受控的轻量级容器(如 Docker 或 Linux cgroup 隔离环境)中。当用户的 Python 脚本消耗资源超过宿主系统预设阈值时,平台会主动中断进程。读者首先需要根据报错形式准确识别受限类型,避免方向误判。
- 运行超时(Timeout / Time Limit Exceeded / TLE):程序未能在规定挂钟时间(如 5 秒或 10 秒)或 CPU 时间片内完成执行。终端通常输出
TimeoutError、Execution timed out,或提示Time Limit Exceeded。这类问题通常源自死循环、非必要的重复递归,或高达 O(N²) 及以上的算法复杂度。 - 解释器级内存溢出(MemoryError):Python 进程在向系统堆申请内存时遭遇失败,Python 解释器自身抛出标准的
MemoryError异常栈。通常发生在一次性创建过大的列表、字典或二维矩阵时。 - 容器级静默强杀(Exit Code 137 / Kernel Restarted):在云端 Jupyter 或容器沙箱中,如果整体常驻内存(RSS)超出 cgroup 限额,Linux 内核的 OOM-Killer 会直接向 Python 发送
SIGKILL信号(信号值为 9,进程退出码 128 + 9 = 137)。此时代码不会输出任何 Python 异常追踪,仅显示“Kernel dead”或“Killed”,这属于典型的容器层内存超载。
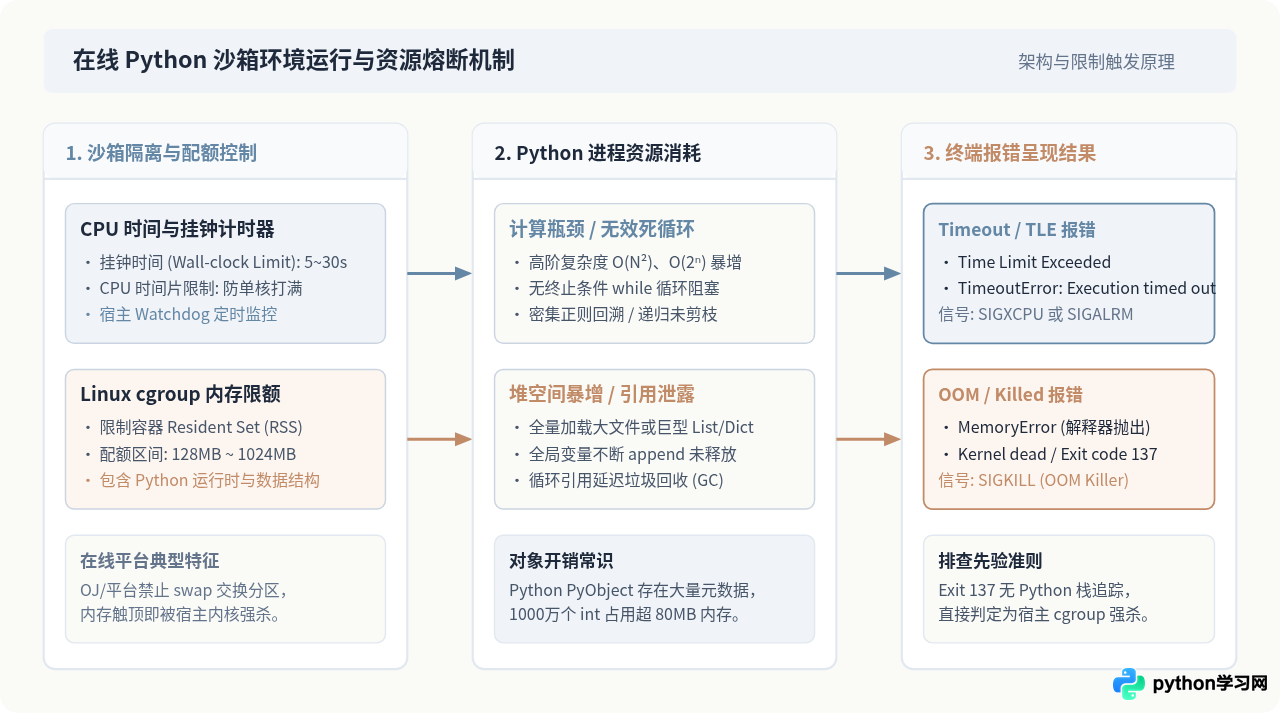
图 1:在线 Python 运行沙箱资源配额与熔断触发机制
二、系统排查:五步诊断代码瓶颈
遇到报错时,盲目调整参数往往收效甚微。建议按照标准排查流程,从最小样例逐步推导至边界数据。
- 提取错误特征:确认中断属于超时还是内存强杀。若有退出码 137,排查重点必须放在内存数据结构上;若报错带有明确的执行耗时截断,则重点分析循环与算法。
- 输入规模极小化(N=5 验证):将原本大数据规模(如 100,000)换为 5 条甚至 1 条微型样例。如果在微型样例下依然卡住超时,说明代码中存在逻辑缺陷(如
while循环未递增控制变量、递归缺少基线返回条件,或正则引擎灾难性回溯),而非算法效率问题。 - 检测算法阶数与嵌套深度:在线沙箱通常单核每秒可执行约 10⁷ 到 10⁸ 次基本操作。如果题目或业务数据量 N 为 10⁵,双层嵌套循环的运算量将达到 10¹⁰ 次,必然触发超时。
- 审计数据加载与容器生命周期:排查是否存在
file.read()一次性读取、无节制的全局变量append,或者对整个 DataFrame 进行无意义的深度拷贝。 - 本地资源限制复现:通过 Python 内置工具建立相同阈值的测试用例,重现错误后再做针对性改造。
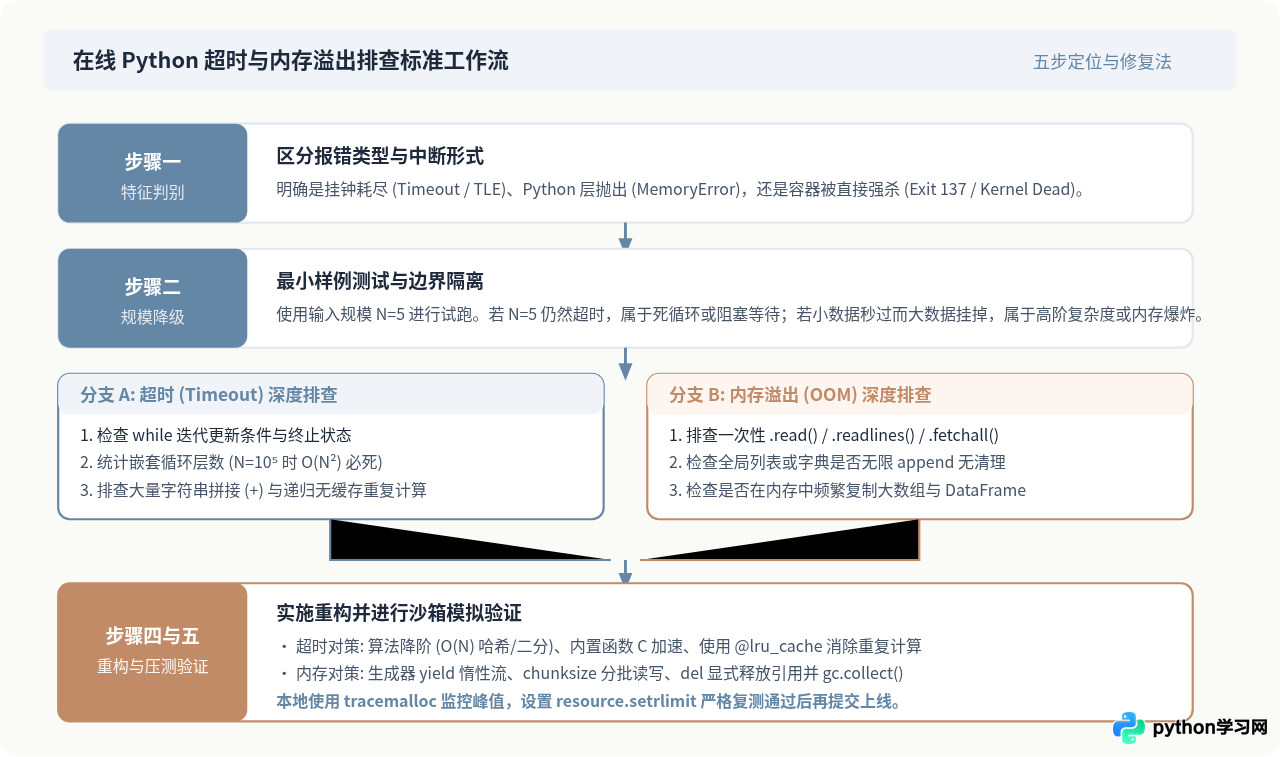
图 2:超时与内存溢出排查标准工作流
三、解决超时(Timeout)报错的关键方法
1. 复杂度降阶:用哈希映射与双指针替代嵌套遍历
超时最常见的诱因是在循环体内进行线性搜索(例如在 list 中执行 in 查询),导致整体时间复杂度演变为 O(N²)。通过将辅助结构改为具备 O(1) 查询效率的 set 或 dict,可直接将整体耗时压缩为 O(N)。
以下为在两组大规模数据中查找匹配项的高危写法与优化示例:
# 优化前:双重嵌套遍历,在 10 万级数据下耗时超 15 秒,触发 Timeout
def find_matches_slow(source_list, target_list):
    results = []
    for item in source_list:
        if item in target_list:  # 在列表上执行 in 是 O(M) 操作,整体 O(N*M)
            results.append(item)
    return results

# 优化后:预先构建哈希集合,单次查询 O(1),整体 O(N + M),耗时仅约 0.05 秒
def find_matches_fast(source_list, target_list):
    target_set = set(target_list)  # 单次构建耗时 O(M)
return [item for item in source_list if item in target_set]find_matches_slow 执行状态: TimeoutError (Execution exceeded 10.0s limit)
find_matches_fast 执行状态: Completed in 0.048s, 顺利通过沙箱限制
2. 递归缓存:使用记忆化消除重复分支计算
求解状态转移或树状递归问题时,若未做分支剪枝,相同子问题会被重复运算数百万次,导致时间复杂度呈指数级 O(2ⁿ) 暴增。通过引入 functools.lru_cache,可将已计算过的结果保存在内存表中,直接将复杂度降低到线性级别。
import functools

# 未优化的递归计算:n=40 时运算次数爆炸,沙箱直接超时
def fibonacci(n):
    if n <= 1:
        return n
    return fibonacci(n - 1) + fibonacci(n - 2)

# 优化后:利用内置装饰器自动缓存中间态,线性完成
@functools.lru_cache(maxsize=128)
def fibonacci_cached(n):
    if n <= 1:
        return n
    return fibonacci_cached(n - 1) + fibonacci_cached(n - 2)
3. 优先使用 C 语言级内置算子与批量操作
Python 原生 for 循环在解释器层存在显著的字节码分派与动态类型开销。在密集循环场景中,应避免在循环体内部反复进行字符串拼接(+ 操作会反复分配新内存)或属性查找,优先改用 str.join()、列表推导式或 itertools。
四、解决内存溢出(MemoryError / Exit 137)的关键方法
1. 惰性计算:用生成器(Generator)替代巨型列表
在内存受限(如 256MB 或 512MB)的沙箱中,创建包含千万级元素的列表会立刻占满堆空间。列表在内存中会一次性分配全部引用槽位,而生成器表达式或 yield 函数仅在被请求时产出当前元素,使常驻内存保持在 O(1) 恒定水位。
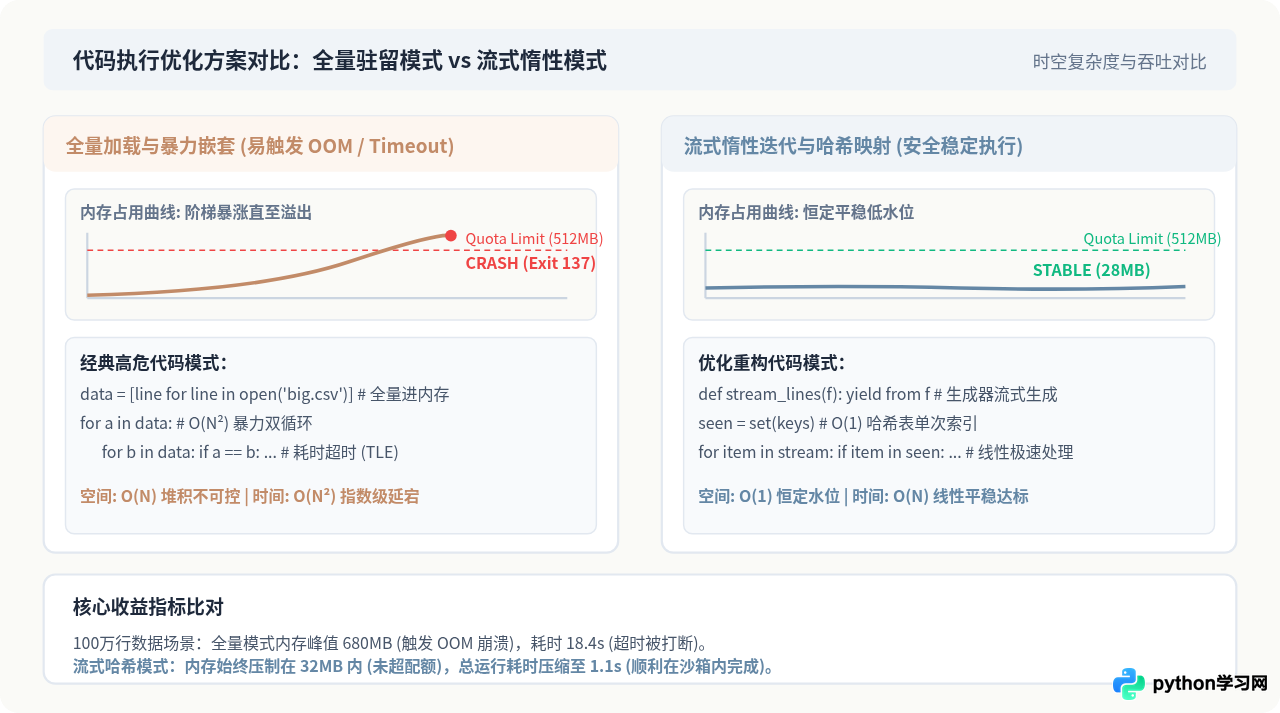
图 3:全量内存驻留模式与流式惰性迭代模式机制对比
对比以下两种处理大数值平方和的代码:
# 优化前:列表推导式全量实例化 10,000,000 个浮点数,内存瞬间暴增超 400MB
def process_data_memory_heavy(n):
    squares = [i * 1.5 for i in range(n)]  # 产生巨大列表,易被 OOM 强杀
    return sum(squares)

# 优化后:改用生成器表达式,内存占用仅约几百字节,完全恒定
def process_data_stream(n):
    squares_gen = (i * 1.5 for i in range(n))  # 仅保存迭代规则,逐个计算
    return sum(squares_gen)
2. 数据分块(Chunking)与流式读取
在线处理日志或 CSV 文件时,调用 open().readlines() 会将整个文件读入内存。正确的做法是利用文件对象的行迭代协议,或者在 Pandas 中指定 chunksize 参数分批运算。
# 传统危险做法:全量读入
# lines = open('large_dataset.txt').readlines()  # 超过 300MB 直接 OOM

# 正确做法:流式逐行处理,内存恒定在缓冲区大小(几 KB)
def parse_large_file(filepath):
    valid_count = 0
    with open(filepath, 'r', encoding='utf-8') as f:
        for line in f:  # Python 内部流式缓冲迭代
            if line.startswith("ERROR"):
                valid_count += 1
    return valid_count
3. 显式解除对象强引用与介入垃圾回收
当代码必须在中间步骤生成大型临时对象(例如经过处理的高分辨率图像矩阵或中间字典)时,Python 的自动垃圾回收(引用计数与分代垃圾回收)可能不会在内存告警前立即回收。此时应使用 del 显式解除局部引用,并在紧随其后调用 gc.collect() 强制回收内存。
import gc

def batch_pipeline(batches):
    summary_results = []
    for batch_id, raw_data in enumerate(batches):
        intermediate_matrix = [[x * 2 for x in raw_data]]
        summary_results.append(len(intermediate_matrix))

        # 处理完毕后立即解除对庞大中间对象的引用
        del intermediate_matrix
        # 在处理多轮批次后,主动触发分代垃圾回收清理孤立循环引用
        if batch_id % 10 == 0:
            gc.collect()

return summary_resultsdel 释放了对象,内存也优先归还给 Python 运行时的内部自由链表,而非直接调用 free() 还给宿主操作系统。因此,避免一次性生成小对象集合(如千万级小字典或小元组),从源头采用紧凑类型(如 array 模块或指定 __slots__)比事后 del 更加可靠。
五、本地模拟验证与上线前防御
为了确保代码提交至线上沙箱后万无一失,可以在本地开发机中模拟沙箱的内存与耗时边界。
1. 使用 tracemalloc 监控内存分配峰值
Python 标配的 tracemalloc 模块能够精确捕获代码块运行过程中的内存峰值(Peak RAM),无需依赖外部探针。
import tracemalloc

def verify_memory_usage():
    tracemalloc.start()  # 开始监控

    # 执行目标处理逻辑
    data_stream = (x ** 2 for x in range(1_000_000))
    total = sum(data_stream)

    current, peak = tracemalloc.get_traced_memory()
    tracemalloc.stop()   # 停止监控

    print(f"当前内存占用: {current / 1024 / 1024:.2f} MB")
    print(f"峰值内存占用: {peak / 1024 / 1024:.2f} MB")
    return total

verify_memory_usage()峰值内存占用: 0.03 MB
结果表明:生成器流式处理在 100 万级规模下峰值仅 30KB,可安全提交至极小内存配额沙箱。
2. 使用 resource 模块在本地强行设定限额(Linux / macOS)
在类 Unix 系统中,可以利用标准库 resource 设定当前进程的地址空间上限与 CPU 时间上限,从而精准复现沙箱被强杀的场景。
import resource

def set_sandbox_limits(max_cpu_seconds=3, max_memory_mb=128):
    # 限制 CPU 运行挂钟时间
    resource.setrlimit(resource.RLIMIT_CPU, (max_cpu_seconds, max_cpu_seconds))
    # 限制最大虚拟内存 (单位: 字节)
    memory_bytes = max_memory_mb * 1024 * 1024
    resource.setrlimit(resource.RLIMIT_AS, (memory_bytes, memory_bytes))

# 在本地运行前调用此函数,若脚本能够顺利完成而不抛出 MemoryError 或 SIGXCPU,即可确信适配线上环境。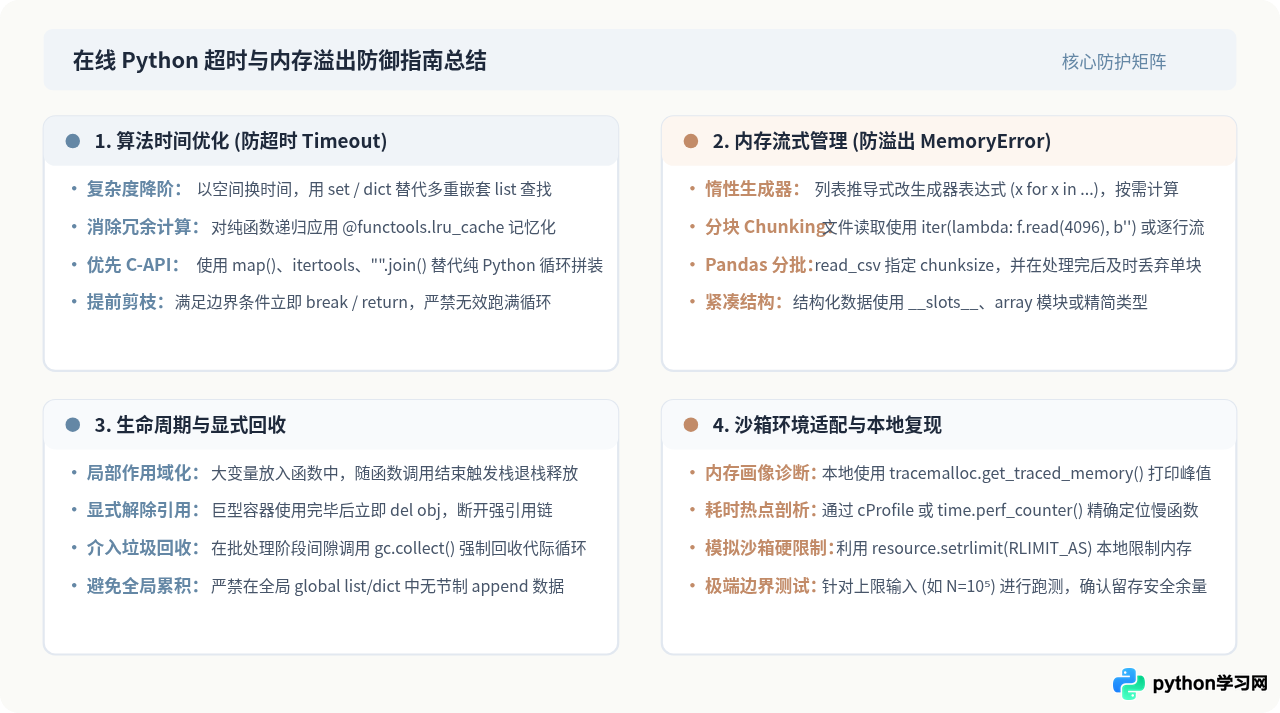
图 4:在线 Python 运行超时与内存溢出防御策略总结矩阵
六、核心策略对照速查
| 问题分类 | 典型触发诱因 | 核心重构方案 | 预期改善幅度 |
|---|---|---|---|
| 超时 (Timeout) | 多重嵌套遍历、列表内 in 成员查询 |
预先构建 set/dict 哈希索引,转化为 O(N) 线性遍历 |
耗时缩短 90%~99% |
| 超时 (Timeout) | 纯函数多分支递归重复计算 | 添加 @functools.lru_cache 记忆化装饰器 |
指数级 O(2ⁿ) 降至 O(N) |
| 内存溢出 (OOM) | 一次性构造千万级列表或矩阵 | 改用生成器表达式 (x for ...) 与 yield |
内存峰值从数百 MB 降至数十 KB |
| 内存溢出 (OOM) | 大文件一次性 read() / readlines() |
逐行 for line in f 或 Pandas chunksize 分块 |
常驻内存与文件总体积解耦 |
| 静默强杀 (137) | 循环体内产生大量中间对象未清理 | 显式执行 del 并配合 gc.collect() 主动回收 |
消除跨轮次累积内存,防止触碰 cgroup 限额 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









