

Python难点专项练习:列表推导式、装饰器与生成器习题集
本篇Python难点专项练习提供针对列表推导式、装饰器与生成器的典型习题集与解析,包含清晰的代码实现、易错点排查与底层机制图解。
掌握列表推导式、装饰器与生成器,是跨越Python初级语法的标志。本文通过针对性习题,从基础写法切入进阶机制,剖析多重嵌套、闭包参数传递及状态暂停恢复的核心逻辑,帮助建立扎实的编程直觉。
第一部分:列表推导式专项练习
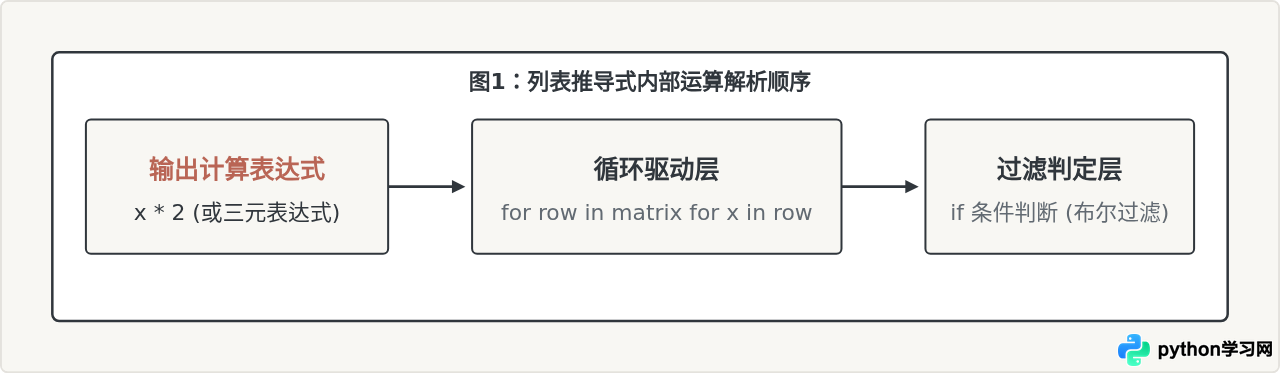
列表推导式(List Comprehension)用于以声明式的方式构建新列表。其核心语法形式为 [表达式 for 项 in 可迭代对象 if 条件]。使用时的关键是区分“过滤条件”与“分支选择表达式”的位置差异。
习题 1.1:矩阵展平与条件清洗
需求:给定一个二维列表(矩阵),包含整数和部分非数字脏数据。请编写单行列表推导式,提取出所有的正整数,同时将数值放大两倍展开为一个一维列表。
# 输入数据
raw_matrix = [
    [12, -3, "invalid", 5],
    [0, 8, None, -9],
    [15, "error", 22, -1]
]

# 目标推导式写法
clean_flattened = [
    x * 2
    for row in raw_matrix
    for x in row
    if isinstance(x, int) and x > 0
]

print("示例输出:", clean_flattened)
# 示例输出: [24, 10, 16, 30, 44]解析与注意点:多层嵌套的 for 循环在推导式中的阅读顺序与普通嵌套循环一致,外层在左,内层在右。末尾的 if 语句仅充当过滤器。如果需要对不满足条件的元素使用备用值填充,则必须将三元表达式 A if cond else B 放在最开头的求值部分,而不是放在末尾。
第二部分:装饰器专项练习
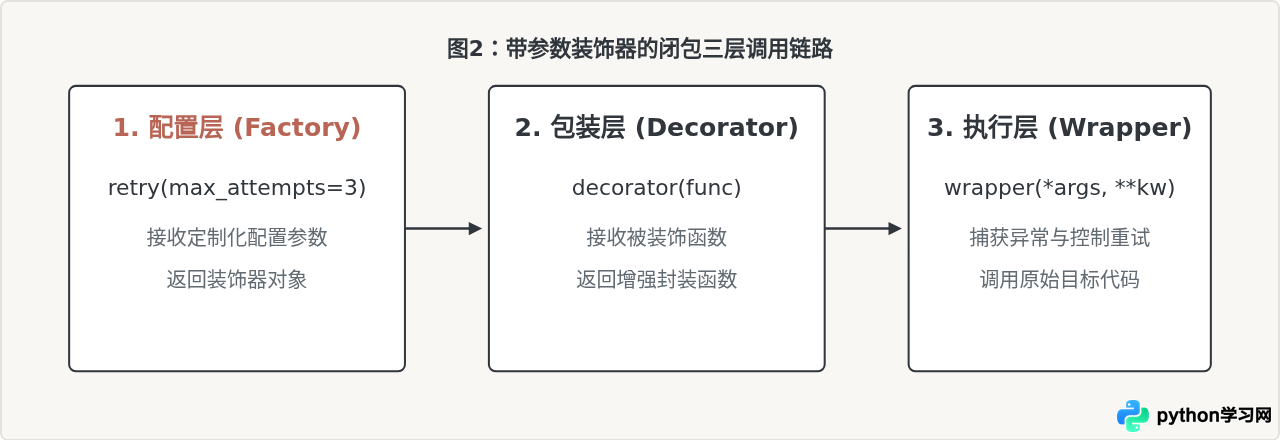
装饰器本质上是一个接收函数作为参数并返回新函数的可调用对象。它基于词法闭包实现,能够在不修改原始函数定义的前提下,扩展函数的执行行为。进阶装饰器常涉及通用参数传递、元数据丢失和外层配置参数问题。
习题 2.1:编写支持传参的执行重试装饰器
需求:编写一个名为 retry 的装饰器工厂函数。该装饰器接受最大重试次数 max_attempts 和捕获异常类型 exceptions。若目标函数在执行中抛出指定异常,则进行重试,直到成功或达到上限并抛出最终异常。同时,被修饰函数的名称和说明文档(__name__、__doc__)必须完整保留。
import functools
import time

def retry(max_attempts=3, delay=0.1, exceptions=(Exception,)):
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            attempts = 0
            while attempts < max_attempts:
                try:
                    return func(*args, **kwargs)
                except exceptions as e:
                    attempts += 1
                    if attempts >= max_attempts:
                        raise e
                    time.sleep(delay)
        return wrapper
    return decorator

# 应用示例
@retry(max_attempts=3, delay=0.05, exceptions=(ValueError,))
def fetch_network_data(success_on_attempt):
    fetch_network_data.counter = getattr(fetch_network_data, "counter", 0) + 1
    if fetch_network_data.counter < success_on_attempt:
        raise ValueError("数据拉取失败,准备重试")
    return {"status": 200, "data": "payload"}

print("示例输出:", fetch_network_data(2))
# 示例输出: {'status': 200, 'data': 'payload'}functools.wraps 会导致原函数的元数据变为 wrapper,这会直接破坏调试工具、日志分析或框架自省机制。
第三部分:生成器专项练习
生成器使用 yield 语句,按需计算并产生数据,具备惰性求值(Lazy Evaluation)特性。生成器在单次产出后会保存当前执行上下文并挂起,直到下一次调用 next() 或由 for 循环驱动,能以近乎固定的内存处理大规模数据流。
习题 3.1:日志窗口移动批处理器
需求:假设有一个超大文本日志迭代器,内存无法一次性容纳。请编写生成器函数 chunked_window(iterable, size),将数据流切分为指定大小的数据块输出,最后一段如果不满 size 也要完整保留。
def chunked_window(iterable, size):
    chunk = []
    for item in iterable:
        chunk.append(item)
        if len(chunk) == size:
            yield chunk
            chunk = []
    if chunk:
        yield chunk

# 测试生成器行为
data_stream = (f"log_row_{i}" for i in range(1, 8))
batches = chunked_window(data_stream, 3)

for batch in batches:
    print("生成器产出批次:", batch)

# 示例输出:
# 生成器产出批次: ['log_row_1', 'log_row_2', 'log_row_3']
# 生成器产出批次: ['log_row_4', 'log_row_5', 'log_row_6']
# 生成器产出批次: ['log_row_7']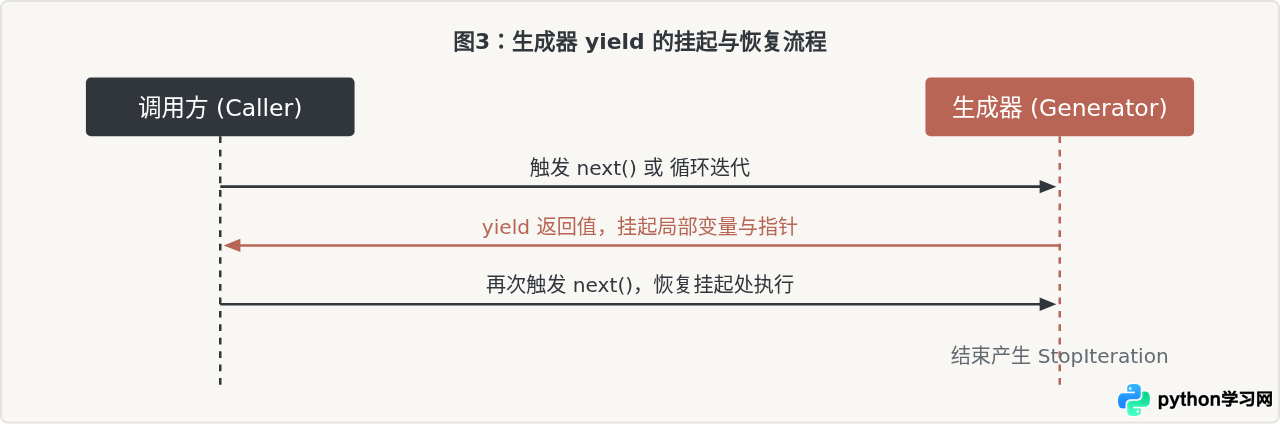
第四部分:综合应用与边界对比总结
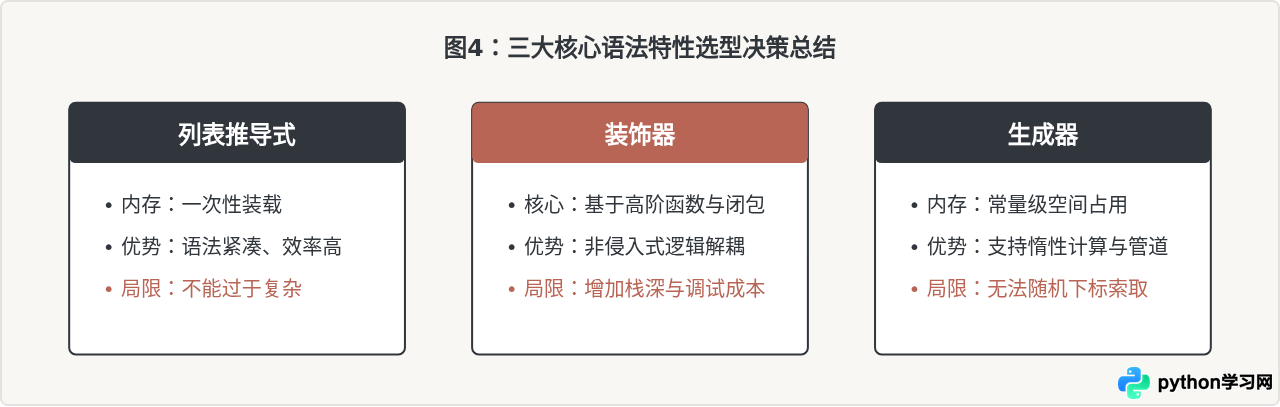
掌握这三项特性的关键,在于了解它们的适用场景与技术边界:
- 列表推导式:适合计算逻辑简单、数据规模可预测且需要立即产生完整列表的场景。如果数据量达到百万级以上,推导式会瞬间占用大量物理内存,此时应改用生成器表达式
(x for x in iterable)。 - 装饰器:适合解耦与业务本身无关的横切关注点(如认证鉴权、耗时统计、限流重试、缓存等)。使用时切记维护签名与返回内部函数的引用。
- 生成器:适合流式读取大文件、无限序列计算以及流水线处理管道。其限制是不能通过下标随机访问元素,且只能从前向后单次消耗。
完成上述习题后,建议结合日常开发中的实际数据结构尝试自主改造。例如将脚本中的批量数据加载替换为生成器管道,或提取重复的性能打点代码重构为通用的带参装饰器,以巩固对底层机制的掌握。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









