

Python切片语法详解:start、stop与step参数规则
深入详解Python切片语法中start、stop与step三大参数的取值规则、缺省机制、左闭右开边界模型、逆向切片与越界容错原理。
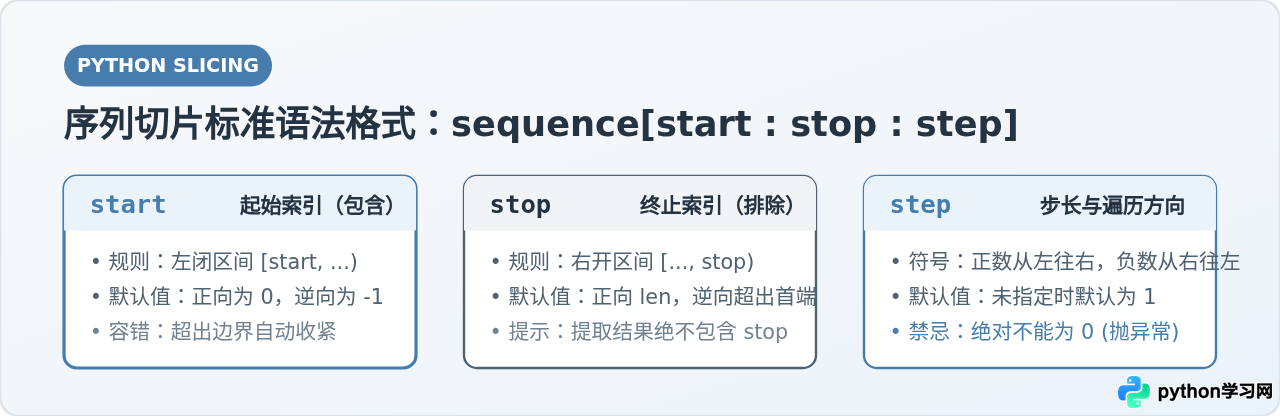
sequence[start:stop:step]。切片操作遵循三个基本机制:一是边界采取左闭右开原则 [start, stop),包含起始位置而不包含终止位置;二是提取方向完全由步长(step)的正负符号决定;三是切片具备边界自动容错特性,超出序列长度的索引会自动收缩而不会引发 IndexError。掌握这三个参数的取值逻辑、缺省规则以及逆向切片的边界换算,即可准确预测并使用任何切片表达式。
一、切片基础格式与区间规则(左闭右开)
在 Python 中,当对一个序列使用方括号提取片段时,最常用的语法是 sequence[start:stop]。这里的 start 代表起始位置索引,stop 代表终止位置索引。
Python 切片最核心的特征是左闭右开区间(数学表示为 [start, stop)):提取结果包含 start 索引所指向的元素,但严格排除 stop 索引所指向的元素。
1. 分界点(Fencepost)模型
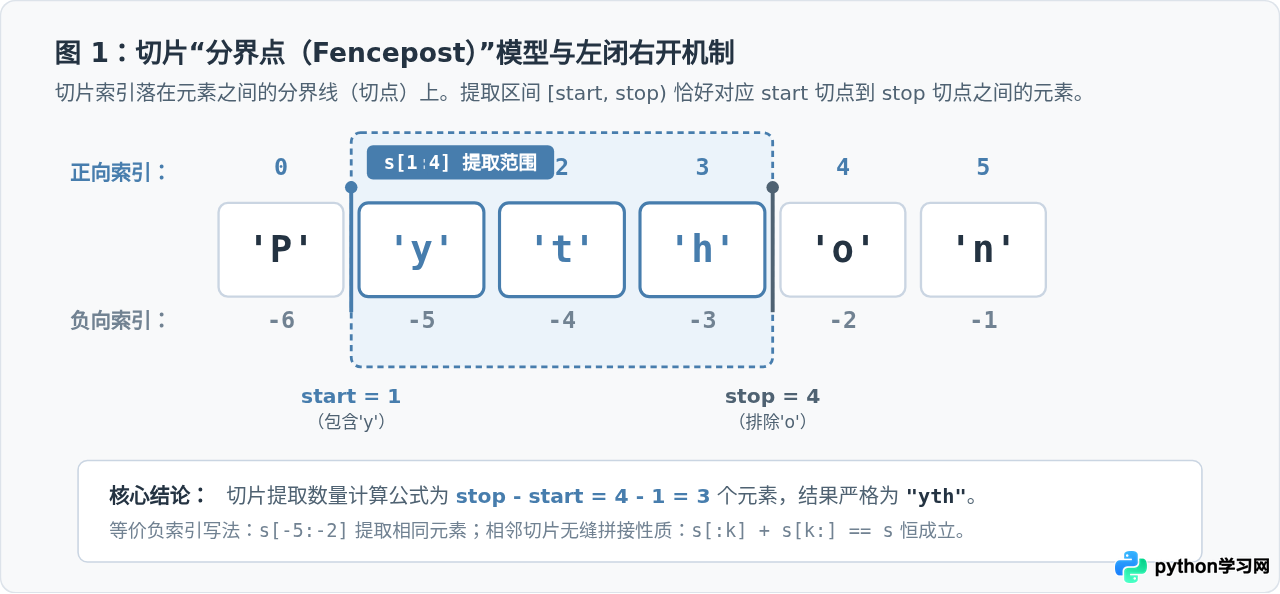
理解左闭右开最自然的方式是将索引看作元素之间的切分边界点(Fenceposts),而不是元素本身的编号。一个长度为 n 的序列,共有 n + 1 个切分点:
- 第
0个切分点位于首个元素之前; - 第
k个切分点位于第k-1与第k个元素之间; - 第
n个切分点位于最后一个元素之后。
使用切分点模型时,sequence[start:stop] 就是直接截取从分界点 start 到分界点 stop 之间的所有元素。这种设计带来了两大直接优势:
- 元素数量直观计算:提取的元素个数恒等于
stop - start(当step=1且stop > start时); - 相邻切片无缝拼接:对任意有效索引
i,表达式s[:i] + s[i:]恒等于原序列s,不存在重叠元素或元素缺失。
2. 正向索引与负向索引代码验证
Python 支持负数索引,负数索引 -k 表示从末尾向前倒数的第 k 个元素,等价于正向索引 len(s) - k。切片中无论是 start 还是 stop 均可自由使用负数:
# 定义示例字符串,长度为 6
s = "Python"

# 正向切片:提取索引 1 到 4(不含 4)
print(s[1:4])
# 示例输出: 'yth'

# 负向切片:等价于从倒数第 5 个到倒数第 2 个(不含倒数第 2 个)
print(s[-5:-2])
# 示例输出: 'yth'

# 验证 stop - start 元素数量公式
result = s[1:4]
print(len(result) == (4 - 1))
# 示例输出: True
二、参数缺省机制与默认值解析
切片表达式中的每一个参数都是可选的。当冒号前后的参数被省略时,Python 会根据步长 step 的正负方向自动填补合理的默认值。
1. 正向遍历(step > 0 或省略 step)时的缺省规则
当未指定 step(默认 step=1)或明确指定 step > 0 时,序列按从左至右的常规顺序提取:
- 省略 start(
[:stop]):默认start = 0,即从序列开头开始提取,直至stop前一位; - 省略 stop(
[start:]):默认stop = len(sequence),即从start处一直提取到序列的最末尾(包含最后一个元素); - 两者均省略(
[:]):默认提取序列的全部元素,对于列表等可变序列,该操作会生成原列表的一份全新浅拷贝(Shallow Copy)。
fruits = ["apple", "banana", "cherry", "date", "elderberry"]

# 省略 start:提取前 3 个元素
print(fruits[:3])
# 示例输出: ['apple', 'banana', 'cherry']

# 省略 stop:从第 2 个索引提取至末尾
print(fruits[2:])
# 示例输出: ['cherry', 'date', 'elderberry']

# 两者皆省略:创建独立列表浅拷贝
copy_fruits = fruits[:]
copy_fruits.append("fig")
print("原列表:", fruits)
# 示例输出: 原列表: ['apple', 'banana', 'cherry', 'date', 'elderberry']
print("副本列表:", copy_fruits)
# 示例输出: 副本列表: ['apple', 'banana', 'cherry', 'date', 'elderberry', 'fig']
三、步长参数 step 的方向与步进规则
第三个参数 step 被称为步长,用于控制指针移动的距离和遍历方向。完整格式为 sequence[start:stop:step]。
1. 步长的绝对值与正负符号
step 的作用由两部分组成:
- 符号决定方向:如果
step > 0,表示从左向右(正向索引递增)提取;如果step < 0,表示从右向左(逆向索引递减)提取。 - 绝对值决定跨度:
|step|表示每次移动的元素间隔。例如step=2表示每隔一个元素取一次,step=1表示连续提取。
step 绝对不能为 0。如果传入 step=0,Python 解释器会立即抛出 ValueError: slice step cannot be zero 运行时异常。
2. 逆向切片(step < 0)与缺省值倒置
当 step < 0 时,整个切片的提取方向被彻底反转。此时参数缺省值也同步发生镜像倒置:
- 省略 start:默认不再是 0,而是序列的最右侧元素位置(等价于
-1或len(sequence) - 1); - 省略 stop:默认不再是末尾,而是最左侧元素之前的虚拟切点(能够完整包含到索引 0 的第一个元素);
- 全缺省逆序表达式
s[::-1]:这是 Python 中反转序列的标准简洁写法,其完整展开逻辑即为“从最末尾元素出发,步长为 -1,向左遍历直至首个元素全部纳入”。
3. 方向冲突导致空切片的原因
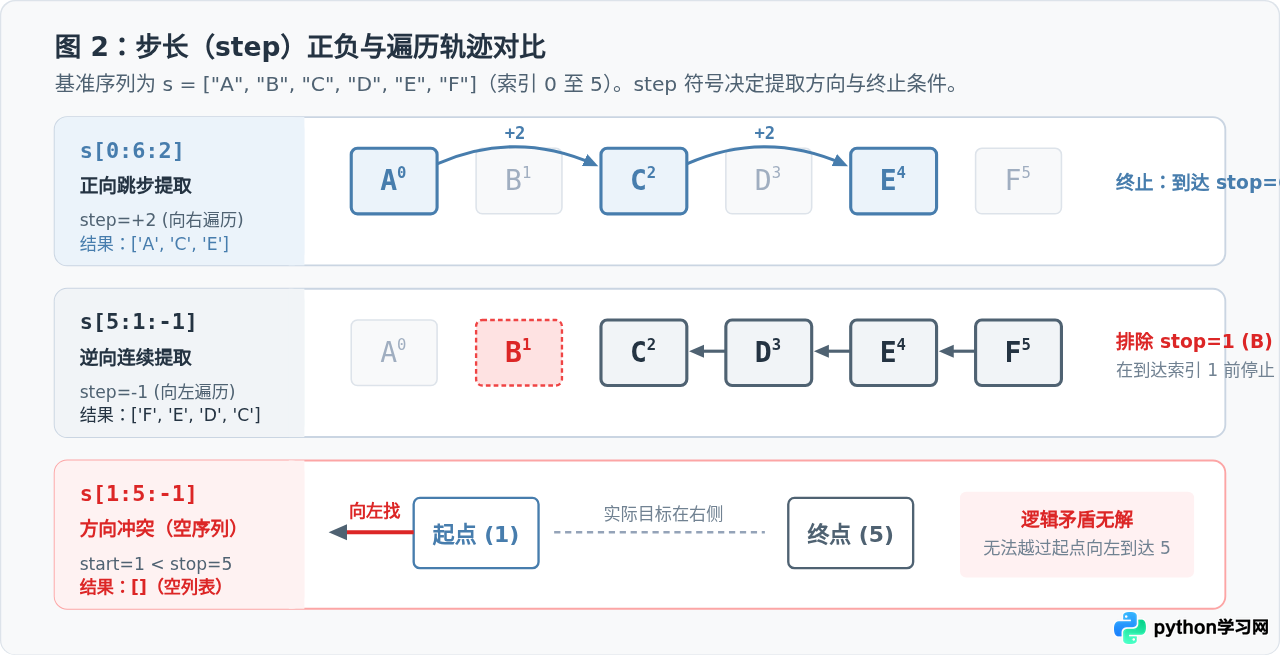
初学者最容易踩的坑是起始终点与步长方向发生逻辑冲突。例如对于序列 s = "ABCDEF":
- 执行
s[1:5:-1]:这里start=1,stop=5,而step=-1要求向左减量遍历。从位置 1 出发向左递减(经过 0, -1...),永远不可能到达位于右侧的目标 5。因此循环判定条件一开始就失效,Python 会直接返回空序列""(或[]),而不是报错。 - 正确逆向切片应该保证
start > stop:如s[5:1:-1],从 5 出发向左遍历至 2(排除 stop=1),提取出['F', 'E', 'D', 'C']。
letters = ["A", "B", "C", "D", "E", "F"]

# 正向步长 2:间隔采样
print(letters[0:6:2])
# 示例输出: ['A', 'C', 'E']

# 逆向提取:从索引 5 倒退至索引 2(排除索引 1)
print(letters[5:1:-1])
# 示例输出: ['F', 'E', 'D', 'C']

# 全序列反转
print(letters[::-1])
# 示例输出: ['F', 'E', 'D', 'C', 'B', 'A']

# 方向矛盾:start < stop 但 step < 0,返回空列表
print(letters[1:5:-1])
# 示例输出: []
四、切片索引解析推导流程(三步判定法)
为了在面对复杂的切片表达式时能够精准推导出实际截取内容,可以按照 Python 底层实现的核心逻辑,分为清晰的三步推导流程:
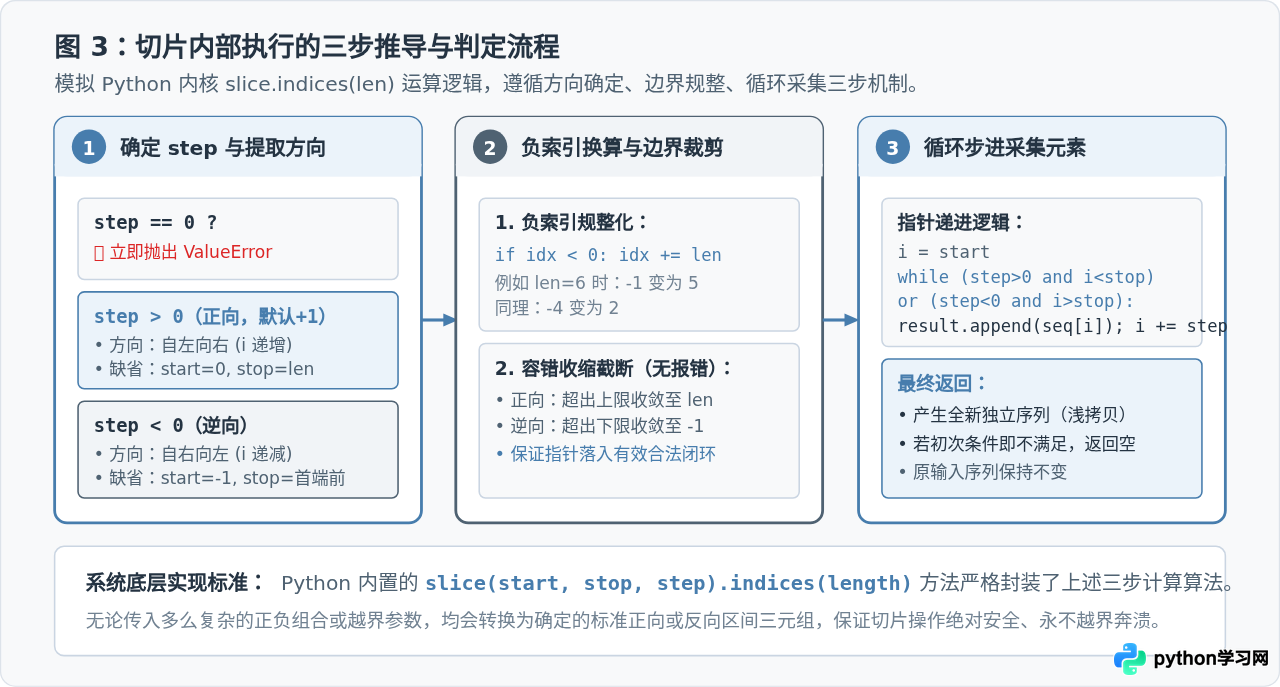
推导步骤剖析:
-
第一步:检查 step,确定遍历方向与基本有效性
首先核验step是否为 0。若为 0 报错;若step > 0,确认自左向右递增;若step < 0,确认自右向左递减。根据方向填充缺失的start与stop默认参数。 -
第二步:规范化负索引与执行边界收缩(Clamping)
对于所有负数索引,统一转换为等价的非负偏移量(公式为idx += len)。随后将数值限制在合法的序列边界区间内。这一步确保了任何极端大值或大负值都能安全落在闭合边界上。 -
第三步:依据指针循环收集元素
初始化指针i = start。当step > 0时以i < stop为继续循环的条件;当step < 0时以i > stop为条件。每次循环将sequence[i]提取存入新列表,随后执行i += step,直到循环退出。
五、切片与单元素索引的区别:边界容错与自动裁剪
在 Python 中,单元素索引访问与范围切片访问在对待“越界”问题上有着本质不同的设计哲学:
1. 为什么单元素索引会报错,而切片不会?
- 单元素索引(
sequence[k]):访问的是序列中某个特定内存位置的元素。若该位置超出序列实际长度(例如长度为 5 的序列访问s[10]),说明程序逻辑出现空指针或未定义寻址错误,因此 Python 会严格抛出IndexError: string index out of range。 - 切片访问(
sequence[start:stop]):操作的是一个“范围窗口”。在数学集合视角下,请求一个范围与实际集合求交集,结果至多为空集或边界收缩的子集,这在语义上完全合法。因此,Python 切片会自动将超出范围的索引截断至有效边界(即自动裁剪),而绝不引发崩溃。
sample = "Hello"

# 1. 直接索引越界:抛出异常
try:
    char = sample[10]
except IndexError as e:
    print("索引越界错误:", e)
# 示例输出: 索引越界错误: string index out of range

# 2. 切片越界容错:自动截断至末尾
print(repr(sample[2:100]))
# 示例输出: 'llo'

# 3. 完全超出范围:返回空子序列
print(repr(sample[20:50]))
# 示例输出: ''

# 4. 负索引极端越界:自动收敛为从开头计算
print(repr(sample[-100:3]))
# 示例输出: 'Hel'
六、底层 slice 对象与代码复用技巧
在语法底层,当编写 seq[start:stop:step] 时,Python 解释器实际上执行的是:
seq.__getitem__(slice(start, stop, step))。
slice 是 Python 的内置类。在处理复杂文本解析、定宽记录切割或数据清洗时,直接使用 slice 对象进行命名封装,可以极大地提升代码的可读性与维护性。
1. 使用命名 slice 对象消除“神秘数字”
假设需要解析一段具有固定列宽的数据记录(如日志格式、硬件传输报文):
# 定义具名切片对象,消除代码中的硬编码数字
RECORD_ID = slice(0, 6)
TIMESTAMP = slice(7, 26)
LOG_LEVEL = slice(27, 32)
MESSAGE   = slice(33, None)  # None 等价于省略该参数(提取至末尾)

log_line = "001429 2026-10-31 02:13:07 ERROR Connection refused to host"

print("ID:", log_line[RECORD_ID])
# 示例输出: ID: 001429
print("时间:", log_line[TIMESTAMP])
# 示例输出: 时间: 2026-10-31 02:13:07
print("级别:", log_line[LOG_LEVEL])
# 示例输出: 级别: ERROR
print("内容:", log_line[MESSAGE])
# 示例输出: 内容: Connection refused to host
2. slice.indices(length) 方法
slice 实例提供了一个专有方法 indices(len)。给定目标序列的长度,该方法会计算并返回一个标准规范化的 (start, stop, step) 三元元组。开发者在自定义序列类型并实现 __getitem__ 时,使用该方法可免于手动编写繁杂的边界规整算法:
s_obj = slice(2, 50, 2)
# 针对一个长度为 6 的序列计算规范化切片参数
start, stop, step = s_obj.indices(6)
print(f"规范化结果: start={start}, stop={stop}, step={step}")
# 示例输出: 规范化结果: start=2, stop=6, step=2

# 可直接用于 range() 迭代
for i in range(start, stop, step):
    print(f"访问索引: {i}")
# 示例输出:
# 访问索引: 2
# 访问索引: 4
七、高频切片操作模式与速查总结
切片语法灵活多变,在实际开发中沉淀了若干常见而经典的高频用法。下表对这些模式进行了汇总对照:
| 切片表达式 | 名称 / 操作模式 | 机制说明 | 典型示例(s = [0,1,2,3,4,5]) |
|---|---|---|---|
s[:] |
完整浅拷贝 | 复制序列所有元素,生成新的同类型独立容器 | [0, 1, 2, 3, 4, 5] |
s[::-1] |
逆序反转 | 步长为 -1,从右至左完整提取全部元素 | [5, 4, 3, 2, 1, 0] |
s[:k] |
截取前 k 个元素 | 从起点 0 开始提取,直至索引 k(包含 k 个元素) | s[:3] -> [0, 1, 2] |
s[-k:] |
截取末尾 k 个元素 | 从倒数第 k 个切点开始提取至末尾 | s[-3:] -> [3, 4, 5] |
s[:-k] |
剔除末尾 k 个元素 | 从开头提取,在倒数第 k 个切点处停止 | s[:-2] -> [0, 1, 2, 3] |
s[k:] |
剔除前 k 个元素 | 跳过前 k 个元素,从切点 k 开始提取至末尾 | s[2:] -> [2, 3, 4, 5] |
s[::2] |
偶数索引抽样 | 以步长 2 采样索引 0, 2, 4... | [0, 2, 4] |
s[1::2] |
奇数索引抽样 | 从索引 1 出发,以步长 2 采样 1, 3, 5... | [1, 3, 5] |
s[1:-1] |
去除两端首尾 | 剥离首位与末位单个元素,常用于括号/引号剥除 | [1, 2, 3, 4] |
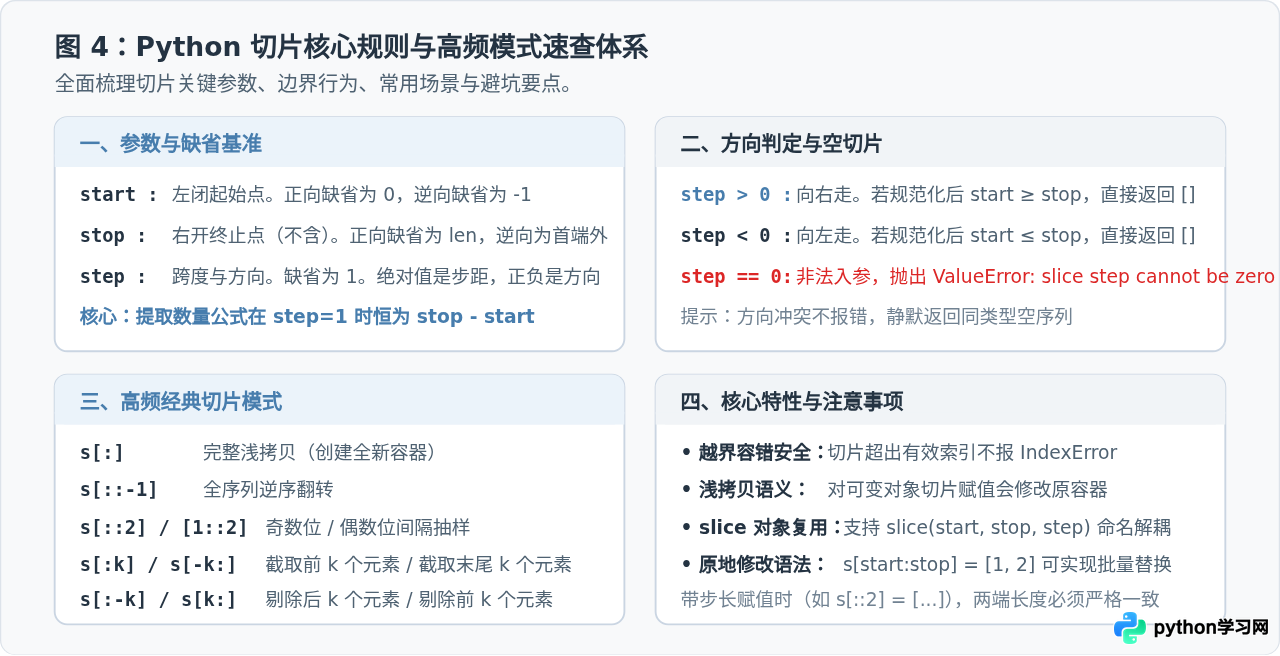
start、stop 与 step 的边界规则与容错机制,就能写出高效、优雅且零错误的 Python 切片代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









