

Python array模块定义数值数组的方法与适用场景
深入解析Python内置array模块定义数值数组的完整方法、类型码选用规则、底层内存排布机制,以及在内存敏感型场景、二进制IO通信中与list、NumPy的对比选型指南。
在 Python 中存储一串数字时,绝大多数开发者首先想到的容器是标准的 list。然而,在处理成千上万乃至数百万个基础数值时,列表会带来显著的内存膨胀与访问开销。Python 标准库自带的 array 模块提供了一种直接基于 C 语言原生数据类型、在内存中连续紧凑排列的数值序列实现。掌握 array 模块的定义方法、类型码规则以及适用边界,能让我们在不引入任何外部第三方依赖(如 NumPy)的前提下,实现大幅度的内存优化与极速二进制数据读写。
一、array 模块的核心机制:与标准 list 的底层差异
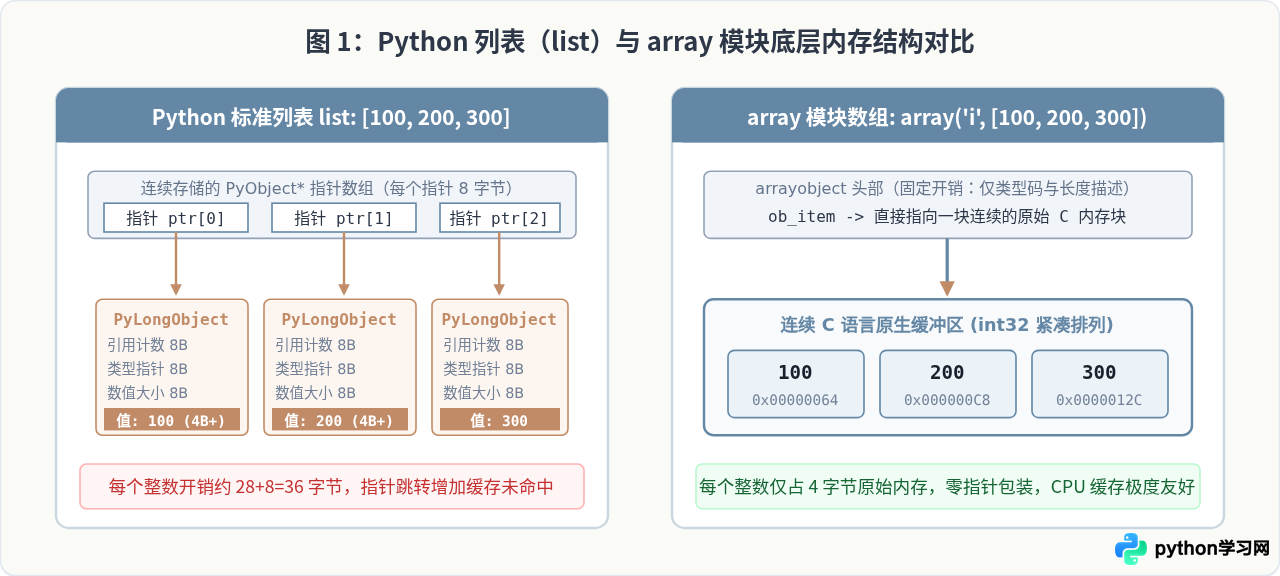
为了理解为什么需要 array 模块,必须先看 Python 原生 list 的内存组织方式。Python 的 list 本质上是一个动态指针数组(PyObject**)。列表内存储的并非数值本身,而是指向堆内存中独立 Python 对象的引用指针。
以一个普通的 64 位系统下的整型 100 为例:一个完整的整型对象(PyLongObject)不仅包含具体的数值,还附带了引用计数(8 字节)、类型指针(8 字节)以及表示大小和数字片段的结构,单对象内存占用通常达到 28 字节;加上列表内部记录指针所需的 8 字节,存储一个整数的综合开销高达 36 字节左右。当列表中包含千万级数据时,内存开销可达数百兆甚至吉字节,且离散的堆对象指针跳转会导致 CPU 缓存命中率显著降低。
与此相对,array 模块通过定义唯一的类型码(Typecode),在底层直接开辟一段连续的 C 语言原生内存缓冲区(例如 4 字节的 int32_t 或 8 字节的 double)。数组对象本身仅维护一个包含类型和长度信息的轻量头部,所有数值紧密贴合排列,不存在多余的指针与装箱对象。
二、类型码(Typecode)详解与内存规格对照
定义 array 数组的前提是选定正确的“类型码”(Typecode)。类型码是一个单字符字符串,用于明确告知解释器数组中每个元素对应的 C 语言原生类型、有无符号以及单元素所占的字节宽度。一旦类型码确定,该数组便只能容纳指定类型的数值,绝不允许混入其他类型的对象。
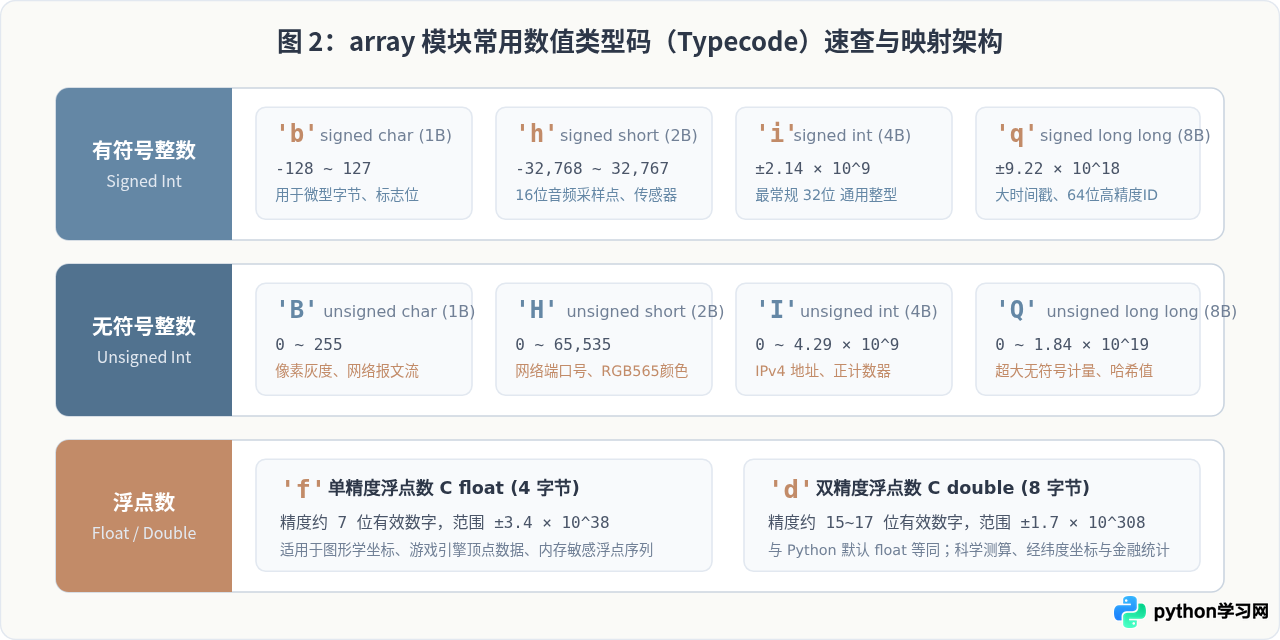
下表汇总了 array 模块中最核心的类型码规格与取值范围:
| 类型码 | 对应 C 语言类型 | Python 数据类型 | 最小字节数 | 典型取值范围 / 用途 |
|---|---|---|---|---|
'b' |
signed char | int | 1 | -128 至 127(低位标志、传感器微小数值) |
'B' |
unsigned char | int | 1 | 0 至 255(原生字节、图像像素灰度值) |
'h' |
signed short | int | 2 | -32,768 至 32,767(16 位音频采样点) |
'H' |
unsigned short | int | 2 | 0 至 65,535(网络端口号、RGB565 颜色) |
'i' |
signed int | int | 4 | -2,147,483,648 至 2,147,483,647(通用 32 位整型) |
'I' |
unsigned int | int | 4 | 0 至 4,294,967,295(无符号 32 位整型、IPv4 整数) |
'l' / 'L' |
signed / unsigned long | int | 4 或 8 | 平台相关的长整型(依赖操作系统平台) |
'q' |
signed long long | int | 8 | -9.22×10¹⁸ 至 9.22×10¹⁸(64 位大整数、时间戳) |
'Q' |
unsigned long long | int | 8 | 0 至 1.84×10¹⁹(64 位无符号计数器) |
'f' |
float | float | 4 | 单精度浮点数(约 7 位有效位,适合轻量坐标、顶点) |
'd' |
double | float | 8 | 双精度浮点数(约 15~17 位有效位,等同于 Python 默认 float) |
'i' 通常稳定代表 4 字节整数,而 'l' 在 Windows 64 位平台下为 4 字节、在 Linux/macOS 64 位下为 8 字节。若需要精确保证 8 字节长度,推荐显式使用 'q'(有符号)或 'Q'(无符号)。
三、定义数值数组的操作步骤与代码实现
在 Python 中使用 array 模块定义与操作数值数组遵循清晰的标准生命周期:从类型选型、初始化,到操作与二进制持久化。
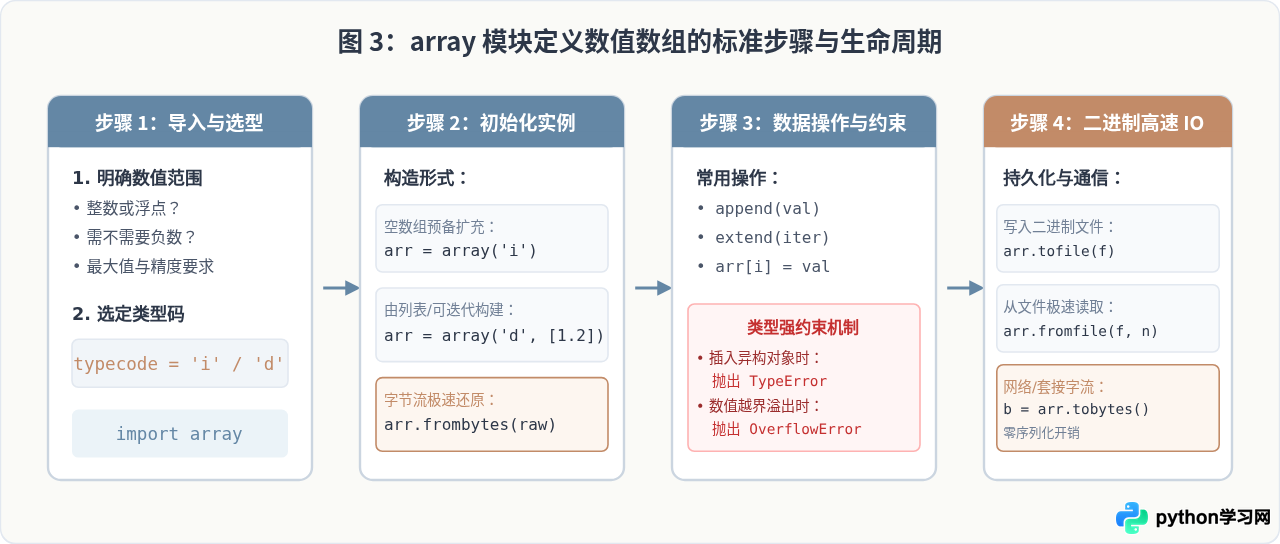
1. 导入模块与初始化数组
可以通过从标准库导入 array 类来初始化数组。初始化语法为 array(typecode[, initializer]),第二个参数可选,可传入列表、元组或生成器等可迭代对象:
from array import array

# 示例 1:创建一个空的 32 位有符号整型数组
int_arr = array('i')

# 示例 2:使用已有列表初始化双精度浮点数数组
float_arr = array('d', [3.14159, 2.71828, 1.41421])

# 示例 3:通过生成器推导快速初始化千万级数组
seq_arr = array('I', (x * 2 for x in range(5)))

print("int_arr:", int_arr)
print("float_arr:", float_arr)
print("seq_arr:", seq_arr)float_arr: array('d', [3.14159, 2.71828, 1.41421])
seq_arr: array('I', [0, 2, 4, 6, 8])
2. 数据追加、修改与切片
array 对象实现了可变序列(MutableSequence)接口,常见列表操作(如 append、extend、切片、索引赋值)均可无缝使用:
from array import array

arr = array('i', [10, 20, 30])

# 单个元素追加与批量扩充
arr.append(40)
arr.extend([50, 60])

# 按索引读取与修改
print("第 0 个元素:", arr[0])
arr[1] = 99

# 支持切片获取子数组(返回同类型 array)
sub_arr = arr[1:4]

print("修改后数组:", arr)
print("切片子数组:", sub_arr)
print("单元素字节大小:", arr.itemsize)修改后数组: array('i', [10, 99, 30, 40, 50, 60])
切片子数组: array('i', [99, 30, 40])
单元素字节大小: 4
3. 类型强约束与边界溢出异常
与动态灵活的 list 不同,array 在插入元素时具有严格的底层类型检查与数值范围验证,这在构建稳定数据管线时能及早拦截脏数据:
from array import array

byte_arr = array('B', [100, 200])

# 异常场景 1:尝试插入非对应类型(如向无符号整型中混入字符串或浮点数)
try:
    byte_arr.append("invalid")
except TypeError as err:
    print("捕获类型错误:", err)

# 异常场景 2:尝试插入超出该类型码取值范围的数值('B' 的范围是 0~255)
try:
    byte_arr.append(300)
except OverflowError as err:
print("捕获数值溢出错误:", err)捕获数值溢出错误: unsigned byte integer is greater than maximum
4. 高速二进制 I/O 与文件持久化
array 最具生产价值的特性之一是直接支持与原生二进制流双向转换,无需经过 json、pickle 或文本字符格式的格式化与解析,I/O 吞吐极高:
from array import array
import io

# 创建包含 5 个 64 位双精度浮点数的数组
original = array('d', [1.1, 2.2, 3.3, 4.4, 5.5])

# 1. 极速导出为字节对象 (bytes),可直接发送至网络套接字
raw_bytes = original.tobytes()
print("原始字节流长度:", len(raw_bytes), "字节 (5 * 8B = 40B)")

# 2. 从二进制流或文件高速回填(无需循环逐个解析)
restored = array('d')
restored.frombytes(raw_bytes)
print("字节流还原结果:", restored)
print("内容完全一致:", original == restored)字节流还原结果: array('d', [1.1, 2.2, 3.3, 4.4, 5.5])
内容完全一致: True
四、核心适用场景与典型工程案例
在实际工程开发中,array 模块并不是为了完全替代 list,而是在特定需求场景下提供极致的资源效率与便利性:
1. 内存极度敏感的大规模同质数值存储
在无第三方依赖的环境下(例如受限的 Linux 最小化容器镜像、AWS Lambda 无外部编译依赖函数、单板嵌入式 Python 运行时),如果需要缓存百万级别的整数 ID、传感器时序指标或经纬度坐标,使用 array('i') 或 array('d') 相比 list 能立即节省 70% 至 80% 的物理内存开销,同时大幅降低垃圾回收(GC)器扫描成千上万小对象的压力。
2. 与底层 C/C++ 共享内存或 ctypes 接口协同
array 的底层内存是严格连续的 C 结构,它原生支持 Python 的 缓冲区协议(Buffer Protocol)。可以通过 memoryview(arr) 对其进行零拷贝包装,并直接作为指针传参提供给 ctypes、Cython 扩展或 C 共享库(.so / .dll)进行直接读写计算,避免了繁重的数据拷贝。
3. 原始二进制文件与网络协议解析
在处理纯二进制协议、音频 PCM 文件(.wav 原始采样)、遥感高程数据或网络硬件捕获的包头序列时,array.fromfile(file_obj, n) 和 array.tofile(file_obj) 能够直接以单次底层系统调用(read / write)完成整批数据的存取,速度往往是逐行处理文本文件的数十倍。
五、技术选型决策:list、array 与 NumPy 的选择依据
面对不同的容器方案,开发者应根据数据特性与计算需求作出理性选型:
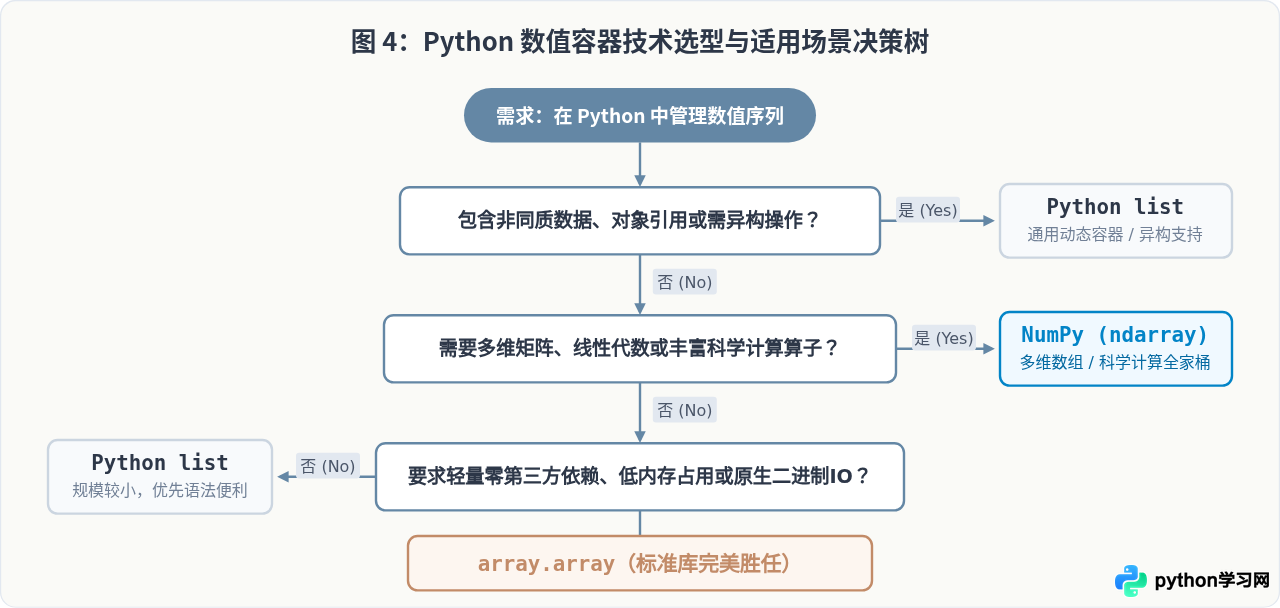
| 对比维度 | Python 标准列表 list | Python array 模块 | 第三方 NumPy (ndarray) |
|---|---|---|---|
| 元素类型 | 完全异构(可混存任何 Python 对象) | 纯同质(仅限指定的单一数值类型码) | 同质数值(支持更丰富的自定义 dtype) |
| 内存布局 | 离散指针数组,高内存开销 | 连续紧凑 C 语言缓冲区,超低内存 | 连续/跨步多维缓冲区,结构最紧凑 |
| 外部依赖 | 无(内置语法) | 无(内置标准库) | 需要额外安装 C/Fortran 编译扩展库 |
| 维度支持 | 多维需通过嵌套列表模拟 | 仅支持一维连续数组 | 天然原生支持任意 N 维张量 |
| 数学与向量化计算 | 无,需写 Python 循环或列表推导 | 无,需使用循环或 map | 极度丰富(SIMD 向量化广播、矩阵代数) |
| 二进制与文件 I/O | 需依赖 pickle/json 逐层序列化 | 原生 tofile/tobytes,简单极速 |
支持高效 .npy / 内存映射(memmap) |
- 如果数据规模在千级以内,或者包含字符串、字典等混合数据,直接使用
list是最灵活直观的选择; - 如果包含海量一维基础数值,且项目明确限制不引入第三方重型包(或只需要轻量的二进制文件存取),
array是标准库中的最优解; - 如果需要进行多维数组切片、傅里叶变换、矩阵相乘、广播运算或统计分析,必须毫不犹豫选用 NumPy。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









