

用Python实现莱布尼茨级数计算Pi
详细讲解如何使用Python编写程序,通过莱布尼茨交错级数计算圆周率Pi。包含公式原理解析、逐步代码实现、性能优化技巧以及收敛精度的实测对比分析。
莱布尼茨级数是数学中形式最为优美、结构最为纯粹的圆周率逼近公式之一。本文将直接从公式的数学规律切入,使用 Python 编写从基础循环到优化封装的完整程序,拆解符号交替与浮点累加的关键细节,并通过具体的数据对照揭示该级数的收敛特性与工程边界。
一、莱布尼茨级数的数学原理与规律拆解
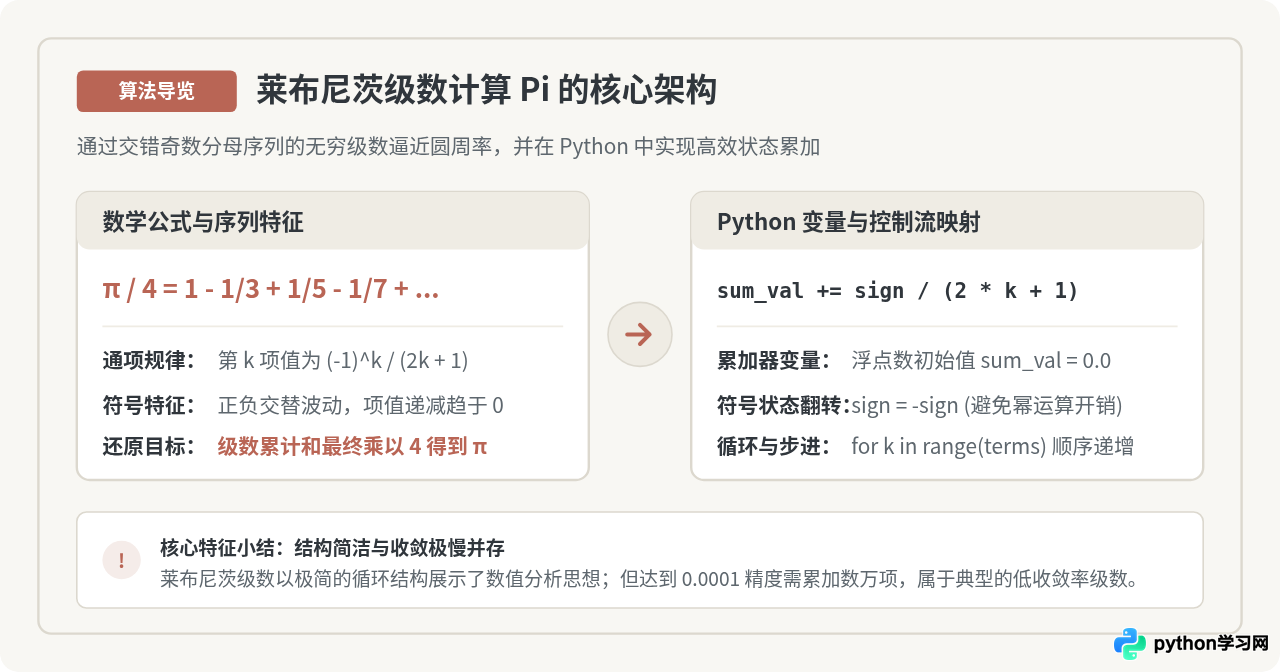
莱布尼茨级数(Leibniz formula for π)由德国数学家莱布尼茨于 1673 年提出。它的公式形式异常简洁,将圆周率四分之一表示为一个无穷交错奇数分母分数之和:
π / 4 = 1 - 1/3 + 1/5 - 1/7 + 1/9 - 1/11 + ... = ∑ [(-1)^k / (2k + 1)] (其中 k 从 0 累加至正无穷)
两边同时乘以 4,即得到 π 的直接估算式:
π = 4 × ∑ [(-1)^k / (2k + 1)]
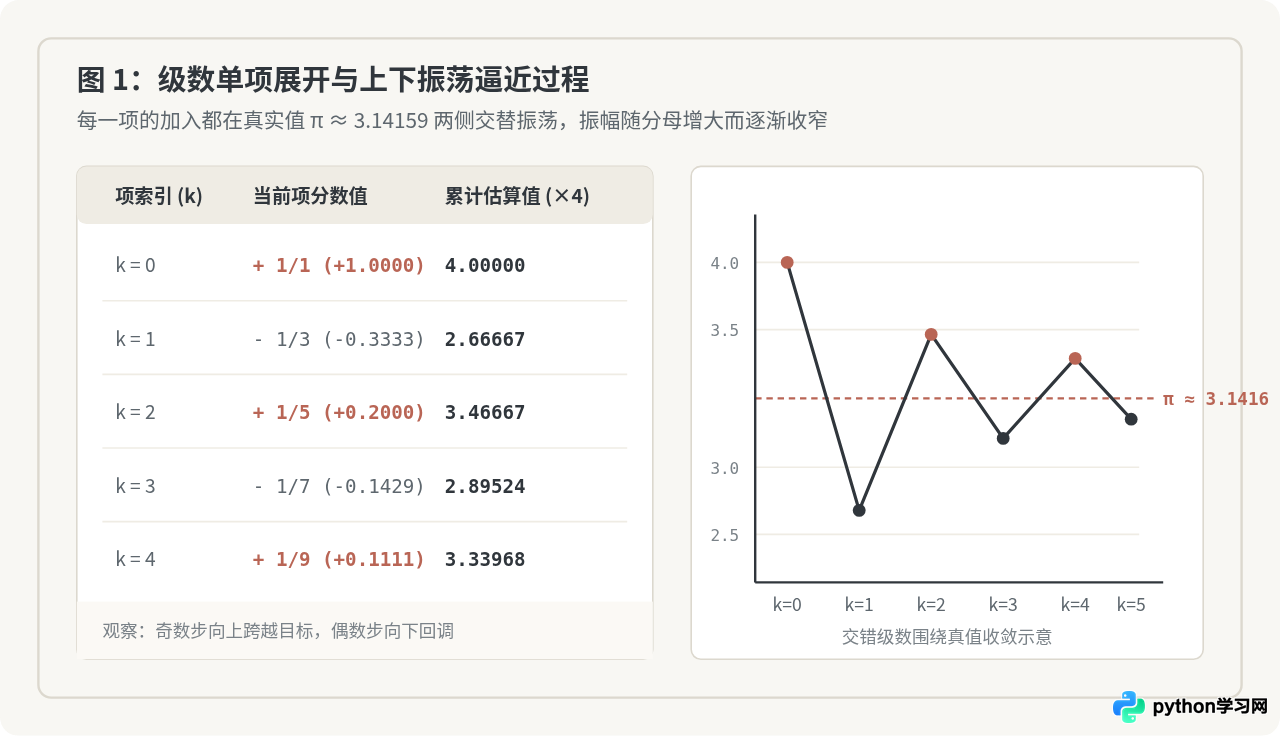
仔细观察级数的构成项,可以提炼出三个直接对应程序实现的数学要素:
- 项索引与其分母规律:项数索引从
k = 0开始,第k项的分母严格遵循正奇数列,即2k + 1(依次为 1, 3, 5, 7, 9...)。 - 交替出现的正负号:分子始终由
(-1)^k决定。当k为偶数时分子为+1,当k为奇数时分子为-1,构成了典型的交错级数(Alternating Series)。 - 振荡逼近特性:每一项的加入都在真实值附近来回跨越。奇数项拉低估算值,偶数项拉高估算值,随着分母不断增大,振幅逐步衰减,整体序列向真实极限收敛。
二、Python 代码实现与符号交替技巧
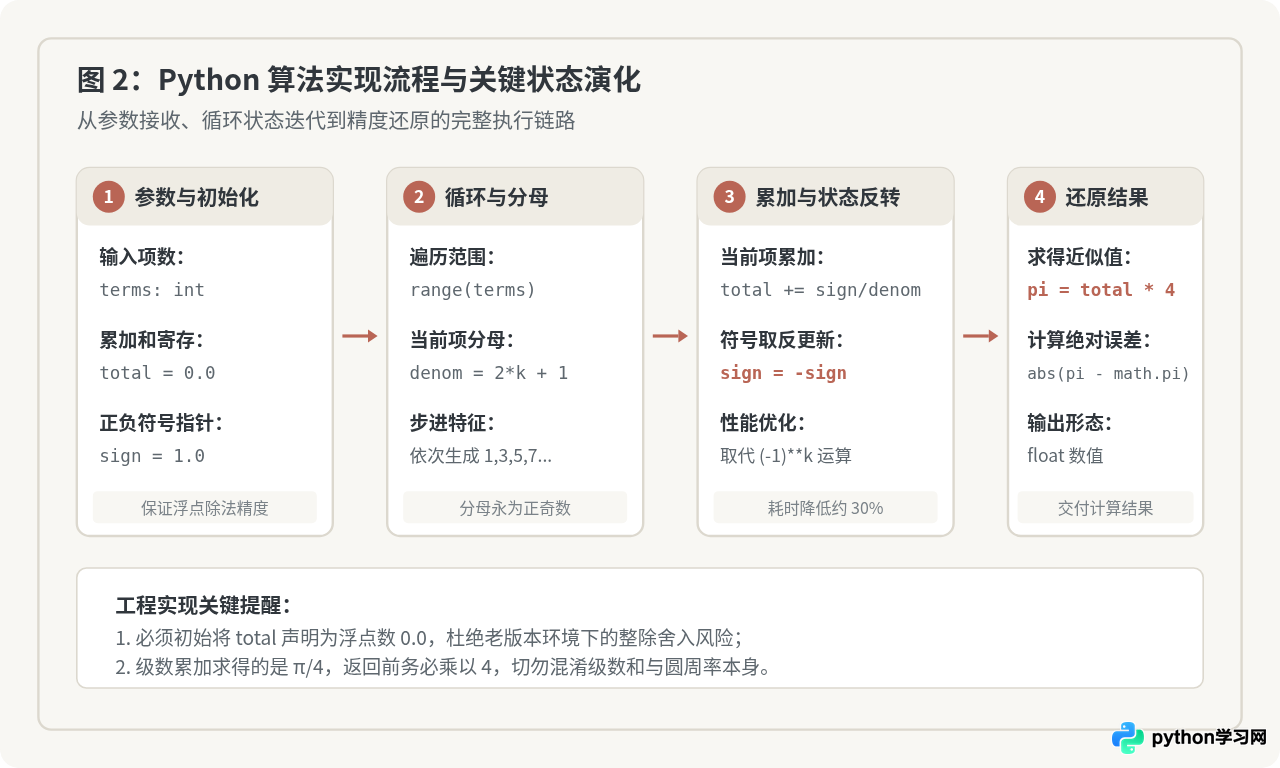
在 Python 中实现该算法时,最直观的想法是使用 for 循环按项索引 k 遍历,并利用 (-1) ** k 产生正负号。然而在大量迭代场景下,幂运算 ** 具有不必要的性能开销。更清晰且高效的工程做法是维护一个符号变量,在每次循环结束时执行 sign = -sign 状态翻转。
1. 基础实现版本
下面给出最直观的单层循环实现代码,该代码定义了计算函数,并注明了必要的类型标注与初始变量:
def calculate_pi_leibniz(terms: int) -> float:
    """
    使用莱布尼茨级数计算圆周率近似值
    :param terms: 迭代项数(必须为正整数)
    :return: 计算出的 pi 近似浮点数
    """
    if terms <= 0:
        raise ValueError("terms 必须是大于 0 的正整数")

    total = 0.0       # 累加和必须初始化为浮点数
    sign = 1.0        # 初始项符为正 (+1.0)

    for k in range(terms):
        denominator = 2 * k + 1
        total += sign / denominator
        sign = -sign  # 翻转符号,替代昂贵的 (-1) ** k 幂运算

    return total * 4.0  # 级数和为 pi/4,最后乘以 4 还原
这段代码中包含两处关键的数值细节:
- 累加器初始为浮点数
0.0:保证参与加减运算的操作数保持浮点上下文,避免隐式类型转换的额外损耗。 - 符号翻转单目取负:
sign = -sign仅涉及底层整数或浮点数的符号位变换,比在每个循环步中调用pow(-1, k)或(-1)**k速度更快,代码结构也更为纯粹。
三、执行结果验证与完整示例脚本
为了让结果可以客观检验,我们需要编写一段驱动脚本,将估算结果与 Python 标准库 math.pi 的真值进行对比,并输出绝对误差。
import math

def run_demo():
    test_terms = [10, 100, 1_000, 10_000, 100_000, 1_000_000]

    print(f"真实 math.pi 参考值: {math.pi:.10f}
")
    print(f"{'项数 (terms)':<14} {'估算值 (pi)':<16} {'绝对误差':<14} {'相对精度'} ")
    print("-" * 60)

    for n in test_terms:
        approx_pi = calculate_pi_leibniz(n)
        error = abs(approx_pi - math.pi)
        print(f"{n:<14} {approx_pi:<16.8f} {error:<14.8f} {'±' + str(round(error, 6))}")

if __name__ == "__main__":
    run_demo()
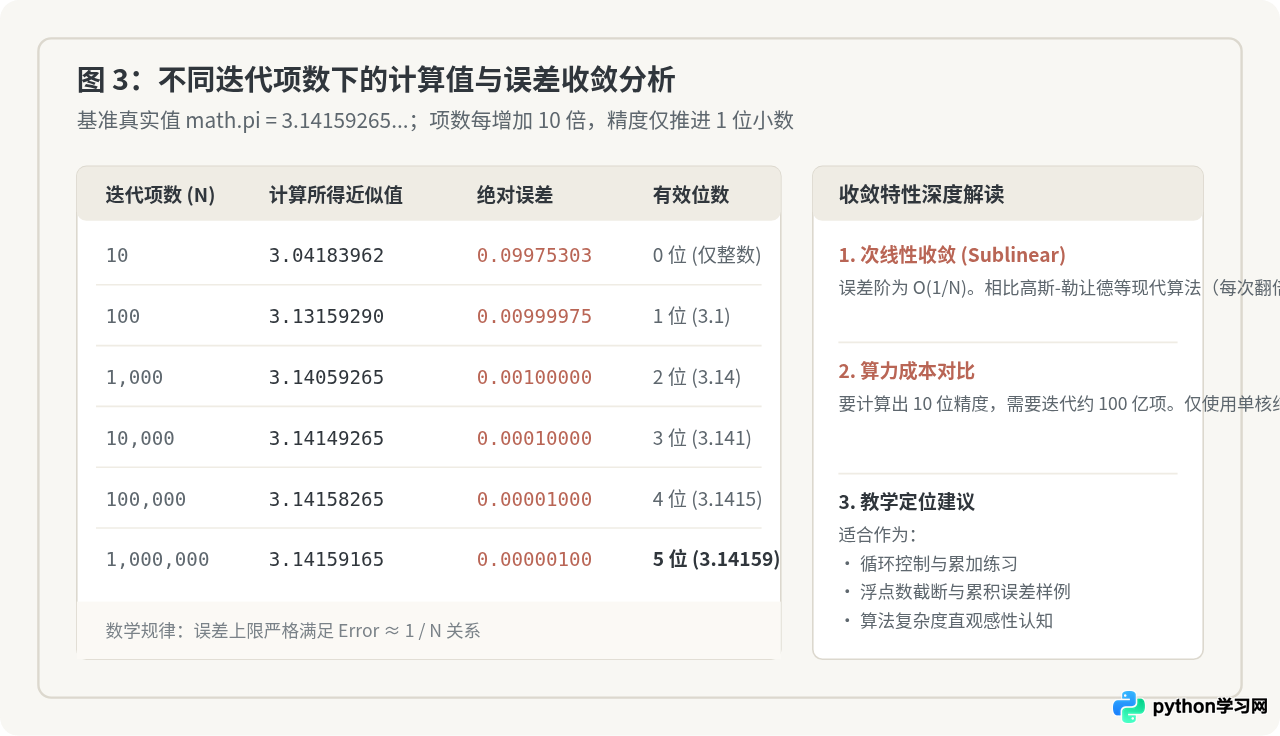
运行该脚本后的典型示例输出如下:
真实 math.pi 参考值: 3.1415926536

项数 (terms)   估算值 (pi)       绝对误差         相对精度
------------------------------------------------------------
10             3.04183962       0.09975303     ±0.099753
100            3.13159290       0.00999975     ±0.01
1000           3.14059265       0.00100000     ±0.001
10000          3.14149265       0.00010000     ±0.0001
100000         3.14158265       0.00001000     ±1e-05
1000000        3.14159165       0.00000100     ±1e-06
3.14159... 的过程。但同时也暴露出一个关键事实:当项数从 10 扩大 100,000 倍达到 1,000,000 项时,计算结果才勉强精确到小数点后第 5 位。
四、收敛速度剖析与精度瓶颈分析
通过上面的实测数据,我们可以从数学层面准确理解莱布尼茨级数的收敛瓶颈。交错级数的审敛定理给出了严格的余项界定:
| 项数数量级 | 循环耗时估算 | 所得有效小数位数 | 理论误差上限 (4 / (2N + 1)) |
|---|---|---|---|
| N = 10^2 (一百) | < 0.001 秒 | 1 位小数 (3.1) | ~ 0.0199 |
| N = 10^4 (一万) | ~ 0.002 秒 | 3 位小数 (3.141) | ~ 0.0002 |
| N = 10^6 (一百万) | ~ 0.15 秒 | 5 位小数 (3.14159) | ~ 0.000002 |
| N = 10^8 (一亿) | ~ 12 秒 | 7 位小数 | ~ 0.00000002 |
| N = 10^10 (一百亿) | 数十分钟 (纯Python单核) | 9 位小数 | ~ 0.0000000002 |
这意味着莱布尼茨级数属于典型的次线性收敛(Sublinear Convergence)。项数每提升一个数量级(乘以 10),我们仅仅能够获得多 1 位有效小数。如果要达到双精度浮点数的 15~16 位极限,理论上需要进行超过 10^16 次循环迭代,这在实际工程算力上是完全无法接受的。
此外,当循环项数极大(如达到数亿次以上)时,计算机内部的 64 位浮点数(IEEE 754 标准)有限尾数精度会导致“大数加小数”的截断误差累加,进一步削弱后续计算的收益。
五、常见实现陷阱与注意事项
初学者在编写该算法时,往往容易踩入以下几个细微但致命的陷阱:
- 漏乘系数 4:公式给出的左侧是
π / 4,而不是π。如果函数直接返回累加变量total,得到的值将约为0.785398,导致逻辑错误。 - 分母未保持奇数递增:部分实现误将分母写为
2 * k或直接k,破坏了公式结构。分母序列必须严格从 1 开始按步长 2 递增(即2k + 1)。 - 幂操作导致性能劣势:在
range(10_000_000)等较长循环中使用(-1) ** k会产生巨大的开销。改用sign = -sign能够显著降低 CPU 执行时间。
六、全文总结与工程选型建议
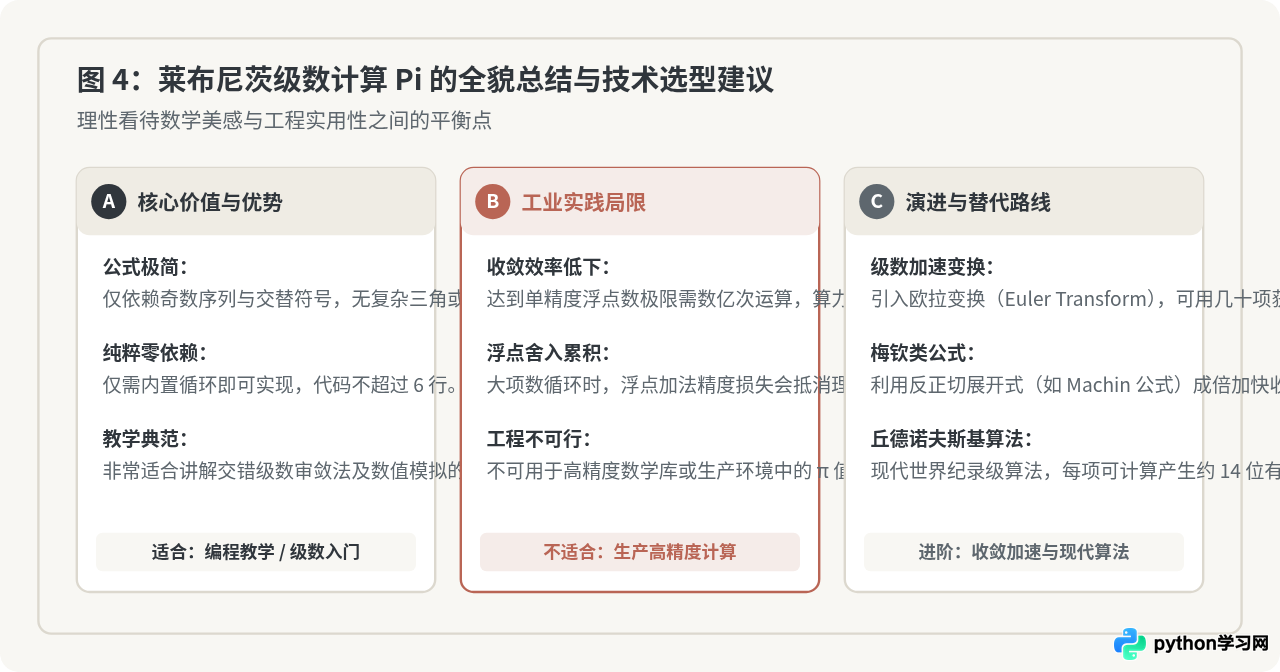
用 Python 实现莱布尼茨级数计算 Pi 是理解算法设计、循环结构以及数值分析的基础练习。它的主要技术定位可以归纳为两点:
- 学习与演示的首选载体:公式逻辑纯粹直观,不需要调用复杂的第三方外部数学库,仅用 6 行标准 Python 语法就能完整还原数学家的推导思想,是理解无穷级数离散逼近过程的范例。
- 生产高精度计算必须换用其他方案:在工程计算或科学仿真中,绝不应直接使用莱布尼茨级数生成高精度 π 值。如需快速收敛,应优先采用基于反正切函数的梅钦类公式(Machin-like formula),或现代计算圆周率世界纪录所采用的丘德诺夫斯基算法(Chudnovsky algorithm,每项即可贡献约 14 位有效数字)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









