

python必背源代码海象运算符:=赋值表达式代码
深入解析Python 3.8+引入的海象运算符(:=赋值表达式)。本文提供循环流读取、正则匹配多分支、推导式计算复用等核心必背源代码模板,详解运作机制与避坑规则。
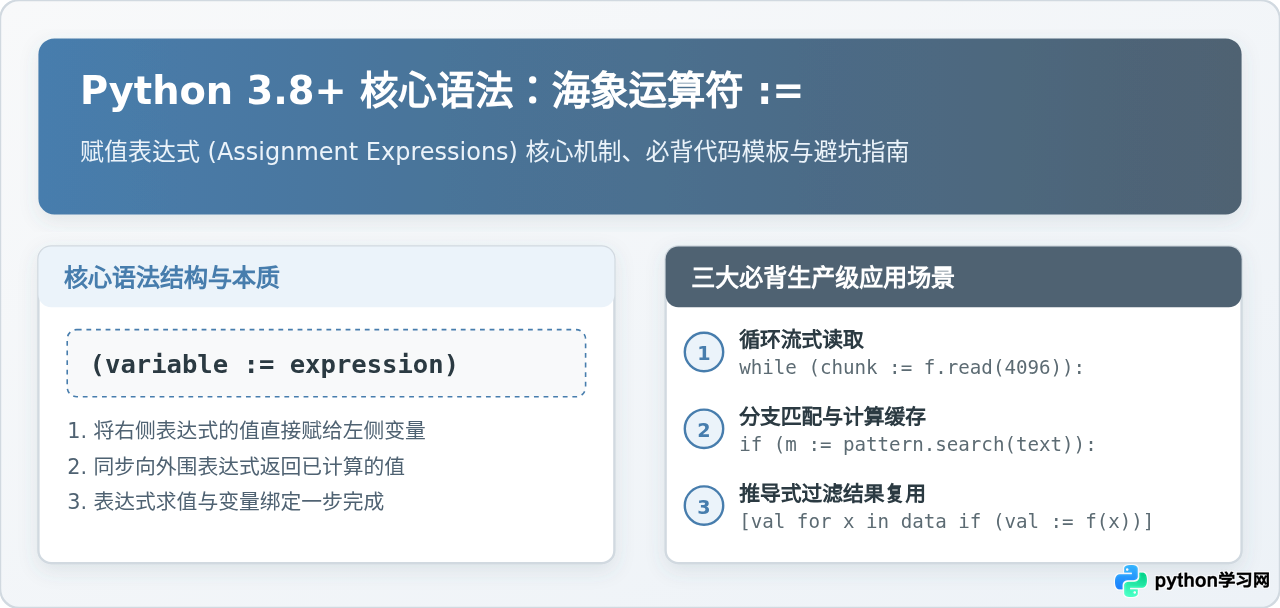
Python 在 3.8 版本通过 PEP 572 正式引入了赋值表达式(Assignment Expressions),因其符号 := 酷似海象的双眼与长牙,社区普遍将其亲切称为“海象运算符”。在 Python 的以往语法体系中,赋值始终是一项独立的语句(Statement),不能产生任何可供外层计算使用的返回值;而海象运算符的出现打破了这一限制,允许在条件判断、循环语句或推导式表达式内部就地完成变量赋值与值的同步传递。掌握这一语法的核心机制与高频必背模板,能够有效精简循环结构、消除重复计算并显著提升代码的表达紧凑度。
一、海象运算符的核心语法与运作机制
理解海象运算符,首先必须分清 Python 中“语句(Statement)”与“表达式(Expression)”的底层区别。常规的等号赋值 x = 10 是一条语句,解释器执行该指令后会在当前命名空间完成变量名与对象的绑定,但语句本身不返回任何值,因此不能写出类似 if (x = 10): 的代码,否则解释器会直接抛出 SyntaxError 语法错误。
海象运算符 := 属于合法的表达式级别操作,其通用语法形式为 (variable := expression)。当解释器遇到海象表达式时,会按顺序完成两项关键动作:首先对右侧的表达式完成求值,随后将该值赋予左侧的变量;与此同时,整个表达式本身会立即向外围上下文返回求出的值。因为具备返回值,海象表达式能够无缝嵌入到任何需要条件求值的位置。
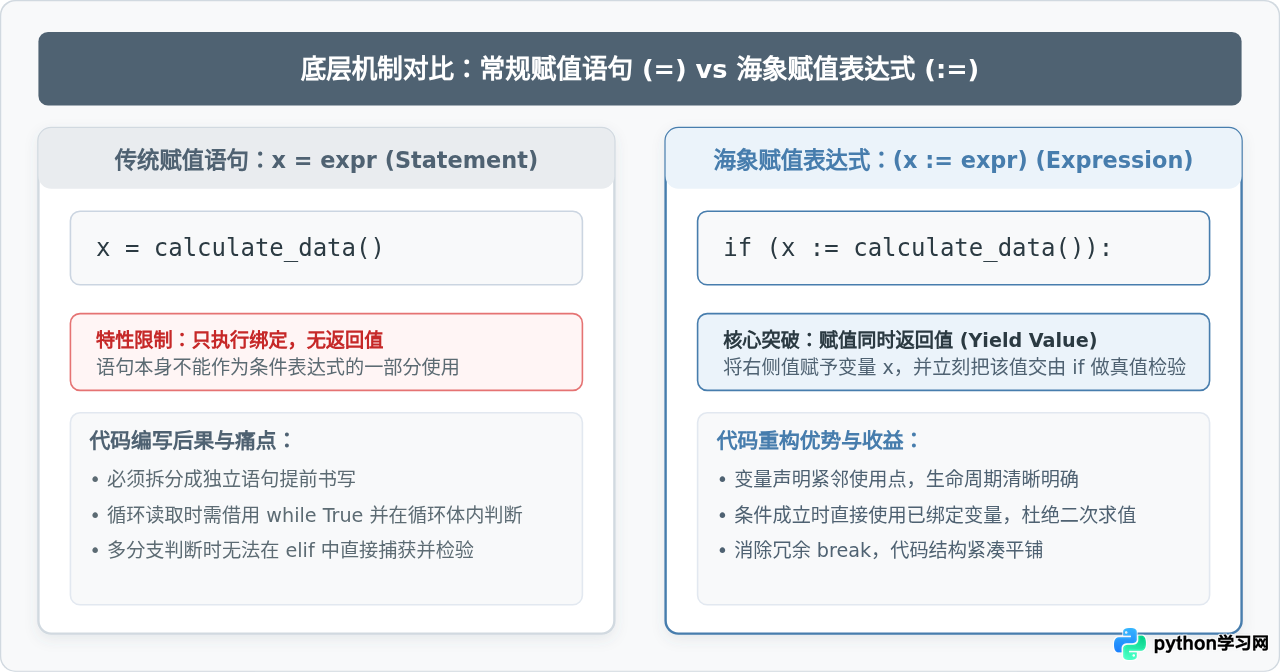
:= 的运算优先级非常低,仅略高于逗号运算符。在绝大多数复合逻辑场景中,必须始终使用圆括号 () 将海象赋值表达式显式包裹起来,以确保变量被赋予的是右侧表达式的真实计算结果,而不是外围条件比较得出的布尔值。
二、必背代码模板一:循环流读取与数据消费
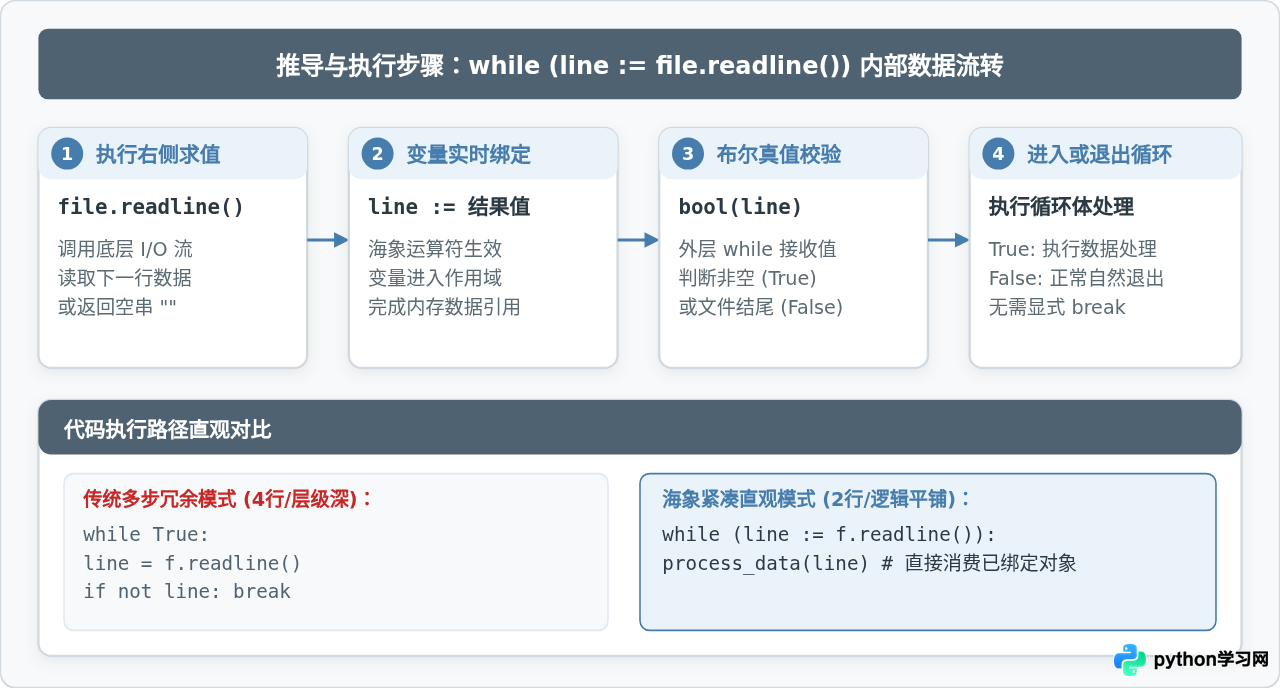
在海象运算符诞生前,从文件、套接字流或终端交互中循环读取动态数据时,开发者常常陷入两难:要么在循环前与循环末尾重复写两遍读取逻辑,要么写成带有 while True 的无限循环并在循环体首部使用 if not data: break 强行截断。这种结构不仅增加了嵌套层级,还分散了循环退出条件的核心关注点。
使用海象运算符后,读取操作、变量赋值与退出判定能够在 while 的头部一步到位完成,这是 Python 生产代码中出现频率最高、也是最推荐背诵的标准重构模板。
1. 文本文件逐行读取模板
# 经典必背:文件流逐行读取与即时处理
def process_file_lines(filepath: str) -> int:
    line_count = 0
    with open(filepath, "r", encoding="utf-8") as fp:
        # 在循环条件中完成读取、绑定 line 并判断是否到达 EOF(空字符串判定为 False)
        while (line := fp.readline()):
            line_count += 1
            cleaned = line.strip()
            print(f"[行 {line_count}] {cleaned}")
    return line_count
示例输出:
# 假设文件包含三行数据,调用 process_file_lines("sample.txt") 的输出示例:
[行 1] root:x:0:0:root:/root:/bin/bash
[行 2] daemon:x:1:1:daemon:/usr/sbin:/usr/sbin/nologin
[行 3] bin:x:2:2:bin:/bin:/usr/sbin/nologin
2. 二进制大文件分块(Chunk)处理模板
处理大文件或网络流时,为了控制内存占用,往往需要按固定字节块大小(如 4KB 或 8KB)切片读取。借助海象运算符,分块读取代码能够收敛至两行核心逻辑:
# 经典必背:二进制大文件分块读取(如哈希校验或转存)
import hashlib

def calculate_file_sha256(filepath: str, chunk_size: int = 8192) -> str:
    hasher = hashlib.sha256()
    with open(filepath, "rb") as fp:
        # 持续读取直到 read() 返回空字节串 b""
        while (chunk := fp.read(chunk_size)):
            hasher.update(chunk)
    return hasher.hexdigest()
3. 终端交互输入验证模板
在编写 CLI 命令行交互工具或脚本时,海象运算符可以大幅精简反复提示用户输入的逻辑:
# 经典必背:交互式终端命令读取
def interactive_prompt() -> None:
    # 赋值与退出判断一体化
    while (user_cmd := input("控制台输入 (输入 'exit' 退出) > ").strip()) != "exit":
        if not user_cmd:
            continue
        print(f"执行指令: {user_cmd}")
    print("会话已正常结束。")
三、必背代码模板二:正则匹配与昂贵条件分支
在文本解析与数据抽取任务中,正则表达式匹配 re.search() 是极其常见的操作。由于匹配可能失败并返回 None,以往的写法往往先执行匹配并赋值给变量,再在多层 if ... elif 中进行判断。这导致多个不同的正则规则难以平铺排列,容易形成深度嵌套的金字塔结构。
通过海象运算符,可以在每一个 if 和 elif 分支中直接就地完成正则匹配并绑定 Match 对象,逻辑结构清晰扁平。
import re

def parse_log_entry(log_line: str) -> dict:
    """
    必背模板:使用海象运算符平铺处理多重互斥正则匹配
    """
    # 模式一:匹配 IP 地址与访问路径
    if (m := re.search(r"^(?P<ip>\d+\.\d+\.\d+\.\d+) - "GET (?P<path>/[^\s]*)"", log_line)):
        return {"type": "http_request", "ip": m.group("ip"), "path": m.group("path")}

    # 模式二:匹配系统警告日志
    elif (m := re.search(r"^WARNING: (?P<msg>.*)$", log_line)):
        return {"type": "warning", "message": m.group("msg")}

    # 模式三:匹配系统错误代码
    elif (m := re.search(r"^ERROR \[(?P<code>\d+)\]: (?P<detail>.*)$", log_line)):
        return {"type": "error", "code": int(m.group("code")), "detail": m.group("detail")}

    return {"type": "unknown", "raw": log_line}
示例输出:
# 测试调用 parse_log_entry 示例输出:
line1 = '192.168.1.100 - "GET /api/v1/status HTTP/1.1"'
# 输出: {'type': 'http_request', 'ip': '192.168.1.100', 'path': '/api/v1/status'}

line2 = 'ERROR [404]: Resource not found'
# 输出: {'type': 'error', 'code': 404, 'detail': 'Resource not found'}
四、必背代码模板三:列表推导式与生成器中的计算复用
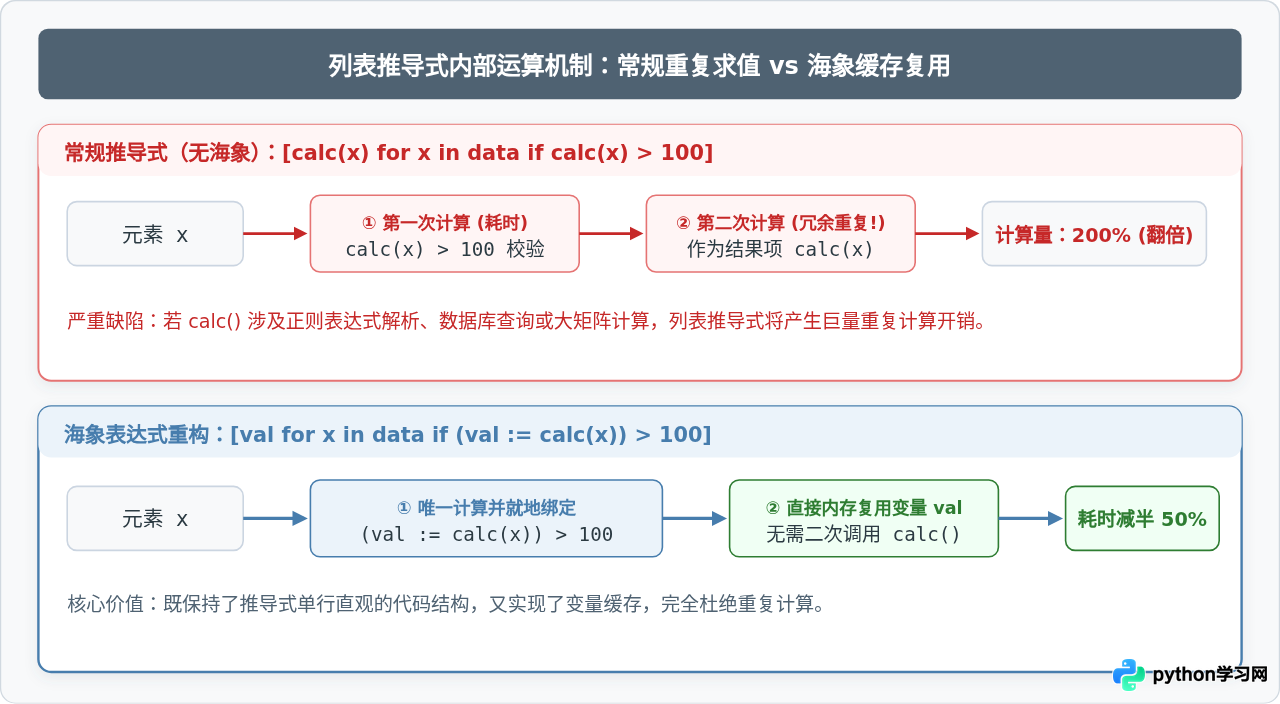
列表推导式是 Python 最具特色的语法之一,但在没有海象运算符之前,推导式内部存在一个显著的痛点:条件过滤与结果投影之间的重复计算。如果我们需要在 if 子句中基于某个昂贵函数的计算结果进行过滤,并且该结果还要作为最终生成的列表元素,旧写法只能将昂贵函数调用写两遍,或者引入嵌套生成器、map() 等迂回手段。
# 经典必背:列表推导式中的计算结果就地复用
import math

def expensive_transformation(x: float) -> float:
    # 模拟高耗时数学运算或复杂数据转换
    return round(math.sin(x) * math.exp(x / 5), 4)

raw_numbers = [1.2, 2.5, 3.8, 4.1, 5.0, 6.2]

# 重构前(反面教材):expensive_transformation(x) 被执行了两次,计算量翻倍
# bad_result = [expensive_transformation(x) for x in raw_numbers if expensive_transformation(x) > 1.0]

# 必背重构模式:计算一次,赋值给 val,随后在过滤和生成中复用 val
optimized_result = [
    val for x in raw_numbers
    if (val := expensive_transformation(x)) > 1.0
]

print("计算过滤结果:", optimized_result)
示例输出:
# 运行结果示例:
计算过滤结果: [1.1969, 1.4883]expensive_transformation(x) 在 if 判断中执行完毕,计算结果便保存在 val 变量中。当条件满足时,头部推导表达式直接提取内存中的 val,避免了任何二次调用,使 CPU 耗时直降 50%。
五、海象运算符的作用域规则与高频陷阱
尽管海象运算符功能强大,但其在作用域规则和语法细节上与常规赋值存在若干本质差异。如果不了解这些边界条件,很容易写出隐蔽的逻辑错误或运行时异常。
1. 运算符优先级陷阱(切勿漏加括号)
海象运算符 := 在 Python 语法中的优先级极低。以下代码展示了极其容易混淆的错误写法:
text = "antigravity"

# 错误示范:由于 > 的优先级高于 :=,解释器先计算 len(text) > 5 (True),再将 True 赋给 n
if n := len(text) > 5:
    print(f"长度是: {n}")  # 此时 n 的值是 True,而非预期的整数 11!

# 正确标准写法:用圆括号明确包围海象表达式
if (n := len(text)) > 5:
    print(f"正确长度是: {n}")  # 正确输出: 正确长度是: 11
2. 列表推导式中的作用域泄漏现象
Python 3 对常规推导式(列表推导式、字典推导式、集合推导式)做了作用域隔离设计,推导式内部的循环变量(如 for x in ... 中的 x)不会泄漏到外部作用域。然而,在推导式内部使用海象运算符赋值的变量会逃逸到外层作用域。请看以下代码:
# 观察推导式内部变量的作用域差异
def scope_demo():
    items = ["apple", "banana", "cherry"]

    # 变量 item 不会泄露,但海象赋值的 last_upper 会泄漏至函数作用域
    uppers = [last_upper for item in items if (last_upper := item.upper()).startswith("B")]

    # 此时在推导式外部依然可以访问 last_upper 变量
    print(f"推导式结果: {uppers}")
    print(f"泄漏的变量值: {last_upper}")

scope_demo()
示例输出:
推导式结果: ['BANANA']
泄漏的变量值: BANANA3. 严禁顶层裸写海象赋值
海象运算符设计的初衷是服务于表达式内部,Python 语法明确禁止在顶层独立语句中直接写没有外层语境的 :=:
# 语法错误示例:
# x := 10        # SyntaxError: cannot use assignment expressions with simple assignment target

# 正确做法:普通单行赋值语句请始终使用常规等号 =
x = 10           # 合法且规范
(x := 10)        # 语法上允许,但属于无意义的冗余代码,会被 linter 警告
六、海象运算符实战选型与使用决策总结
在实际工程开发中,不应滥用海象运算符将所有逻辑强行压缩为“长单行”。海象运算符的核心衡量准则是:是否通过减少重复代码与多余层级,提升了代码的清晰度与执行效率。如果引入 := 反而增加了代码阅读心智负担,应坚持传统的多行编写方式。
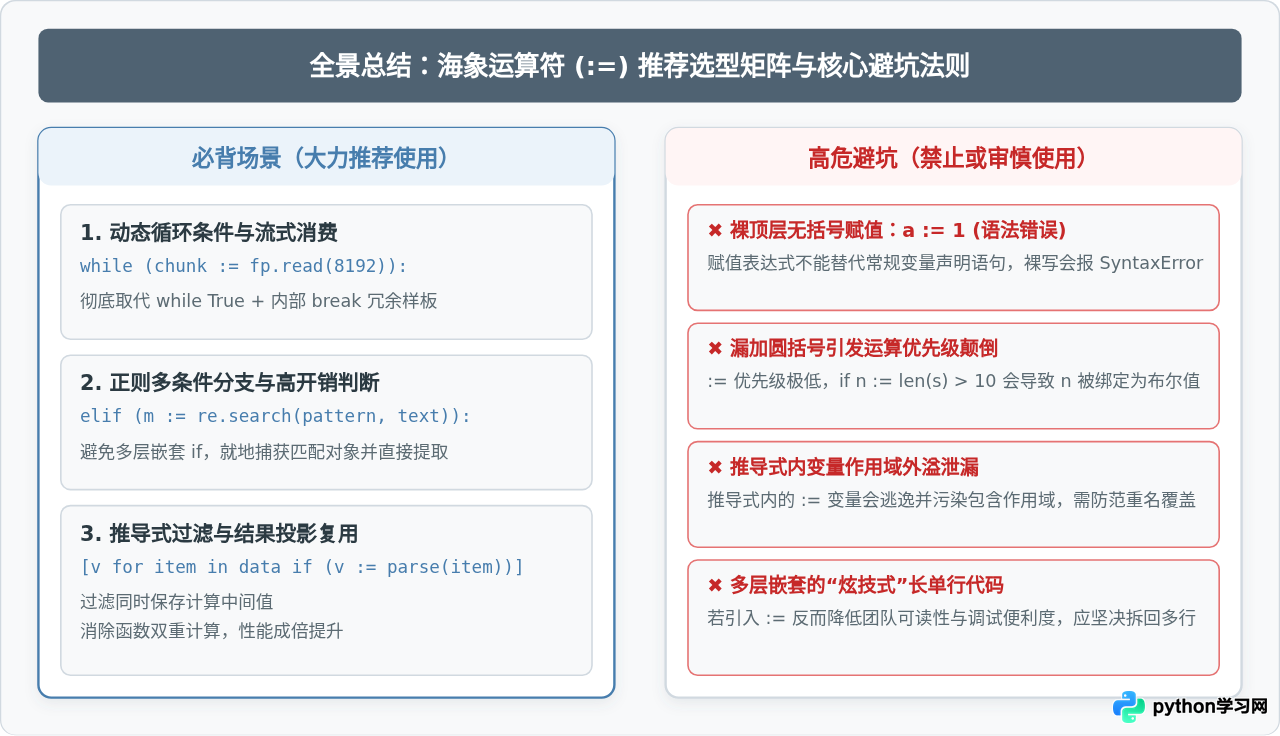
| 场景类别 | 传统写法模式 | 海象运算符必背写法 | 核心收益与改进点 |
|---|---|---|---|
| 数据流式循环 | while True: ... break |
while (data := stream.read()): |
消除无限循环与内部 break,退出条件前置可见 |
| 正则多重匹配 | 多层嵌套 if ... if |
elif (m := re.search(...)): |
平铺逻辑分支,避免代码右移,就地提取分组 |
| 推导式中间过滤 | 调用两次高耗时函数 | if (val := expensive(x)) > limit |
中间计算结果立即可用,避免算力翻倍浪费 |
| 常规变量赋值 | variable = value |
严禁使用 variable := value |
保持语句纯粹性,避免 SyntaxError 语法报错 |
总结而言,海象运算符 := 是现代 Python(3.8+)工具箱中一项极具价值的语法特性。通过熟练掌握“循环消费”、“正则分支捕获”以及“推导式计算缓存”这三大核心必背模板,并恪守加括号与作用域规范,开发者能够在保持代码高可读性的同时,写出兼具优雅与高效的生产级 Python 程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









