

Python列表转NumPy数组怎么操作?常见类型错误解决
全面讲解Python原生列表转换为NumPy数组的核心操作与参数配置,深入剖析np.array与np.asarray的区别、显式类型声明技巧,并针对不规则嵌套、隐式类型提升、字符串强转异常等常见类型错误提供详实的排查与修复方案。
list)转为 NumPy 数组(ndarray)是最常用的前置步骤。常规场景仅需一行 np.array() 即可完成转换,但在处理非规则嵌套数据、混合类型或字符数值混排时,极易诱发 ValueError 异常或隐式的全局类型污染(如数值全部静默沦为字符串)。本文通过梳理标准转换方法、对比核心参数差异,并针对三类典型类型错误给出具体的排查与修复方案。
一、Python 列表转 NumPy 数组的标准操作方法
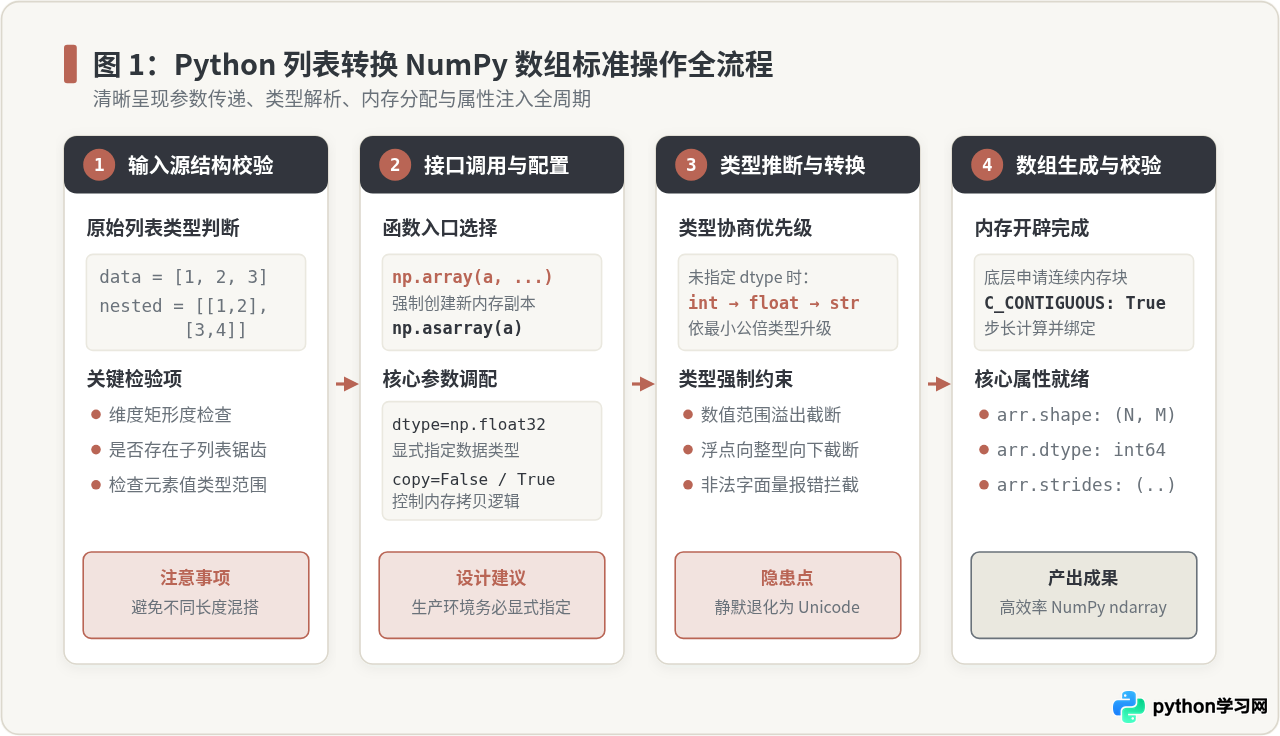
将 Python 列表转为 NumPy 数组,主要使用 NumPy 提供的两个核心工厂函数:np.array() 与 np.asarray()。两者的核心区别在于是否无条件开辟新的内存副本。
1. 一维与多维列表的标准转换
对于结构规则的一维或嵌套二维列表,传入 np.array() 即可自动识别维度结构并完成转换:
import numpy as np

# 1. 一维列表转换
list_1d = [10, 20, 30, 40]
arr_1d = np.array(list_1d)
print("一维数组:", arr_1d)
print("数据形状与类型:", arr_1d.shape, arr_1d.dtype)
# 示例输出:
# 一维数组: [10 20 30 40]
# 数据形状与类型: (4,) int64

# 2. 规则嵌套二维列表转换
list_2d = [[1, 2, 3], [4, 5, 6]]
arr_2d = np.array(list_2d)
print("二维数组:
", arr_2d)
print("维度数与形状:", arr_2d.ndim, arr_2d.shape)
# 示例输出:
# 二维数组:
#  [[1 2 3]
#   [4 5 6]]
# 维度数与形状: 2 (2, 3)
2. 显式指定数据类型(dtype)
如果在转换时不指定 dtype,NumPy 会根据系统架构和列表中的元素自动推断类型(如在 64 位系统上推断为 int64 或 float64)。在生产环境下,为了节省内存占用或对齐后续模型接口(例如 PyTorch 默认要求的 float32),建议显式指明目标类型:
# 显式转换为 32 位浮点数以节省一半内存开销
raw_list = [1, 2, 3, 4]
arr_float32 = np.array(raw_list, dtype=np.float32)

print("元素类型:", arr_float32.dtype)
print("每个元素占用字节数:", arr_float32.itemsize)
# 示例输出:
# 元素类型: float32
# 每个元素占用字节数: 4
3. np.array 与 np.asarray 的内存机制差异
当输入源本就已经是 ndarray 或其派生对象时,两者的行为存在本质不同:
np.array()默认设置参数copy=True,总是深拷贝一份全新的物理连续内存缓冲区。np.asarray()如果检测到输入已是满足条件的ndarray(且未要求类型转换),则直接复用原有数据并返回浅拷贝视图(View),避免无谓的内存分配开销。
二、底层存储机制:为什么会出现类型冲突?
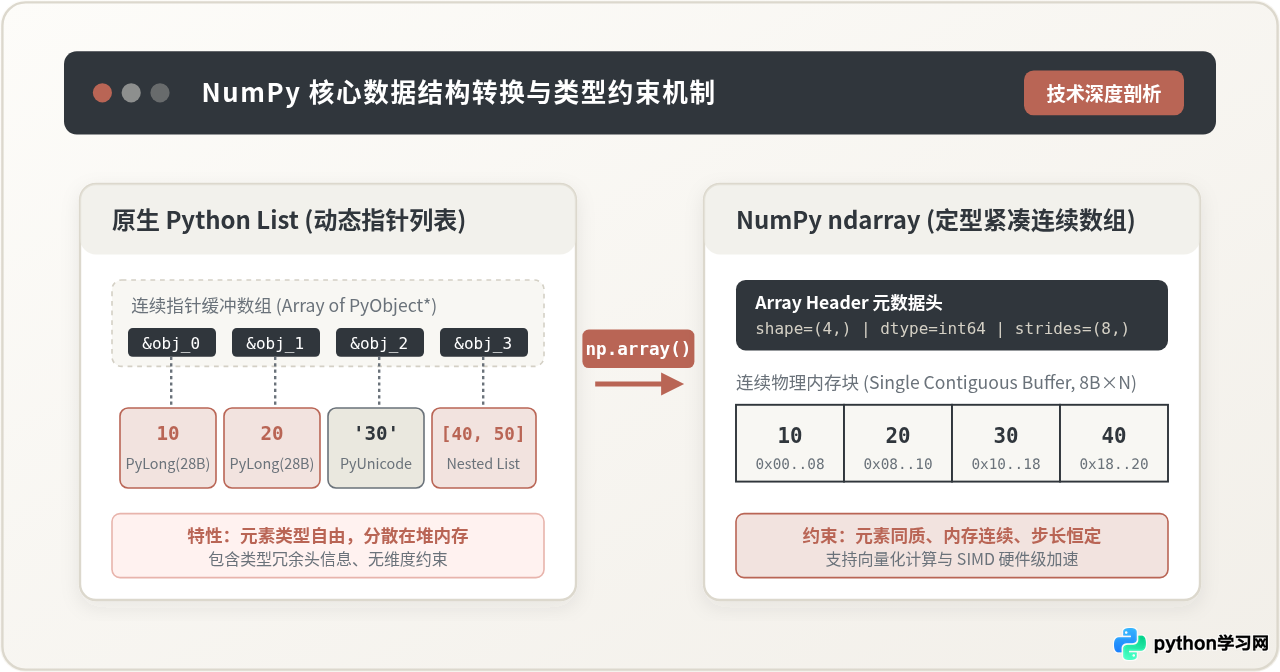
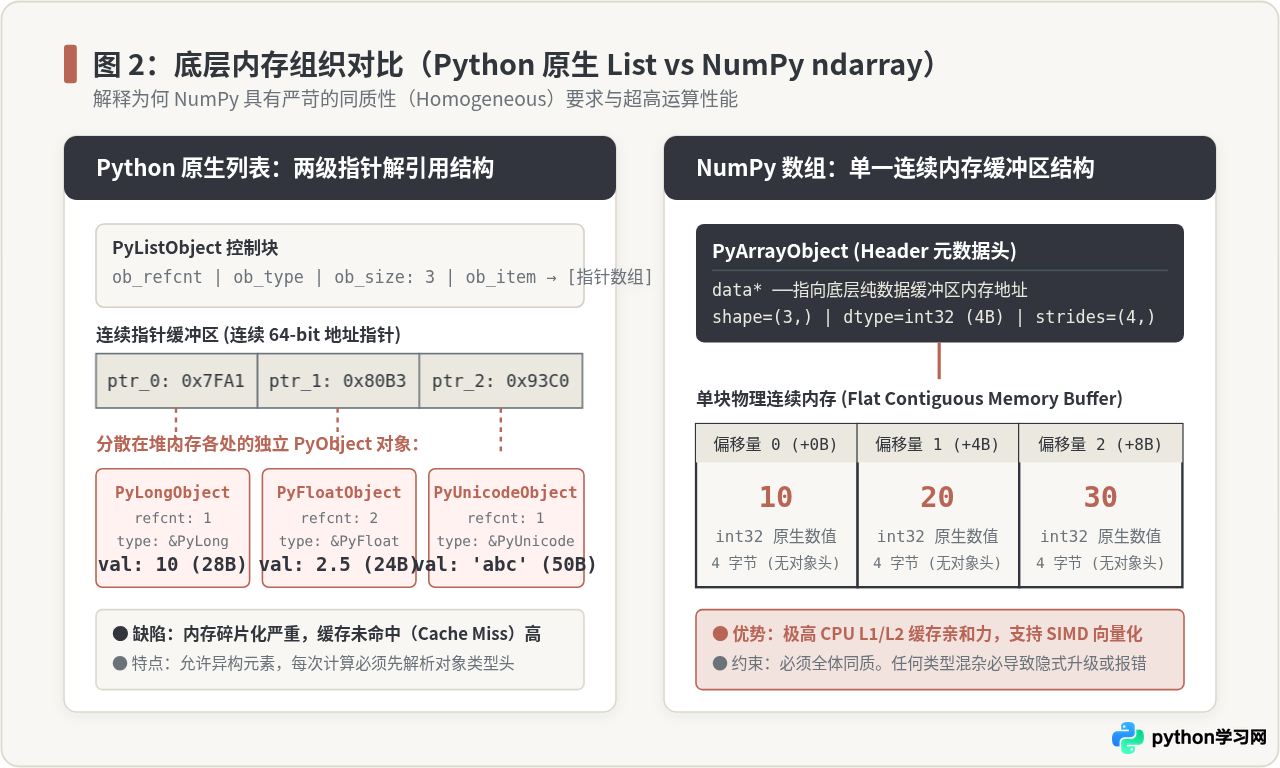
理解转换过程中的报错与异常现象,必须看清 Python 原生列表与 NumPy 数组在底层 C 语言实现上的根本差异:
| 对比维度 | Python 原生列表 (PyListObject) | NumPy 数组 (PyArrayObject) |
|---|---|---|
| 存储实质 | 指针数组,存储的是指向堆内存对象的地址指针(PyObject*) |
单一连续的原始字节块(Data Buffer),直接存放纯数值二进制 |
| 类型要求 | 高度自由的异构性(同一个列表可同时放整数、字符串、列表) | 严格的同质性(Homogeneous),所有元素的数据类型和字节宽度必须完全一致 |
| 多维表达 | 多级指针嵌套(列表内部存放子列表指针) | 单一平铺的一维内存空间,通过 shape 和 strides(步长)做逻辑高维映射 |
| 寻址效率 | 存在二级解引用,CPU 缓存命中率低,无法利用现代 CPU 向量指令 | 连续地址单步自增,内存局部性极佳,全面激活 SIMD 向量化计算 |
正因为 NumPy 数组强制要求所有元素在底层共享同一个 dtype,一旦输入列表中混杂了不兼容的数据或不同长度的子结构,NumPy 内部的推断引擎就会受到挑战,进而引发类型强制提升或直接抛出错误。
三、常见类型错误诊断与解决方案
在实际操作中,输入数据通常源自爬虫、数据库、CSV 解析或用户输入,极易夹杂异常格式。以下是三类最高频的错误及其对应的解决路径。
1. 错误一:非规则嵌套导致的“锯齿列表”异常
当嵌套列表各行的长度不一致时,即构成了所谓的不规则数组(Ragged Nested Sequences)。在旧版 NumPy 中,此情况会静默退化为一个 dtype=object 的低效数组;而在较新的 NumPy 版本中,将直接抛出明确的异常或废弃警告:
# 错误示例:子列表元素长度不同(第一行 2 个,第二行 3 个)
ragged_list = [[1, 2], [3, 4, 5]]

# 执行转换
arr = np.array(ragged_list)
# 常见报错表现:
# ValueError: setting an array element with a sequence.
# 或在某些环境提示:
# VisibleDeprecationWarning: Creating an ndarray from ragged nested sequences...如果多维数据的语义允许,可以通过预填充默认占位符(如 0 或 np.nan),将每行的长度对齐到最大长度:
# 计算最大行长度并填充 np.nan
max_len = max(len(row) for row in ragged_list)
padded_list = [row + [np.nan] * (max_len - len(row)) for row in ragged_list]

arr_padded = np.array(padded_list, dtype=np.float64)
print("对齐填充后的数组:
", arr_padded)
# 示例输出:
# 对齐填充后的数组:
#  [[ 1.  2. nan]
# [ 3. 4. 5.]]如果确实需要保存变长序列,必须显式传递 dtype=object。需要注意,此时该数组本质上退化回了指针数组,失去了向量化计算的高性能加成:
arr_obj = np.array(ragged_list, dtype=object)
print("Object 数组:", arr_obj)
print("数组类型:", arr_obj.dtype)
# 示例输出:
# Object 数组: [list([1, 2]) list([3, 4, 5])]
# 数组类型: object
2. 错误二:混合数据类型的隐式提升与静默污染
当 Python 列表中同时包含数值与非数值(如误混入字符串),NumPy 不会报错,而是会根据最小公倍规则将全体元素向更高表达能力的类型提升。最典型的灾难就是整组数据沦为定长 Unicode 字符串(形如 <U21 或 <U32),导致后续的数学乘除全部崩溃:
# 列表中混杂了一个由脏数据产生的数字字符串
mixed_list = [10, 20, '30', 40]

arr_polluted = np.array(mixed_list)
print("推断出的类型:", arr_polluted.dtype)
print("数组内容:", arr_polluted)

# 此时尝试进行数值运算
try:
    result = arr_polluted * 2
except TypeError as e:
    print("运算报错:", e)

# 示例输出:
# 推断出的类型: <U21
# 数组内容: ['10' '20' '30' '40']
# 运算报错: ufunc 'multiply' did not contain a loop with signature matching types...解决此类问题有两个核心抓手:一是在构造数组时显式传入数值类型(如 dtype=float),让非法元素在转换边界即时暴露;二是在传入前进行列表推导清洗:
# 方式 1:利用 dtype 进行转换(如字符串为纯数字可成功转换)
arr_clean = np.array(mixed_list, dtype=np.int64)
print("强制规范类型后:", arr_clean.dtype, arr_clean * 2)
# 示例输出:强制规范类型后: int64 [20 40 60 80]

# 方式 2:防御性前置过滤(若列表中存在 None 或空文本)
raw_data = [10, 20, "", None, 50]
sanitized = [float(x) if (x is not None and x != "") else np.nan for x in raw_data]
arr_safe = np.array(sanitized, dtype=np.float64)
print("清洗后数组:", arr_safe)
# 示例输出:清洗后数组: [10. 20. nan nan 50.]
3. 错误三:浮点数字符串直接强转整型的转换异常
在通过 astype(int) 或在 np.array(..., dtype=int) 中解析包含小数点的字符串列表时,底层 C 语言解析器无法直接将带小数点的字符字面量解释为整型,从而抛出经典的 ValueError:
str_floats = ['1', '2.5', '3']

# 直接强制转换为整型
try:
    np.array(str_floats, dtype=int)
except ValueError as e:
    print("捕获到异常:", e)

# 示例输出:
# 捕获到异常: invalid literal for int() with base 10: '2.5'针对包含小数位文本的列表,必须先将其解析为浮点类型,再依业务需要截断或四舍五入为整型:
# 方式 1:标准两阶段类型转换
arr_step1 = np.array(str_floats, dtype=np.float64)
arr_step2 = arr_step1.astype(np.int64)  # 向下截断取整
print("两阶段转换结果:", arr_step2)
# 示例输出:两阶段转换结果: [1 2 3]

# 方式 2:使用 Pandas 优雅处理含破损字符的大规模数据
import pandas as pd
dirty_list = ['1.2', '3.4', 'N/A', 'invalid']
arr_numeric = pd.to_numeric(dirty_list, errors='coerce').to_numpy()
print("Pandas 容错解析结果:", arr_numeric)
# 示例输出:Pandas 容错解析结果: [1.2 3.4 nan nan]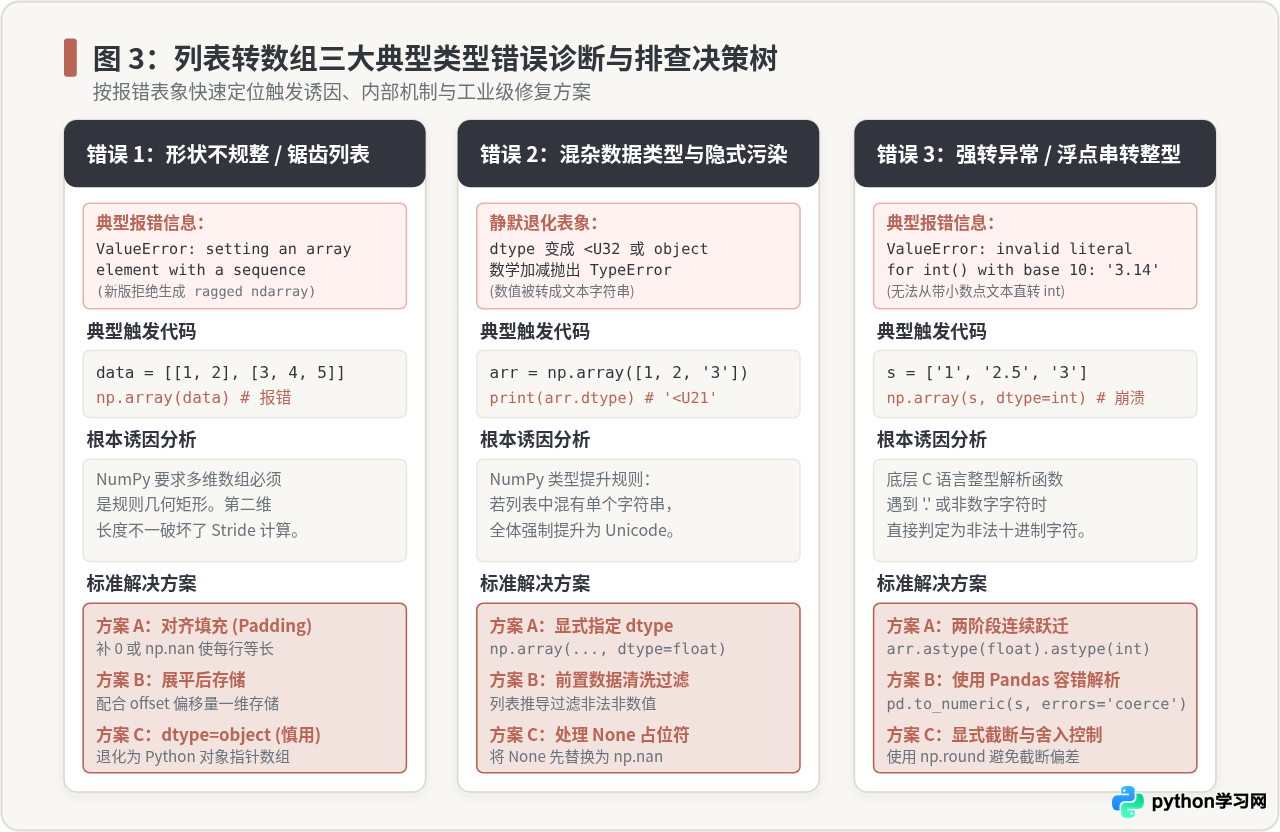
四、转换后的质量核验与工程最佳实践
完成列表转换后,切忌盲目直接进入后续算法或网络计算。建立严格的输出断言机制,能够杜绝绝大部分生产环境静默 Bug。
1. 关键属性的防御性断言
建议在封装数据转换函数时,加入以下四重属性核验:
def safe_list_to_numpy(data, expected_dim=2, target_dtype=np.float32):
    # 1. 显式构建并指定 dtype
    arr = np.array(data, dtype=target_dtype)

    # 2. 严防静默退化为 object 指针数组
    assert arr.dtype != object, "致命错误: 数组存在异构元素,退化为了 object 数组!"

    # 3. 维度与形状检查
    assert arr.ndim == expected_dim, f"维度不匹配: 期望 {expected_dim} 维,实为 {arr.ndim} 维"

    # 4. 验证内存连续性(确保无缝接入 C/Fortran 扩展)
    assert arr.flags['C_CONTIGUOUS'], "内存块非 C 连续!"

    return arr
2. 避免就地赋值引发的截断与类型报错
最后需要特别提醒:NumPy 数组一旦初始化完成,其在物理内存中的每个格子宽度已经焊死。如果向一个整型数组赋值浮点数,数值会被直接截断;而如果赋值字符串,则会直接抛出类型异常:
target_arr = np.array([1, 2, 3], dtype=np.int32)

# 现象 1:赋值浮点数发生静默向下截断
target_arr[0] = 9.99
print("截断后的首元素:", target_arr[0])  # 输出 9 而非 9.99

# 现象 2:赋值字符串直接崩溃
try:
    target_arr[1] = "hello"
except ValueError as e:
    print("向整型数组赋值字符串失败:", e)
# 示例输出:
# 截断后的首元素: 9
# 向整型数组赋值字符串失败: invalid literal for int() with base 10: 'hello'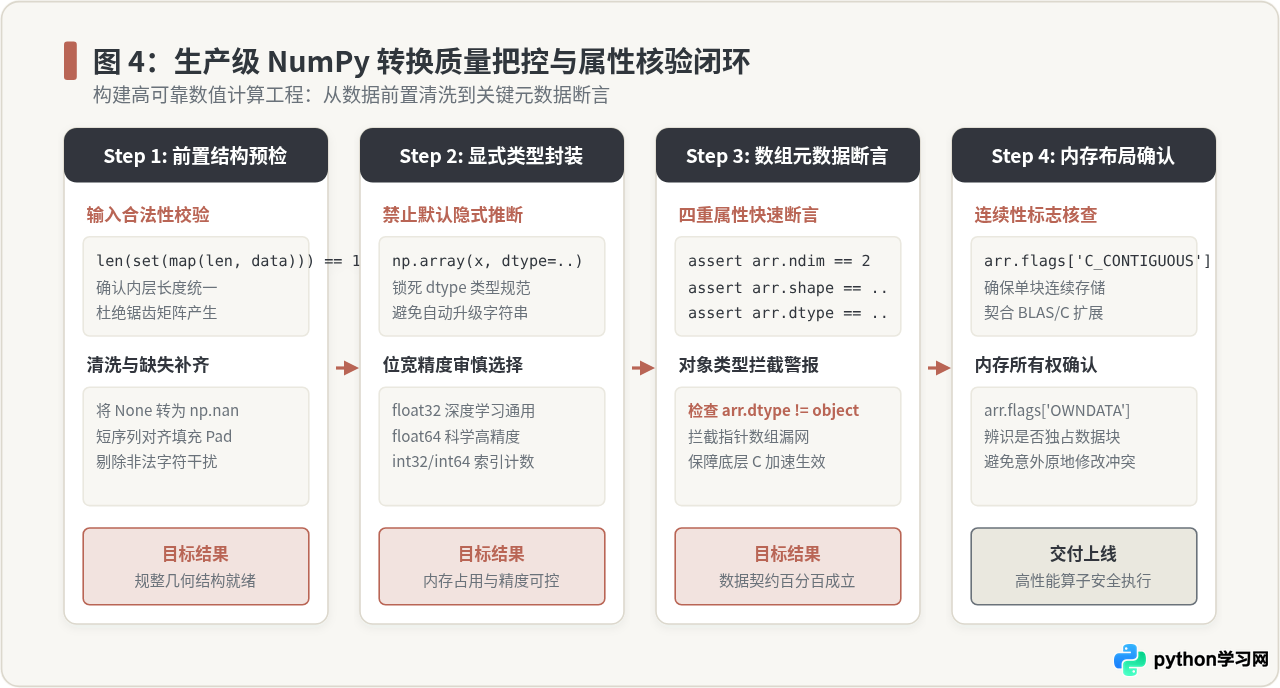
五、总结与速查清单
将 Python 原生列表转换为高效 NumPy 数组的核心要领可归纳为以下四点:
- 拒绝裸奔:转换时尽可能主动传入
dtype,明确指定float32、int64等具体数值类型,防止自动推断引入类型膨胀或静默退化。 - 对齐几何矩形:面对多维列表,务必在转换前保证各内层列表长度一致。遇到长短不一的序列,优先考虑填充(Padding)机制,非必要不使用
dtype=object。 - 隔离脏数据:对混合输入进行两阶段解析或前置清洗,防范字符串将整个数值数组污染为
<U文本类型。 - 属性闭环核验:在函数出口处主动对
arr.shape、arr.dtype和arr.flags进行断言,确保生成的数据能够真正发挥底层科学计算引擎的极致算力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









