

Python开发中何时该用标准库而非安装第三方包
深入解析Python开发中标准库与第三方包的选择边界,从交付环境、业务复杂度、供应链安全及维护成本四个维度提供清晰的选型步骤与实战对照。
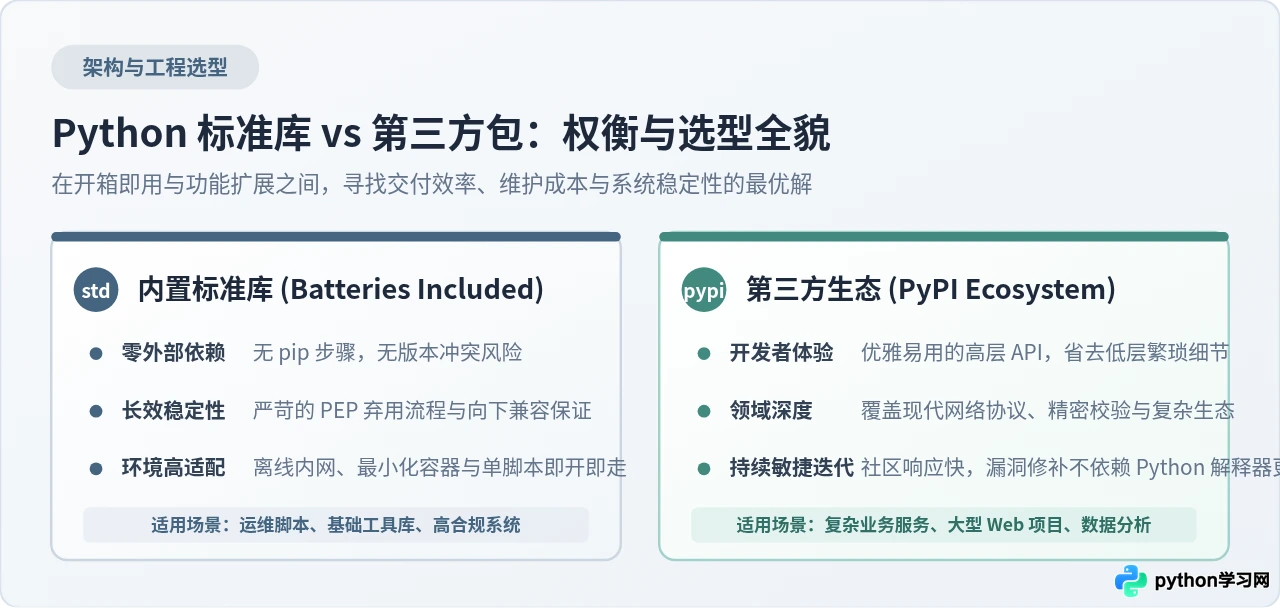
一、技术选型的四步评估流程
遇到新需求时直接在终端敲下 pip install 是许多开发者的惯性动作。然而,现代软件工程不仅仅关注“写出代码需要几分钟”,更关注代码在后续数年的构建、部署、审计与运行成本。通过以下四个步骤的递进判断,可以迅速明确当前模块是否应当收敛至标准库。
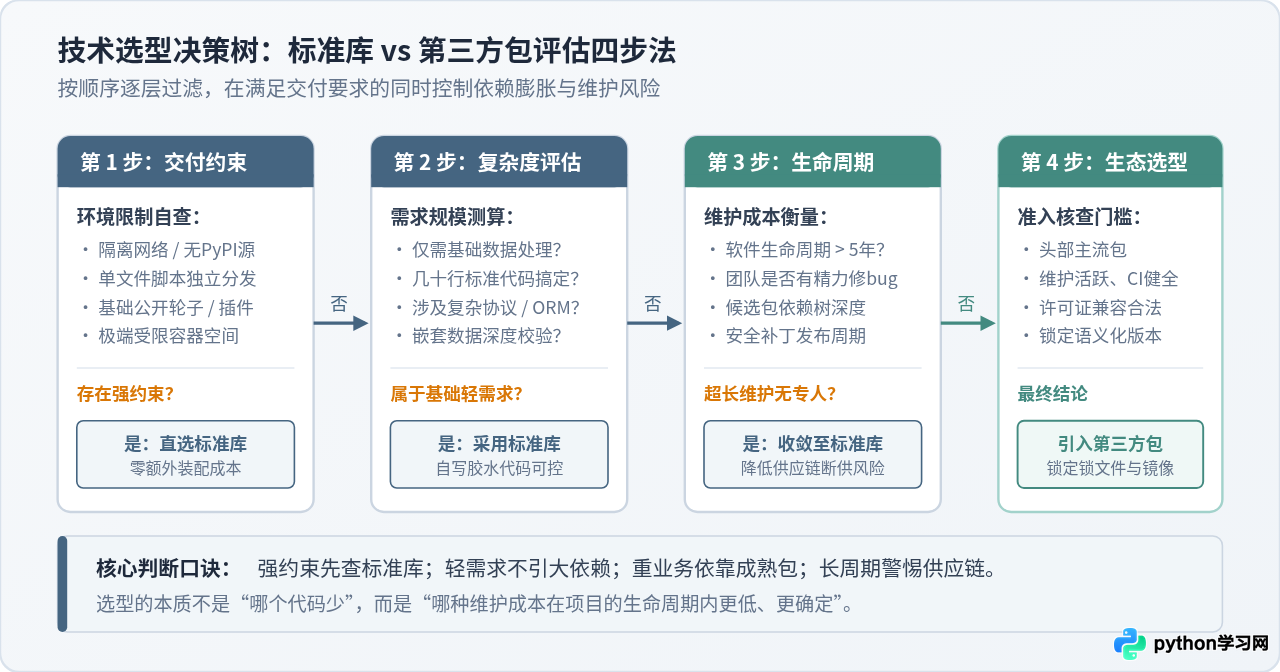
第一步:检查环境与交付强约束。如果当前项目属于以下情形之一,应将“无外部依赖”作为最高优先级指标:
- 离线与高隔离网络环境:生产服务器禁止直连外网 PyPI,或者内部私有源同步流程繁琐、审批周期长。
- 系统运维与自动化管理脚本:跨大量不同版本的 Linux 宿主机执行,目标机器上可能仅有系统预装的 Python 解释器,没有也不适合配置独立的虚拟环境。
- 单文件独立分发工具:希望代码被其他人通过复制单个
.py文件即可直接执行,无需附带requirements.txt。 - 开源公共基础库:如果你正在编写一个通用的底层工具库供其他开发者调用,减少直接依赖能大幅减轻下游用户的依赖解析负担,避免引发连锁的依赖地狱(Dependency Hell)。
第二步:评估核心逻辑的复杂度。标准库并非功能简陋,而是倾向于提供稳定、通用的低抽象构件。如果你的需求只需要几十行标准库代码即可严谨实现,且后续逻辑基本稳定,就不应为了几行动词性 API 引入动辄数兆的庞大第三方包。反之,如果实现当前功能需要你自己手写一整套状态机、协议解析器或复杂的类型验证规则,强行不用第三方包属于盲目造轮子。
第三步:测算软件生命周期与维护精力。大型企业系统或工具的服役期往往长达 5 至 10 年。标准库遵循 Python 官方严格的 PEP 弃用流程,拥有极高水准的向下兼容承诺;而 PyPI 上的第三方开源项目可能因为作者精力变化、工作变动而停止维护。如果项目长期没有专职人员持续处理第三方包的破坏性更新,收敛至标准库是保障系统长治久安的关键手段。
第四步:审查第三方包的准入质量。若确需引入第三方扩展,必须经过准入核查:该包是否为业界事实标准、社区活跃度是否良好、测试覆盖与发布历史是否规范、依赖树是否深度过大,以及开源协议是否符合团队商业合规要求。
二、核心高频场景对照:标准库能做到什么程度
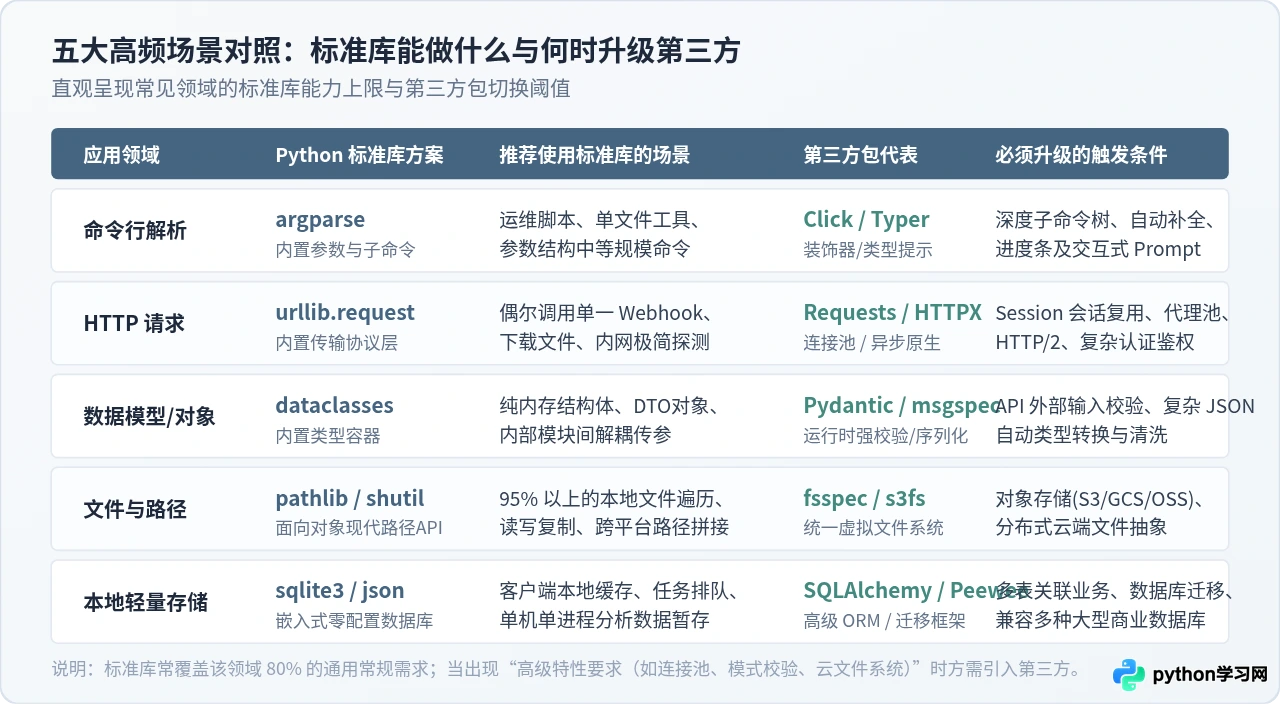
Python 官方一直秉持“自带电池”(Batteries Included)的哲学。在现代 Python(Python 3.10+)中,标准库早已补齐了大量现代语言特性。下面选取五个最容易产生选择困惑的领域,详细对比标准库与第三方包的适用边界。
1. 命令行参数解析:argparse vs click / typer
对于服务器运维脚本、日常批处理任务以及结构清晰的 CLI 工具,标准库内置的 argparse 已经能够处理位置参数、可选参数、默认值、类型转换、多选限制以及嵌套子命令(Subparsers),并且会自动生成规范的 --help 帮助文档。
# 使用标准库 argparse:无任何外部依赖,开箱即用
import argparse

def build_cli():
    parser = argparse.ArgumentParser(description="日志归档与清理工具")
    parser.add_argument("log_dir", help="日志文件所在目录")
    parser.add_argument("--days", type=int, default=7, help="保留最近几天日志(默认7天)")
    parser.add_argument("--dry-run", action="store_true", help="试运行模式,不实际删除")
    return parser

if __name__ == "__main__":
    args = build_cli().parse_args()
    print(f"扫描目录: {args.log_dir}, 过滤阈值: {args.days} 天, 试运行: {args.dry_run}")
何时升级第三方:当 CLI 工具拥有多级树状复杂子命令(如类似 kubectl、aws-cli 的架构)、需要高级终端交互(进度条展示、确认提示框、彩色高亮排版)或自动 Bash/Zsh 补全脚本生成时,使用 click 或基于类型提示的 typer 能显著提升代码组织优雅度与开发效率。
2. 路径与文件系统:pathlib vs 传统模块及外部扩展
在许多旧教程中,开发者经常看到 os.path、glob 与 shutil 混合使用的代码,导致不少人误以为 Python 处理文件路径极其繁琐,进而寻求第三方替代品。自 Python 3.6 起成熟的面向对象标准库 pathlib 已经彻底统一了路径抽象,覆盖了 95% 以上的文件系统操作。
# 现代标准库 pathlib:链式操作与跨平台优雅路径拼接
from pathlib import Path

data_dir = Path.home() / "project_data" / "reports"
data_dir.mkdir(parents=True, exist_ok=True)

# 递归匹配全部 json 文件并过滤大小
for file_path in data_dir.rglob("*.json"):
    if file_path.stat().st_size > 1024:
        content = file_path.read_text(encoding="utf-8")
        print(f"找到文件: {file_path.name}, 字符数: {len(content)}")
何时升级第三方:本地文件系统的操作在 pathlib 下已无引入第三方包的必要。只有当你需要跨越本地存储与云端对象存储(例如 AWS S3、Google Cloud Storage、阿里云 OSS),并希望用统一的文件系统接口透明访问时,才需要引入 fsspec 或 s3fs 等专用驱动。
3. 结构化数据对象:dataclasses vs pydantic
当需要在程序内部组织结构化数据、消除字典键值松散访问的不安全性时,标准库的 dataclasses 是最轻量且高性能的选择。它自带类型注解支持、自动生成 __init__、__repr__、__eq__,并支持不可变定义(frozen=True)。
# 使用标准库 dataclasses:零依赖、内存紧凑、清晰规范
from dataclasses import dataclass
from typing import Optional

@dataclass(frozen=True)
class DatabaseConfig:
    host: str
    port: int = 5432
    username: str = "postgres"
    password: Optional[str] = None

    def get_uri(self) -> str:
        return f"postgresql://{self.username}:***@{self.host}:{self.port}"
何时升级第三方:dataclasses 仅在静态层面提供类型契约,不会在运行时自动将传入的字符串 "5432" 强制转换并校验为整型 5432。如果你的数据来自未受信任的外部边界(如 HTTP REST API 请求体、用户上传的松散 JSON/YAML 配置文件),需要强校验规则、数据清洗与自动错误汇总,pydantic 是不可替代的事实标准。
4. 网络请求:urllib.request vs requests / httpx
如果你的脚本只需要偶发地向内部 Webhook 发送一条 JSON 告警消息,或者下载一个简单的文件,标准库的 urllib.request 配合 json 模块即可在 10 行代码内完成,完全不需要安装外部包。
# 使用标准库完成基本的 JSON POST 请求,无须 pip install requests
import urllib.request
import json

def send_alert(webhook_url: str, message: str) -> int:
    payload = json.dumps({"text": message}).encode("utf-8")
    req = urllib.request.Request(
        webhook_url,
        data=payload,
        headers={"Content-Type": "application/json"},
        method="POST"
    )
    with urllib.request.urlopen(req, timeout=5) as response:
        return response.status
何时升级第三方:urllib 的底层 API 缺乏高级状态管理。如果业务场景需要维护长连接会话(Cookie 保持、连接池复用以提升吞吐)、需要代理池轮换、处理复杂的 OAuth/摘要认证、自动解压缩、重定向控制,或是需要基于 asyncio 的高并发异步 HTTP 客户端,果断采用 requests 或现代异步客户端 httpx。
5. 轻量数据存储:sqlite3 vs 重型外部数据库与 ORM
许多本地应用或缓存系统动辄引入 Redis 或 MySQL,但在单机、中低并发以及单进程或轻量服务场景下,内置的 sqlite3 提供了零维护、零外设依赖、支持完整 ACID 事务的高性能关系型存储。数据库本身仅为一个磁盘文件,极其易于备份与随同代码归档。
三、警惕“无痛安装”:引入第三方包的隐性成本
pip install 表面上看似只有一行命令和几秒钟的下载时间,但在工程实践中,任何外部代码的引入都意味着将团队系统的控制权部分交给了外部生态。盲目添加依赖会带来不可逆的隐性持有成本。
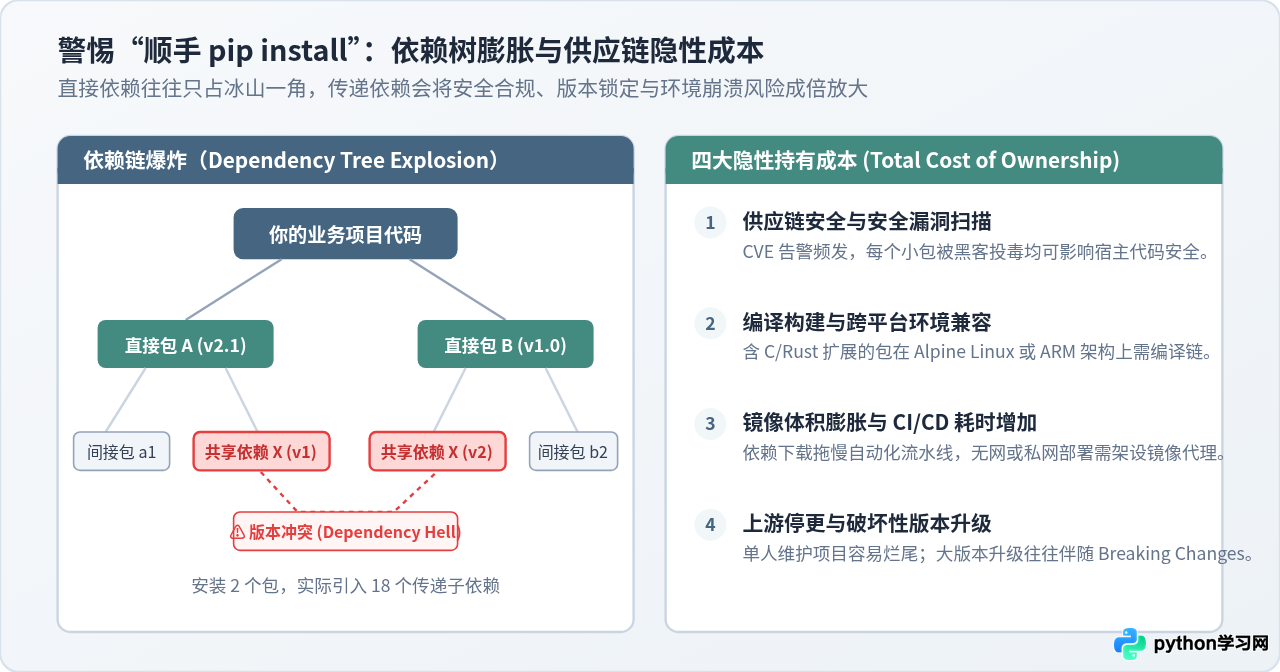
1. 依赖传递与版本锁定冲突(Dependency Hell):安装一个主包往往会默默下载 5 到 10 个间接依赖(Transitive Dependencies)。当项目中引入的两个不同第三方包依赖同一个底层包的互不兼容大版本时,便会陷入依赖解析死锁。这种冲突不仅折磨本地开发,更会导致 CI 流水线意外中断。
2. 供应链安全漏洞与合规审计:开源供应链投毒(Typosquatting、维护者账号被盗、恶意植入窃密代码)已成为现代安全防御的重大威胁。企业内部的安全扫描器(如 Snyk、Trivy、Dependabot)会定期扫描依赖树中的 CVE。依赖包数量越多,团队每周消耗在升级补丁、排查误报与安全合规申报上的工时就越长。
3. 容器镜像体积与跨架构构建成本:许多第三方包为了极致性能包含了 C/C++ 或 Rust 扩展模块。如果所使用的 Linux 基础镜像(如 Alpine 或特定架构的 ARM 芯片服务器)没有现成的预编译 Wheel,Docker 构建时就必须在镜像中安装 gcc、python3-dev、musl-dev 等大型编译工具链,导致镜像体积从 50MB 剧增至数百兆,严重拖慢自动扩缩容与集群发布速度。
4. 上游维护者弃坑与非受控 Breaking Changes:开源项目维护者大多属于志愿奉献。项目一旦失去维护,遇到 Python 新解释器版本发布时便可能无法安装;而部分商业化开源项目在大版本迭代时频繁变更 API,迫使下游团队不得不频繁重构原有稳定业务代码。
四、选型象限与工程落地法则
在实际项目推进中,团队应当建立明确的技术选型决策基准,避免“全盘手写轮子”与“依赖无节制狂欢”两种极端偏向。
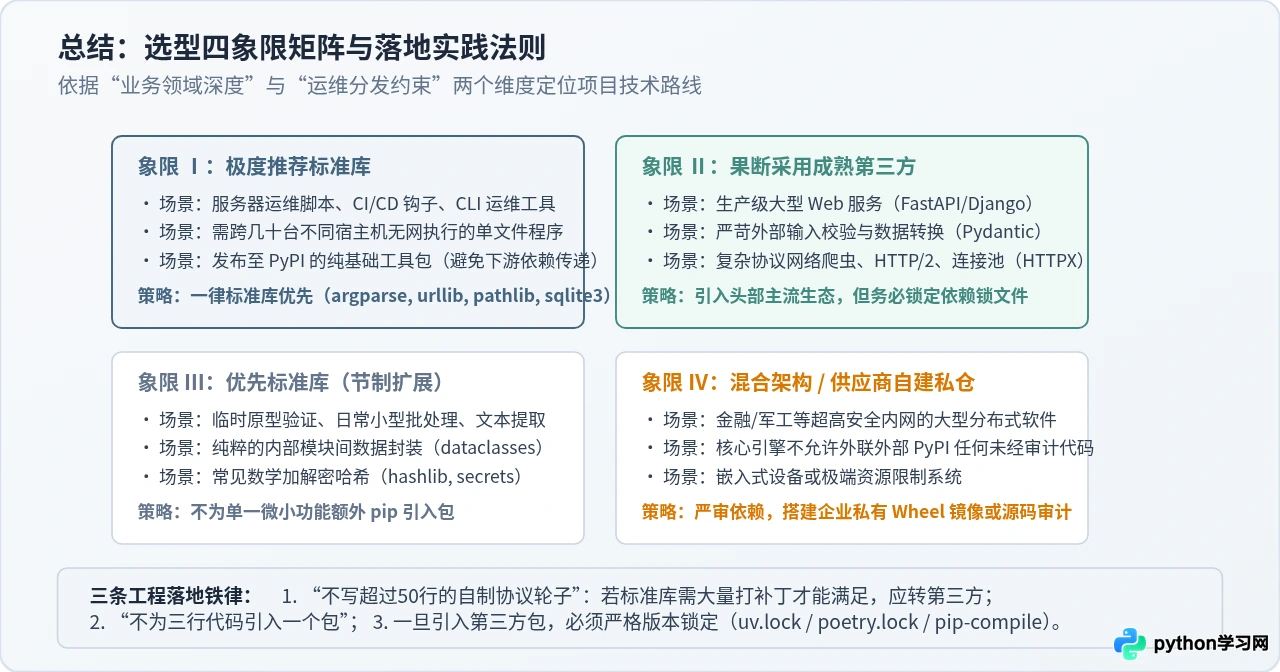
- 不为三五行逻辑引入依赖:如果一个功能只需要标准库组合 10 到 30 行纯 Python 代码即可清晰表达,严禁引入第三方单功能微型库(Micro-packages)。
- 不写超过 50 行的自制底层协议:如果标准库实现当前需求需要开发者自己手写复杂的连接池重试、协议状态机或复杂的密码学算法,必须停止造轮子,转而选用经受海量工业验证的权威第三方包。
- 引入第三方包必须严格锁定版本:生产项目一旦决定引入第三方包,必须在代码仓中提交锁文件(如
uv.lock、poetry.lock或由pip-compile锁定的requirements.txt),杜绝在没有锁文件的环境下执行开放式版本的pip install。
结语
选择 Python 标准库还是第三方包,不是个人审美之争,而是工程可靠性与生产力之间的权衡艺术。标准库是软件长期稳健运行的坚实基石,它让你的代码在最干净的环境中自足运作;第三方包则是加速现代业务创新的强大引擎。理解两者的边界,在架构初期严控依赖蔓延,才能让系统在敏捷迭代的同时,保持轻盈与长久的可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









