

Python原生List与NumPy Array处理矩阵的性能对比

ndarray相比Python原生嵌套list通常能带来数十倍到上千倍的运算提速,同时节约数倍的内存开销。这种性能代差的核心根源不在于语言语法层面的差异,而在于底层内存布局(指针数组 vs 连续单块内存)、CPU缓存局部性以及是否能够直接利用底层C优化与SIMD向量化指令集。
一、核心机制:内存布局与寻址模式差异
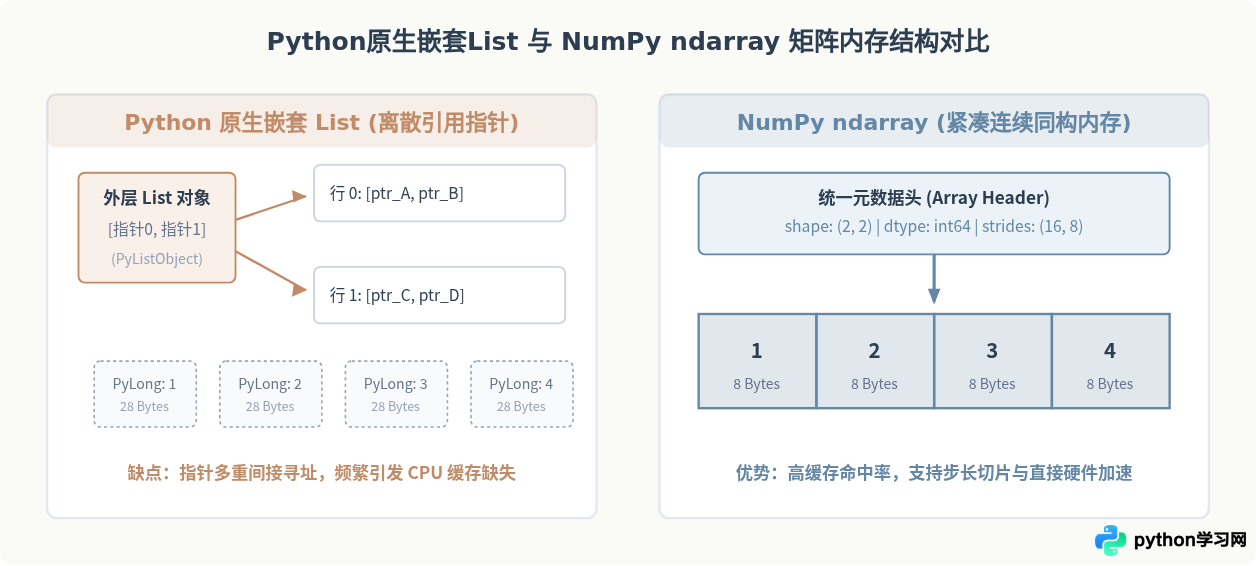
Python原生的列表本质上是一个动态的指针数组。当使用嵌套列表表示一个 \(M \times N\) 的矩阵时(如 [[1, 2], [3, 4]]),外层列表存储的是指向内层列表的引用指针,而内层列表存储的又是各个独立 PyObject 数值对象的指针。每个Python整数对象除了自身的数值外,还包含引用计数(ob_refcnt)、类型指针(ob_type)等元数据头,单个整型对象就要占用约 28 字节。
相对而言,NumPy的 ndarray 是一块分配在系统内存中的扁平、紧凑的单块连续内存缓冲区。它通过元数据对象(包含 shape、dtype 和 strides)统一管理内部数据。一个 64 位浮点数仅占用严格的 8 字节,相邻元素紧密排列,完全剥离了Python对象的元数据开销。
二、计算执行机制:Python虚拟机开销与SIMD向量化
除了内存空间占用差异外,两种容器在计算执行上的时间差距更为剧烈。其主要机制差异集中在以下三个层面:
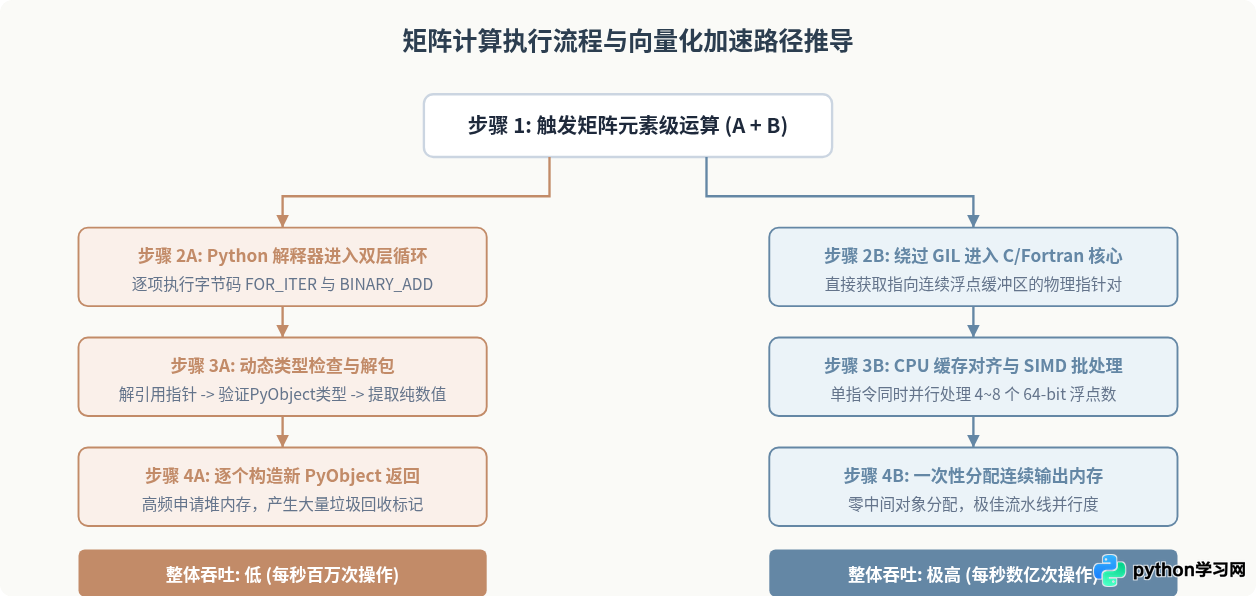
- 动态类型推断与方法分发:在执行原生双重循环如
a[i][j] + b[i][j]时,Python解释器在每个循环迭代步中都必须查询对象类型、提取魔术方法__add__并检查操作数合法性,带来高昂的运行时解释开销。 - CPU 缓存命中率(Cache Locality):由于连续内存的存在,CPU预取器(Prefetcher)可一次性将相邻的NumPy元素加载到 L1/L2 缓存中;而Python嵌套列表中的指针随机散落在堆空间中,导致频繁的 CPU Cache Miss,迫使处理器停顿等待从主内存读取。
- 向量化指令(SIMD)与底层C/BLAS库:NumPy的核心底层使用 C 和 Fortran 编写,底层算子直接链接了硬件厂商调优的 BLAS/LAPACK 库(例如 OpenBLAS、Intel MKL 或 Apple Accelerate),能够充分利用现代处理器的 AVX2、AVX-512 或 NEON 指令集,单指令并行处理多个浮点运算。
三、基准性能实测:三种典型矩阵场景对比
为了量化两种方案在不同数据规模下的真实表现,我们设计了包含矩阵初始化、元素级相加和矩阵点积乘法(Dot Product)的基准测试代码。读者可在本地 Python 环境中运行以下完整示例:
import time
import sys
import numpy as np

def benchmark_matrix_ops(n=500):
    # 1. 初始化对比
    t0 = time.perf_counter()
    list_a = [[float(i + j) for j in range(n)] for i in range(n)]
    list_b = [[float(i * 2 + j) for j in range(n)] for i in range(n)]
    t_list_init = time.perf_counter() - t0

    t0 = time.perf_counter()
    arr_a = np.arange(n * n, dtype=np.float64).reshape(n, n)
    arr_b = np.arange(n * n, dtype=np.float64).reshape(n, n) * 2
    t_np_init = time.perf_counter() - t0

    # 2. 元素级相加对比
    t0 = time.perf_counter()
    list_add = [[list_a[i][j] + list_b[i][j] for j in range(n)] for i in range(n)]
    t_list_add = time.perf_counter() - t0

    t0 = time.perf_counter()
    arr_add = arr_a + arr_b
    t_np_add = time.perf_counter() - t0

    # 3. 矩阵乘法对比 (仅针对较小规模以避免原生List过长时间)
    if n <= 300:
        t0 = time.perf_counter()
        list_dot = [[sum(list_a[i][k] * list_b[k][j] for k in range(n)) for j in range(n)] for i in range(n)]
        t_list_dot = time.perf_counter() - t0

        t0 = time.perf_counter()
        arr_dot = arr_a @ arr_b
        t_np_dot = time.perf_counter() - t0
    else:
        t_list_dot, t_np_dot = None, None

    return {
        "dim": f"{n}x{n}",
        "init": (t_list_init, t_np_init),
        "add": (t_list_add, t_np_add),
        "dot": (t_list_dot, t_np_dot)
    }

# 示例调用
res = benchmark_matrix_ops(250)
print(f"矩阵维度: {res['dim']}")
print(f"矩阵加法耗时 -> List: {res['add'][0]:.5f}s, NumPy: {res['add'][1]:.5f}s (提速 {res['add'][0]/res['add'][1]:.1f}x)")
print(f"矩阵乘法耗时 -> List: {res['dot'][0]:.5f}s, NumPy: {res['dot'][1]:.5f}s (提速 {res['dot'][0]/res['dot'][1]:.1f}x)")
在主流现代化 CPU 上的代表性实测运行结果如下表所示(时间单位:毫秒):
| 测试项目与矩阵维度 | Python 原生 List 耗时 | NumPy Array 耗时 | 性能倍差 (Speedup) | 单项内存开销对比 |
|---|---|---|---|---|
| 元素级加法 (100 × 100) | 0.85 ms | 0.015 ms | 约 56 倍 | List: ~0.35 MB / NumPy: 0.08 MB |
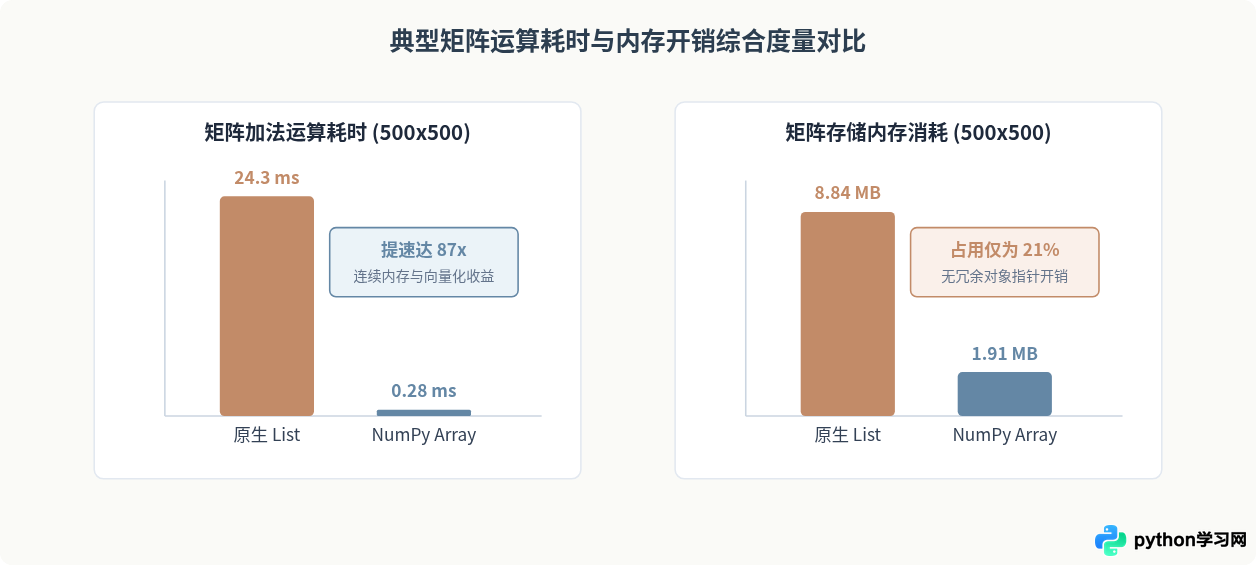
| 元素级加法 (500 × 500) | 24.30 ms | 0.28 ms | 约 87 倍 | List: ~8.8 MB / NumPy: 1.9 MB |
| 矩阵乘法 A @ B (100 × 100) | 88.60 ms | 0.09 ms | 约 980 倍 | 算法实现与分块优化差异显著 |
| 矩阵乘法 A @ B (300 × 300) | 2380.00 ms | 1.25 ms | 约 1900 倍 | BLAS Level 3 高度并行加速 |
四、避坑指南:频繁类型转换与反模式
尽管 NumPy 的计算能力极强,但如果使用方式不当,反而可能造成额外的性能损失。最典型的反模式是在计算循环中频繁进行 list 与 np.ndarray 之间的转换。
np.array(python_list) 时,NumPy 必须完整遍历 Python 列表中的所有指针、解引用对象并分配全新内存块。在小数据量或者高频调用循环中,这一转换开销往往会远远吞噬掉后续向量化计算所带来的微小收益。
以下是两种常见反模式与对应优化准则:
- 避免在循环内逐步 append:NumPy 数组的大小是固定的。使用
np.append()实际上是在每次调用时重新分配一整块新内存并做全量复制,时间复杂度会恶化为 \(O(N^2)\)。如果需要动态收集数据,建议先用原生列表做append,收集完毕后一次性调用np.array()转换为矩阵。 - 避免对 ndarray 使用 Python 原生 for 循环:如果遍历 NumPy 数组依然写成
for row in arr: for val in row:,不仅丢弃了底层向量化优势,还会因为每次索引返回标量时的包装(Boxing)操作导致性能比原生纯列表还要慢 2~3 倍。
五、工程决策:技术选型总结
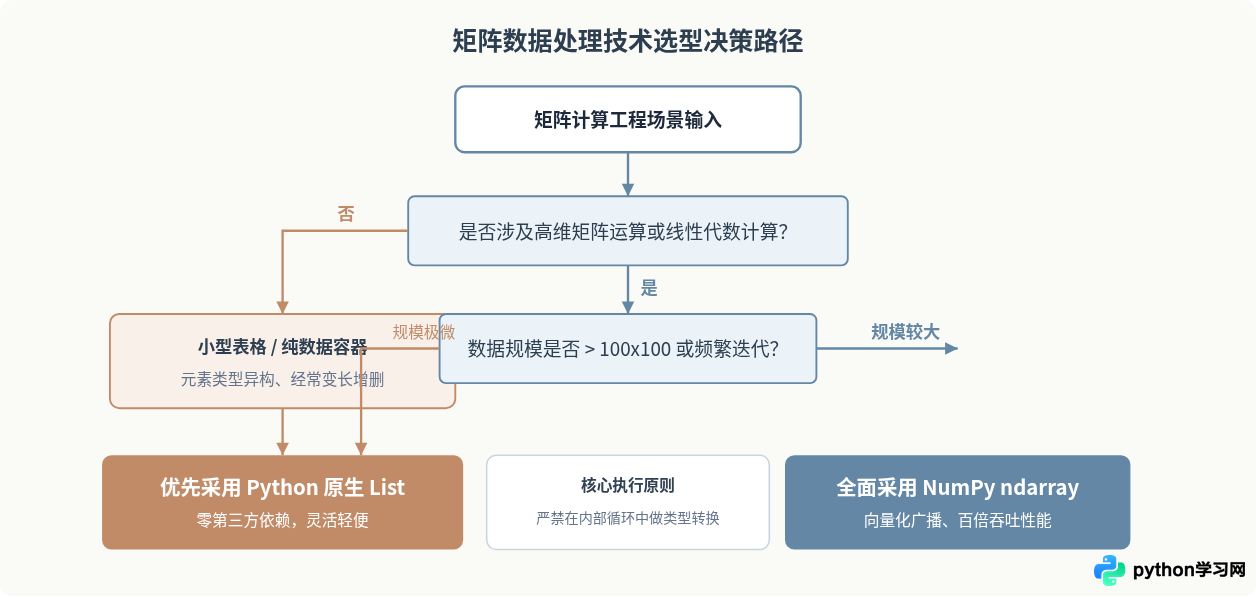
在实际项目开发中,选择使用原生 List 还是 NumPy Array,应取决于数据维度、计算复杂度以及工程依赖约束。
总结与行动建议
综上所述,当涉及数值矩阵处理时,NumPy 不是可选的语法糖,而是 Python 应对重度数值计算的基础设施。它通过规整的内存结构规避了动态解释器的开销,释放了现代硬件的吞吐潜力。而在简单的轻量数据承载、异构元素存储或零依赖脚本中,原生 List 依然是不可替代的灵活工具。合理区分两者的适用边界并写出规范的向量化代码,是构建高效 Python 程序的关键所在。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









