

Scikit-learn与PyTorch怎么选?Python主流AI框架对比与入门建议
深入对比Python主流机器学习框架Scikit-learn与深度学习引擎PyTorch的核心机制、适用场景、代码实现差异与落地工程步骤,为初学者提供清晰的选型决策树与循序渐进的入门学习路线。
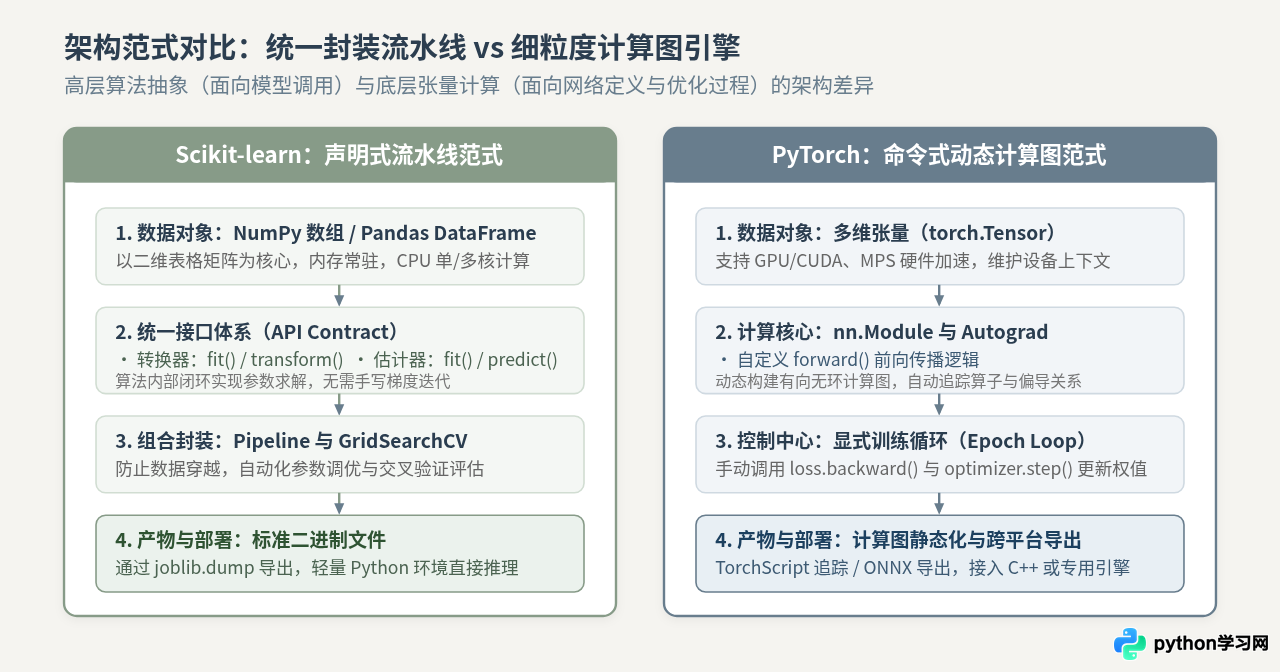
一、核心定位与选型决策维度
很多初学者容易误以为深度学习全面淘汰了传统机器学习。在真实的工业落地场景中,模型评估标准不仅包含准确率,还紧密关联研发周期、机器算力、可解释性审查以及线上延迟要求。下表对比了两者的核心定位差异:
| 对比维度 | Scikit-learn | PyTorch |
|---|---|---|
| 核心领域 | 经典统计机器学习、数据预处理与模型评估 | 深度学习、神经网络表征、多模态计算 |
| 输入数据形态 | 结构化二维表格(NumPy 数组、Pandas DataFrame) | 多维张量(Tensor,包括图片、序列 Token、图节点) |
| 硬件与算力依赖 | CPU 单机计算为主,内存密集型,无需 GPU | 强依赖 GPU(CUDA/MPS)硬件加速,显存管理要求高 |
| 编程交互风格 | 高层声明式 API,黑盒封装 fit/predict/transform | 底层命令式 API,显式手写前向传播与反向训练循环 |
| 模型可解释性 | 高(线性权重、特征重要性、决策路径直观可见) | 低(高维连续嵌入空间,参数量巨大,属于典型黑盒) |
| 交付与依赖体积 | 极轻量(依赖纯净,通常只需 numpy/scipy),单包仅数十 MB | 较重(含 CUDA 运行时及张量引擎,安装包超数百 MB 至数 GB) |
二、底层机制与开发范式对比
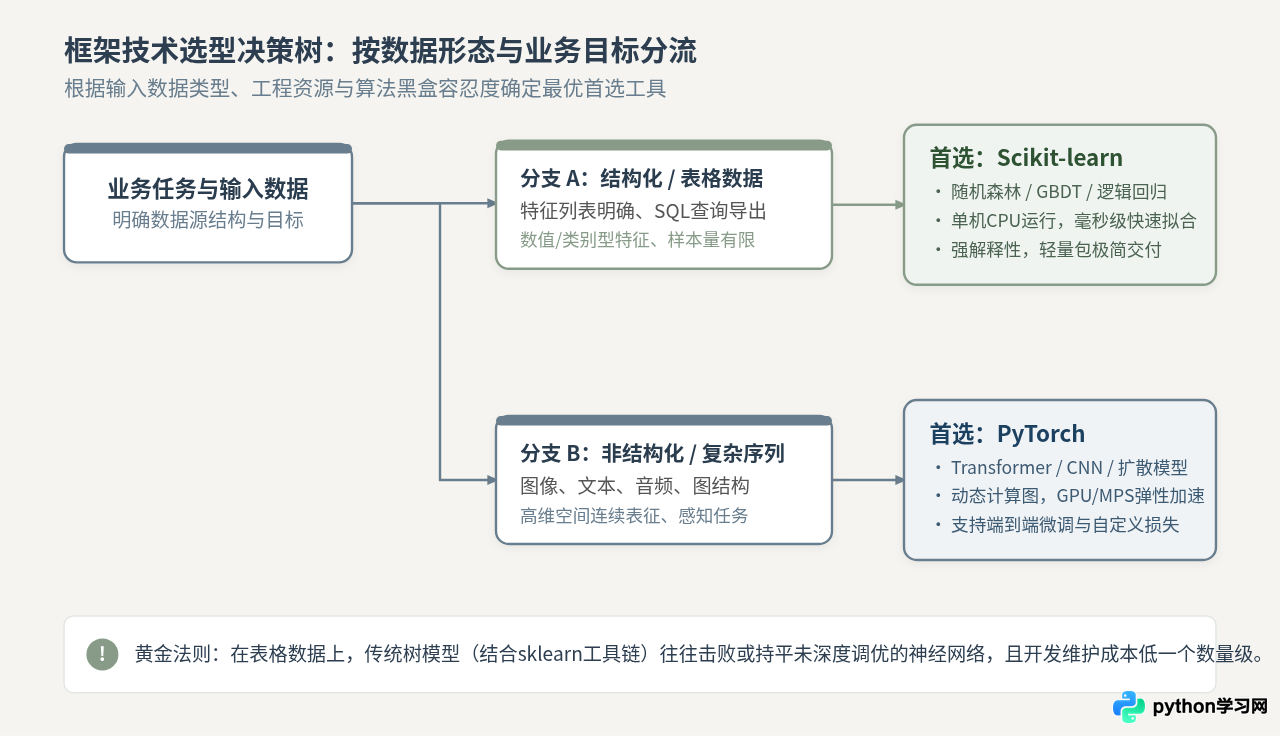
理解两个框架的本质区别,关键在于掌握它们如何组织“数据”与“计算”:
1. Scikit-learn 的流水线(Pipeline)闭环
Scikit-learn 建立在严格的面向对象 API 规范之上,其核心抽象包含两类对象:
- 转换器(Transformer):必须实现
fit(X)学习统计量(如均值、标准差),并通过transform(X)将变换应用到数据集; - 估计器(Estimator):必须实现
fit(X, y)拟合目标分布,并通过predict(X)输出推断结果。
由于算法内部采用 C/Cython 深度优化,调用者不需要干预内部梯度计算,只需通过 Pipeline 将预处理与模型装配为一个串联单元即可。这种高层封装消除了绝大部分底层细节,也避免了训练集与测试集统计量混淆引发的数据泄漏。
2. PyTorch 的动态计算图(Dynamic Autograd)机制
PyTorch 是一个基于张量(Tensor)的科学计算引擎与自动求导框架:
- 即时执行(Eager Execution):代码执行到哪一行,底层的数学算子就运行到哪一行,支持原生 Python 的 if 分支与 for 循环断点调试;
- 动态构建反向图:在前向传播过程中,PyTorch 动态追踪张量之间的运算依赖,调用
loss.backward()时自动通过链式法则推导梯度; - 显式循环控制:网络结构(
nn.Module)、损失函数(Loss)、优化器(Optimizer)彼此解耦,调用者拥有掌控权,需显式执行清空梯度、反向传播与步长更新。
三、具体场景代码实现对照
为了直观展现两者的编码手感与工作机制,我们在完全相同的二分类任务场景下,分别使用两个框架实现从数据准备到评估的全流程。
1. Scikit-learn 实现:结构化分类流水线
在 Scikit-learn 中,我们通过标准类库在数行代码内完成归一化与随机森林分类器训练:
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report

# 1. 模拟生成结构化表格数据 (1000个样本,10个特征)
X, y = make_classification(n_samples=1000, n_features=10, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 2. 构建包含标准化与估计器的 Pipeline
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', RandomForestClassifier(n_estimators=100, random_state=42))
])

# 3. 拟合模型并评估
pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)

# 4. 输出评估指标
print(classification_report(y_test, y_pred, digits=4))pipeline 对象已经包含了 StandardScaler 学到的均值方差,新数据传入 predict 会自动执行相同的缩放,极大减少了工程缺陷。
2. PyTorch 实现:多层感知机(MLP)分类器
相同的任务如果使用 PyTorch 实现,我们需要显式构建数据集迭代器、继承网络基类、定义前向传播并编写 Epoch 训练循环:
import torch
import torch.nn as nn
from torch.utils.data import TensorDataset, DataLoader
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

# 1. 数据准备与张量转换 (保持前置特征工程与划分一致)
X, y = make_classification(n_samples=1000, n_features=10, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 转为 FloatTensor 并封装为 DataLoader
train_dataset = TensorDataset(torch.tensor(X_train_scaled, dtype=torch.float32),
                              torch.tensor(y_train, dtype=torch.float32))
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)

# 2. 定义神经网络架构
class BinaryMLP(nn.Module):
    def __init__(self, input_dim):
        super(BinaryMLP, self).__init__()
        self.net = nn.Sequential(
            nn.Linear(input_dim, 16),
            nn.ReLU(),
            nn.Linear(16, 1) # 输出未经激活的 Logits
        )
    def forward(self, x):
        return self.net(x).squeeze(-1)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = BinaryMLP(input_dim=10).to(device)
criterion = nn.BCEWithLogitsLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)

# 3. 显式训练循环 (Epoch Loop)
model.train()
for epoch in range(15):
    for batch_x, batch_y in train_loader:
        batch_x, batch_y = batch_x.to(device), batch_y.to(device)
        optimizer.zero_grad()            # 步骤A: 清空上一轮残留梯度
        outputs = model(batch_x)         # 步骤B: 前向传播
        loss = criterion(outputs, batch_y) # 步骤C: 计算损失
        loss.backward()                  # 步骤D: 反向传播计算梯度
        optimizer.step()                 # 步骤E: 优化器更新参数

# 4. 显式切换为推理模式
model.eval()
with torch.no_grad():
    test_x = torch.tensor(X_test_scaled, dtype=torch.float32).to(device)
    raw_logits = model(test_x)
    preds = (torch.sigmoid(raw_logits) >= 0.5).long().cpu().numpy()

acc = (preds == y_test).mean()
print(f"PyTorch MLP Test Accuracy: {acc:.4f}")- 在进行模型评估或推理时,必须严格调用
model.eval()并在with torch.no_grad():上下文内运行,否则 Dropout、BatchNorm 等层会继续处于训练随机状态,且会浪费大量显存保存计算图历史。 - 在反向传播前必须显式调用
optimizer.zero_grad(),因为 PyTorch 的梯度默认是累加而非覆盖的。
四、实战落地全生命周期步骤
无论选择哪个框架,工业级落地都需要走完“环境准备 → 数据预处理 → 模型调优 → 序列化部署”四个标准环节。以下是两者的具体操作指引:
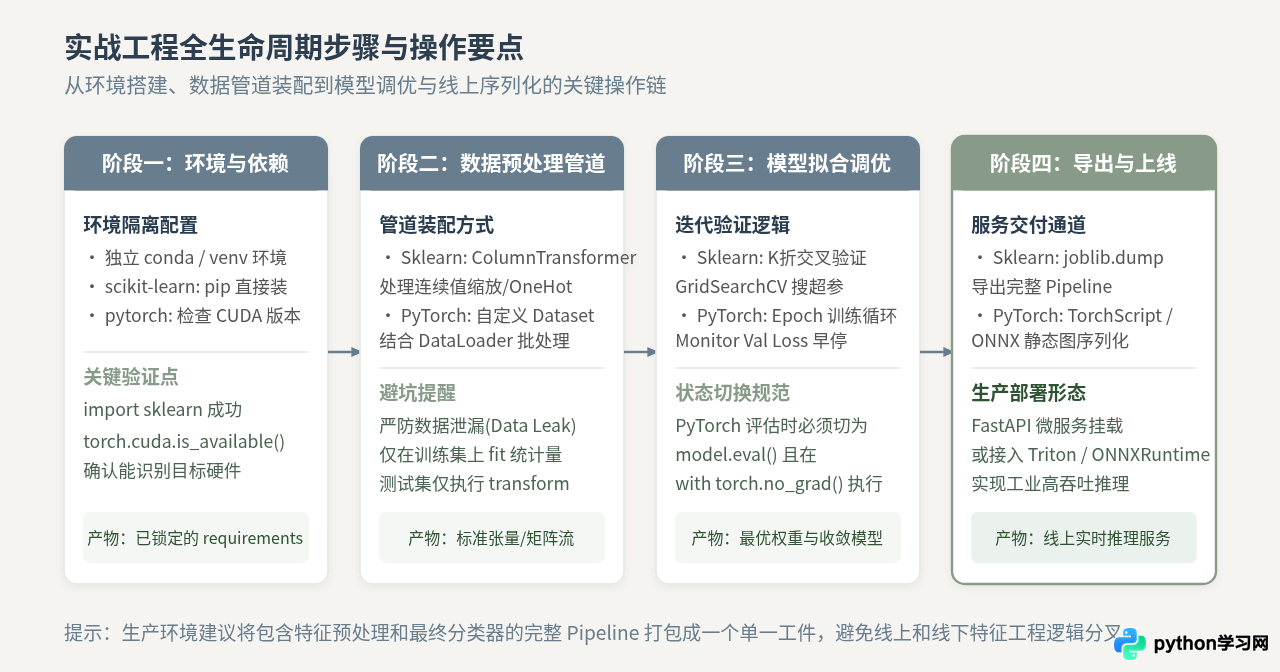
步骤 1:环境安装与硬件验证
严禁在全局 Python 环境下直接混装框架,务必使用虚拟环境隔离:
# 创建并激活专用虚拟环境
python3 -m venv ai_env
source ai_env/bin/activate  # macOS / Linux
# 或 ai_env\Scripts\activate  # Windows

# 安装 Scikit-learn (自动包含 numpy, scipy)
pip install scikit-learn pandas

# 安装 PyTorch (建议访问 pytorch.org 依据硬件选择官方安装命令)
# 针对纯 CPU 环境:
pip install torch --index-url https://download.pytorch.org/whl/cpu
步骤 2:数据流水线与防穿越设计
对于 Scikit-learn,使用 ColumnTransformer 对类别列(OneHotEncoder)与数值列(StandardScaler)进行分流处理;对于 PyTorch,编写继承 torch.utils.data.Dataset 的类,并在 __getitem__ 中实现单样本读取,由 DataLoader 完成多线程预取(num_workers)与 Batch 拼接。
步骤 3:调优与监控策略
- Scikit-learn:依赖
GridSearchCV或RandomizedSearchCV针对特定超参数(如树的深度max_depth、叶子节点数)执行分层 K 折交叉验证(StratifiedKFold); - PyTorch:切分独立验证集,按 Epoch 记录验证集损失(Val Loss),配合
torch.optim.lr_scheduler衰减学习率,并在验证集损失连续若干轮不下降时触发早停(Early Stopping)。
步骤 4:模型序列化与生产上线
模型在离线环境调优完成后,必须导出为静态工件交付给在线服务:
- Scikit-learn 导出:使用
joblib.dump(pipeline, "model_v1.pkl")保存。在线服务通过joblib.load()加载,执行单次predict()延迟通常在 1-5 毫秒以内; - PyTorch 导出:推荐使用 TorchScript 静态追踪或 ONNX 导出,避免生产环境依赖完整的 Python 运行期:
# 将 PyTorch 模型追踪为 TorchScript
scripted_model = torch.jit.trace(model, torch.randn(1, 10))
scripted_model.save("model_traced.pt")
五、入门进阶路线与工业界协同建议
很多开发者在学习过程中陷入“非此即彼”的误区。在工业实践中,成熟团队往往将两者串联协同使用,而非互相排斥。
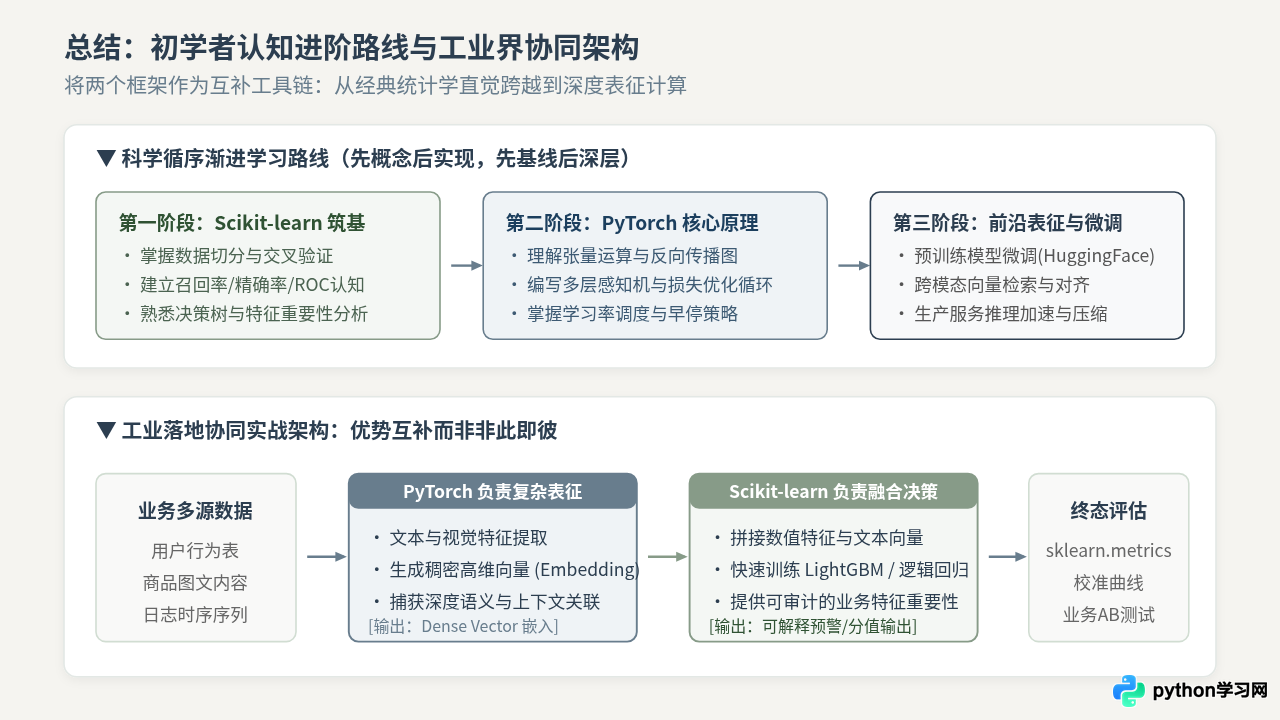
1. 给初学者的循序渐进建议
- 先学 Scikit-learn 建立数据与评估常识:先通过逻辑回归、决策树和随机森林理解过拟合、欠拟合、泛化能力、精确率、召回率、F1-Score 与 ROC-AUC。如果直接上手 PyTorch,大量精力会被网络层维度对齐、显存溢出与张量变形所分散,反而忽略了统计学核心逻辑;
- 在面对非结构化数据时切入 PyTorch:当你需要处理文本分类、目标检测、语音识别或需要调用开源 Transformer 预训练权重时,开始系统学习 PyTorch 的张量切片、Autograd 原理与训练闭环。
2. 工业界典型协同架构:优势互补
在诸如电商推荐系统、反欺诈风控或智能合规审核等复杂业务中,常见架构是:
- 使用 PyTorch 加载大语言模型或视觉骨干网络,对海量非结构化文本、图片进行端到端编码,提取出高语义密度的稠密向量(Embedding);
- 使用 Scikit-learn(或兼容其生态的 LightGBM/XGBoost)将上述深度向量与业务侧已有的数值特征(如近30天消费额、点击频次)拼接,最终完成分类决策。这种方式既利用了深度学习的表征能力,又兼顾了表格模型的高效、稳定与可解释性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









