

为什么处理大量数值数据推荐用NumPy而不是Python列表
深度解析为什么在大规模数值数据处理中推荐使用NumPy而非Python原生列表。从连续内存布局、CPU缓存命中率、C语言SIMD向量化执行以及广播零拷贝机制等底层原理出发,结合代码实测与决策模型,全面阐释性能与内存差异的本质。
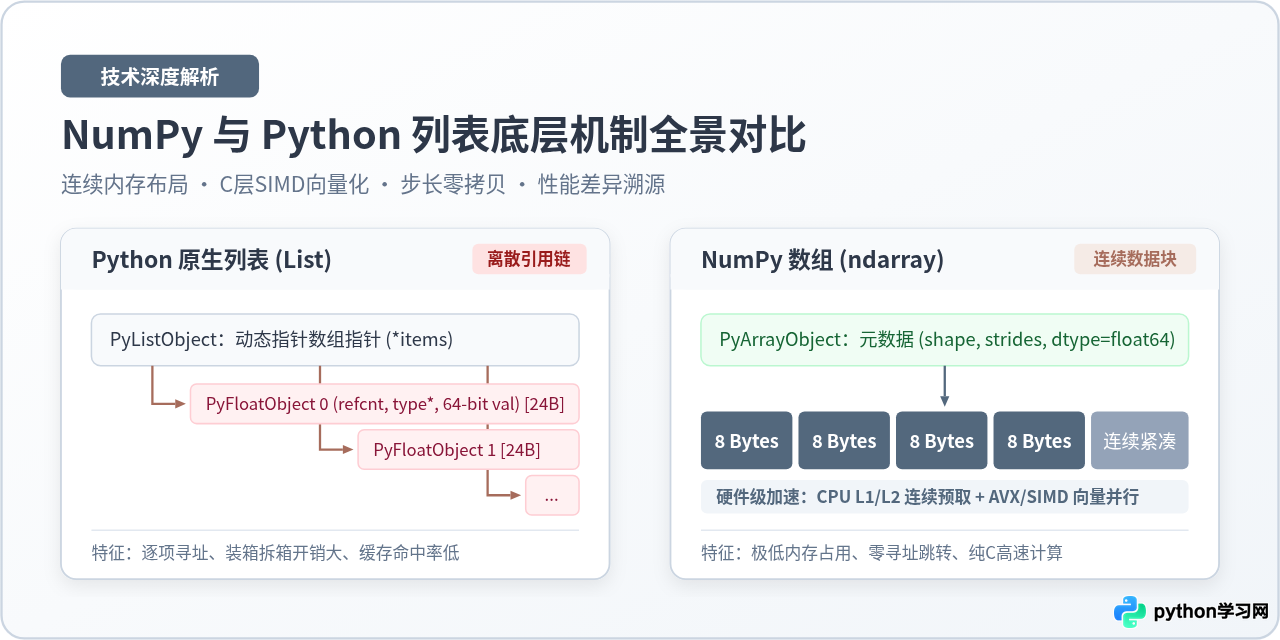
list)无论在内存开销还是计算耗时上都会出现断崖式性能衰减。NumPy 之所以成为科学计算与工程分析的核心基石,本质在于其通过连续同质内存存储、C语言层级的SIMD向量化硬件指令以及基于步长变换的零拷贝切片与广播机制,彻底消除了通用动态对象的装箱拆箱开销与全局解释器寻址瓶颈。
1. 直观体验:千万级浮点数计算的性能断层
在深入探讨内部实现机制前,我们先通过一个直观的基准操作观察差异。假设我们需要生成 1000 万个浮点数,并对每个元素执行平方求和计算。以下是分别使用标准库 list 与 numpy.ndarray 的典型实现:
import time
import sys
import numpy as np

# 1. 初始化 10,000,000 个浮点数
n = 10_000_000

# 测试 Python 原生列表
start_time = time.perf_counter()
py_list = [float(i) for i in range(n)]
create_list_time = time.perf_counter() - start_time

start_time = time.perf_counter()
sum_py = sum(x * x for x in py_list)
calc_list_time = time.perf_counter() - start_time

# 测试 NumPy 数组
start_time = time.perf_counter()
np_arr = np.arange(n, dtype=np.float64)
create_arr_time = time.perf_counter() - start_time

start_time = time.perf_counter()
sum_np = np.sum(np_arr ** 2)
calc_arr_time = time.perf_counter() - start_time
在配备现代 x86_64 或 ARM 处理器的通用开发环境中,运行该基准测试通常会产生如下量级的典型结果(具体绝对时间取决于具体CPU型号,但比例关系高度恒定):
| 测试项目 | Python 原生列表 (List) | NumPy 数组 (ndarray) | 性能倍率 |
|---|---|---|---|
| 内存占用 (1000万个双精度浮点数) | 约 280 MB ~ 320 MB | 约 76.3 MB (纯数据仅 80000000 字节) | 节省 70% ~ 75% 内存 |
| 生成序列耗时 | 约 0.65 秒 | 约 0.015 秒 | NumPy 快约 40 倍 |
| 平方求和计算耗时 | 约 0.82 秒 | 约 0.009 秒 | NumPy 快约 90 倍 |
近百倍的速度差距与数倍的内存缩减,绝非单纯的“编译优化”可以解释。这背后反映的是两者在物理内存拓扑结构与CPU指令执行链路上的根本分歧。
2. 内存布局深析:指针数组与连续数据块的本质差异
Python 中的 list 被设计为一种高度通用的动态容器,它可以同时容纳整数、字符串、自定义对象甚至另一个列表。为了实现这种多态灵活性,Python 付出了巨大的空间和寻址代价:
- Python 列表本质是指针数组:变量
list内部并不直接存放数值,而是保存了一个连续的PyObject*指针数组。每一个槽位指向堆内存中独立分配的一个具体对象。 - 高昂的单个数值装箱(Boxing)成本:在 CPython 中,即便只是一个基础的 64 位双精度浮点数(
PyFloatObject),除了 8 字节的实际值外,还必须附带 8 字节的引用计数(ob_refcnt)和 8 字节的类型对象指针(ob_type)。这意味着存储一个 8 字节的数,系统总共需要消耗 24 字节(对象本身)加上 8 字节(列表中的指针),总计 32 字节。 - 内存碎片与 CPU 缓存行失效:更致命的是,这些
PyFloatObject是由操作系统的通用内存分配器分别在堆中开辟的,它们的物理地址往往处于非连续的内存页中。当 CPU 读取数据时,每次缓存行(Cache Line,通常为 64 字节)预取都难以命中后续元素,引发频繁的 L1/L2 Cache Miss 和页表跳转。
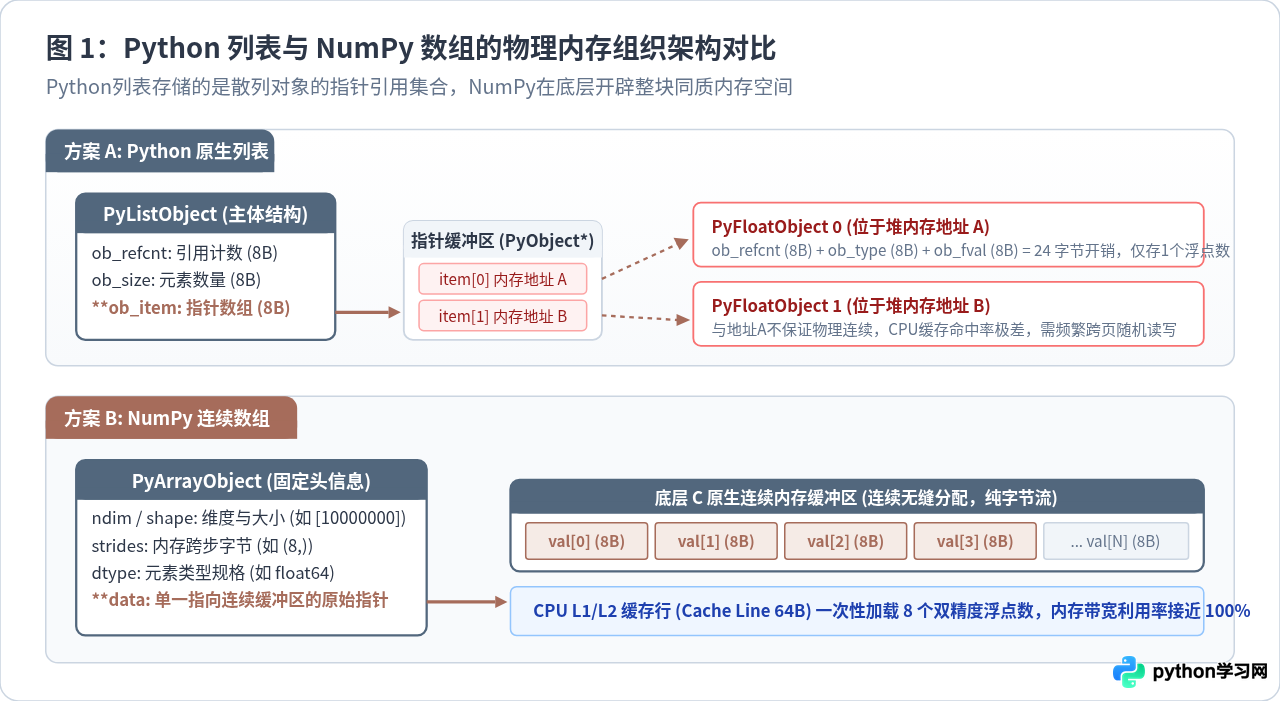
与之形成鲜明对比的是,NumPy 的 ndarray 采用了 C 语言传统的连续内存设计(C-style contiguous array):
- 同质类型约束(Homogeneous Dtype):创建数组时明确声明数据类型(例如
float64),整个数组所有元素具有相同的固定字节长度。 - 纯粹紧凑的原始字节流:整个数组只有一个统一的头部结构
PyArrayObject(存放形状、步长和指针元数据),底层数据区是一段完整无缝的原始二进制字节流。存储 1000 万个float64仅仅占用精确的 80,000,000 字节(约 76.3 MB),额外开销仅有固定的几十字节元数据,几乎趋近于零。 - 硬件缓存友好:由于内存完全连续,现代 CPU 硬件预取单元(Hardware Prefetcher)在处理前几个数值时,就会自动将相邻的数据行推入 CPU L1/L2 高速缓存,内存访问带宽被榨取到极致。
3. 执行流程革命:解释器类型分发与硬件级 SIMD 向量化
在算法运算时,为什么即使我们使用 CPython 运行最简单的 for 循环,速度依然无法与 NumPy 抗衡?根本原因在于循环体内的解释器运行时损耗。
在原生 Python 循环中,解释器对循环中的每一次加法或乘法操作,都必须经历以下一系列动态分发步骤:
- 通过指针索引从列表中获取当前元素的
PyObject*内存地址。 - 解引用读取对象的类型标记,判断其是否支持加法操作,并在类型字典中动态查找对应的双目运算符函数(如
float.__add__)。 - 将
PyFloatObject拆箱(Unbox),取出其中封装的底层 8 字节原始浮点值。 - CPU 浮点寄存器执行一次实际的算术加法指令。
- 在堆内存中申请一块新内存,构造一个新的
PyFloatObject将计算结果包装起来,并更新引用计数。
在这条漫长的执行链路中,CPU 进行实际数学运算所消耗的晶体管周期不足整体开销的 5%,其余 95% 以上的时间全部浪费在指针解引用、类型分支预测、动态函数查找以及装箱拆箱上。
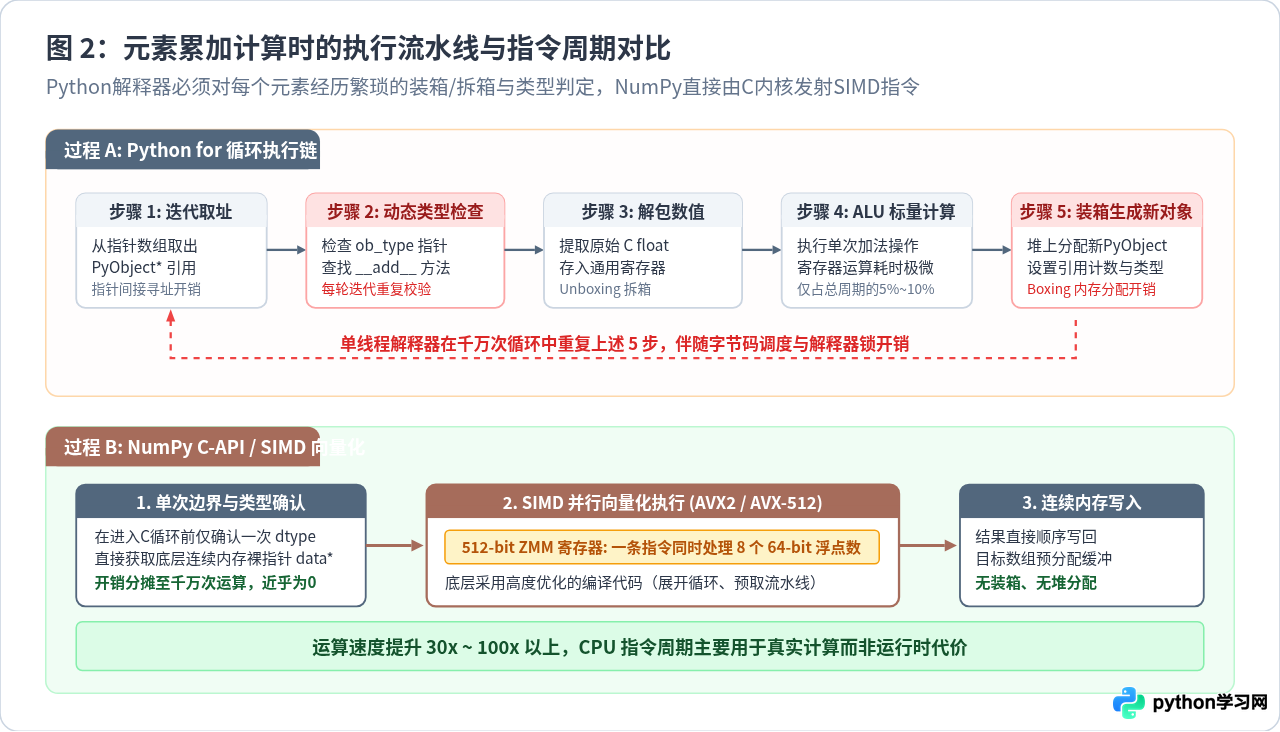
而 NumPy 的向量化(Vectorization)操作将整个循环完全下沉到了高度优化的底层 C/Fortran 代码库中:
- 单次全局类型判定:在运算发起的一瞬间,NumPy 仅需检查一次整个数组的
dtype,随后便直接拿到指向连续数据块的原始 C 指针。 - 无分支编译展开:底层的 C 循环内没有任何动态类型判断,也没有对象创建,循环体被编译为最紧凑的机器指令。
- SIMD(单指令多数据)硬件并发:NumPy 广泛调用了现代 CPU 提供的向量扩展指令集(如 x86 平台的 AVX2、AVX-512 以及 ARM 平台的 Neon)。一个 512 位的向量寄存器在一条 CPU 指令周期内,即可同时完成 8 个 64 位双精度浮点数的加法或乘法运算,计算吞吐量直接成倍跃升。
4. 高维矩阵与广播机制:优雅背后的零内存复制
当数据维度从一维升格为二维矩阵或三维张量时,Python 原生语法的劣势会进一步被几何级放大。在 Python 中构建一个 1000×1000 的浮点数矩阵,唯一的标准做法是构建“列表中嵌套列表”(list of lists)。
这导致了极其可怕的多级指针寻址:外层列表包含 1000 个指针,指向 1000 个内层列表;每个内层列表再包含 1000 个指针,指向具体的 100 万个浮点对象。要对矩阵进行切片、行列提取或转置,必须通过深层推导式重新生成一套完整的列表结构,伴随大量的堆内存分配与垃圾回收压力。
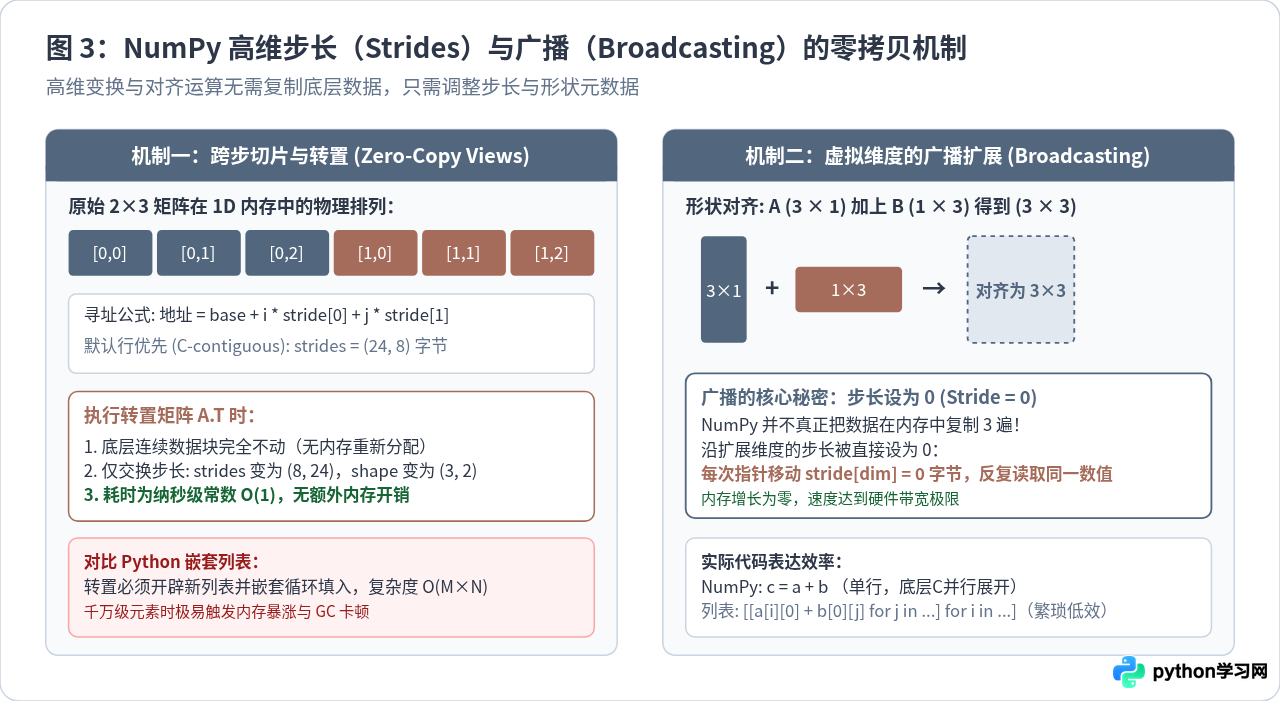
NumPy 解决多维数据的方式异常精妙,其核心由两个数学属性支撑:形状(Shape)与步长(Strides)。
4.1 步长(Strides)与零拷贝视图(Views)
无论数组在逻辑上是几维,在物理内存中它始终只是一维连续的字节数组。步长定义了在某个维度上移动一个索引时,指针在底层内存中需要跳过的字节数。
例如,对于一个形状为 (2, 3) 的 float64 数组,其 strides 通常为 (24, 8)。要定位元素 arr[i, j],底层地址计算极其简单:
address = base_address + i * 24 + j * 8
这一设计的巨大威力在于:转置(.T)、切片(arr[:, 1])或重塑(reshape)操作完全不需要移动或复制任何底层数据!NumPy 只需要生成一个新的轻量级头信息对象,修改其中的 shape 和 strides(例如将转置后的步长调换为 (8, 24)),即可瞬间生成一个原始数据的全新“视图”(View)。这个过程的耗时是绝对恒定的 O(1),消耗内存仅数十字节。
4.2 广播机制(Broadcasting)的虚拟维度
在需要将不同形状的数组进行数学运算时(例如将一个 (1000, 10) 的矩阵逐行加上一个 (10,) 的均值向量),若使用 Python 列表,开发者必须编写双重循环手动平铺数据。
而在 NumPy 中,直接执行 matrix - mean_vector 即可完成。更关键的是,广播并没有在内存中把 mean_vector 真实复制 1000 次,而是利用了步长为 0 的数学特性:在扩展维度上将 stride 设置为 0 字节。当底层循环指针在该维度前进时,实际读取的始终是同一个内存地址,实现了“零额外内存开销”的自动维度对齐与高效向量计算。
5. 边界与工程权衡:什么时候不应该使用 NumPy?
尽管 NumPy 在大规模数值处理中拥有绝对统治力,但这并不意味着它可以在所有场景下无脑替代 Python 原生列表。理解两者的边界,是做出正确架构选择的关键前提。
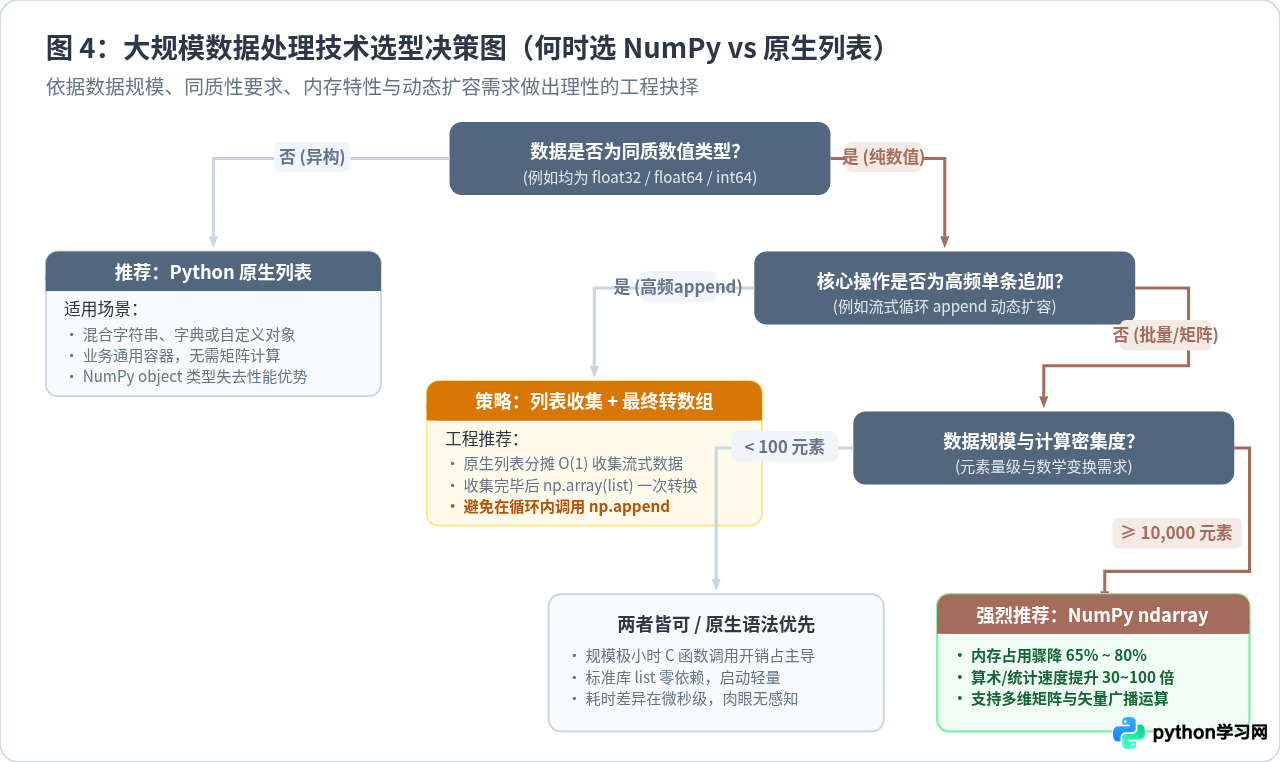
场景 1:频繁的单条元素动态追加(Dynamic Append)
Python 列表具有优秀的动态扩容算法(基于指数预分配缓冲),调用 list.append(x) 的平摊时间复杂度是稳健的 O(1)。
然而,NumPy 数组的底层内存是完全固定长度的。如果在循环中盲目调用 np.append(arr, x),NumPy 每一次都必须在堆中重新申请一块稍大的全新连续内存空间,把旧数据全部逐字节拷贝过去,再写入新元素。在处理 100 万次追加时,时间复杂度会恶化为灾难性的 O(N²),速度比原生列表慢几个数量级。
list 收集元素,待全部加载完成后,通过 np.array(my_list) 一次性转化为 NumPy 数组进行后续数值分析。
场景 2:异构混合数据与非数值对象
NumPy 虽然支持 dtype=object,但这会使它退化为与 Python 列表几乎一致的“指针数组”模式,不仅失去了连续内存缓存命中优势,SIMD 向量化指令也完全无法生效。对于包含字符串、嵌套字典或任意自定义类实例的业务对象集合,Python 原生列表是更自然、轻量且具备完整 Python 语义表达力的容器。
场景 3:微小规模数据(< 100 个元素)
对于只有几十个元素的微小计算,调用 NumPy 函数时所附带的 C-API 接口穿透开销、维度检查与对象包装时间,可能会略大于纯粹的 Python 简单表达式。在这种场景下,不需要引入额外的第三方依赖,Python 基础内置函数(如 sum()、min()、列表推导式)足以胜任。
6. 核心总结
回顾全文,“为什么处理大量数值数据推荐用 NumPy 而不是 Python 列表”这一问题的答案可以凝聚为四个维度的技术落差:
- 空间维度:从“离散多级指针 + 繁重对象头”走向“极简连续二进制字节流”,内存占用骤降 70% 以上;
- 时间维度:消除了逐个元素的解释器装箱/拆箱与动态类型检查,借助硬件 SIMD 指令实现数据并发处理,运算吞吐提升数十到上百倍;
- 结构维度:依托 Strides 步长体系,高维转置、切片与变换实现纳秒级零拷贝视图,彻底终结了嵌套循环构建新矩阵的高昂开销;
- 工程维度:与 Pandas、SciPy、PyTorch、TensorFlow 等现代数据科学和机器学习生态保持底层二进制内存兼容(Buffer Protocol),成为大规模计算流水线中不可替代的标准数据基石。
当数据规模越过万级门槛,NumPy 带来的不仅是执行效率的量变,更是从“解释型逐项运算”向“现代硬件原生运算”范式迁移的质变。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









