

Python字典setdefault()与get()在读取时的应用场景对比
深入对比Python字典get()与setdefault()在读取键值时的底层机制、原字典影响与性能表现。解析常见误区,并通过代码实例讲解配置读取、数据分组、多级嵌套建树与频次统计的最佳实践与选型依据。
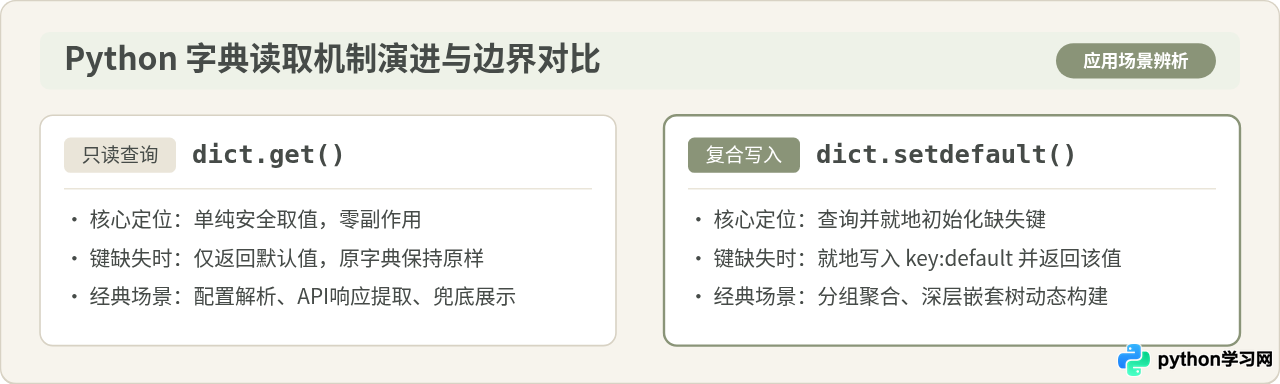
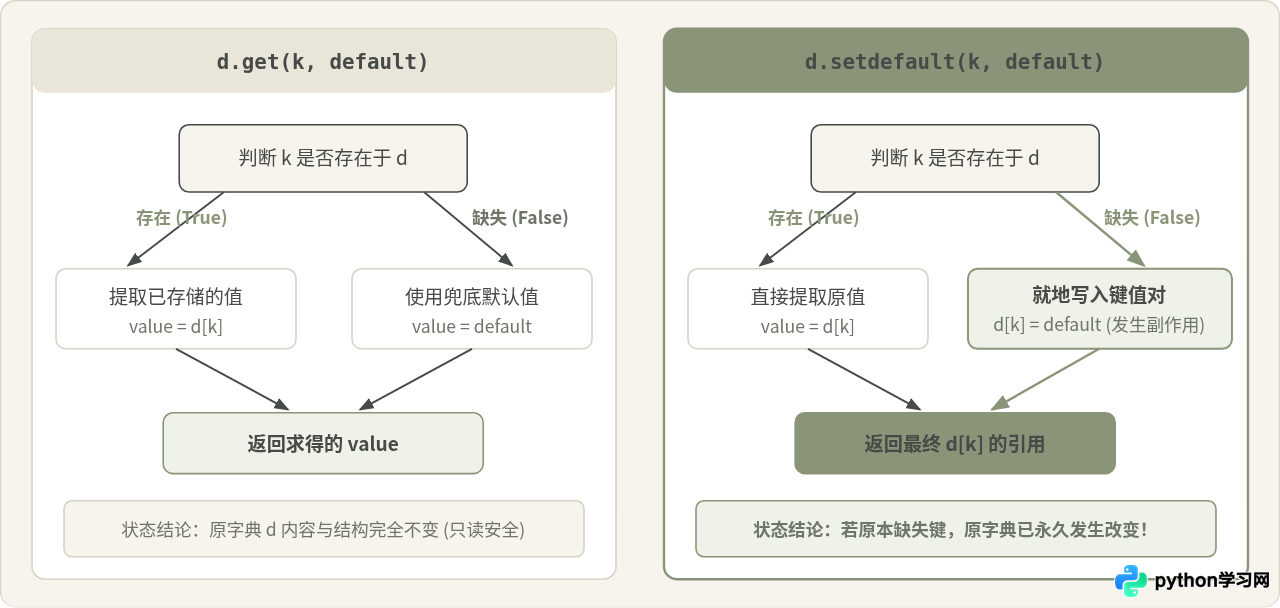
get() 与 setdefault() 都能在键不存在时避免引发 KeyError 并返回给定的默认值。但两者在底层设计与行为目标上有着根本差异:get() 是严格的纯只读操作,无论查询目标是否存在都绝不触碰或修改原字典;而 setdefault() 则是读写复合操作,在键缺失时会立即将键与默认值写入原字典,然后再返回该值的引用。正确理解这一差异,是避免静默数据污染、写出高内聚数据处理代码的关键。
一、核心机制与执行行为剖析
为了直观理解两者的运作机制,先查看两者的标准方法签名与常规调用方式:
dict.get(key, default=None) -> value:在字典中检索key。若键存在,返回对应的实际值;若键不存在,返回指定的default(未指定则返回None)。dict.setdefault(key, default=None) -> value:同样在字典中检索key。若键存在,直接返回其对应的值;若键不存在,先将dict[key] = default写入字典,再返回该default。
这两者在“键已存在”时的返回值完全一致,但当“键缺失”时,底层哈希表的走向彻底分化。下面的代码直观展现了调用前后原字典的状态变化:
# 初始化一个基础信息字典
profile = {"username": "dev_user"}

# 使用 get() 查询不存在的键 "email"
email_res = profile.get("email", "unknown@example.com")
print("email_res:", email_res)
print("当前字典 profile:", profile)
print("字典长度:", len(profile))
可以看到,profile.get("email", ...) 返回了兜底邮箱地址,但原字典 profile 毫发无损,长度依然为 1。接下来对同一个字典调用 setdefault():
# 使用 setdefault() 查询同样不存在的键 "role"
role_res = profile.setdefault("role", "guest")
print("role_res:", role_res)
print("当前字典 profile:", profile)
print("字典长度:", len(profile))
由于 "role" 不在字典中,setdefault() 在返回 "guest" 的同时,把 "role": "guest" 永久注入到了 profile 内部,使字典长度从 1 增加到了 2。
二、深入辨析:常见认知误区与潜藏陷阱
误区一:“setdefault() 只是带默认值的安全读取方法”
部分初学者由于看到 setdefault() 也能返回默认值,且名字中带有 default,便将其当作“更高级的 get()”随手用于纯读取逻辑中。例如在校验用户请求、读取配置文件或生成展示数据时调用:
# 错误示例:在校验或只读探测中滥用 setdefault
def check_user_permission(user_dict):
    # 开发者本意:如果没设置 is_admin,就按 False 判定
    if user_dict.setdefault("is_admin", False):
        return "管理员通道"
    return "普通访客"

session = {"user_id": 1001}
print("校验结果:", check_user_permission(session))
print("调用后的 session:", session)  # {'user_id': 1001, 'is_admin': False} 被静默修改!
这种写法的破坏性在于违反了命令与查询分离原则(CQS):一个表面上负责“检查或查询”的函数,却在每次查询不存在的键时悄悄修改了入参字典。这会导致字典被塞入大量无意产生的默认键,干扰后续的 len() 统计、keys() 迭代,甚至在将字典序列化为 JSON 写入数据库时留下脏数据。只要目标是只读提取,就必须坚决使用 get()。
误区二:“默认参数是在缺少键时才会执行求值的”
无论是 d.get(k, default) 还是 d.setdefault(k, default),它们都遵循 Python 标准的函数参数求值规则——即时求值(Eager Evaluation)。传入的第二个参数会在方法被调用之前就计算完毕,而不是等到发现键缺失才惰性计算。
import time

def fetch_remote_config():
    time.sleep(0.5)  # 模拟耗时网络请求
    return {"timeout": 30}

cache = {"timeout": 10}

# 注意:即使 cache 中已经存在 "timeout",fetch_remote_config() 仍然会每次都执行!
val = cache.get("timeout", fetch_remote_config())
val2 = cache.setdefault("timeout", fetch_remote_config())
在上面的代码中,尽管 cache 里早已存在 "timeout",fetch_remote_config() 依然会被无谓地执行两次并造成延迟。如果默认值的构造涉及复杂计算、文件读取或大对象创建,应改用显式判断:
if "timeout" not in cache:
    cache["timeout"] = fetch_remote_config()
val = cache["timeout"]
误区三:“setdefault() 对所有类型的默认值累加都好用”
有的开发者尝试用 setdefault() 简化数字计数:
# 常见误解:想通过 setdefault(word, 0) 来累加计数
counts = {}
words = ["apple", "banana", "apple"]
for w in words:
    # 这样写无法完成累加!因为整数是不可变对象,返回值 + 1 不会反向作用到原字典
    counts.setdefault(w, 0) + 1  # 无效操作
由于数字(int)是不可变类型,setdefault(w, 0) 返回的是整数 0,对其 + 1 得到的仅仅是一个孤立的临时数字 1,原字典里的值依然保持 0。若要完成累加,依然必须写回 counts[w] = ...。因此在计数场景下,counts[w] = counts.get(w, 0) + 1 语法更加直接明确。
三、典型应用场景对比与选型实战
场景 1:安全配置读取与参数兜底提取(严格选 get)
在解析外部输入、环境变量、API 响应或配置项时,目标通常是:如果配置项存在则使用配置值;不存在则回退到安全默认值,同时绝对不希望变更输入对象。此时 get() 是标准解法。
# 场景:从配置字典提取数据库连接参数
db_config = {
    "host": "127.0.0.1",
    "port": 5432
}

# 安全读取未配置项,原配置字典不受任何污染
max_conn = db_config.get("max_connections", 20)
charset = db_config.get("charset", "utf-8")
ssl_enabled = db_config.get("ssl_enabled", False)

print("连接主机:", db_config.get("host"), "最大连接数:", max_conn)
场景 2:数据分组与一对多聚合映射(首选 setdefault)
在将平铺列表按类别归类分组时,目标是为每个分类建立一个列表容器 [],并将属于该类别的元素放入其中。如果用普通的 get():
# 错误用法:get() 返回的列表是孤立对象,追加后原字典依然为空
groups = {}
groups.get("fruits", []).append("apple")
print(groups)  # 输出依然是 {},apple 被丢弃了!
因为 groups.get("fruits", []) 只是创建了一个临时的空列表并返回,.append("apple") 确实把苹果塞进了这个临时列表,但原字典 groups 中根本没有 "fruits" 这个键,临时列表在执行完毕后被垃圾回收。
换成 setdefault() 则可以一行代码搞定:
records = [
    ("fruit", "apple"),
    ("vegetable", "carrot"),
    ("fruit", "banana"),
    ("meat", "beef"),
    ("vegetable", "spinach")
]

categorized = {}
for category, item in records:
    # 若类别不存在,立即插入空列表并返回引用;若已存在,直接返回已有列表引用
    categorized.setdefault(category, []).append(item)

print(categorized)
在这个场景中,setdefault() 返回的是已经存在于字典哈希槽中的列表对象引用,后续调用的 .append() 是真正的就地修改(In-place mutation),使字典内容随之丰富。
场景 3:多层嵌套字典的只读探测 vs 动态建树
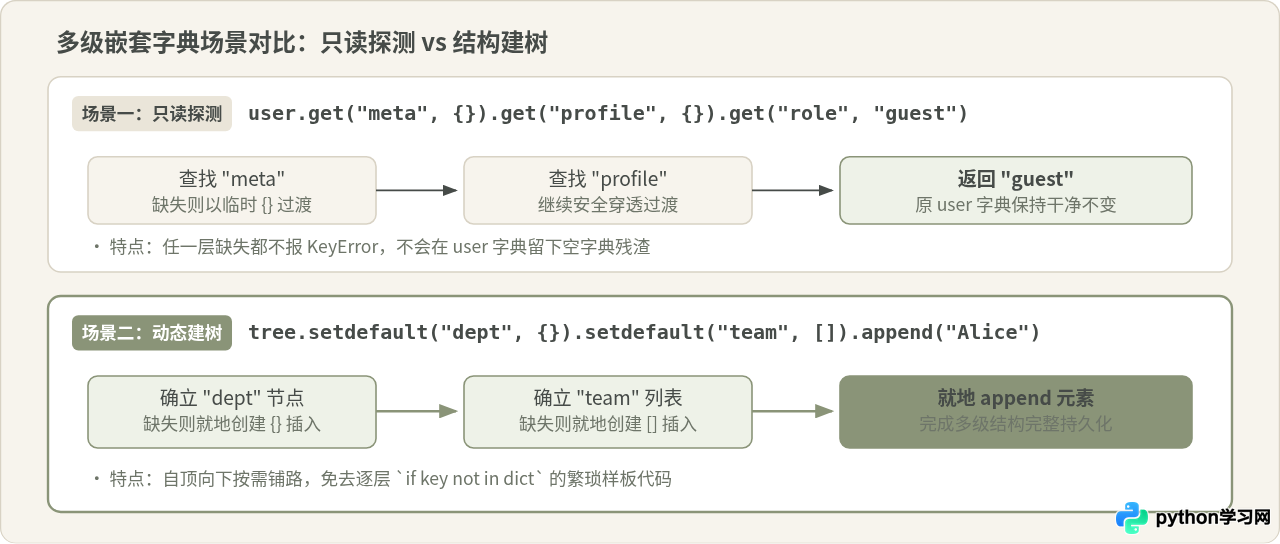
在处理多层嵌套字典(如解析复杂的 JSON 报文或树形目录)时,两者的适用场景截然相反:
- 只读探测(层级提取):当我们要从嵌套层级深处取出一个值,且中途任一层级都可能为缺失时,可以使用多级
.get()链式调用,提供临时的空字典{}传递安全层级,而不会在原始数据中留下多余的空层。 - 动态建树(层级构建):当我们要根据动态路径自动在原字典中创建多层树形结构时,可以使用多级
.setdefault()自动向下铺平路径。
代码对照如下:
# 演示 1:多级只读探测(使用 get)
raw_payload = {"user": {"id": 42}}
# 安全提取深层未定义的头像配置,不破坏原始 payload
avatar = raw_payload.get("user", {}).get("preferences", {}).get("avatar", "default.png")
print("头像地址:", avatar)
print("payload 状态:", raw_payload)  # 原字典依然只有 {'user': {'id': 42}}

# 演示 2:多级动态建树(使用 setdefault)
org_tree = {}
# 动态创建 技术部 -> 后端组 -> 成员列表,自动补齐缺失层级
org_tree.setdefault("技术部", {}).setdefault("后端组", []).append("张三")
org_tree.setdefault("技术部", {}).setdefault("后端组", []).append("李四")
org_tree.setdefault("技术部", {}).setdefault("前端组", []).append("王五")
print("构建完成的部门树:", org_tree)四、选型决策指南与差异总结
当面对一个字典取值或初始化的需求时,可以依照以下决策流快速判断应当选择的方法:
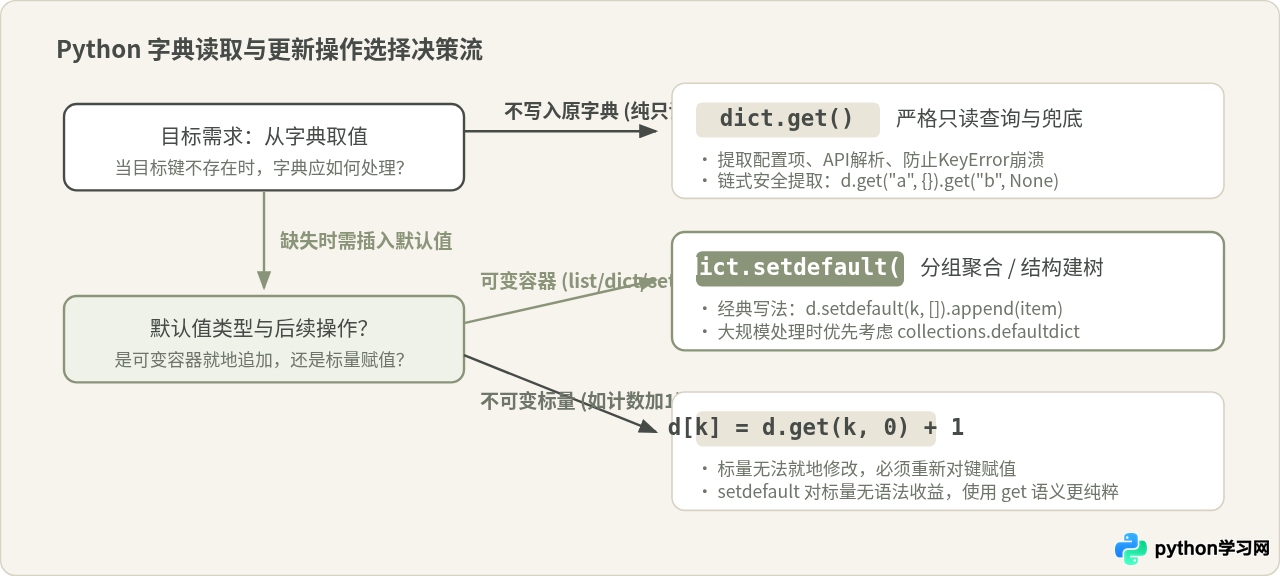
选择依据归纳:
- 如果需求是纯只读查询:无论键是否存在,原字典绝不应该发生变更,一律使用
dict.get()。 - 如果需要在键缺失时向字典注入默认值,且后续需要就地修改可变对象(如
list.append、dict.update):使用dict.setdefault()是标准惯用法。 - 如果是数值统计累加(如词频计数):由于标量必须重新赋值,使用
d[k] = d.get(k, 0) + 1在语义上更清晰;若统计量庞大,更推荐直接使用标准库的collections.Counter。 - 关于性能与
collections.defaultdict的权衡:若在一个大规模循环中频繁进行分组(例如处理数万条记录),dict.setdefault(k, [])在每次循环都会执行一次[]的实例化,并伴随哈希槽检索开销。此时推荐使用标准库的collections.defaultdict(list),它通过底层的__missing__钩子实现真正的惰性初始化,代码更为优雅且运行效率更高。
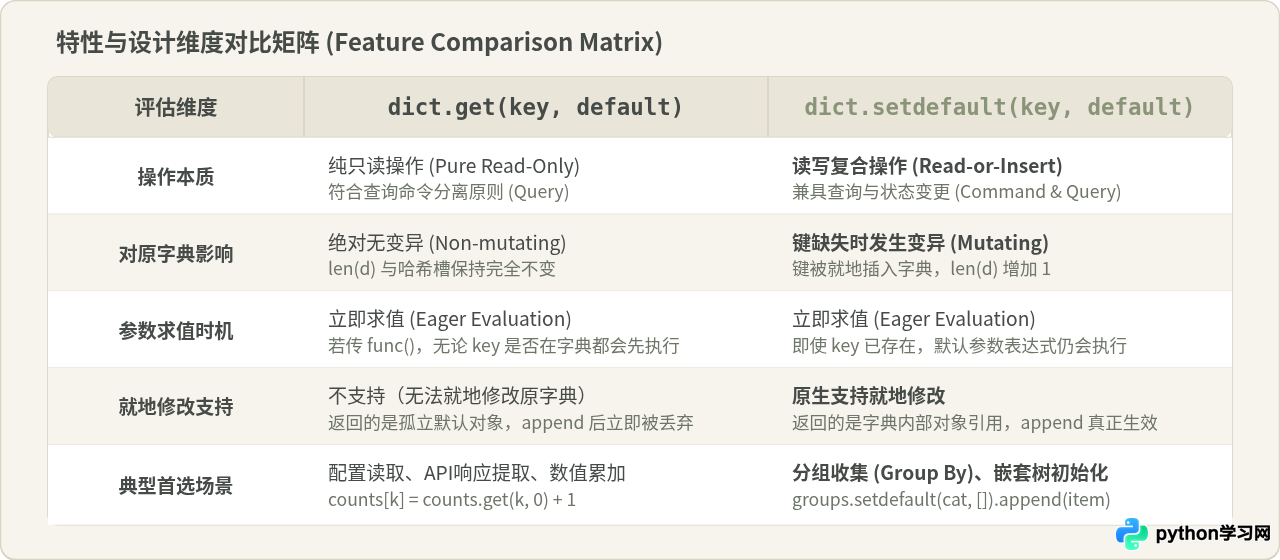
五、快速总结清单
| 功能特性 | dict.get(key, default) | dict.setdefault(key, default) |
|---|---|---|
| 核心设计意图 | 纯只读安全取值,避免 KeyError | 安全取值并在缺失时就地写入默认值 |
| 是否修改原字典 | 否(严格只读,原字典完全不变) | 是(当 key 缺失时,原字典就地新增该键值) |
| 默认值参数求值时机 | 立即求值(传表达式先计算) | 立即求值(传表达式先计算) |
| 可变容器就地追加 | 不支持(返回临时对象,修改后丢失) | 原生支持(返回字典内对象引用,修改持久化) |
| 典型适用业务场景 | 配置读取、API参数解析、防御性查询 | 数据分组汇集(Group by)、动态生成嵌套字典树 |
| 替代/进阶方案 | 显式 if key in d 或字典解构 |
collections.defaultdict / collections.Counter |
“读后不留痕,安全用 get;读后要占位,追加用 setdefault。”
在日常开发中,清晰划分只读查询与状态写入,能够显著降低系统隐性 Bug,使数据流向清晰可靠。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









