

怎么用Python取模运算判断奇偶数与实现循环索引
详细讲解在Python中如何使用取模运算符(%)进行奇偶数判断以及实现列表的循环索引。涵盖Python取模与整除的数学原理、负数运算特性、轮播轮询与分页对齐等实战场景与注意事项。
在 Python 编程中,百分号 % 作为取模运算符(Modulo Operator),返回两数相除后的整数余数。它的核心数学价值在于“将离散的整数收敛到固定的周期区间内”——利用除以 2 产生的 0 与 1 可完成奇偶数划分,利用除以列表长度 N 产生的 0 至 N-1 则能无缝实现环形循环索引。本文将详细讲解这两大经典场景的实现方法、底层运算机制与避坑准则。
一、取模运算符的基本数学定义与运行机制
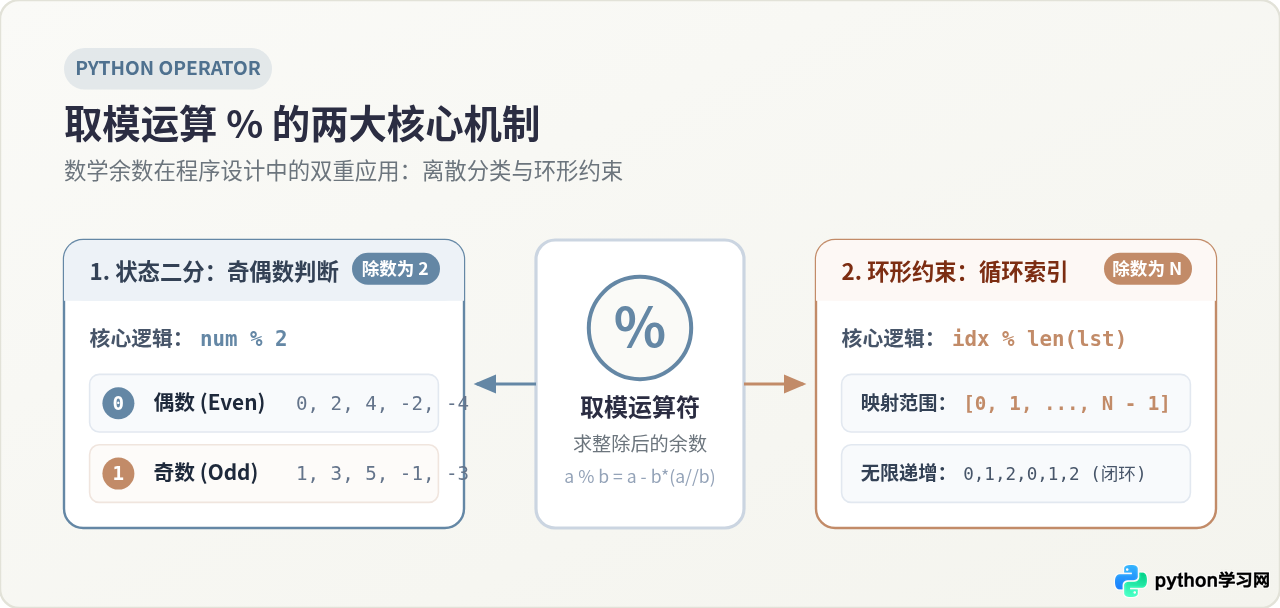
取模运算(Modulo Operation)通常被初学者称为“求余数”,但在深入编写代码前,必须掌握其严谨的数学关系。在 Python 中,给定两个整数 a 和 b,取模运算 a % b 与整除运算 a // b 严格满足以下恒等式:
a = b * (a // b) + (a % b)其中,关键差异在于 Python 对整除 // 采用的是向下取整(Floor Division),即始终朝向负无穷大方向取最近的整数,而不是向零截断(Truncation)。这一核心设定决定了:当除数 b 为正整数时,无论被除数 a 是正数还是负数,取模结果 a % b 的值域始终严格落在闭区间 [0, b - 1] 内,绝不会产生负余数。
这个性质为 Python 带来了两大便利:在做奇偶数判断时,负奇数的结果统一为 1;在做循环索引时,向前倒退的负下标能够自然跳转到列表尾部。
二、怎么用取模运算判断奇偶数
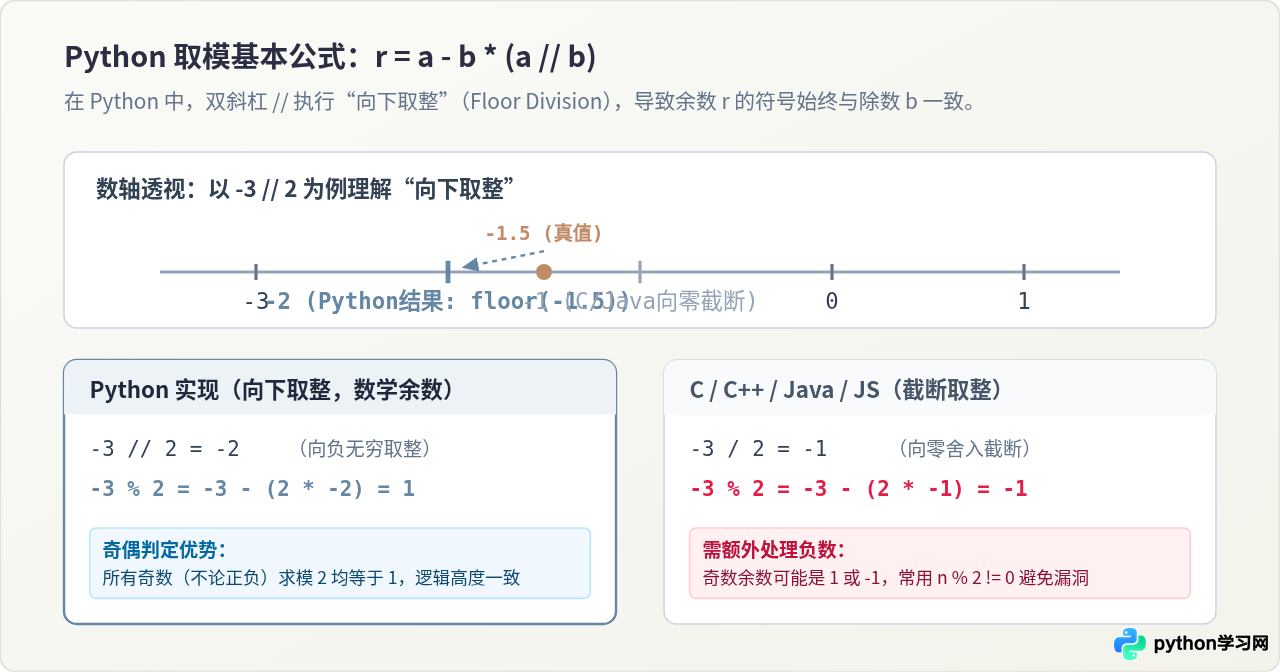
判断一个整数是奇数还是偶数,本质是检查它能否被 2 整除。如果一个数除以 2 的余数为 0,说明它是偶数;余数不为 0,则说明它是奇数。
1. 标准实现代码
在 Python 中,通过 number % 2 即可快速完成判断:
def is_even(num: int) -> bool:
    # 余数为 0 即为偶数
    return num % 2 == 0

def is_odd(num: int) -> bool:
    # 余数不为 0(在 Python 中等价于 == 1)即为奇数
    return num % 2 != 0

# 示例测试输出
print(is_even(8))    # 输出: True
print(is_even(7))    # 输出: False
print(is_odd(-5))    # 输出: True
print(is_even(-4))   # 输出: True
print(is_even(0))    # 输出: True (0 是标准偶数)
2. 深度剖析:为什么 Python 中判断奇数可以直接写 n % 2 == 1
在 C 语言、C++ 或 Java 等静态语言中,由于整除采用“向零取整”,计算 -3 % 2 时会得到 -1。因此在那些语言中,如果写 n % 2 == 1,会对负奇数(如 -3、-5)发生漏判,必须写成 n % 2 != 0。
但在 Python 中,运算机制如下:
-3 // 2计算出floor(-1.5) = -2;- 根据恒等式:
-3 % 2 = -3 - (2 * -2) = -3 - (-4) = 1。
这意味着在 Python 中,所有正负奇数除以 2 的余数都是 1。因此,无论编写 n % 2 != 0 还是 n % 2 == 1,在 Python 中都能准确覆盖负数,完全安全。
3. 批量数据分类实战
在日常数据清洗与业务逻辑中,我们常常需要将一个数字列表拆分为奇数集和偶数集,结合列表推导式(List Comprehension)能够写出简洁高效的代码:
numbers = [12, -7, 0, 19, -4, 23, 8, 15]

# 筛选所有偶数
evens = [n for n in numbers if n % 2 == 0]
# 筛选所有奇数
odds = [n for n in numbers if n % 2 != 0]

print("偶数列表:", evens)  # 示例输出: [12, 0, -4, 8]
print("奇数列表:", odds)   # 示例输出: [-7, 19, 23, 15]
三、怎么用取模运算实现循环索引
在开发图片轮播图、走马灯、任务轮询分配(Round-Robin)、游戏回合轮转或环形缓冲区时,经常面临这样一个挑战:当指针下标增加到超出列表最大下标时,需要让它自动折返回列表头部;反之,当指针往前翻越第 0 项时,需要折返回列表末尾。
如果使用 if-else 条件分支来判断越界,不仅代码冗长,而且难以应对一次性跨越多个步长(如一次跳跃 5 步)的场景。使用取模运算 index % len(sequence) 是实现循环索引最优雅的标准解法。
1. 核心数学模型
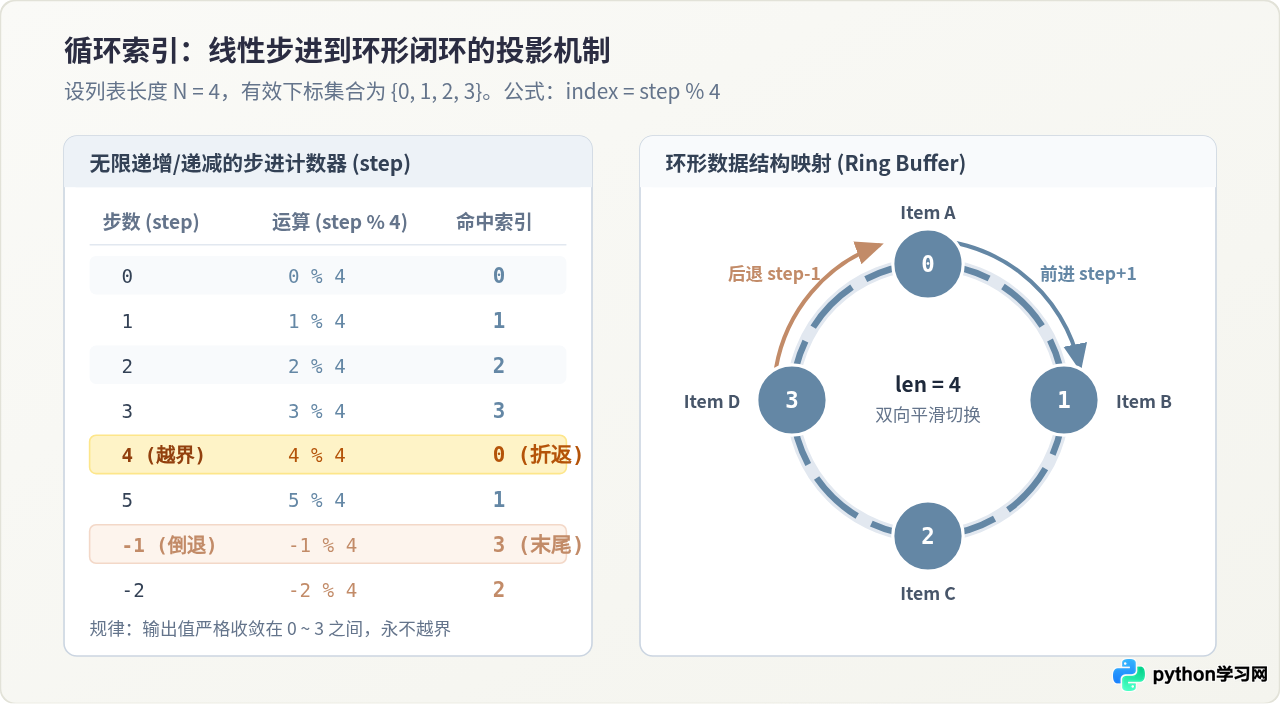
设列表长度为 N = len(items),合法索引范围为 0 到 N - 1。当步进计数器 step 持续递增时,step % N 的输出将呈现出周期性波形:
step = 0, 1, 2, ..., N-1:取模结果与原值相同;step = N:N % N = 0,指针回到起点;step = N + 1:(N + 1) % N = 1,继续向前推进;step = -1:-1 % N = N - 1,自动环绕到最后一项。
2. 实战场景 A:无缝双向图片轮播(Next / Prev 控制)
下面是一个完整的轮播控制器类实现,读者可以直接在 Python 3 中执行:
class Carousel:
    def __init__(self, slides: list):
        if not slides:
            raise ValueError("幻灯片列表不能为空!")
        self.slides = slides
        self.current_idx = 0

    def next_slide(self) -> str:
        # 下一张:正向递增并取模回绕
        self.current_idx = (self.current_idx + 1) % len(self.slides)
        return self.slides[self.current_idx]

    def prev_slide(self) -> str:
        # 上一张:负向递减并取模回绕
        self.current_idx = (self.current_idx - 1) % len(self.slides)
        return self.slides[self.current_idx]

# 使用示例
banner = Carousel(["Slide A", "Slide B", "Slide C"])
print("初始:", banner.slides[banner.current_idx])  # Slide A

print("点击下一张:", banner.next_slide())  # Slide B
print("点击下一张:", banner.next_slide())  # Slide C
print("点击下一张:", banner.next_slide())  # 越界自动回到 Slide A

print("点击上一张:", banner.prev_slide())  # 首项往前翻,自动回到 Slide C
3. 实战场景 B:服务器集群负载均衡(Round-Robin 调度)
在高并发架构中,将请求均匀轮流分发给 N 台后端服务器是经典模式。无需维护复杂队列,只需一个自增全局计数器与取模运算:
servers = ["192.168.1.101", "192.168.1.102", "192.168.1.103"]

def dispatch_request(request_id: int) -> str:
    # 无论请求ID多大,始终均匀映射到 0, 1, 2 服务器下标
    target_index = request_id % len(servers)
    return servers[target_index]

# 模拟连续涌入的 7 个请求
for req_id in range(7):
    assigned = dispatch_request(req_id)
    print(f"请求 #{req_id} -> 派发至服务器: {assigned}")

# 示例输出:
# 请求 #0 -> 派发至服务器: 192.168.1.101
# 请求 #1 -> 派发至服务器: 192.168.1.102
# 请求 #2 -> 派发至服务器: 192.168.1.103
# 请求 #3 -> 派发至服务器: 192.168.1.101 (自动轮转)
# 请求 #4 -> 派发至服务器: 192.168.1.102
# 请求 #5 -> 派发至服务器: 192.168.1.103
# 请求 #6 -> 派发至服务器: 192.168.1.101
四、进阶组合:一维循环向二维网格坐标转换
在 UI 界面排列(如商品瀑布流、图片画廊)或游戏棋盘(如 8×8 国际象棋)中,数据通常以一维数组平铺存储,但在页面渲染时需要转换为 (行, 列) 的二维网格。此时,取模运算 % 与整除运算 // 是天然的黄金搭档:
- 行号(Row):由整除运算决定,
row = index // cols(代表当前项目已经装满了多少整行); - 列号(Col):由取模运算决定,
col = index % cols(代表当前项目在本行内的偏移余量)。
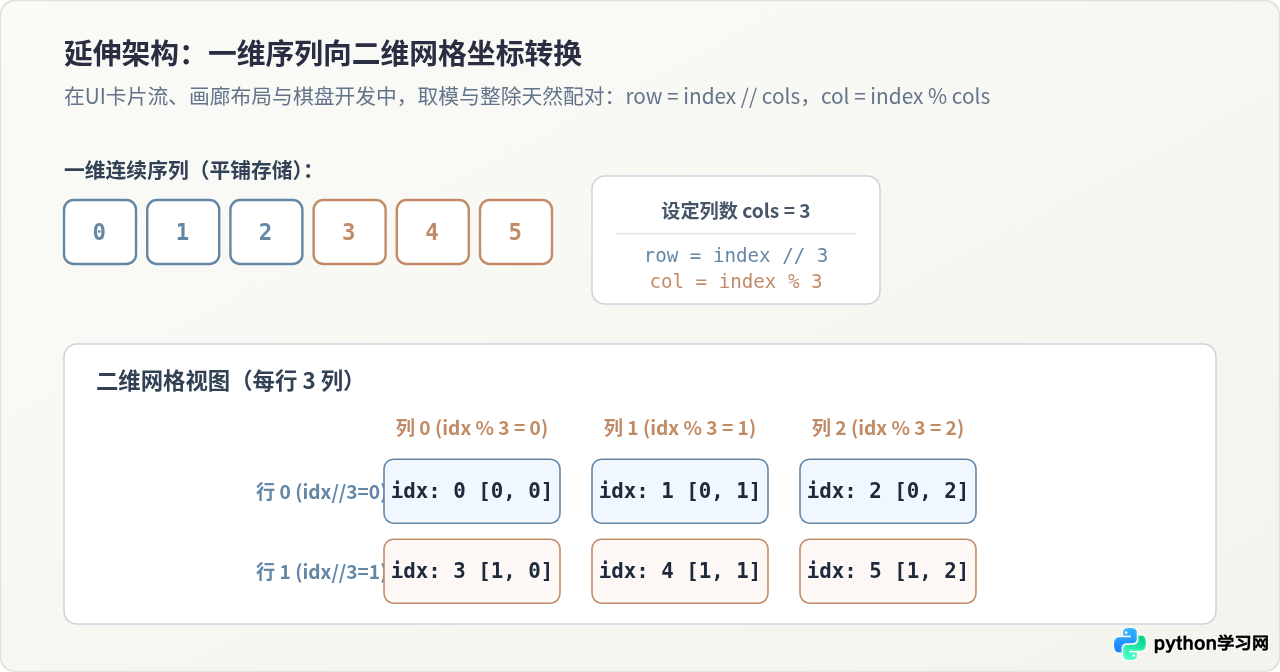
示例代码如下:
items = ["用户A", "用户B", "用户C", "用户D", "用户E", "用户F"]
COLS = 3  # 设定每行显示 3 列

for idx, user in enumerate(items):
    row = idx // COLS
    col = idx % COLS
    print(f"元素 [{user}] -> 放置于网格 第 {row} 行, 第 {col} 列")

# 示例输出:
# 元素 [用户A] -> 放置于网格 第 0 行, 第 0 列
# 元素 [用户B] -> 放置于网格 第 0 行, 第 1 列
# 元素 [用户C] -> 放置于网格 第 0 行, 第 2 列
# 元素 [用户D] -> 放置于网格 第 1 行, 第 0 列 (自动折行)
# 元素 [用户E] -> 放置于网格 第 1 行, 第 1 列
# 元素 [用户F] -> 放置于网格 第 1 行, 第 2 列
五、开发中必须注意的边界与避坑准则
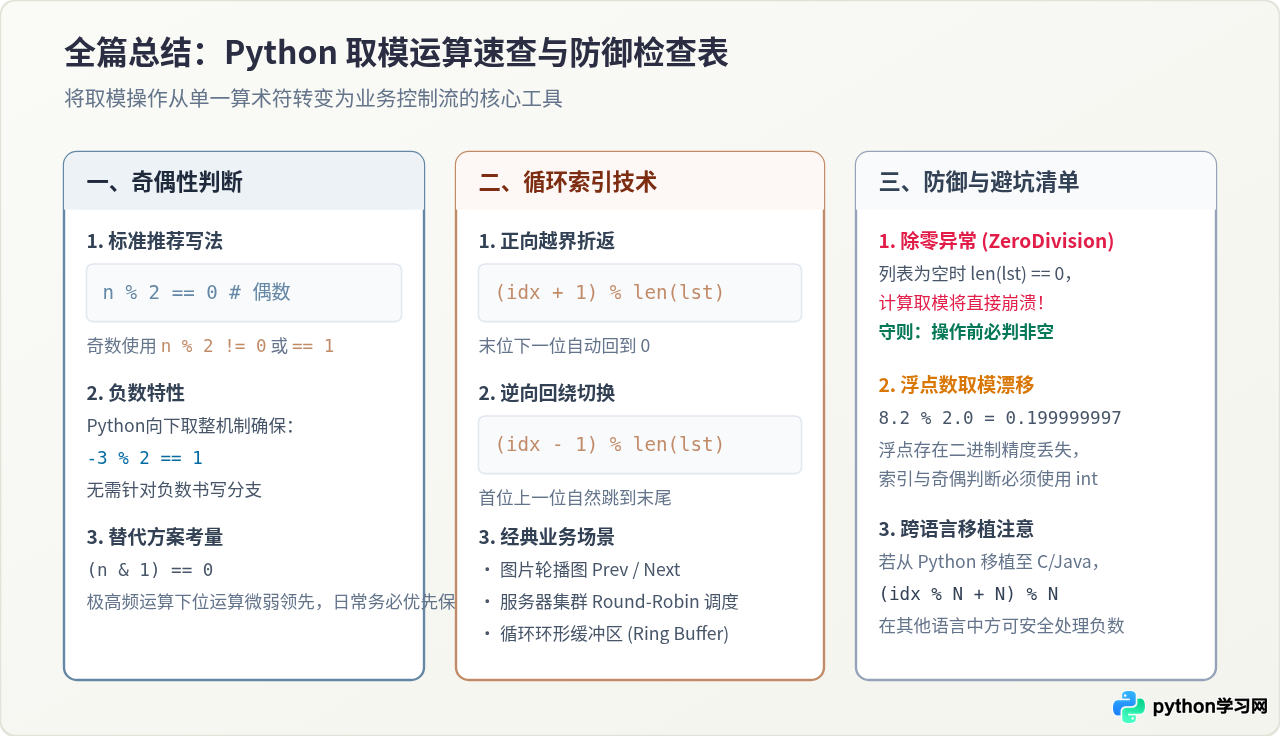
1. 严防除零异常(ZeroDivisionError)
数学中除数不能为 0,程序中同样如此。在做循环索引 idx % len(lst) 时,如果传入的列表为空列表 [],len(lst) 为 0,程序将立即抛出 ZeroDivisionError: integer division or modulo by zero 异常并崩溃。
if not lst: return None。
2. 避免对浮点数使用取模判断奇偶
Python 允许对浮点数执行 % 操作(如 8.2 % 2.0),但由于 IEEE 754 二进制浮点数在计算机中的存储精度限制,其运算结果往往包含极小的浮点误差:
print(8.2 % 2.0) # 结果并非理想的 0.2,而是 0.1999999999999993因此,严禁用浮点数做奇偶数判断。如果涉及浮点数判断,应先使用 int(round(val)) 或在业务层进行整数化转换后再取模。
3. 性能对比:取模 % 2 与位运算 & 1
在计算机底层,偶数的二进制最低位必为 0,奇数的二进制最低位必为 1。因此,利用按位与运算符 number & 1 也可以判断奇偶((num & 1) == 0 为偶数)。
| 判断方式 | 代码写法 | 可读性 | 执行效率 | 最佳适用场景 |
|---|---|---|---|---|
| 取模运算 | num % 2 == 0 |
极高(语义直观) | 优异(Python底优化良好) | 绝大多数业务系统、数据统计与日常脚本 |
| 按位与运算 | (num & 1) == 0 |
中等(需底层位运算认知) | 微弱领先(纳秒级别提升) | 海量数据计算、加密算法、极度苛刻的高频循环 |
在现代 CPython 解释器中,整数取模已经被高度优化。除非在数千万次循环的极限性能瓶颈中,否则强烈建议使用 num % 2 == 0,这能为团队代码带来最高的清晰度与可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









