

利用PyTorch自动微分求解常微分方程:PINN应用实例
深入讲解利用PyTorch自动微分机制构建物理信息神经网络(PINN)求解常微分方程的完整流程。结合阻尼振子实例,详解网络设计、autograd.grad高阶导数计算、损失函数构建及代码实现。
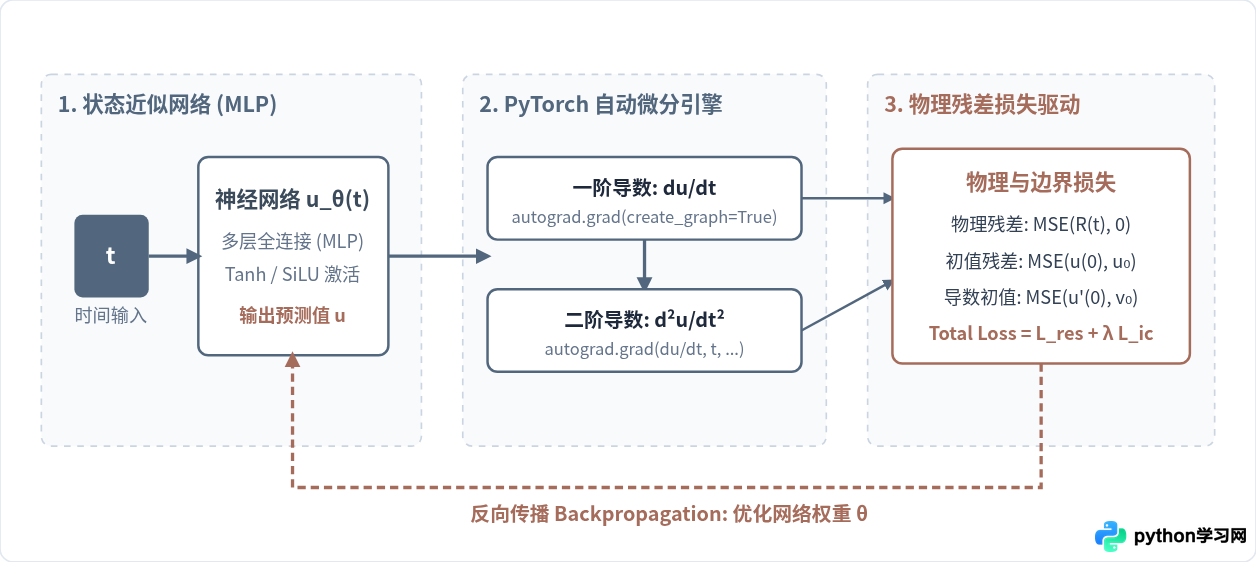
一、PINN 求解常微分方程的核心机理
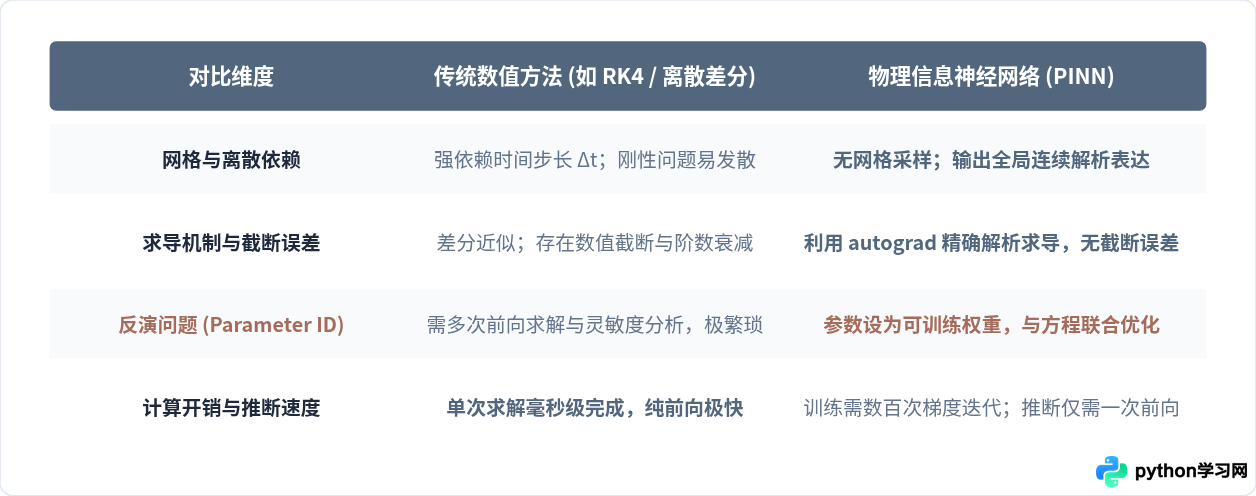
传统的常微分方程(ODE)数值求解方法(例如欧拉法、四阶 Runge-Kutta 法)依赖于离散时间网格,通过步进推进获得一系列离散状态点。当方程步长不合适或遇到刚性系统时,数值累积误差或发散往往难以避免。
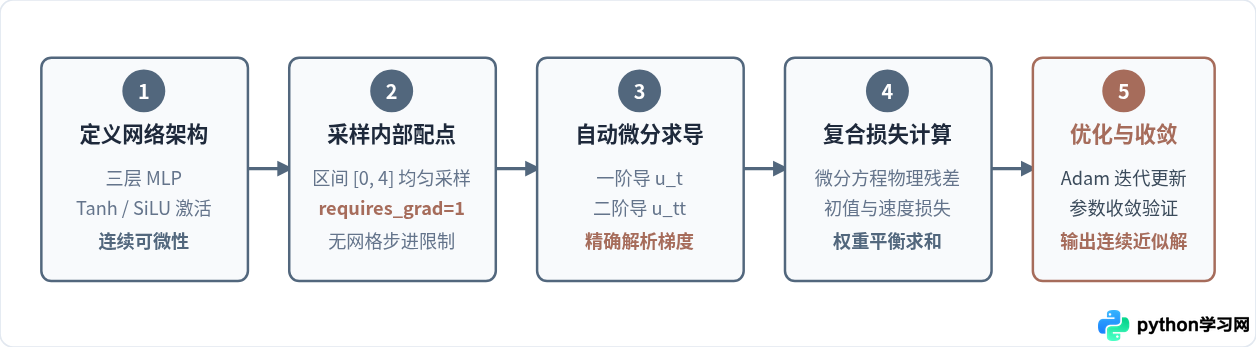
PINN 换了一种思路:用全连接神经网络 $u_\theta(t)$ 来逼近未知状态函数 $u(t)$。自变量 $t$ 输入网络,网络输出 $u_\theta(t)$。由于神经网络本质上是一个连续且处处光滑的复合函数,因此我们可以借助 PyTorch 的反向传播引擎(autograd),计算输出 $u$ 对输入自变量 $t$ 的各阶精确导数($\frac{du}{dt}$、$\frac{d^2u}{dt^2}$)。
将这些导数代入常微分方程后,方程成立的条件即“残差等于零”。我们只需在定义域内均匀或随机撒上一组配点(Collocation Points),将残差平方和与初始条件误差组合成标量损失,使用梯度下降(如 Adam 优化器)优化网络权重 $\theta$。优化收敛时,网络输出就是该微分方程的连续解析解近似。
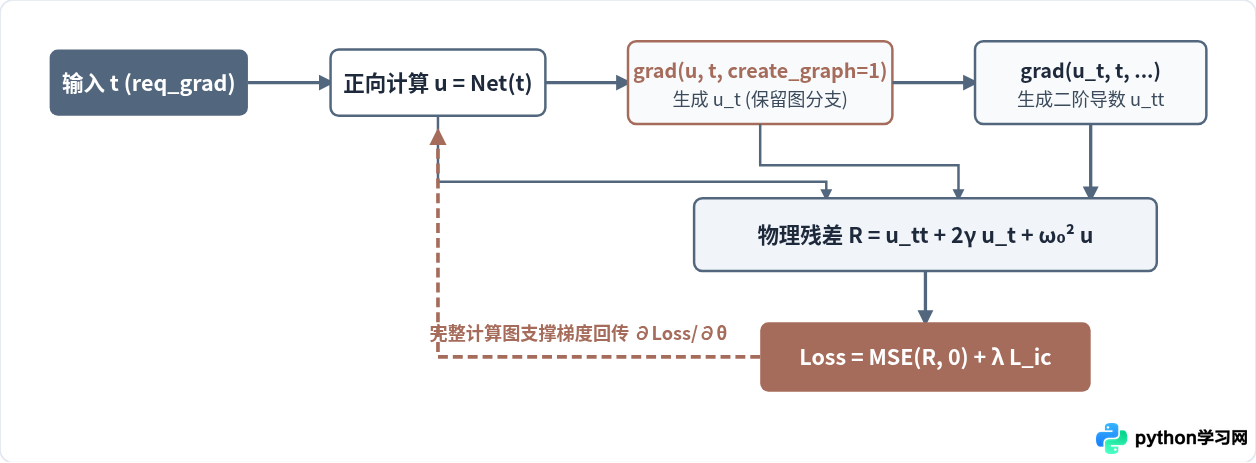
二、PyTorch 自动微分在高阶导数中的关键细节
常规 PyTorch 训练中,我们通过 loss.backward() 对网络权重参数(Weights & Biases)求梯度。但在物理方程中,我们首先需要计算的是网络输出对输入自变量的导数。这就必须用到 torch.autograd.grad 函数。
有两处关键设置决定了整个计算过程能否正确运行:
-
自变量必须显式开启梯度追踪:
输入变量 $t$ 在送入网络前,必须满足
t.requires_grad = True。如果忘记开启,PyTorch 会认为 $t$ 是固定常量,求导时直接报错或得到None。 -
高阶求导必须保留计算图(
create_graph=True): 当我们求一阶导数 $\frac{du}{dt}$ 时,必须传入参数create_graph=True。只有这样,PyTorch 才会为导数 $\frac{du}{dt}$ 本身构建计算图。后续求二阶导数 $\frac{d^2u}{dt^2}$ 以及最终计算loss.backward()更新网络参数 $\theta$ 时,梯度才能顺利逆流回神经网络各层权重。如果遗漏此参数,残差图与参数间的连接就会断裂,网络参数将无法更新。
三、实战问题建模:二阶阻尼振子常微分方程
为了给出一个清晰、可验证的完整实例,我们求解物理学中极具代表性的欠阻尼简谐振子方程:
初始条件给定初始位移与初始速度:
在系统处于欠阻尼状态($\gamma < \omega_0$)时,该方程具有明确的解析解,方便我们评估 PINN 的解算精度:
在下面的实验中,设定阻尼系数 $\gamma = 0.4$,固有角频率 $\omega_0 = 4.0$。
四、完整可运行 PyTorch 代码实现
以下给出完整的实现代码。代码包含网络定义、初边值与配点生成、损失函数与高阶导数求解,以及训练循环与解析解验证。代码在纯 CPU 环境下即可在十秒内完成收敛。
import torch
import torch.nn as nn
import numpy as np

# 1. 物理问题参数设定
GAMMA = 0.4        # 阻尼系数
OMEGA_0 = 4.0      # 固有频率
T_MAX = 4.0        # 时间上限
N_COLLOC = 400     # 内部物理方程配点数

# 2. 构建 PINN 神经网络
class PINN(nn.Module):
    def __init__(self, hidden_dim=40):
        super(PINN, self).__init__()
        # 使用 3 层全连接层,Tanh 激活函数保证高阶可微
        self.net = nn.Sequential(
            nn.Linear(1, hidden_dim),
            nn.Tanh(),
            nn.Linear(hidden_dim, hidden_dim),
            nn.Tanh(),
            nn.Linear(hidden_dim, 1)
        )

    def forward(self, t):
        return self.net(t)

# 3. 真实解析解(用于对比验证)
def exact_solution(t_np):
    w = np.sqrt(OMEGA_0**2 - GAMMA**2)
    return np.exp(-GAMMA * t_np) * (np.cos(w * t_np) + (GAMMA / w) * np.sin(w * t_np))

# 4. 训练主流程
def train_pinn():
    torch.manual_seed(42)
    model = PINN(hidden_dim=32)
    optimizer = torch.optim.Adam(model.parameters(), lr=0.005)

    # 4.1 构造初始条件点 (t = 0)
    t_0 = torch.tensor([[0.0]], requires_grad=True)
    u_0_target = 1.0
    v_0_target = 0.0

    # 4.2 构造区间内配点
    t_colloc = torch.linspace(0.0, T_MAX, N_COLLOC).view(-1, 1)
    t_colloc.requires_grad = True

    print("开始训练 PINN...")
    for epoch in range(1, 1501):
        optimizer.zero_grad()

        # --- A. 初始条件损失 ---
        u_0_pred = model(t_0)
        loss_u0 = (u_0_pred - u_0_target) ** 2

        # 初始速度 du/dt 在 t=0 处的导数
        grad_u0 = torch.autograd.grad(
            outputs=u_0_pred,
            inputs=t_0,
            grad_outputs=torch.ones_like(u_0_pred),
            create_graph=True
        )[0]
        loss_v0 = (grad_u0 - v_0_target) ** 2
        loss_ic = loss_u0 + loss_v0

        # --- B. 物理方程残差损失 (配点) ---
        u_colloc = model(t_colloc)

        # 一阶导数 du/dt,必须使用 create_graph=True
        u_t = torch.autograd.grad(
            outputs=u_colloc,
            inputs=t_colloc,
            grad_outputs=torch.ones_like(u_colloc),
            create_graph=True
        )[0]

        # 二阶导数 d^2u/dt^2
        u_tt = torch.autograd.grad(
            outputs=u_t,
            inputs=t_colloc,
            grad_outputs=torch.ones_like(u_t),
            create_graph=True
        )[0]

        # 物理控制方程残差: u'' + 2γ u' + ω0^2 u = 0
        residual = u_tt + 2.0 * GAMMA * u_t + (OMEGA_0 ** 2) * u_colloc
        loss_residual = torch.mean(residual ** 2)

        # --- C. 总体损失与反向传播 ---
        # 初始条件施加适度权重以保证边界强约束
        total_loss = loss_residual + 20.0 * loss_ic

        total_loss.backward()
        optimizer.step()

        if epoch % 300 == 0 or epoch == 1:
            print(f"Epoch {epoch:4d} | Total Loss: {total_loss.item():.6f} | "
                  f"Residual Loss: {loss_residual.item():.6f} | IC Loss: {loss_ic.item():.6f}")

    # 5. 结果评估与验证
    t_test = torch.linspace(0.0, T_MAX, 100).view(-1, 1)
    with torch.no_grad():
        u_pred = model(t_test).numpy().flatten()
    t_test_np = t_test.numpy().flatten()
    u_exact = exact_solution(t_test_np)

    mae = np.mean(np.abs(u_pred - u_exact))
    max_err = np.max(np.abs(u_pred - u_exact))
    print(f"\n训练完成!在 [0, 4] 区间上的平均绝对误差 (MAE): {mae:.5f},最大绝对误差: {max_err:.5f}")

if __name__ == "__main__":
    train_pinn()
注意:在编写 torch.autograd.grad 时,若对批量点进行求导,必须传入与输出形状一致的全 1 张量 grad_outputs=torch.ones_like(u_colloc)。这是因为向量对向量求导在自动微分中实质是雅可比-向量积(Vector-Jacobian Product,VJP)。全 1 向量恰好能让各个样本点独立且正确地计算出自身对 $t$ 的偏导。
五、PINN 与传统数值方法的对比与选型建议
许多工程师在面对常微分方程时,第一反应是:“既然 Scipy 里的 solve_ivp 又快又准,为什么还要折腾 PINN?”
理解两者的差异与边界,能帮助我们在正确场景选用合适的工具。传统数值算法针对前向初始值问题已经非常成熟高效,而 PINN 的核心优势体现在反问题参数辨识、无规则观测数据融合以及无网格连续表示上。
六、实践中的关键踩坑点与工程建议
在将上述方法迁移到其他常微分或偏微分系统时,往往会遇到训练不收敛或解失真的情况。以下是三个最重要的实战避坑经验:
-
绝不能使用 ReLU 类分段线性激活函数:
对于二阶常微分方程,ReLU 的一阶导数为常数分段跃迁,二阶导数处处为 0。使用 ReLU 将导致二阶物理残差完全失效。务必选用高阶连续光滑的激活函数,例如
Tanh、GELU或SiLU。 - 损失权重的量级平衡(Loss Weighting): 如果初始条件项 $L_{\text{ic}}$ 的权重过低,网络容易找到全 0 解(平庸解),即残差极小但完全不满足初值。适当提高初始条件损失权重(如本例中的 20.0),能强迫模型优先锚定初始状态。
- 自变量域的归一化: 若时间域跨度很大(如 $t \in [0, 1000]$),直接输入网络容易导致内部梯度爆炸或消失。建议对自变量进行尺度变换 $\tau = t / T_{\text{scale}}$,将方程转换到无量纲区间 $[0, 1]$ 之后再送入神经网络求解。
通过 PyTorch 的 autograd.grad 搭配物理残差,PINN 提供了一种全新的无网格求解范式。掌握其底层计算图构建与导数回传机制,是进一步探索复杂偏微分方程、流体力学系统及物理参数反演的坚实基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









