

Python读取文件用哪个模块?内置open与pathlib对比
详细对比Python中内置open()函数与标准库pathlib模块的差异、适用场景、操作步骤及性能表现,帮助开发者选择最适合的文件读取方案。
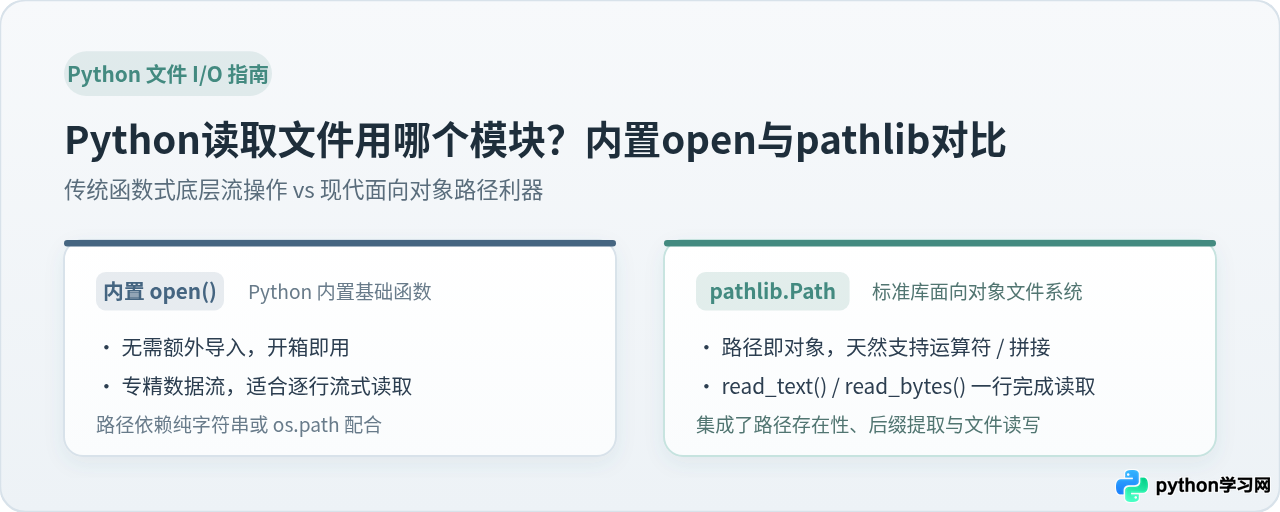
open() 与标准库模块 pathlib(核心为 Path 类)。简明结论是:如果只做纯粹的文件内容读取或处理超大文本流,内置 open() 语法直接、无需导入;但如果任务伴随路径判断、跨平台路径拼接、目录遍历或读取中小型配置文件,优先推荐使用 pathlib.Path。现代 Python(3.4 引入、3.6+ 成为标准工程范式)中,pathlib 提供了面向对象的封装,其内置的 read_text() 和 read_bytes() 方法大幅简化了常规读取代码。
一、核心差异速览:open() 与 pathlib 对照表
很多开发者在选择时常产生疑问:既然已经有了内置的 open(),为什么 Python 还要在标准库中推行 pathlib?理解这一点的关键在于操作维度的差异。open() 专职于数据流的传输与缓冲区读写,而 pathlib 将“路径”本身提升为一等公民对象,将文件状态探测、路径解析以及快速读写集于一身。
| 对比维度 | 内置函数 open() | 标准库 pathlib.Path |
|---|---|---|
| 模块归属 | Python 语言内置(底层对应 io.open) |
标准库 pathlib 模块(直接 import 即可) |
| 调用方式 | 全局函数:open('file.txt', 'r') |
面向对象方法:Path('file.txt').read_text() |
| 路径类型入参 | 接受字符串、字节串或路径对象(os.PathLike) |
路径对象自身具备方法,无需传参给外部函数 |
| 读取小文件代码量 | 需要 with 上下文管理器 + f.read()(至少 2-3 行) |
仅需 1 行:p.read_text(encoding='utf-8') |
| 路径组合与处理 | 依赖纯字符串拼接或配合 os.path.join() |
原生支持斜杠运算符:folder / 'sub' / 'file.txt' |
| 超大文件逐行流式 | 支持优秀(for line in f: 迭代器流式处理) |
同样支持优秀(调用 with p.open() as f:) |
| 生命周期管理 | 必须严格使用 with 语句防止句柄泄漏 |
read_text() 内建自动关闭;流式同样支持 with |
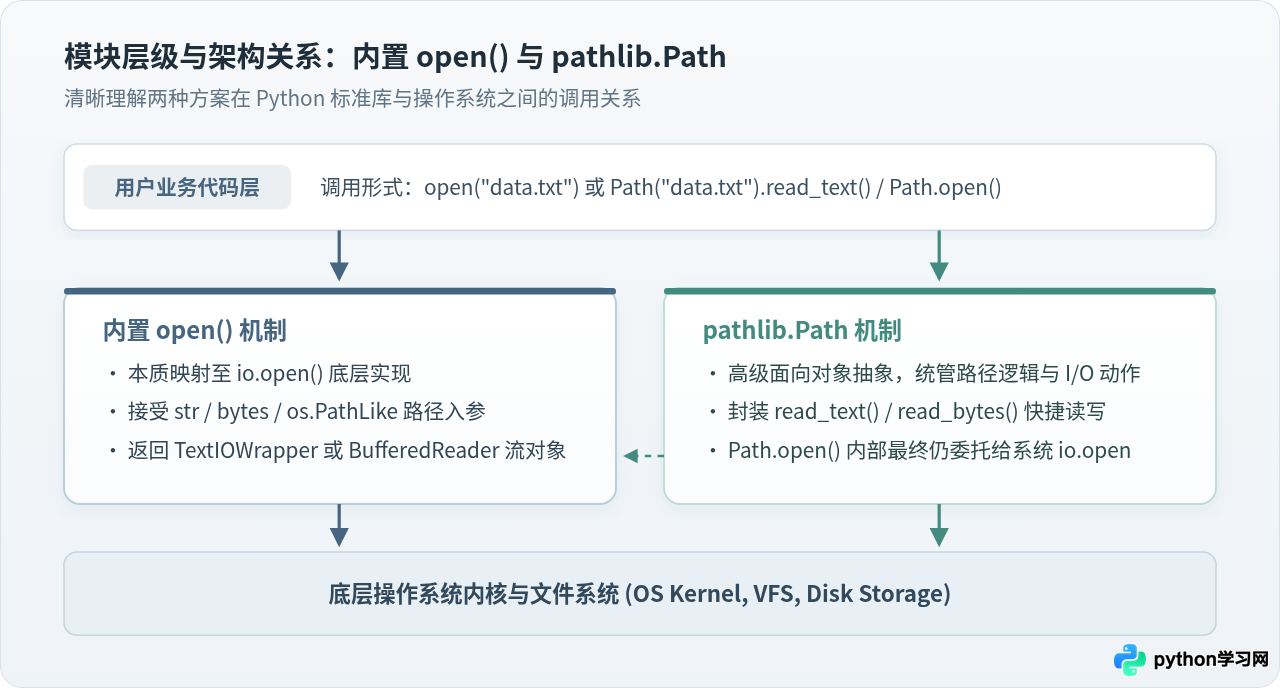
从图 1 可以清晰看到,pathlib.Path 并不是要彻底取代 Python 底层的 I/O 体系,而是提供了一个更符合现代软件工程的抽象层。当调用 Path.open() 或 Path.read_text() 时,其底层最终依旧会安全对接至 Python 的标准流处理体系。
二、内置 open() 函数:基础流处理与大文件基石
内置 open() 函数自 Python 诞生早期便是文件 I/O 的核心入口。它直接返回一个文件流对象(文本模式下为 TextIOWrapper,二进制模式下为 BufferedReader 或 BufferedWriter)。
1. 规范用法:必须配合 with 上下文管理器
在编写实际业务代码时,切忌使用裸写 f = open(...) 并在末尾手动 f.close()。如果读取过程中遇到格式错误或提前 return,未关闭的文件句柄将发生泄漏。标准写法永远是 with open(...):
# 标准读取文本文件示例
with open("server.log", mode="r", encoding="utf-8") as f:
    content = f.read()  # 一次性将全部内容读入内存字符串
2. 逐行迭代:处理几十 MB 到数 GB 大文件的黄金法则
当文件体积超出几十兆、甚至达到数 GB 时,如果直接调用 f.read() 或 f.readlines(),会将整份数据一次性加载到内存中,极易触发系统的 MemoryError。open() 返回的文件对象本身就是可迭代器,支持以极低内存逐行流式读取:
# 处理超大日志文件,无论文件多大,内存占用始终保持在几 KB 级别
with open("access.log", mode="r", encoding="utf-8") as f:
    for line in f:
        line_clean = line.strip()
        if "ERROR" in line_clean:
            print(f"发现错误日志: {line_clean}")
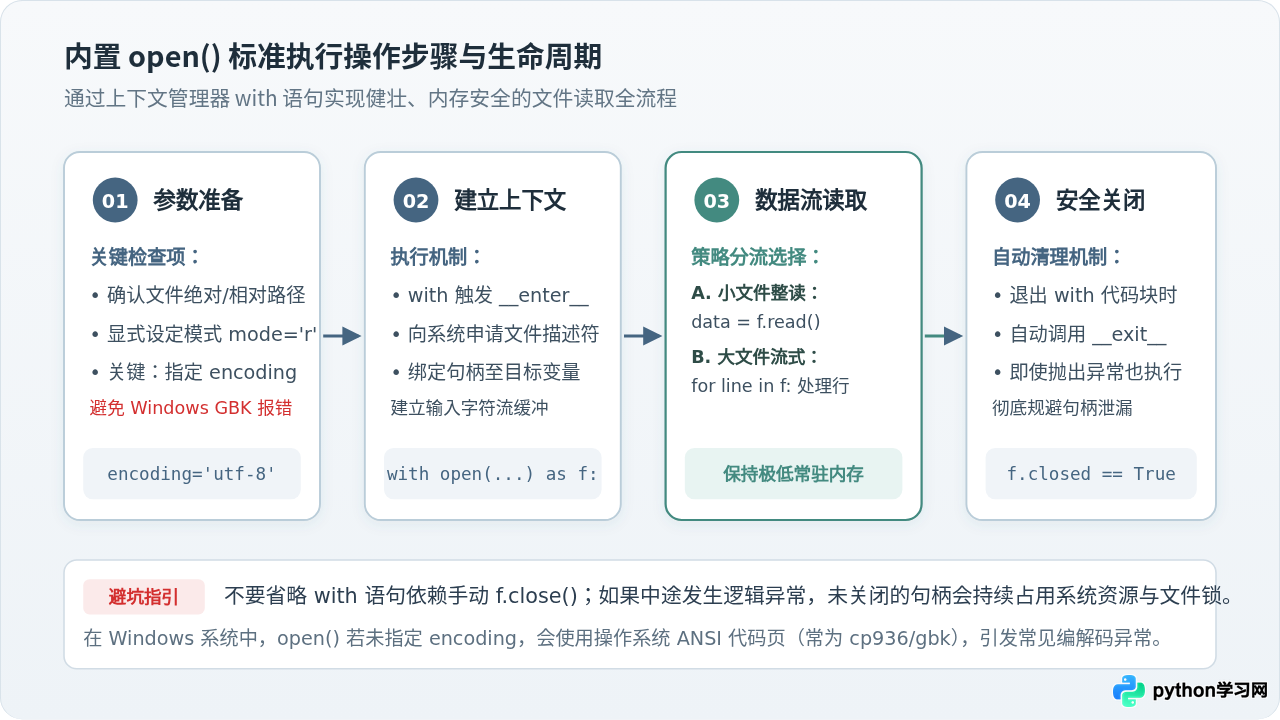
encoding 参数,系统会回退至 locale.getpreferredencoding(False)。在 Windows 操作系统中,该值通常为 cp936(GBK),如果文件实际是以 UTF-8 编码保存的,极易抛出 UnicodeDecodeError: 'gbk' codec can't decode byte... 异常。养成显式传入 encoding="utf-8" 的习惯可以避免绝大多数跨平台乱码问题。
三、pathlib 模块:面向对象的文件与路径利器
pathlib 模块是在 Python 3.4 引入并在 Python 3.6+ 全面普及的模块。它的核心设计思想是:文件路径不应只是死板的文本字符串,而应当是一个具有属性和操作方法的实体对象。
1. 一行搞定小文件全量读取:read_text 与 read_bytes
对于绝大多数日常场景(如加载 JSON 配置文件、读取 Markdown 文档或抓取模板文件),使用 Path.read_text() 能将原本繁琐的 with open 结构浓缩为单行代码,同时保持完全的资源安全:
from pathlib import Path

# 单行读取文本:自动打开、解码并自动关闭文件描述符
config_text = Path("config.json").read_text(encoding="utf-8")

# 读取二进制文件(如图片或音频头数据)
image_bytes = Path("banner.png").read_bytes()
2. 路径拼接与状态判断一体化
在过去,配合 open() 处理深层目录文件时,开发者必须频繁引入 os 模块,写出诸如 os.path.join(os.path.dirname(...), "data", "users.csv") 这类嵌套深、可读性差的代码。而在 pathlib 中,使用正斜杠 / 即可自然拼接路径:
from pathlib import Path

base_dir = Path(__file__).resolve().parent
target_file = base_dir / "data" / "2026" / "report.csv"

# 先判断文件是否存在且确实为普通文件,再读取
if target_file.is_file():
    content = target_file.read_text(encoding="utf-8")
else:
    print(f"文件未找到: {target_file}")
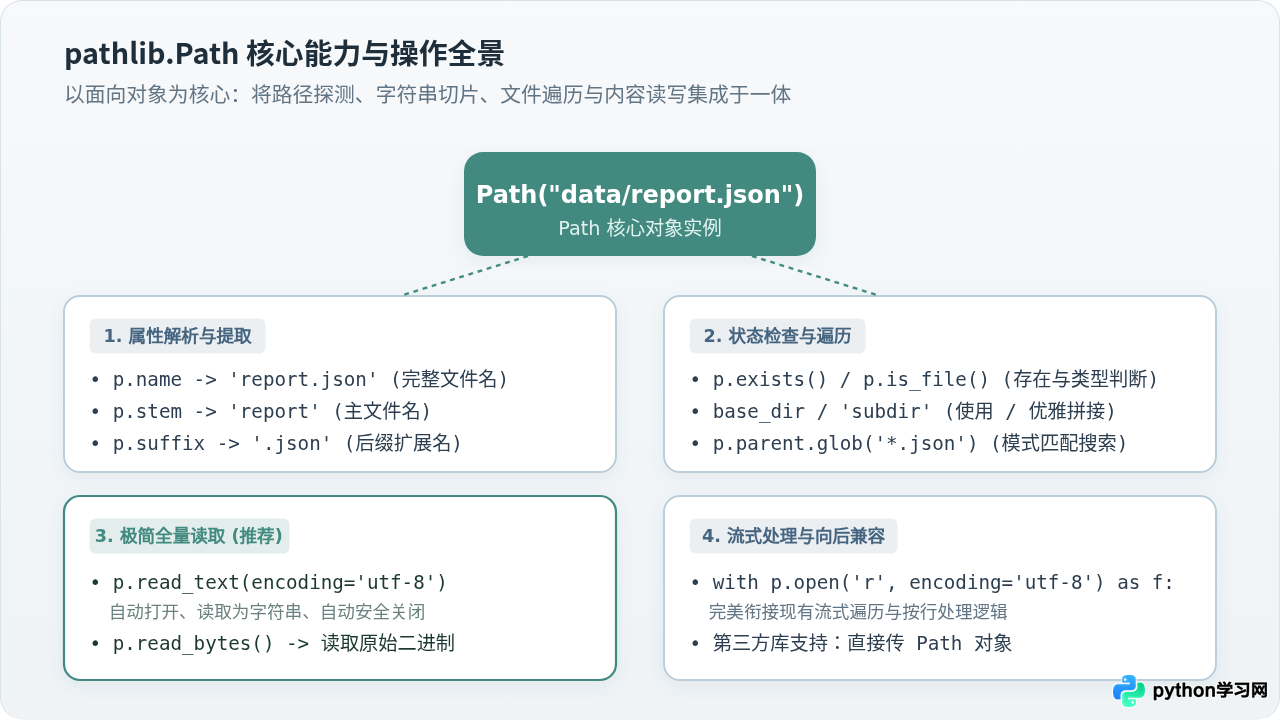
四、典型场景实操对照:从代码中看优劣
场景 1:读取位于项目嵌套目录中的配置文件
需求:在当前执行脚本所在目录的上一级 settings 文件夹下,读取 app.cfg。
传统方案(内置 open + os.path)
import os

current_dir = os.path.dirname(os.path.abspath(__file__))
config_path = os.path.join(os.path.dirname(current_dir), "settings", "app.cfg")

if os.path.exists(config_path):
    with open(config_path, "r", encoding="utf-8") as f:
        data = f.read()
现代方案(pathlib.Path)
from pathlib import Path

config_path = Path(__file__).resolve().parent.parent / "settings" / "app.cfg"

if config_path.is_file():
    data = config_path.read_text(encoding="utf-8")
对比分析:pathlib 避免了层层函数嵌套包裹,.parent.parent 和 / 拼接清晰易读,且直接调用 read_text(),代码结构清爽紧凑。
场景 2:扫描目录并批量读取特定扩展名的所有文件
需求:找到 logs/ 目录下所有以 .txt 结尾的文件并输出内容。
使用 pathlib.Path.glob() 实现
from pathlib import Path

log_dir = Path("./logs")

for txt_path in log_dir.glob("*.txt"):
    print(f"正在处理 [{txt_path.name}]:")
    text = txt_path.read_text(encoding="utf-8")
    print(text[:100])  # 打印前 100 字符示例
对比分析:传统方案需要先 os.listdir(),再用 endswith('.txt') 过滤,最后 os.path.join() 后再 open()。使用 pathlib 时,glob() 迭代出来的每一个元素本身就是 Path 实例,可直接调取 .name 和 .read_text(),流畅度大幅提升。
场景 3:需要精细控制流的大文件读取
需求:对一个几百兆的日志逐行筛选,且路径本身是通过参数传入的。
from pathlib import Path

log_file = Path("/var/log/syslog")

# 直接在 Path 对象上使用 .open(),与内置 open() 完全同等兼容
with log_file.open(mode="r", encoding="utf-8") as stream:
    for line in stream:
        if "CRITICAL" in line:
            process_alert(line)
对比分析:Path.open() 完美继承了上下文管理器与流式逐行迭代能力。这意味着选择 pathlib 并不意味着放弃 open() 的流式特性,反而兼收了路径对象化与流式读取的双重优势。
五、选型决策指南与落地建议
综合以上分析,对于“读取文件到底用哪个模块”,可以根据具体的开发诉求依照以下决策路径进行选择:
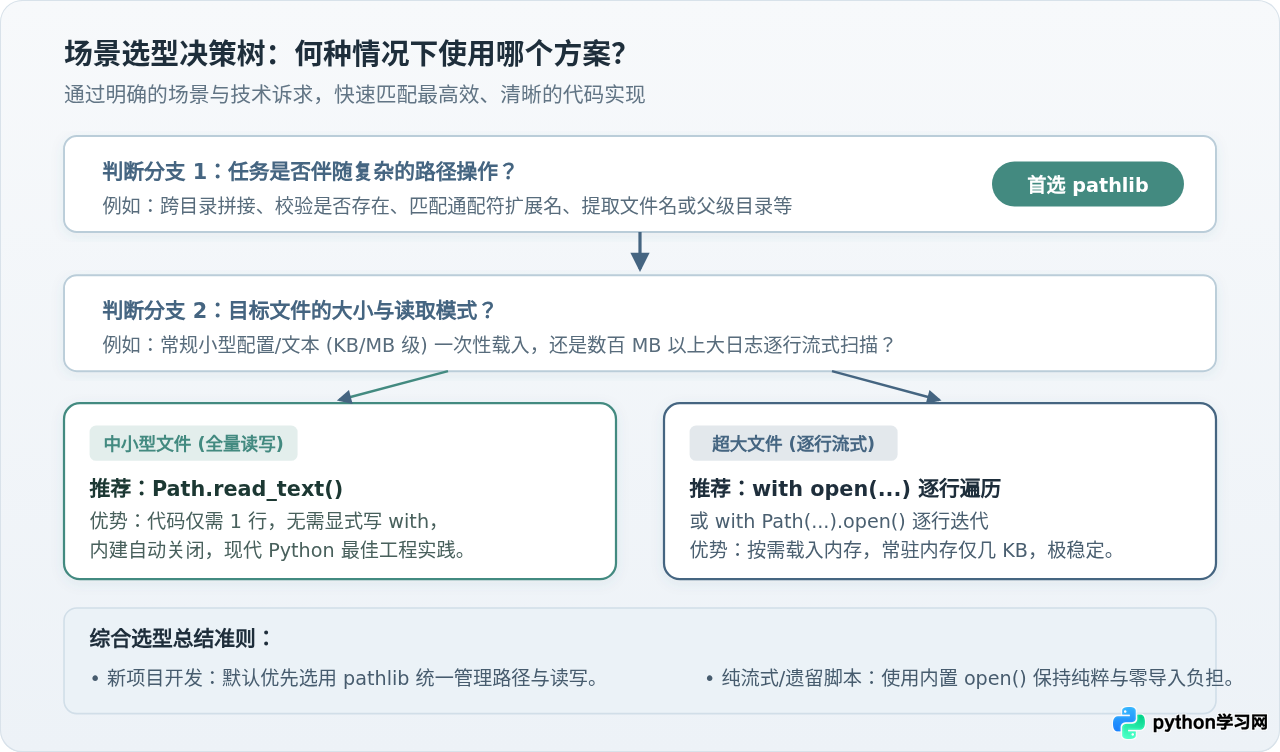
- 新项目与应用开发:统一引入
from pathlib import Path,将路径处理和文件读写合二为一。中小型配置文件使用Path.read_text(),需要流式处理时使用with Path.open()。 - 极简辅助脚本 / 练习代码:如果代码仅仅是简单读取当前目录下的固定文件,且无需拼接路径,直接用
with open("file.txt", "r", encoding="utf-8") as f:完全合理。 - 第三方库兼容性:在现代 Python(3.6+)中,标准库与流行第三方库(如
json.load(),pandas.read_csv(),openpyxl等)均已实现对os.PathLike协议的全面支持,可以直接向它们传递Path对象,无需手动转为str(path)。 - 警惕内存爆炸:无论采用哪种模块,面对大小不可预知的文件时,切忌盲目使用
.read()或.read_text(),必须改用with ... open()配合循环逐行处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









