

Python开发中何时用列表何时用集合?典型场景选型建议
深入解析Python开发中列表(list)与集合(set)的底层存储原理、寻址机制及时间空间复杂度差异,提供涵盖高频检索、批量去重、数据对账与时序处理等典型场景的工程选型建议。
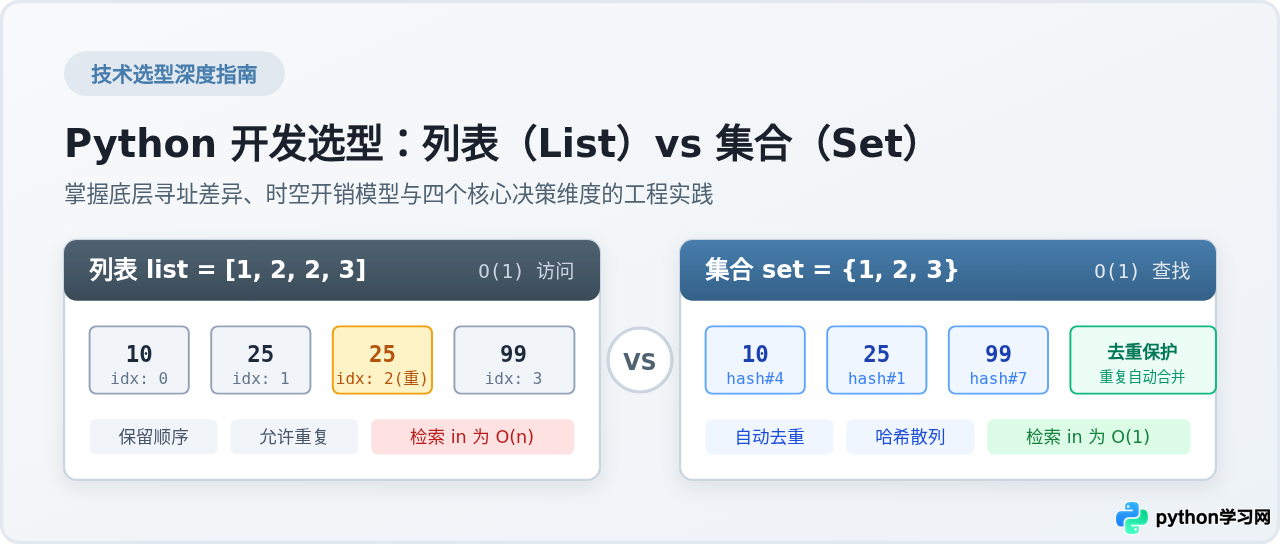
list)还是集合(set),核心决策依据取决于三个关键问题:是否需要保持元素顺序与重复项、是否需要高频进行成员判断(in 操作),以及容器中的元素本身是否可哈希。列表本质是动态指针数组,保留严格的插入顺序并允许重复,支持通过下标随机访问;集合底层基于哈希散列表实现,元素天然唯一且不保证顺序,但具备接近常数时间复杂度 O(1) 的查找与去重速度。搞清二者的底层机制差异,能在保证代码简洁性的同时避免严重的性能退化。
底层存储机制与寻址原理差异
Python 官方实现(CPython)中,列表和集合虽然都是存储对象的容器,但底层的内存布局与寻址逻辑截然不同。了解这种物理结构的差异,是理解它们性能特征的前提。
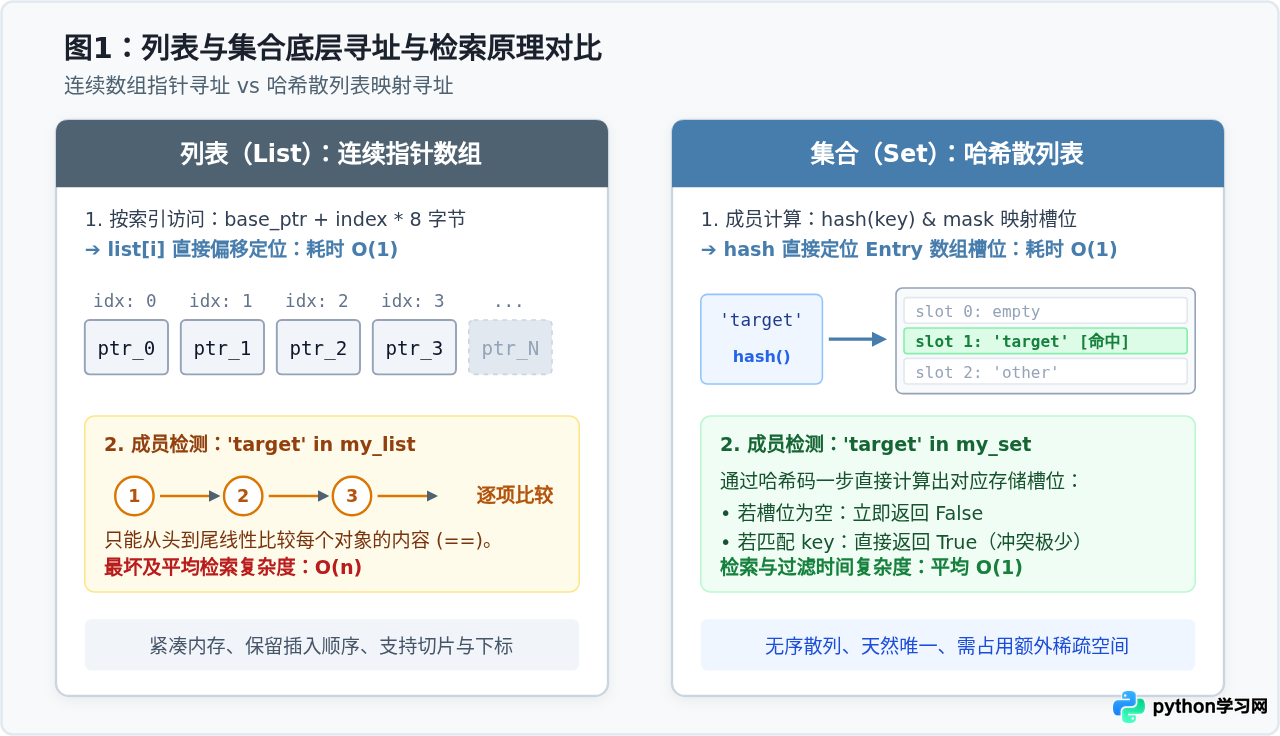
列表(list)的底层本质是一个可变长度的连续指针数组(PyListObject)。
在内存中,列表开辟一段连续的地址空间,数组中每一个槽位存放的是指向 Python 实际对象堆内存地址的指针(在 64 位系统上每个指针占用 8 字节)。因为内存连续且指针大小固定,列表通过索引访问元素时只需执行一次基地址偏移计算:base_address + index * 8,即可在 O(1) 时间内直达目标对象。然而,如果要在列表中执行 target in my_list 检索某值是否存在,Python 必须从头到尾对数组中的每个对象逐一执行相等性比较(item == target),直到找到目标或遍历结束,因此检索时间复杂度为线性的 O(n)。
集合(set)的底层则是一个高度优化的开地址哈希表(PySetObject)。
集合内部维护着一个散列条目(entry)数组。向集合添加元素或查询元素时,Python 首先调用对象的 hash() 函数计算哈希码,通过掩码运算映射到散列表的对应桶(bucket)位置。如果该桶已有元素,再通过内建的探测算法寻找空位或匹配对象。因此,集合执行 target in my_set 检索时,只需一次哈希计算和极少次数的冲突探测即可直接命中,平均时间复杂度为 O(1)。
容器选型的 4 个核心决策维度
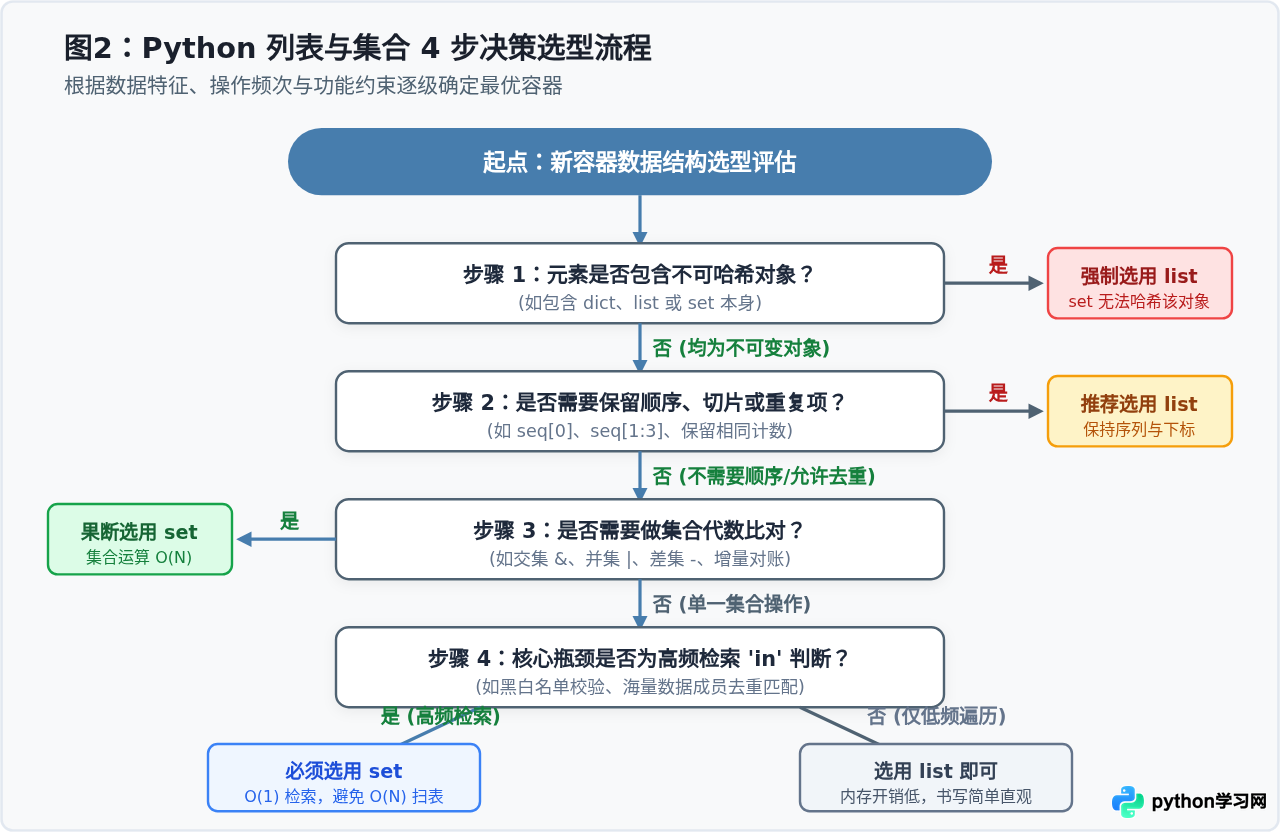
面对具体业务需求时,不需要凭直觉猜测,可按照以下 4 个递进维度建立清晰的选型标准。
1. 数据唯一性与重复计次要求
列表天然允许包含重复元素,并如实记录每一个元素出现的频次与相对位置。如果业务场景需要记录用户每一次点击历史、购物清单中重复加入的同一商品数量,或者需要使用 list.count(x) 统计频次,必须选用列表。
集合在数学定义与实现上都是无重复集合。当向集合中加入已存在的元素时,集合会自动忽略新元素。因此,如果业务数据在逻辑上不允许存在重复项(例如唯一的设备 ID、已爬取的 URL 库、角色拥有的权限标识),使用集合是最直接、不易出错的选型。
2. 元素顺序、切片与下标访问依赖
Python 3.7 开始,字典与列表均保留确定的插入顺序。列表支持丰富的序列操作:
- 通过索引精准读写:
items[0]、items[-1]; - 切片子集提取:
items[10:20]、步长切片items[::-1]; - 基于原始顺序就地排序:
items.sort()或翻转items.reverse()。
集合则是非序列容器(Non-sequence)。它不支持索引访问,执行 my_set[0] 会直接抛出 TypeError: 'set' object is not subscriptable;虽然在某些 CPython 版本中遍历集合会呈现特定顺序,但这一顺序取决于哈希分布与插入历史,无法作为稳定顺序依赖,更无法进行切片截取。
3. 成员检测(in)的操作频次与数据规模
在批量数据处理、爬虫排重、风控黑名单比对等场景下,成员检测往往是整个循环体系的核心耗时点。
当数据量较小(如 10 个以内元素)时,列表扫描与集合哈希计算的耗时差异在纳秒级,几乎可以忽略。但当数据规模增长到上万甚至上百万时,列表的 O(n) 线性扫描会导致整体算法退化为 $O(N imes M)$;而集合的 O(1) 特性可以将总复杂度稳定在 $O(N)$。如果在循环体内需要反复执行 if item in collection:,必须毫不犹豫地将目标集合设计为 set。
4. 元素的可哈希性(Hashability)约束
这是使用集合时的硬性语法红线。由于集合依赖哈希表寻址,放入集合的元素必须是可哈希对象(Hashable)。
在 Python 中,绝大多数不可变内置类型(如 int、float、str、tuple、frozenset)都是可哈希的;而所有的可变容器类型(如 list、dict、set 本身)都是不可哈希的(__hash__ 为 None)。如果数据本身包含嵌套字典或嵌套列表(例如解析 JSON 得到的结构体列表),就不能直接放入集合中。
典型业务场景实践与代码选型
场景一:海量数据过滤与黑白名单校验
业务背景:在接口网关或数据清洗流程中,需要对接收到的日志或交易流水过滤掉黑名单中的 IP 或非法字符。
如果使用列表存储黑名单,每一条流入的数据都会触发一次全列表遍历。以下示例直观展示了列表与集合在该场景下的性能悬殊:
# benchmark_lookup.py
import time

# 准备 50,000 个黑名单 ID,以及 20,000 条待检测数据
blacklist_data = [f"user_{{i}}" for i in range(50000)]
test_items = [f"user_{{i * 2}}" for i in range(20000)]

# 方案 A:使用列表作为检索容器 (不推荐)
start_time = time.perf_counter()
blocked_by_list = [item for item in test_items if item in blacklist_data]
list_duration = time.perf_counter() - start_time

# 方案 B:使用集合作为检索容器 (推荐)
blacklist_set = set(blacklist_data)
start_time = time.perf_counter()
blocked_by_set = [item for item in test_items if item in blacklist_set]
set_duration = time.perf_counter() - start_time

print(f"列表检索耗时: {{list_duration:.4f}} 秒")
print(f"集合检索耗时: {{set_duration:.4f}} 秒")
print(f"性能提升倍数: {{list_duration / set_duration:.1f}} 倍")
列表检索耗时: 6.8421 秒
集合检索耗时: 0.0019 秒
性能提升倍数: 3601.1 倍
选型结论:对于任何作为“查询字典”或“白名单/黑名单”用途的数据结构,即使原始输入是列表,也应在进入循环前通过 set(source_list) 一次性转换为集合。
场景二:数据批量去重与保序去重策略
业务背景:从外部系统采集到了包含重复记录的字符串数组,需要进行唯一化处理。
如果不需要关心原有顺序,使用 set() 转换是最简洁、速度最快的方式:
raw_tags = ["python", "fastapi", "docker", "python", "k8s", "fastapi"]

# 仅去重,不保证顺序
unique_tags = list(set(raw_tags))
# 结果可能是: ['fastapi', 'k8s', 'python', 'docker'] (顺序被打乱)
如果业务要求在去重的同时严格保留元素第一次出现的顺序(例如时间线上用户首次访问的页面),单纯使用 set() 会破坏顺序。此时最佳实践是利用 Python 3.7+ 字典键的天然唯一与保序特性:
# 既去重,又严格保留首次出现的相对顺序
ordered_unique_tags = list(dict.fromkeys(raw_tags))
print(ordered_unique_tags)
# 准确输出: ['python', 'fastapi', 'docker', 'k8s']
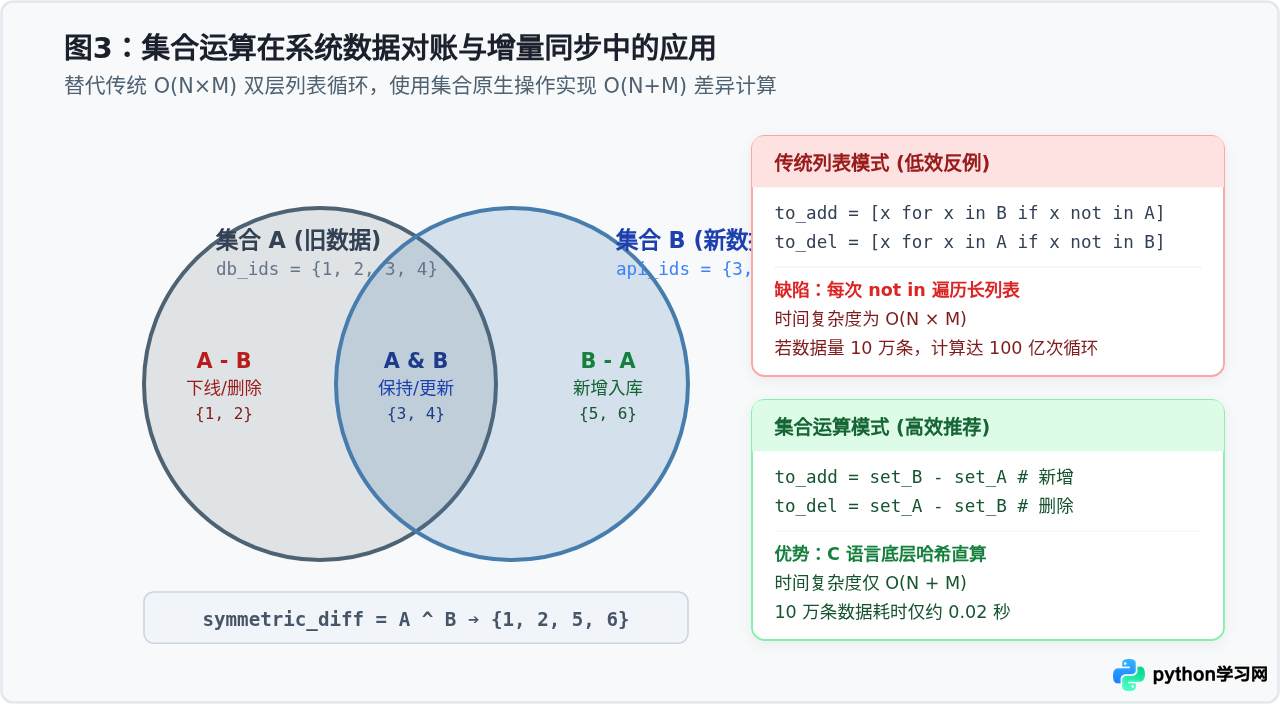
场景三:系统数据对账、权限合并与增量同步
业务背景:在数据库与第三方服务同步时,本地拥有当前全量 ID 集合 local_ids,远程接口返回最新全量 ID 列表 remote_ids。系统需要计算:哪些需要新增(INSERT)、哪些需要销毁(DELETE)、哪些保持活跃。
如果使用列表,需要编写繁琐的双层循环或多次列表推导式,代码冗长且性能较差;而集合提供了原生的高效代数运算:
# 模拟数据源
current_db_ids = {101, 102, 103, 104, 105}   # 数据库现有记录
incoming_api_ids = {103, 104, 105, 106, 107} # 接口最新推送记录

# 1. 计算需要新增入库的 ID: 存在于接口中,但数据库尚无 (差集 B - A)
to_insert = incoming_api_ids - current_db_ids
# 结果: {106, 107}

# 2. 计算需要废弃或删除的 ID: 存在于数据库中,但接口已不再返回 (差集 A - B)
to_delete = current_db_ids - incoming_api_ids
# 结果: {101, 102}

# 3. 计算保持不变、需更新状态的 ID: 两方皆有 (交集 A & B)
to_keep = current_db_ids & incoming_api_ids
# 结果: {103, 104, 105}

# 4. 计算产生变化的总 ID 集合 (对称差集 A ^ B)
changed_ids = current_db_ids ^ incoming_api_ids
# 结果: {101, 102, 106, 107}
选型中的易踩坑点与工程注意事项
很多开发者知道集合查找快,于是在循环内部写出类似 if x in set(long_list): 的代码。请务必注意:set(long_list) 本身是一个 O(n) 的构造成本。如果在外层循环执行 $M$ 次,总复杂度仍然是 $O(M imes N)$,甚至因为反复申请哈希表内存而比纯列表遍历更慢。正确的做法是:在循环外部只执行一次 target_set = set(long_list),在循环内部反复利用已建好的哈希表。
哈希表为了保证装载因子(Load Factor)在合理区间以减少哈希冲突,通常会预留 1/3 到 2/3 的空桶(稀疏存储)。因此,存放同样数量的整数或字符串,集合占用的物理内存通常是列表的 2 倍至 4 倍。在内存极度受限(如嵌入式微服务、几千万规模的常驻内存对象)且仅需要顺序流式遍历的场景下,紧凑的列表(或 array.array、tuple)是更安全的选择。
在处理接口返回的列表字典(如 users = [{"id": 1}, {"id": 2}])时,直接执行 set(users) 会直接触发 TypeError: unhashable type: 'dict'。对于这类数据,如果需要去重,应提取出其中的不可变字段进行比对(例如 {u['id'] for u in users}),或者先将字典转为已排序键值对的元组 tuple(sorted(d.items())) 再送入集合。
综合选型对照总结
为了便于在日常开发与代码审查(Code Review)中快速决策,下表完整归纳了列表与集合在各项维度的关键指标:
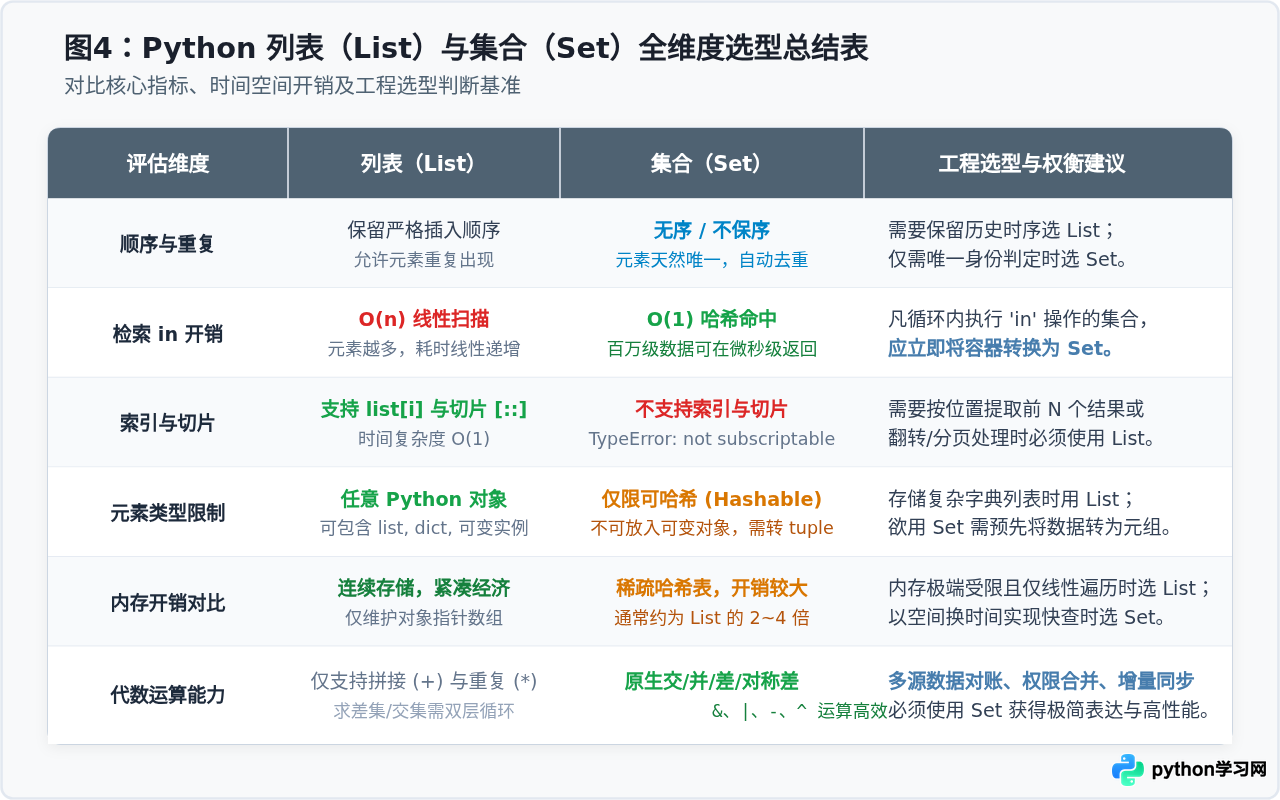
简而言之:“保序、按位、可重复、任意类型”用列表;“唯一、快查、数学关系、不可变键”用集合。在日常工程实践中,两者往往不是非此即彼的对立关系,而是相互配合——利用列表接收并承载外部时序数据,在需要校验或去重时转换为集合加速处理,最终再根据输出格式要求转回列表,方能在开发效率与执行性能之间取得最佳平衡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









