

怎么通过实战项目巩固Python知识?适合新手的5个练习方向
针对Python初学者学完语法容易遗忘、难以独立编写代码的实际问题,本文系统梳理新手选择实战练习的核心原则,推荐5个极具针对性的练习方向(办公自动化、交互式CLI、轻量网页采集、数据清洗可视化与微型Web API),提供完整代码示例与落地方案,帮助读者扎实巩固Python知识。
一、为什么常规语法练习容易遗忘?“项目驱动”的内化机制
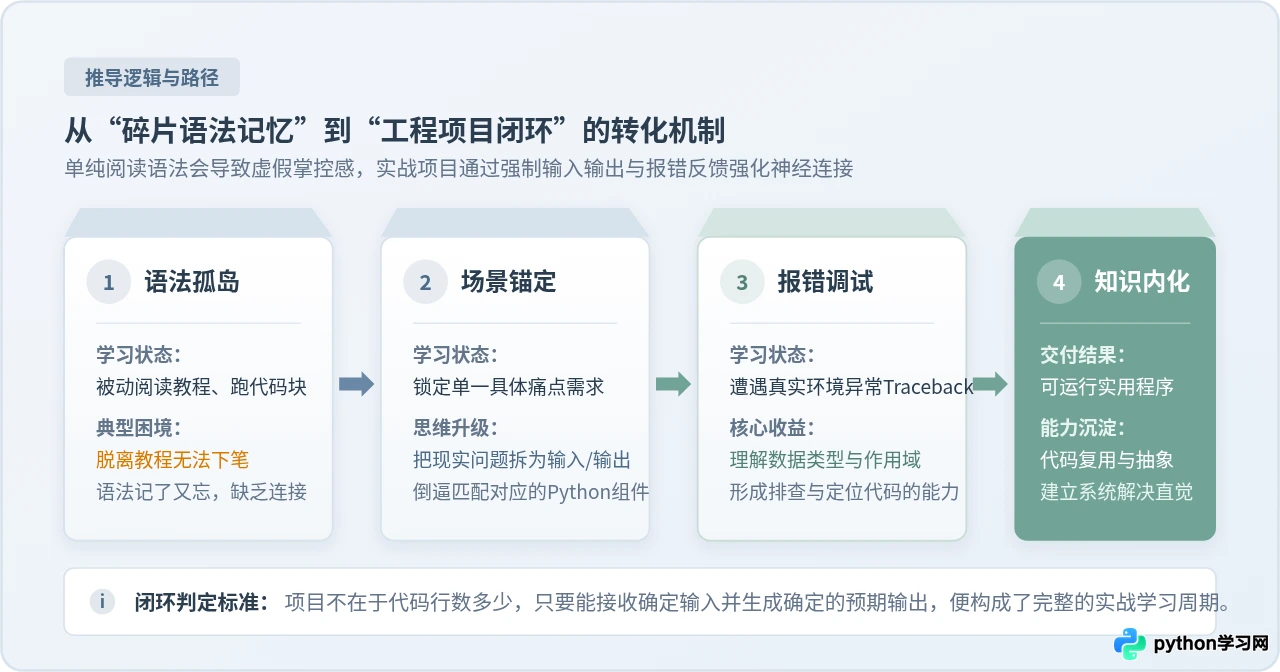
在被动学习阶段,学习者通常在 IDE 或 Jupyter Notebook 中逐行执行教科书上的碎片代码块。例如定义一个字典并遍历键值对,或者编写一个打印九九乘法表的嵌套循环。这类练习虽然能加深对关键字的印象,但它们缺乏现实上下文:数据是硬编码的、运行结果是显而易见的、程序即使出错也不会造成任何实际影响。
而实战项目之所以能够高效巩固知识,是因为它引入了“不确定性”和“闭环反馈”:
- 输入不确定:现实中的数据往往来自文件、用户输入或网络接口,格式可能不规范甚至存在缺失,这会强制初学者理解数据清洗与类型转换(如
int()、strip())。 - 控制流实战化:在项目中,
if-else和while不再是为了做题而写,而是用于控制菜单跳转、重试网络请求或判定业务状态。 - 报错即时教育:面对终端打印的
FileNotFoundError或KeyError回溯信息(Traceback),初学者必须学会读懂报错行号并修复逻辑漏洞,这种排错经历远比单纯看书深刻。
二、新手挑选实战练习的3个核心原则
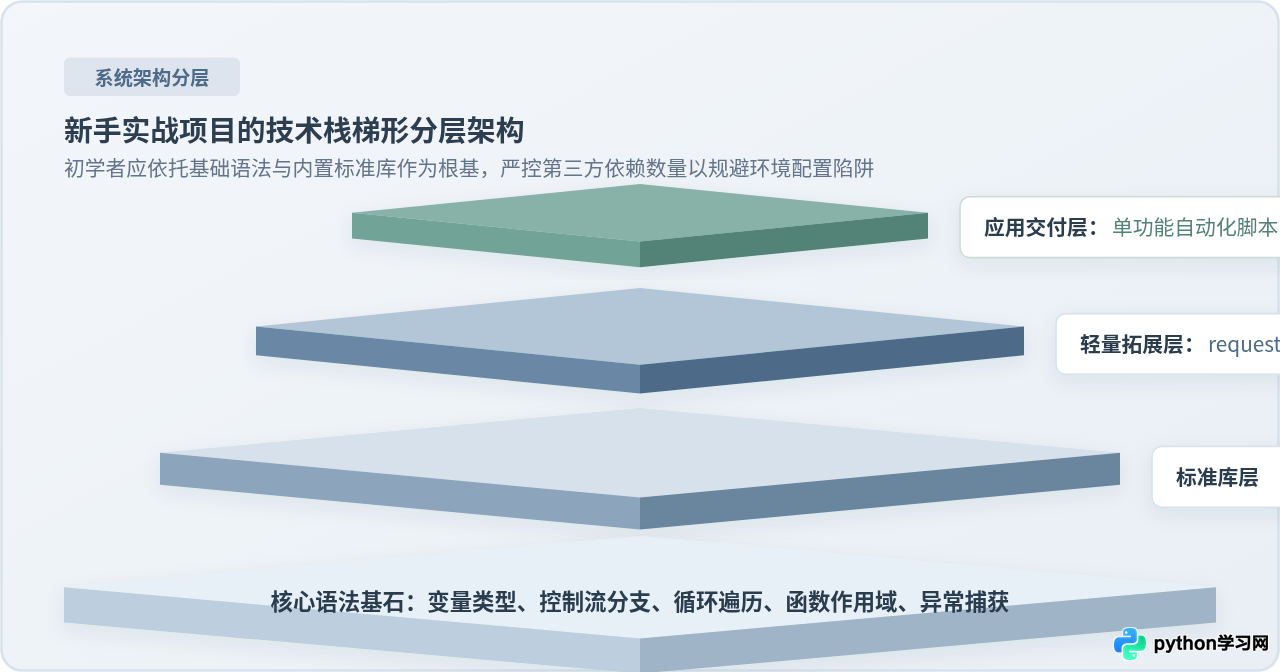
初学者在寻找项目时,最常见的失误是好高骛远——例如刚学完函数就尝试开发全功能商城系统或大型3D游戏。这类项目依赖庞大的框架、数据库关系设计和复杂的前后端协议,初学者极易在环境搭建和繁琐配置中耗尽耐心。适合巩固基础的项目必须满足以下 3 个原则:
- 输入输出边界明确,运行结果肉眼可见: 项目应当有清晰的物理产出。例如“把下载文件夹里所有的截图重命名并移动到分类目录”,脚本运行完毕后打开文件夹就能直接验证成败。即时可视的成果能提供源源不断的学习正反馈。
-
以基础语法与标准库为核心,严格控制第三方依赖:
巩固基础的重点是磨砺语言核心能力。优先使用 Python 自带的标准库(如
pathlib、json、csv、datetime、math),若确实需要第三方库,也应局限于单目的轻量库(如requests),避免过早陷入重量级框架的学习成本。 - 能在单文件或微型模块中跑通: 初学者项目代码量通常在 50 至 150 行之间最为理想。在一个单文件内,初学者能一眼看清从参数接收、数据处理到最终导出的完整全貌,心智负担降至最低。
三、适合新手的5个实战练习方向(附完整落地示例)
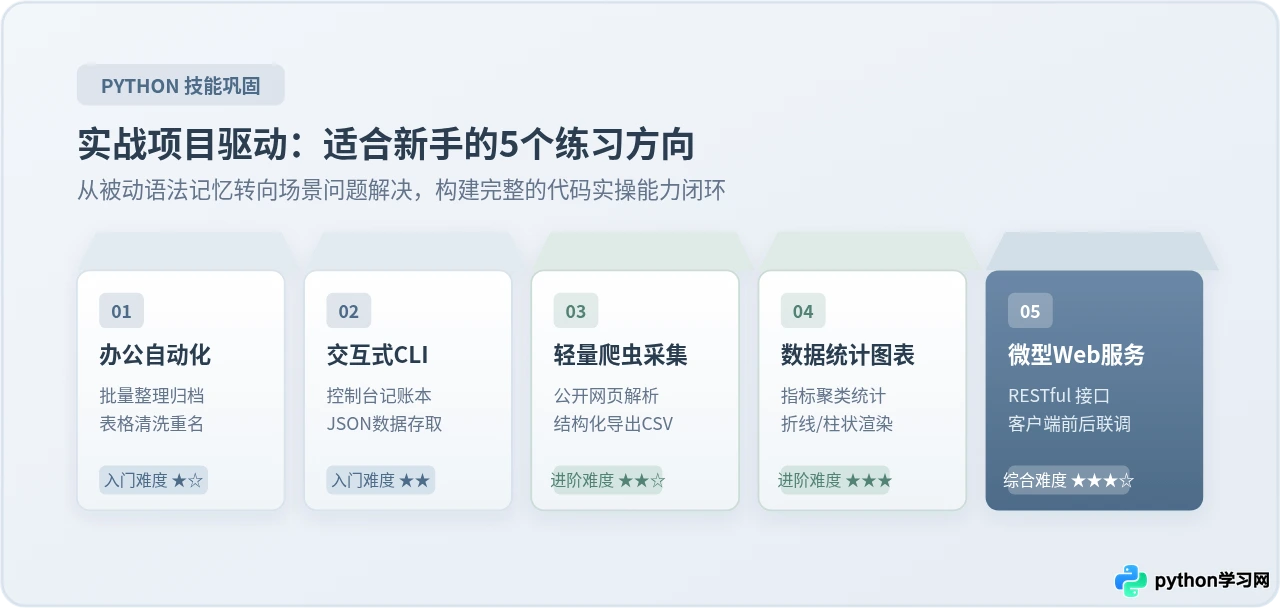
结合初学者的知识储备与实际应用价值,以下推荐 5 个由易到难、各有侧重的实战练习方向。建议按照推荐顺序逐步攻坚,每完成一个方向,都尝试在基础功能之上增加一两个个性化需求。
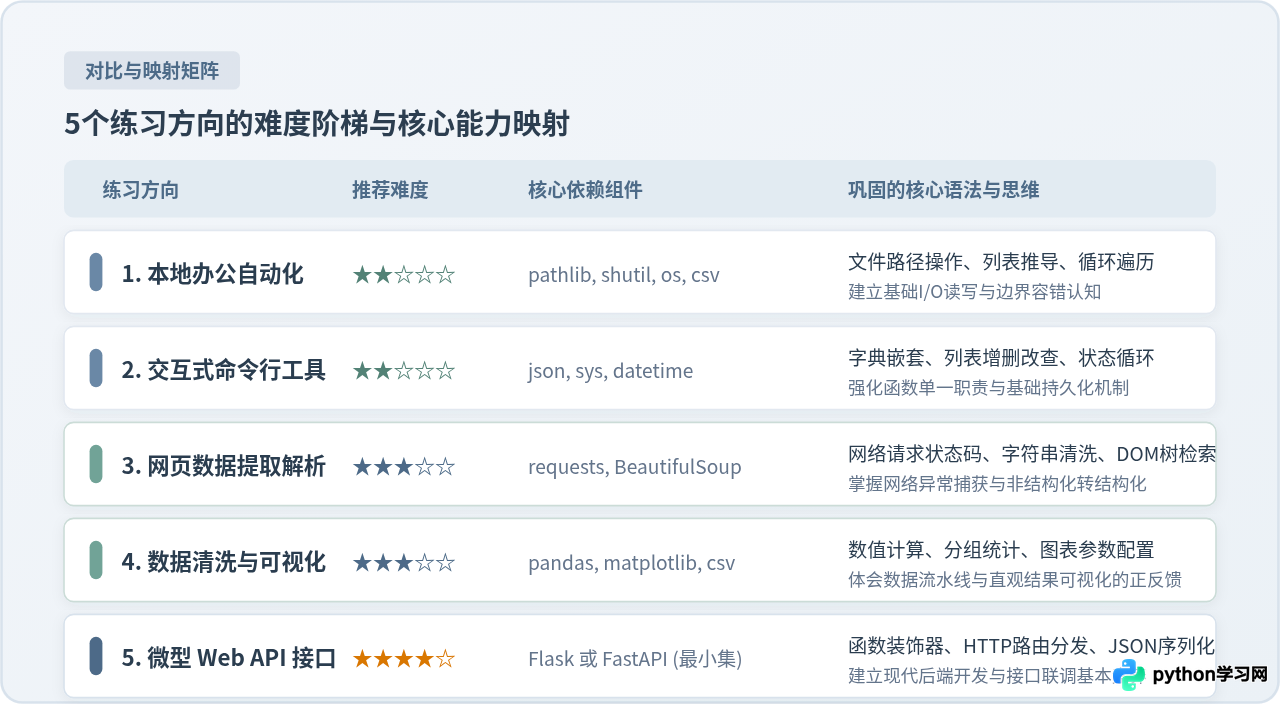
方向一:本地文件与日常办公自动化(文件批处理)
巩固知识点:路径对象操作(pathlib.Path)、循环遍历、字符串前缀后缀判断(endswith()、startswith())、异常处理(try...except)。
练习场景:个人电脑的“下载”文件夹通常杂乱无章,存放着各种临时文档、安装包与图片。编写一个自动化归档脚本,根据文件扩展名自动创建分类文件夹并将文件归类存放。
import os
import shutil
from pathlib import Path

def organize_folder(target_dir: str):
    target_path = Path(target_dir).resolve()

    if not target_path.exists() or not target_path.is_dir():
        print(f"错误:指定路径不存在或不是有效文件夹:{target_path}")
        return

    # 定义分类映射表:扩展名 -> 分类子文件夹名
    rules = {
        "图片": [".jpg", ".jpeg", ".png", ".gif", ".webp"],
        "文档": [".pdf", ".docx", ".txt", ".xlsx", ".md"],
        "压缩包": [".zip", ".tar", ".gz", ".rar", ".7z"],
        "代码脚本": [".py", ".sh", ".json", ".sql"]
    }

    moved_count = 0

    for item in target_path.iterdir():
        # 跳过子目录自身,只处理顶层文件
        if item.is_dir():
            continue

        ext = item.suffix.lower()
        matched_category = "其他杂项"
        for category, extensions in rules.items():
            if ext in extensions:
                matched_category = category
                break

        dest_dir = target_path / matched_category
        dest_dir.mkdir(exist_ok=True)
        dest_file = dest_dir / item.name

        # 处理同名文件冲突,防止静默覆盖
        if dest_file.exists():
            dest_file = dest_dir / f"{item.stem}_dup{item.suffix}"

        try:
            shutil.move(str(item), str(dest_file))
            print(f"移动成功:{item.name} -> {matched_category}/")
            moved_count += 1
        except Exception as e:
            print(f"处理文件 {item.name} 时出错:{e}")

    print(f"\n整理完成!共处理并归类 {moved_count} 个文件。")

if __name__ == "__main__":
    # 执行测试前可指定专门的测试文件夹
    test_directory = "./workspace_demo"
    os.makedirs(test_directory, exist_ok=True)
organize_folder(test_directory)方向二:交互式命令行实用小工具(CLI待办记账本)
巩固知识点:while 主循环控制、input() 命令行交互、字典与列表嵌套数据结构、json 格式本地读写持久化。
练习场景:构建一个轻量级控制台日常记账本,支持用户记录单笔收支明细、按类别查看流水、计算当前总结余,退出时自动将账单保存到本地 ledger.json 文件中。
import json
from datetime import datetime
from pathlib import Path

DATA_FILE = Path("ledger_data.json")

def load_records():
    if not DATA_FILE.exists():
        return []
    try:
        with open(DATA_FILE, "r", encoding="utf-8") as f:
            return json.load(f)
    except (json.JSONDecodeError, OSError):
        print("警告:数据文件损坏,已初始化为空列表。")
        return []

def save_records(records):
    with open(DATA_FILE, "w", encoding="utf-8") as f:
        json.dump(records, f, ensure_ascii=False, indent=2)

def add_entry(records):
    item_name = input("请输入消费/收入事项说明: ").strip()
    if not item_name:
        print("错误:事项说明不能为空!")
        return

    amount_input = input("请输入金额(正数表示收入,负数表示支出,例如 -25.5): ").strip()
    try:
        amount = float(amount_input)
    except ValueError:
        print("错误:金额格式不正确,必须为数字!")
        return

    category = input("请输入分类标签(餐饮/交通/娱乐/薪资等): ").strip() or "默认"

    record = {
        "timestamp": datetime.now().strftime("%Y-%m-%d %H:%M"),
        "item": item_name,
        "amount": amount,
        "category": category
    }
    records.append(record)
    save_records(records)
    print(f"成功记录:{item_name},金额:{amount:+.2f} 元")

def list_entries(records):
    if not records:
        print("\n暂无记账数据。")
        return

    print("\n" + "="*50)
    print(f"{'时间':<18} {'事项':<12} {'分类':<8} {'金额(元)':>10}")
    print("-" * 50)
    total_balance = 0.0
    for r in records:
        print(f"{r['timestamp']:<18} {r['item']:<12} {r['category']:<8} {r['amount']:>10.2f}")
        total_balance += r["amount"]
    print("=" * 50)
    print(f"当前净收支总结余: {total_balance:+.2f} 元\n")

def main():
    records = load_records()
    while True:
        print("\n=== 个人微型命令行记账系统 ===")
        print("1. 记录一笔收支")
        print("2. 查看账单流水与结余")
        print("3. 退出系统")
        choice = input("请选择操作编号 (1-3): ").strip()

        if choice == "1":
            add_entry(records)
        elif choice == "2":
            list_entries(records)
        elif choice == "3":
            print("感谢使用,账本已安全保存。")
            break
        else:
            print("输入无效,请输入 1、2 或 3。")

if __name__ == "__main__":
main()float() 转换前必须通过 try...except ValueError 拦截非数值输入,防止程序直接抛出异常闪退。
方向三:轻量网络数据抓取与解析(结构化公开网页信息提取)
巩固知识点:HTTP网络请求基本概念、状态码判断(status_code == 200)、HTML DOM 树检索语法(BeautifulSoup)、CSV 结构化数据存储。
练习场景:从技术资讯或学术公开网站上抓取最新的技术文章标题、发布日期与阅读链接,将其整理成标准 CSV 报表文件。
import csv
import sys
from pathlib import Path
try:
    import requests
    from bs4 import BeautifulSoup
except ImportError:
    print("缺少第三方库,请先通过命令安装:pip install requests beautifulsoup4")
    sys.exit(1)

def scrape_quotes_to_csv(output_csv: str = "quotes_data.csv"):
    # 此处使用专为爬虫教学设计的公开沙盒站点
    target_url = "http://quotes.toscrape.com/"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        response.raise_for_status()
    except requests.exceptions.RequestException as e:
        print(f"网络请求失败:{e}")
        return

    # 解析HTML内容
    soup = BeautifulSoup(response.text, "html.parser")
    quote_blocks = soup.find_all("div", class_="quote")

    extracted_data = []
    for block in quote_blocks:
        text_elem = block.find("span", class_="text")
        author_elem = block.find("small", class_="author")
        tags_elems = block.find_all("a", class_="tag")

        quote_text = text_elem.get_text(strip=True) if text_elem else ""
        author = author_elem.get_text(strip=True) if author_elem else "未知"
        tags = [t.get_text(strip=True) for t in tags_elems]

        extracted_data.append({
            "格言内容": quote_text,
            "作者": author,
            "标签": "/".join(tags)
        })

    # 写入CSV文件
    out_path = Path(output_csv)
    with open(out_path, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=["格言内容", "作者", "标签"])
        writer.writeheader()
        writer.writerows(extracted_data)

    print(f"数据采集成功!共抓取 {len(extracted_data)} 条数据,已保存至 {out_path.resolve()}")

if __name__ == "__main__":
scrape_quotes_to_csv()robots.txt 协议;设置合理的请求间隔(例如使用 time.sleep()),禁止对生产系统进行高并发或破坏性抓取。
方向四:业务数据清洗与统计图表生成(数据统计与可视化)
巩固知识点:数值计算与统计聚合、字典分组聚合逻辑、图表渲染与参数配置(折线图、柱状图)、文件输出保存。
练习场景:读取一份杂乱的团队周考勤或产品销量 CSV 记录,清洗掉空值与非法数值,统计各个品类的总销售额与平均客单价,并自动生成一张高清对比柱状图保存到本地。
import csv
from pathlib import Path
try:
    import matplotlib.pyplot as plt
    # 配置中文字体,防止生成图表时中文乱码
    plt.rcParams["font.sans-serif"] = ["PingFang SC", "Microsoft YaHei", "SimHei", "sans-serif"]
    plt.rcParams["axes.unicode_minus"] = False
except ImportError:
    print("提示:需要安装绘图库:pip install matplotlib")
    plt = None

def generate_mock_csv(file_path: Path):
    # 生成演练用的CSV销售明细文件
    mock_data = [
        ["品类", "商品名", "销量", "单价"],
        ["电子产品", "无线鼠标", "120", "49.9"],
        ["电子产品", "机械键盘", "45", "199.0"],
        ["办公用品", "记事本", "300", "12.5"],
        ["办公用品", "中性笔", "800", "2.0"],
        ["日用百货", "保温杯", "85", "68.0"],
        ["日用百货", "纸巾整箱", "150", "29.9"]
    ]
    with open(file_path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerows(mock_data)

def analyze_and_plot(csv_file: str, output_image: str = "sales_chart.png"):
    file_path = Path(csv_file)
    if not file_path.exists():
        generate_mock_csv(file_path)

    category_sales = {}

    with open(file_path, "r", encoding="utf-8") as f:
        reader = csv.DictReader(f)
        for row in reader:
            category = row["品类"].strip()
            try:
                qty = int(row["销量"])
                price = float(row["单价"])
                total = qty * price
            except ValueError:
                continue  # 忽略格式损坏的脏数据

            category_sales[category] = category_sales.get(category, 0.0) + total

    print("\n=== 各品类销售额汇总 ===")
    for cat, total in category_sales.items():
        print(f"品类: {cat:<8} 总销售额: {total:>10.2f} 元")

    if plt and category_sales:
        categories = list(category_sales.keys())
        totals = list(category_sales.values())

        fig, ax = plt.subplots(figsize=(7, 4.5), dpi=100)
        bars = ax.bar(categories, totals, color="#6B88A6", edgecolor="#4D6B88", width=0.5)

        # 在柱状图上方标注具体数值
        for bar in bars:
            height = bar.get_height()
            ax.annotate(f"¥{height:.1f}",
                        xy=(bar.get_x() + bar.get_width() / 2, height),
                        xytext=(0, 4),
                        textcoords="offset points",
                        ha="center", va="bottom", fontsize=10)

        ax.set_title("各品类销售额统计柱状图", fontsize=14, fontweight="bold", pad=12)
        ax.set_ylabel("销售额 (元)", fontsize=11)
        ax.grid(axis="y", linestyle="--", alpha=0.5)

        plt.tight_layout()
        plt.savefig(output_image)
        plt.close()
        print(f"统计图表已成功导出为图片:{Path(output_image).resolve()}")

if __name__ == "__main__":
analyze_and_plot("demo_sales.csv")matplotlib 时最容易遇到中文方块乱码问题。务必在脚本头部配置 plt.rcParams['font.sans-serif'] 指定系统常见中文字体,并开启 unicode_minus=False 确保负号正常显示。
方向五:微型轻量 Web API 接口开发(轻量服务构建)
巩固知识点:函数装饰器(@app.route)、HTTP 请求方法(GET/POST)、请求参数解析与 JSON 序列化传输、服务端状态码。
练习场景:搭建一个仅有几十行代码的微型 HTTP 服务。提供一个文本字数与词频分析接口,客户端通过 POST 提交一段文本,服务器返回该文本的字数、词数统计以及高频关键词列表。
import re
from collections import Counter
try:
    from flask import Flask, request, jsonify
except ImportError:
    print("缺少Flask依赖,请执行安装命令:pip install flask")
    import sys; sys.exit(1)

app = Flask(__name__)

@app.route("/api/ping", methods=["GET"])
def health_check():
    # 基础健康检查接口
    return jsonify({"status": "ok", "message": "服务正在正常运行"})

@app.route("/api/analyze", methods=["POST"])
def analyze_text():
    # 核心文本分析计算接口
    data = request.get_json(silent=True)
    if not data or "content" not in data:
        return jsonify({"error": "参数错误,请提供包含 content 字段的 JSON 请求体"}), 400

    text = data["content"].strip()
    if not text:
        return jsonify({"error": "content 不能为空字符串"}), 400

    # 简单统计:字符总数(不含换行与空格)
    char_count = len(re.sub(r"\s+", "", text))

    # 提取所有单词/词项并统计词频
    words = re.findall(r"\b\w+\b", text.lower())
    total_words = len(words)
    top_words = Counter(words).most_common(5)

    response_payload = {
        "char_count": char_count,
        "word_count": total_words,
        "top_keywords": [{ "word": w, "count": c } for w, c in top_words]
    }

    return jsonify({"success": True, "result": response_payload}), 200

if __name__ == "__main__":
    print("本地微型 Web API 正在启动,监听地址:http://127.0.0.1:5000 ...")
app.run(host="127.0.0.1", port=5000, debug=False)# 在新终端窗口中通过 curl 命令测试接口:
curl -X POST http://127.0.0.1:5000/api/analyze \
-H "Content-Type: application/json" \
-d '{"content": "Python is powerful and Python is easy to learn."}'curl 或用 Postman 发送请求;初学阶段保持单机 127.0.0.1 监听即可,无需配置复杂的反向代理或域名。
四、零基础落地实战项目的“四步推进法”
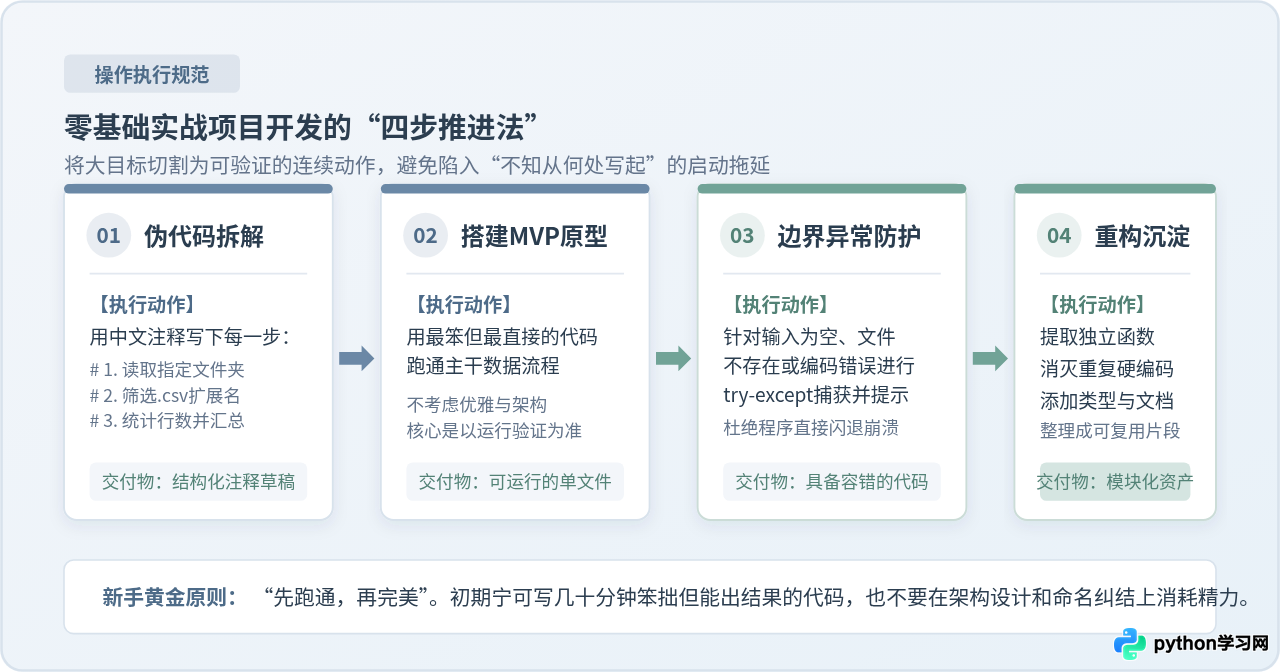
在确定好练习方向后,很多初学者的阻碍不是写不出代码,而是一面对空白的编辑器就陷入“从哪一行开始写”的焦虑。采用工程化的“四步推进法”,可以平稳降低认知负担:
-
第一步:中文伪代码拆解(确定骨架)
不要一上来就敲代码。在.py文件中先用单行注释写出程序执行的 3~5 个顺序动作。例如:“# 1. 检查文件是否存在”、“# 2. 读取第一行表头”、“# 3. 统计并计算平均值”。把复杂问题分解为每一个独立明确的微小指令。 -
第二步:编写最小可行版本(MVP)
用最直白、甚至看似笨拙的方式先让程序跑起来。遇到需要计算的地方直接写死数据或者只处理一条记录;遇到不熟悉的库先写两行测试脚本看输出结果。此时不要考虑代码是否优雅、命名是否高级,唯一的验收指标是“控制台能打印出预期的结果”。 -
第三步:注入边界条件与异常防御
当核心流程能走通后,主动制造“意外”进行加固。思考:如果传入空文件会怎样?如果输入字母而非数字会怎样?如果网络超时断开会怎样?通过添加if not data:判定或try...except块,让程序在遇到异常时给出友好的提示信息,而不是直接闪退崩溃。 -
第四步:函数封装与重构沉淀
当功能与容错都稳定后,将长串的扁平脚本按照职责切分成 2~3 个独立函数(如read_data()、process_logic()、save_output()),清理掉调试期间随手打印的无用print(),补齐类型注解与说明注释。
五、完成练习后的复盘与知识内化策略
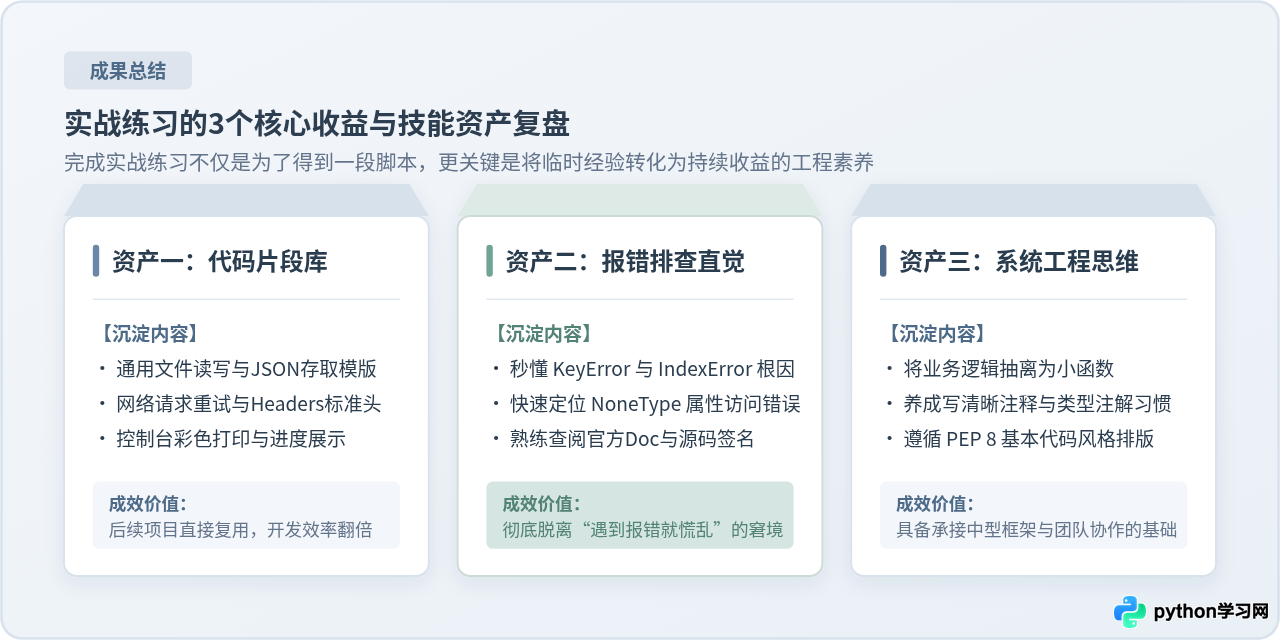
仅仅将代码敲完并运行成功,只完成了学习过程的一半。要把一次性的练习成果真正转化为长期的编程本能,还需要通过复盘沉淀三项核心资产:
-
建立个人代码片段库(Snippets):
在练习中写得顺手或解决过复杂问题的代码片段(如安全保存 JSON、带重试的 requests 请求模版、Matplotlib 中文配置),应当保存在专门的utils.py或知识笔记中。当下一次写新项目时,直接引入使用,代码复用是程序员提升开发效率的核心手段。 -
复盘报错排查日志(Debug Note):
记录下开发过程中卡壳最久的那几个报错信息(Traceback)。搞清楚引发报错的本质原因:是字典找不到 key(KeyError)、切片索引超界(IndexError),还是对None调用了方法(AttributeError)。下次遇到类似红字报错时,便能建立秒级定位问题的直觉。 -
向外扩展二次开发需求:
每一个完成的小项目都是优秀的基石。例如把命令行记账本的存储从本地 JSON 迁移到简易 SQLite 数据库;或者把文件整理脚本做成定时任务。在原有跑通的项目上做增量迭代,比重新开辟新坑更容易保持持续学习的动力。
六、常见问题解答(FAQ)
Q1:练习过程中遇到报错卡住很久,该如何高效排查?
首先看报错信息的最底部一行,它明确交代了错误类型与核心原因;其次看倒数第二行,它指示了错误发生的文件与精确行号。若无法立即理解,可以将最后一行错误信息复制,连同该行对应的核心代码一并查阅官方文档或进行搜索。在排查阶段,善用 print(type(obj), obj) 打印关键变量的实际数据类型与内容,能快速定位90%以上的传参或取值偏差。
Q2:这5个练习做完后,下一步该学什么?
完成上述 5 个方向后,你已经具备了完整的 Python 基础语法实战能力与模块组织意识。接下来可以根据个人职业发展或兴趣选择深入分支:如果倾向数据科学,深入学习 NumPy、Pandas 高级切片与数据探索;如果倾向 Web 软件开发,可以系统学习 FastAPI 或 Django 并搭配 SQLAlchemy 关系型数据库;如果偏向自动化与测试,可以学习 Selenium 或 Playwright 浏览器自动化工具。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









