

电脑端批量照片转Word:ABBYY与WPS OCR识别效果对比
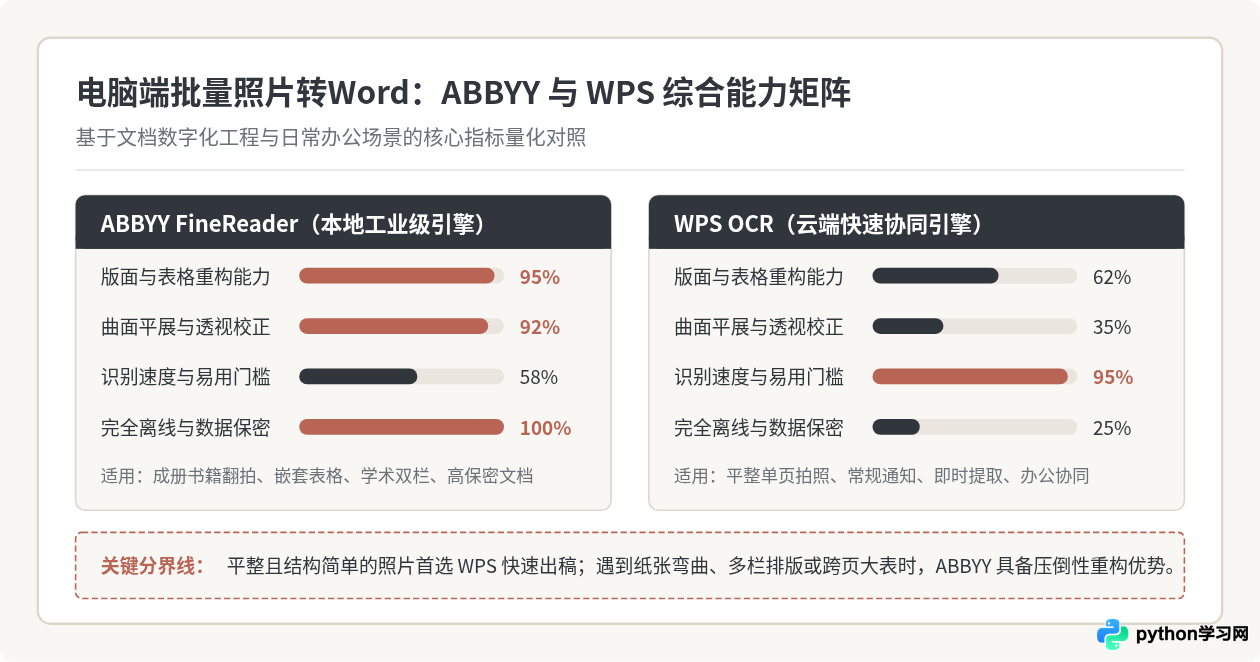
深入对比电脑端批量照片转Word场景下ABBYY FineReader与WPS Office的OCR识别效果,从字符准确率、复杂版面重构、表格还原、图像几何畸变校正到离线安全与批处理工作流进行全面实证剖析。
一、批量转换工作流与操作路径差异
在电脑端处理几十甚至上百张照片时,操作流程的顺畅度直接决定了工作效率。两款软件在任务组织逻辑与交互设计上呈现出不同的产品哲学:WPS 强调即开即用的“流水线输出”,而 ABBYY 则提供了细致的“工程化校验空间”。
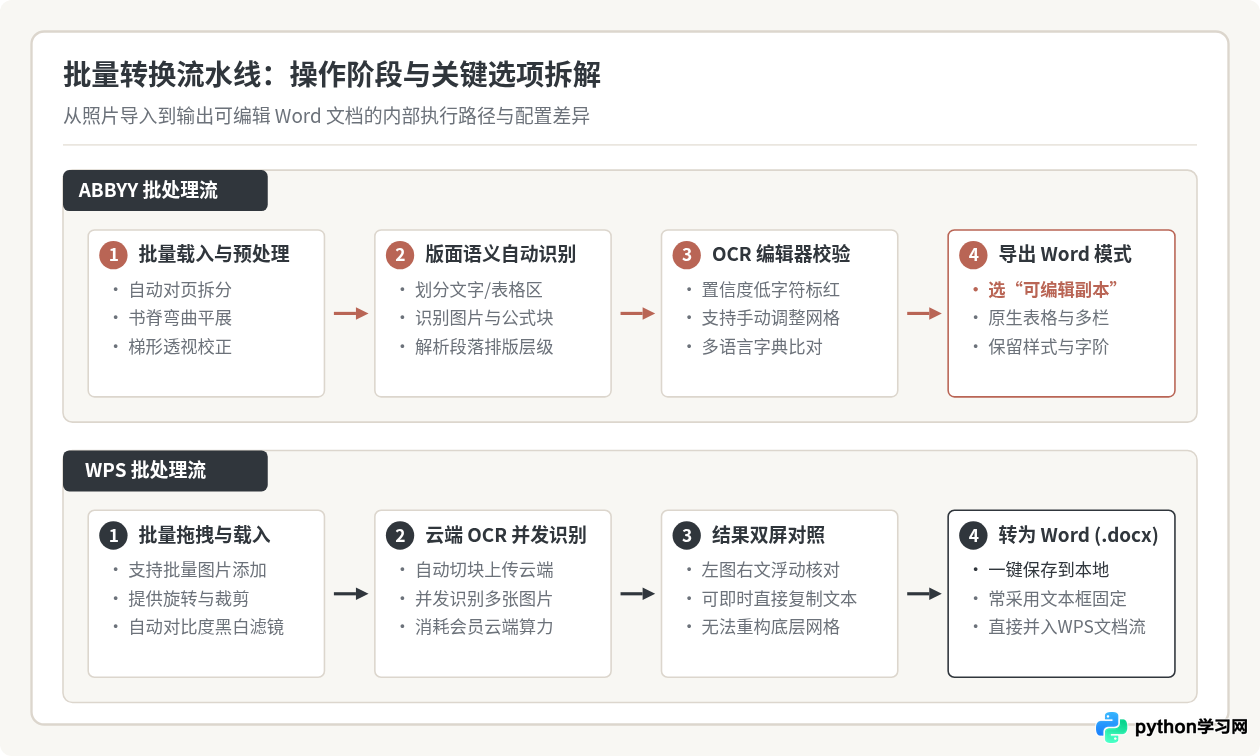
1. ABBYY FineReader 的工程化批处理逻辑
在 ABBYY FineReader 中,批量转换的标准入口位于“在 OCR 编辑器中打开”。载入一组照片后,系统并不会直接输出静态文档,而是自动创建一个数字化任务项目:
- 图像预处理阶段:引擎在后台执行预检,自动识别页面朝向,对于对页翻拍的书籍执行双页居中拆分,并对镜头畸变进行梯形纠偏。
- 区域语义自动划分:系统利用绿、红、蓝三种色框分别圈定文本块、图片块和表格块。如果原图中存在条形码或公式,还可手动指定专门的识别属性。
- 低置信度字符标红核对:在三联联动窗口中,左侧为页面列表,中间为主图像,底部直接高亮显示识别置信度偏低的文字或生僻字符,便于人工批量跳步确认。
- 输出格式配置:在保存为 Word 时,关键在于格式选项的设定。建议选择“可编辑副本”以保留流式排版,若选择“精确副本”,软件将使用大量文本框固定位置,虽然视觉相似但极难二次编辑修改。
2. WPS Office 的直连云端批处理模式
WPS 的操作逻辑紧密贴合日常办公生态。用户在电脑端打开“图片转文字”或“OCR 工具”界面,将照片批量拖入列表窗口即可开始:
- 图像调整:提供基础的角度旋转、手动选区裁剪与三种黑白/灰度增强滤镜,但不具备深层几何曲面校正工具。
- 云端并行解析:点击开始转换后,图片被分批次传输至云端识别服务,依赖服务器集群并发处理,批量处理速度受本地上行带宽与云端队列影响。
- 导出与同步:识别完成后,用户可直接点击“转为 Word”。文档将直接在 WPS 文字组件中打开并自动同步至云文档,适合需要多人即时协作的场景。
二、印刷体文字与特殊符号识别准确率
字符级别的准确率是 OCR 的立足之本。在文字本身的辨识上,光照均匀、纸张平整的标准宋体、黑体或常见拉丁字母,两款软件的表现差异微乎其微,字符准确度均可稳定在 98.5% 以上。真正的识别分水岭出现在符号语义、冷僻汉字以及复杂公式场景中。
| 测试文本类型 | ABBYY FineReader 识别特征 | WPS OCR 识别特征 | 差异成因分析 |
|---|---|---|---|
| 常规中文连贯段落 | 字符识别准确,中英文标点全角/半角区分严谨 | 识别速度快,常用词汇联想与错别字纠错准确 | WPS 基于海量中文语料库,语言模型对现代汉语上下文适应更好 |
| 英文专业词汇与连字符 | 准确识别行尾破折号(Hyphen)并在 Word 中自动连词 | 易将行尾连字符识别为独立减号,截断单词 | ABBYY 具备多语种系统词典,支持语法级的断行重组校验 |
| 数学公式与希腊字母 | 支持将公式区块单独标记,保留上下标与特殊符号编码 | 公式常被拆解为散落的斜体字母、横线与不规则数字 | ABBYY 内置数学符号拓扑解析模块,WPS 主要侧重自然语言文本 |
| 古籍冷僻字与生僻异体 | 依托扩展字库编码输出 Unicode,未收录字符标红提示 | 偶尔出现同音近形常见汉字自动替换替代现象 | WPS 的语义模型倾向于输出通用高频字,ABBYY 优先还原原始字形特征 |
在批量处理学术文献、法律合同等严谨资料时,ABBYY 呈现出更强的规范性。它严格区分全角双引号、半角单引号以及不同长度的连接号(En-dash 与 Em-dash);WPS 则在中文日常交流语境下表现更平滑,极少出现多余的空格乱码。
三、版面还原与排版重构深度对比
文字识别只是第一步,决定批量照片转换实用价值的关键在于版面重构。如果输出的 Word 文档中布满了相互重叠的绝对定位文本框,用户在调整字体或增删文字时,整篇文档就会彻底崩溃。
1. 数据表格的结构性重建
纸质文档中广泛存在的财务报表、统计清单在拍摄后往往存在边框模糊或缺失。ABBYY 拥有独立的表格拓扑分析引擎,能根据文字对齐关系推导隐藏的虚拟网格:
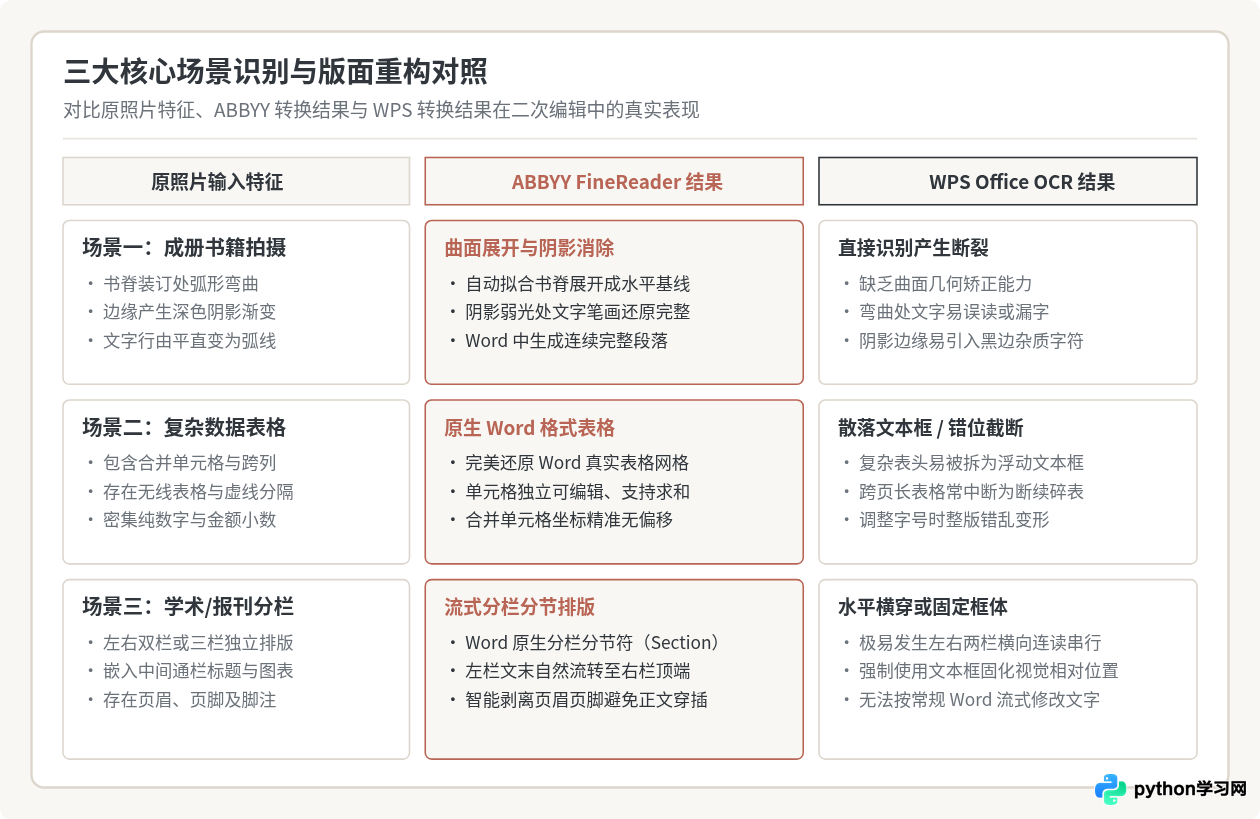
- 真实 Word 表格还原:ABBYY 输出的表格属于真正的 Word XML 结构。单元格具有明确的行、列坐标,支持鼠标拖拽改变列宽,内置数值可以直接在 Word 中应用 SUM 等公式进行计算。
- WPS 的多段文本框策略:WPS 在处理规整、拥有清晰黑实线的单页表格时能够生成标准表格;但在面对无外边框表、虚线表或跨页长表时,常退化为将数据块放置于半透明文本框内。这导致后续很难复制整列数据。
2. 多栏混排与流式分节排版
学术期刊、杂志和报纸通常采用双栏或三栏排版。当扫描或拍摄整页时,OCR 工具必须正确理解“先读左栏底部,再接续右栏顶部”的阅读顺序。
WPS 在遇到栏间距较窄或有横跨通栏大标题时,算法有时会发生横向连读错误,把左右两栏同一水平线上的文字强行合并为一行。为了避免这类错乱,WPS 往往在 Word 中为左右各建立一个浮动图文框。而 ABBYY 则能够在 Word 中插入原生“分节符”(Section Breaks),设定真正的分栏排版,使得文本在左栏编辑溢出后自然流淌到右栏,保持了原汁原味的流式排版体验。
四、拍摄畸变与低质量图像的容错机制
手机随手拍摄的照片不同于平板扫描仪,往往不可避免地伴随透视角度倾斜、边缘虚焦、纸张翘起与光照阴影。这是检验 OCR 预处理实力的硬指标。
书脊曲面平展算法:翻开厚重的书籍拍照时,靠近装订线的一侧必然呈现向下弯曲的弧度。WPS 本身未集成曲面展开网格算法,弯曲区域的文字因纵向拉伸与基线扭曲,经常被判定为乱码或产生大面积漏行。ABBYY 则内置了成熟的 3D 曲面展平算法,通过检测文本行的曲率变化,在识别前从数学层面将弧面反向投影拉平,确保边缘文字字形恢复矩形垂直,极大提升了成册翻拍材料的可用率。
非均匀光照与阴影补偿:当单侧光源或手机机身在纸面上投下暗影时,WPS 的全局二值化算法容易在阴影边界形成大块黑斑,影响正文字符连通域分析;ABBYY 采用了局部自适应阈值计算,能够平滑剔除漫反射阴影,在弱对比度背景下分离出纤细的汉字笔画。
五、系统资源、隐私合规与运行成本
除了识别与重构的技术指标,两款软件在部署环境、数据安全合规以及商业授权上的差别,同样是企业与重度用户决策的核心依据。
| 考量维度 | ABBYY FineReader PDF | WPS Office 深度集成的 OCR |
|---|---|---|
| 计算架构与数据流 | 100% 本地运算,图像数据不离开本机内存与磁盘 | 主要依赖云端 API 交互,图像数据需分块加密上传 |
| 网络依赖性 | 完全离线可用,适合内网隔离环境或离线笔记本 | 必须保持宽带连接,断网状态下批量识别功能受限 |
| 本地硬件资源开销 | 对 CPU 多核心与内存占用较高,大批转换时风扇明显提速 | 本地几乎零算力负担,核心任务由金山云端服务器承担 |
| 合规与保密适用 | 高度符合金融审计、保密军工、司法卷宗与医疗档案要求 | 遵循通用商业办公隐私协议,适宜常规非涉密业务资料 |
| 授权与成本模式 | 专业单机买断或企业年费许可证,单次采购成本较高 | 深度集成于 WPS 超级会员体系,个人与团队订阅门槛较低 |
六、综合选型决策路径与批量落地建议
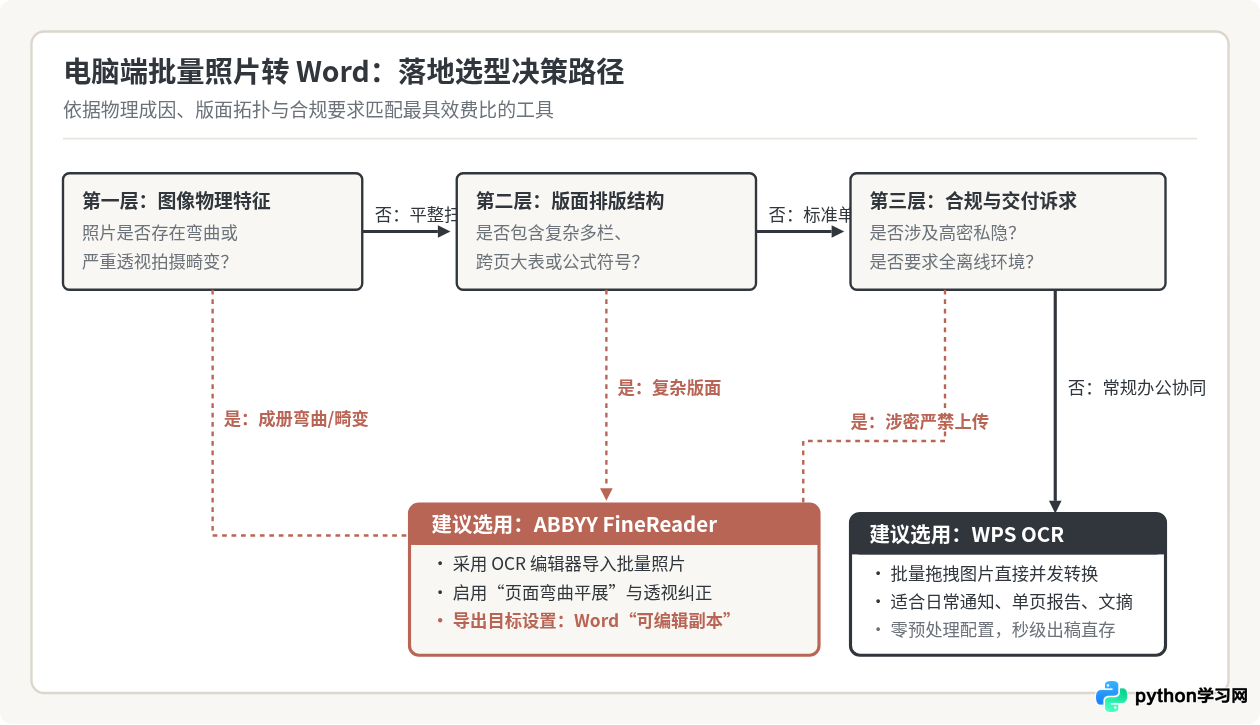
通过前述多个维度的对比分析可以发现,两款工具并非单纯的胜负替代关系,而是对应着清晰的需求分界。根据以下决策逻辑,可以在实际工作中实现效率最大化。
1. 选型判断法则
- 推荐选用 WPS 的条件:处理对象主要是用手机平平整整俯拍的单页文档、会议白板、普通发票或单栏打印稿;追求在两三分钟内把几十张图片变成可读文字,且电脑时刻联网。此时 WPS 操作链路最短,直接在办公软件中闭环。
- 推荐选用 ABBYY 的条件:处理对象包含成册图书翻拍、历史文献扫描、多栏学术期刊、跨页大型数据表格或包含复杂公式的理工科书籍;需要把生成的 Word 作为终稿长期编辑排版;或者运行在无外网连接的保密隔离机房。
2. 提升批量照片转 Word 效果的拍摄建议
再强大的 OCR 算法也无法完全弥补极度劣质的原始图像。为了在批量转换中减少人工核对量,在源头拍摄时应保持以下三个基本习惯:
- 双侧布光避免单点反光:使用两盏台灯从左右 45 度角照射纸面,避免使用手机自带闪光灯在铜版纸表面形成刺眼的亮斑。
- 保持镜头光轴与纸面垂直:尽量将手机固定在桌面支架上进行平视俯拍,使画面四个角距离镜头的距离保持一致,从物理层面消除严重的梯形畸变。
- 分页折印留出边界:翻拍较厚的书籍时,可用亚克力透明压条抚平书页,但压条边缘应避开文字行,为软件的文本行分析保留清晰的白边边界。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









