

Python列表去重且保持原始顺序的方法
详细讲解在Python中对列表进行去重且严格保持原始先后顺序的实用方法,包含dict.fromkeys原理机制对比、不可哈希对象去重方案与性能避坑指南。
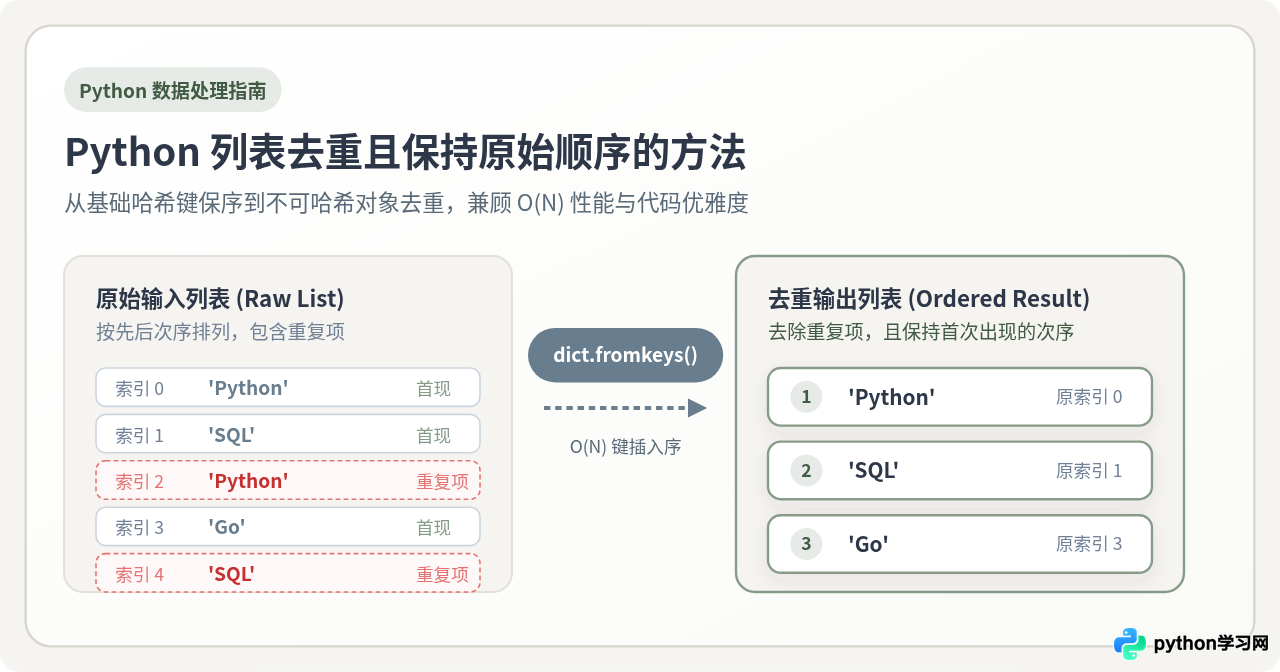
list(set(seq)) 去重,会因集合底层的散列分布机制破坏列表中元素原有的先后顺序。当业务依赖列表的初始时序(例如时间轴倒序日志、用户操作足迹、按权重排序的关键词或菜单选项)时,现代 Python(3.7 及以上版本)最简洁、高效的标准解法是使用 list(dict.fromkeys(seq))。若列表中包含不可哈希的字典或嵌套列表,则应配合 seen = set() 辅助集合进行键值提取过滤。
一、首选方案:使用 dict.fromkeys() 实现保序去重
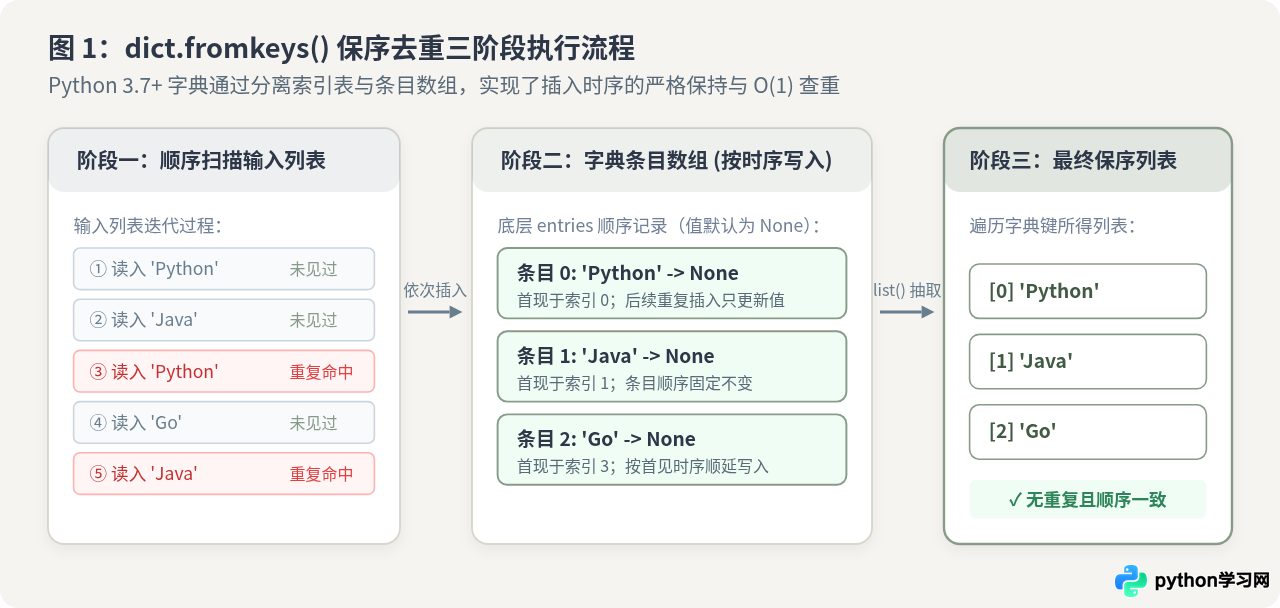
自 Python 3.7 开始(CPython 3.6 作为实现特性引入),官方语言规范正式保证字典键的插入顺序与元素遍历顺序完全一致。同时,字典的键具有天然的唯一性,重复插入相同键时不会改变该键最初所占用的位置。
因此,将列表传入 dict.fromkeys() 会按顺序将元素作为键写入字典,重复元素被直接忽略,最后再由 list() 将字典的所有键按顺序取出。这一过程在 C 底层执行,时间复杂度仅为 O(N),且无需引入任何第三方模块。
1. 完整示例代码
# 原始标签列表(包含重复项,且次序代表用户添加的先后时间)
raw_tags = ['Python', 'SQL', 'Python', 'Go', 'Docker', 'SQL', 'Rust']

# 核心语句:执行保序去重
unique_tags = list(dict.fromkeys(raw_tags))

# 打印验证结果
print("原始列表:", raw_tags)
print("保序去重:", unique_tags)原始列表: ['Python', 'SQL', 'Python', 'Go', 'Docker', 'SQL', 'Rust']
保序去重: ['Python', 'SQL', 'Go', 'Docker', 'Rust']
可以看到,重复出现的 'Python' 和 'SQL' 被成功剔除,而未重复的首现位置(索引 0 的 Python、索引 1 的 SQL、索引 3 的 Go 等)被完整保留。
二、机制对照:为什么普通 set() 会打乱列表次序?
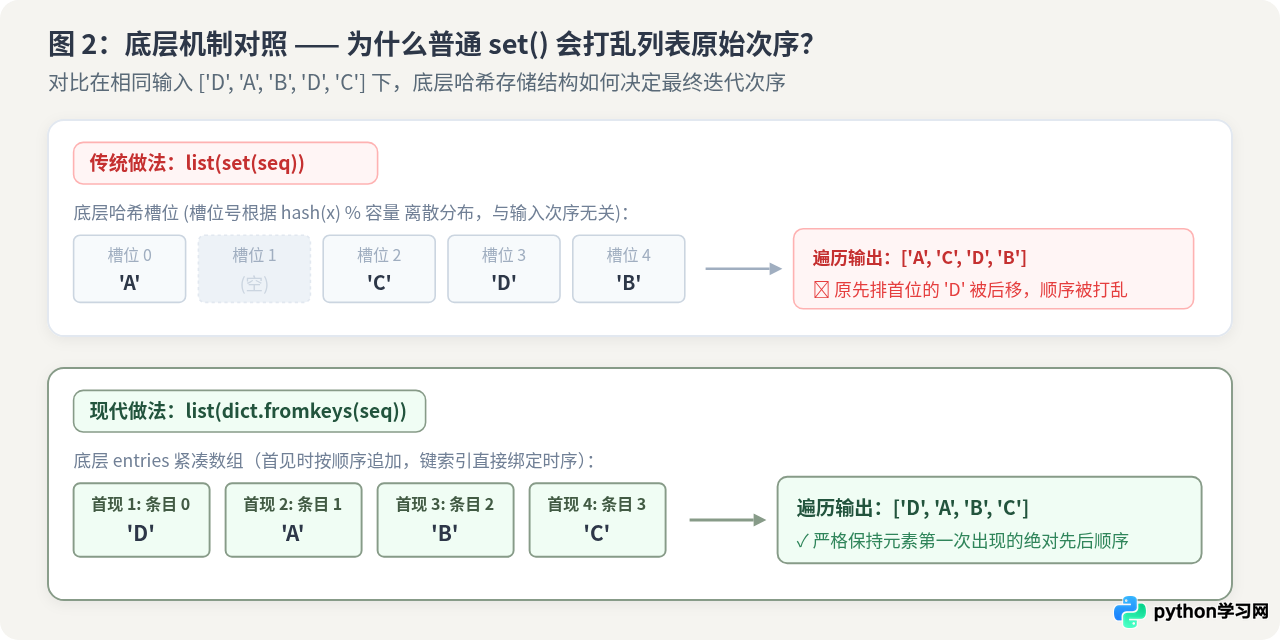
许多初学者疑惑:既然 set() 也是哈希表,为什么它无法保持顺序?理解二者的底层数据结构差异,有助于在实际工程中做出正确的选型决策:
- 集合 set() 的运作机制:Python 中的
set底层由单个散列稀疏数组构成。每个元素被存放的位置完全由其哈希值与当前分配的桶大小(hash(item) % table_size)决定。当对其进行遍历时,解释器是从槽位 0 开始依次扫描所有非空槽。因此,遍历顺序反映的是内存桶的散列物理布局,与元素进入集合的时间完全没有关联。 - 紧凑字典 dict 的运作机制:自 Python 3.6+ 起,字典采用了更高效的紧凑内存模型:由一个记录哈希槽索引的“稀疏索引表”与一个按时序追加的“连续条目数组(entries)”共同维护。新键到来时直接追加到 entries 的末尾,重复键到来时仅查表定位,不会变更原条目在 entries 数组里的物理下标。遍历字典时直接按 entries 数组递增下标遍历,从而实现了对插入时序的绝对保留。
相同输入下的行为对照
seq = ['D', 'A', 'B', 'D', 'C']

# 方式 A:普通 set 去重(顺序不可控)
set_result = list(set(seq))

# 方式 B:dict.fromkeys 保序去重(顺序精确固定)
dict_result = list(dict.fromkeys(seq))

print("set 结果:         ", set_result)
print("dict.fromkeys 结果:", dict_result)set 结果: ['A', 'C', 'D', 'B'] (乱序,排在首位的 'D' 被打乱到第三位)
dict.fromkeys 结果: ['D', 'A', 'B', 'C'] (完全保持首现顺序)
三、复杂场景:不可哈希元素(字典、列表)的保序去重
dict.fromkeys() 虽然优雅高效,但有一个明确的前置限制:列表中的元素必须是可哈希类型(Hashable),例如数字、字符串、元组等。如果列表中包含字典(例如从数据库或 REST API 查出的数据行)或嵌套列表,执行 dict.fromkeys() 会直接触发 TypeError: unhashable type: 'dict'。
针对这种场景,标准解法是编写一个辅助生成器函数,利用 seen = set() 维护已遇到的特征标识(如记录的唯一主键 ID),并用一个轻量循环按顺序产出数据。
1. 基于唯一键的保序去重实现
def deduplicate_by_key(items, key=None):
    """
    对包含不可哈希对象(如字典)的列表进行保序去重。
    :param items: 输入的可迭代对象
    :param key: 提取可哈希唯一特征的函数(例如 lambda x: x['id'])
    """
    seen = set()
    result = []
    for item in items:
        # 如果提供了 key 函数则以其返回值作为判重依据,否则直接比对元素
        val = key(item) if key else item
        if val not in seen:
            seen.add(val)
            result.append(item)
    return result

# 测试数据:用户浏览行为列表(字典不可哈希,但拥有唯一 user_id)
records = [
    {'user_id': 101, 'action': 'login', 'city': '北京'},
    {'user_id': 102, 'action': 'click', 'city': '上海'},
    {'user_id': 101, 'action': 'view',  'city': '广州'},  # 重复 user_id
    {'user_id': 103, 'action': 'logout', 'city': '深圳'}
]

deduped_records = deduplicate_by_key(records, key=lambda x: x['user_id'])
print("去重后的记录数:", len(deduped_records))
for r in deduped_records:
print(r)去重后的记录数: 3
{'user_id': 101, 'action': 'login', 'city': '北京'}
{'user_id': 102, 'action': 'click', 'city': '上海'}
{'user_id': 103, 'action': 'logout', 'city': '深圳'}
2. 无独立 ID 的纯字典内容全量去重
如果业务中的字典没有类似 id 的唯一属性,而要求“键值对完全相同才算重复”,可以将字典转化为可哈希的冻结元组后再进行判重:
def dict_to_hashable(d):
    # 按照键排序后转化为由 (key, value) 构成的元组
    return tuple(sorted(d.items()))

unique_dicts = deduplicate_by_key(records, key=dict_to_hashable)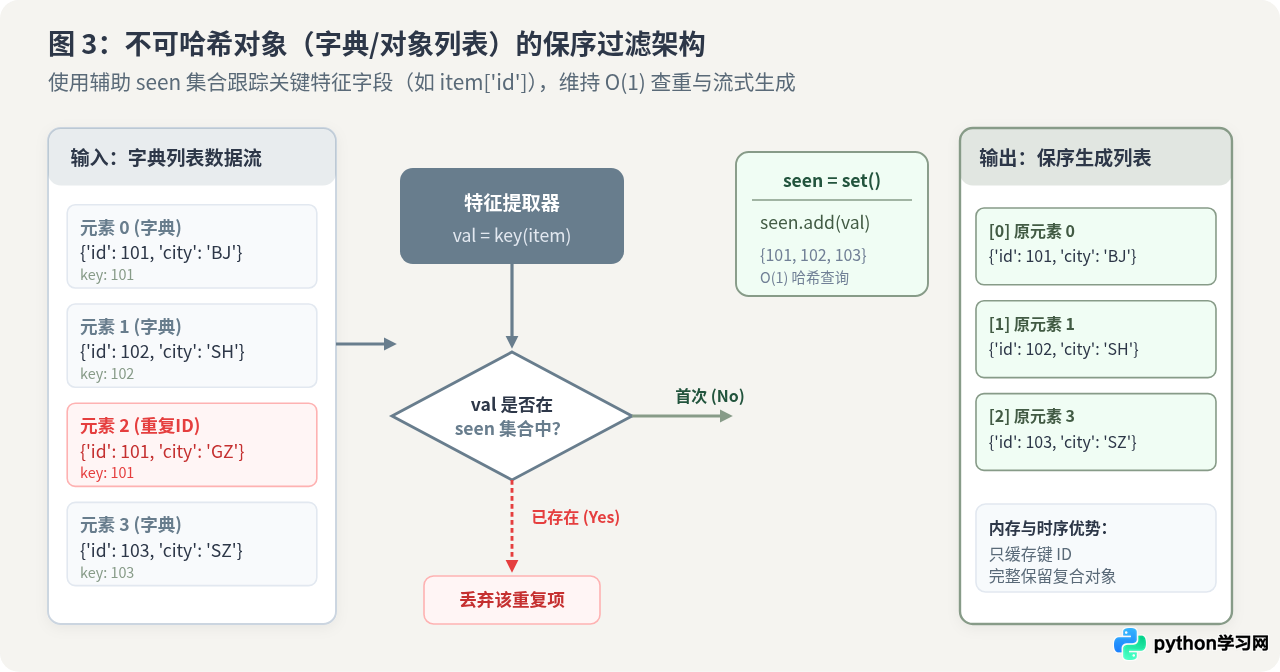
四、历史方案与常见性能陷阱
在寻找保序去重方案时,网络上常出现一些看似简短但暗藏隐患的写法,在生产环境中需要特别注意甄别:
许多开发者直觉上会写出以下两类代码:
result = [x for x in seq if seq.count(x) == 1]:严重逻辑错误,这并非去重,而是把所有出现过两次以上的元素全盘删除,只保留从未重复过的孤立元素。result = []; [result.append(x) for x in seq if x not in result]:严重性能瓶颈,因为 x not in result 是在列表上进行线性扫描,每次耗时 O(K),整体时间复杂度直接退化为 O(N²)。在 10 万级数据量下,该写法可能耗时数分钟,而 dict.fromkeys() 仅需约 15 毫秒。
历史遗留方案:OrderedDict
如果在维护运行在旧版本 Python(Python 2.7 或 Python 3.5 之前)的系统,可以使用标准库提供的 collections.OrderedDict:
from collections import OrderedDict

legacy_unique = list(OrderedDict.fromkeys(raw_tags))
在 Python 3.7+ 环境中,普通 dict 已经具备保序能力且底层经过极致的 C 语言优化,直接使用内置 dict.fromkeys() 速度更快、内存占用更低,无需导入额外模块。
五、选型总结与决策建议
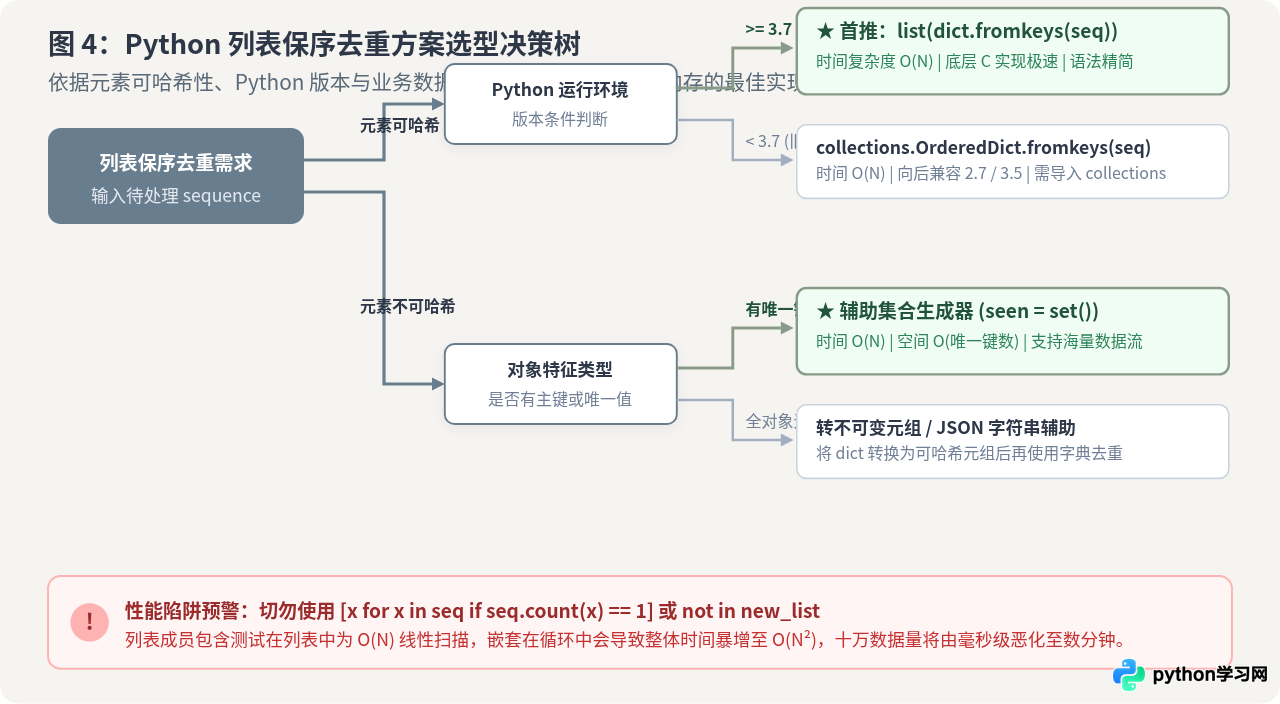
为了在实际编码中快速选择最合理的保序去重方式,可参考如下决策对照表:
| 场景条件 | 推荐方案 | 时间复杂度 | 空间复杂度 | 核心优势 |
|---|---|---|---|---|
| Python 3.7+ 且元素可哈希(数字/字符串/元组) | list(dict.fromkeys(seq)) |
O(N) | O(N) | Python 官方推荐标准写法,C底层实现,执行极快 |
| Python < 3.7 且元素可哈希 | collections.OrderedDict.fromkeys(seq) |
O(N) | O(N) | 跨版本通用性强,老旧环境兼容 |
| 元素不可哈希(字典、自定义类)且有唯一字段 | seen = set() 辅助生成器函数 |
O(N) | O(唯一键数) | 内存开销仅取决于键大小,支持无限生成器流 |
| 元素不可哈希且无唯一键(全内容比对) | 转换为排序元组 tuple(sorted(d.items())) |
O(N log M) | O(N) | 严格按内容无损判重,不改变原始对象结构 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









