

确定Python职业方向后,需要重点掌握哪些库和框架?
针对Web后端开发、数据分析与工程、自动化运维测试、人工智能四大主流Python职业方向,系统梳理不可替代的骨干框架与核心支撑库,提供清晰的技术选型依据与学习落地闭环。
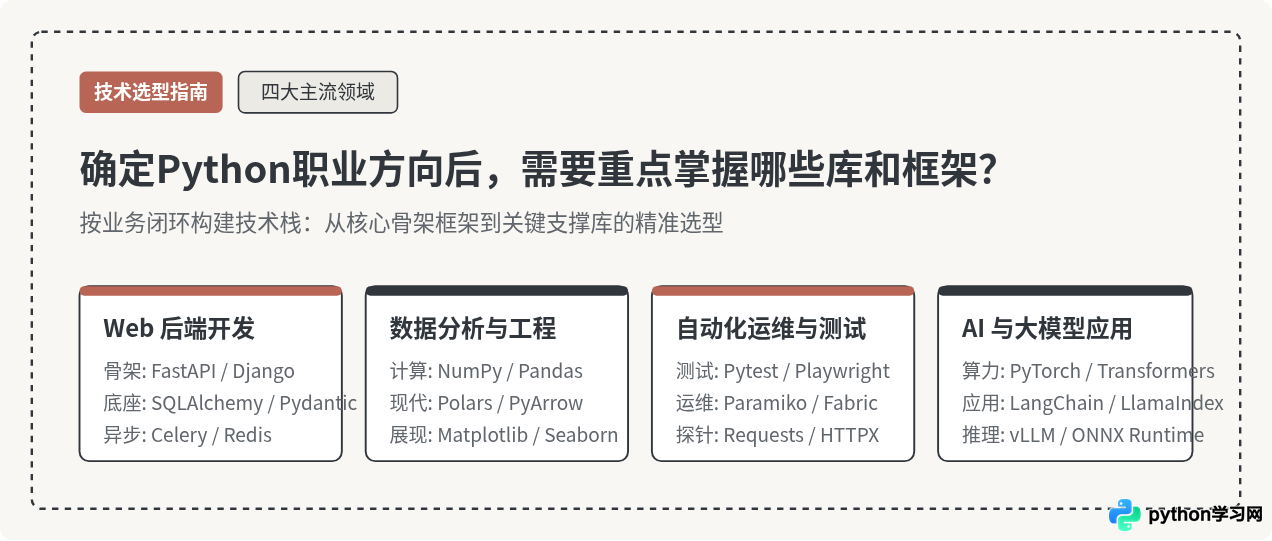
一、从方向确立到技术栈落地的四步筛选路径
许多初学者在确定职业方向后,往往陷入“收藏几百个第三方库、逐个阅读官方文档”的盲目状态。事实上,生产环境下的技术栈并非零散库的简单堆砌,而是围绕特定系统拓扑建立的调用链。
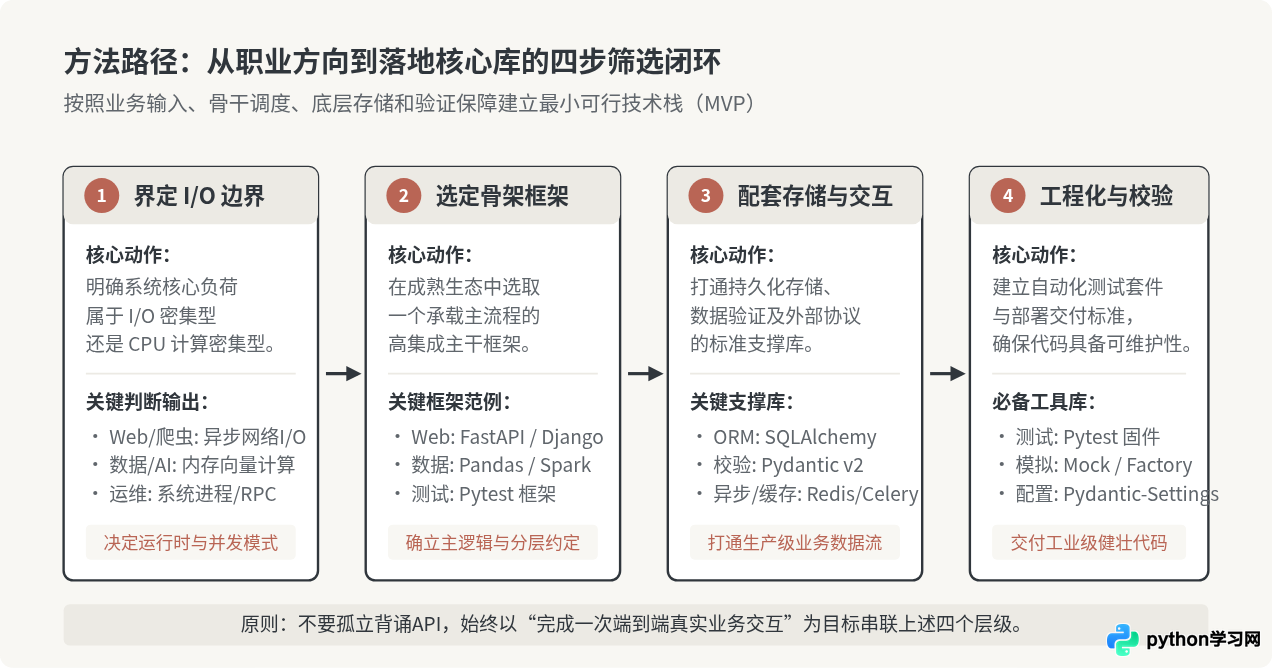
为了避免无效学习,任何方向的技术栈构建都应当遵循以下四个具体步骤:
- 界定系统的核心 I/O 与计算瓶颈:首先判断业务属于高并发网络 I/O 密集型(如高频 API 交互、爬虫抓取)、本地多维矩阵计算密集型(如机器学习训练、量化清洗),还是系统进程与网络协议通信型(如测试平台、批量运维)。输入输出形式直接决定了需要采用同步模型还是异步事件循环。
- 锁定承担主业务流的“骨架框架”:在确定的方向中,只选择一个生态成熟度最高、约束力最强的骨架框架进行深度攻坚。骨架框架决定了项目的目录结构、生命周期管理、路由分发与错误捕获机制。
- 配置标准化的持久化存储与校验工具:任何工业系统都离不开数据存取与数据清洗。必须掌握该领域事实上的通用 ORM、列式序列化或矩阵存储底座,彻底解决业务数据在内存与持久化介质之间的流转。
- 补齐工程化测试与环境保障工具:编写可交付代码的前提,是具备编写测试用例、模拟外部依赖与管理配置环境的能力。自动化测试工具不是附属品,而是验证框架掌握深度的唯一抓手。
二、Web 后端开发:以接口性能与数据建模为核心
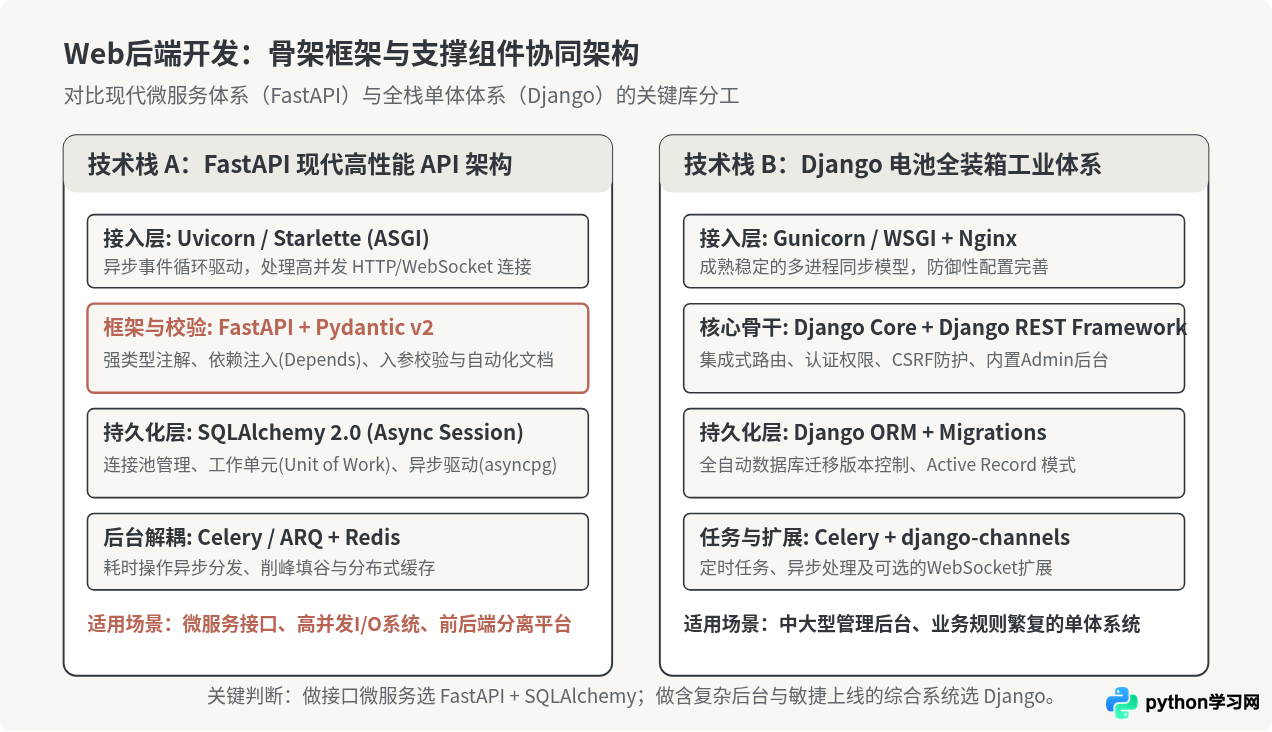
在 Web 后端开发方向,Python 的主要任务是构建高可用的业务 API 服务、管理后台及分布式业务系统。掌握的核心必须围绕“请求生命周期管理”与“数据库事务保障”展开。
1. 核心骨架框架选型:FastAPI vs Django
当前工业界在骨架框架上存在两种主流范式,读者应当根据实际业务形态做出清晰选择:
- FastAPI(现代微服务与高性能 API 事实首选):基于 Starlette 和 Pydantic 构建,原生支持 Python 3.10+ 的类型注解与
async/await异步并发。它的核心优势在于极致的开发效率与全自动生成的 OpenAPI 文档。学习 FastAPI 时,不要停留在简单的路由定义,重点要攻克其依赖注入系统(Dependency Injection)以及中间件(Middleware)的生命周期挂载。 - Django(全功能单体系统与复杂后台基石):如果业务需要快速上线完整的用户权限体系、内容管理或自带管理面板的企业内部系统,Django 的“电池全装箱(Batteries Included)”理念依然无可替代。学习 Django 必须重点掌握内置的
Django ORM关联查询、Migrations数据迁移机制以及Django REST Framework (DRF)的序列化器体系。
2. 核心底座与数据层:SQLAlchemy 2.0 与 Pydantic v2
脱离了数据持久化,Web 框架就成了无源之水。无论选择 FastAPI 还是其他轻量框架,以下两个库是必须掌握的基础:
- SQLAlchemy 2.0:Python 生态中最具统治力的 ORM 库。在 2.0 版本中,SQLAlchemy 全面统一了 Core 和 ORM 的语法风格,并深度支持原生异步引擎(如结合
asyncpg)。必须重点掌握Session的上下文生命周期管理、连接池参数调优(pool_size、max_overflow)以及select()链式查询与延迟加载(Lazy Loading vs Joined Loading)引发的 N+1 查询问题。 - Pydantic v2:负责数据的运行时类型检查与高效序列化。其底层采用 Rust 重构,性能大幅提升。重点掌握
BaseModel的字段校验装饰器(field_validator)、序列化控制以及Settings环境配置管理。
3. 异步解耦与缓存:Celery 与 Redis-py
生产环境绝不允许在 HTTP 请求响应链路中执行耗时的外部调用、报表生成或邮件发送。
三、数据分析与数据工程:以计算底盘与管道流转为核心
数据方向的核心诉求是在有限的内存与 CPU 资源下,完成海量结构化数据的抽取、清洗、转换(ETL)与聚合建模。该方向的技术栈高度聚焦于矩阵运算底座和高性能列式管道。
1. 内存计算基石:NumPy 与 Pandas
- NumPy:几乎所有数据科学库的共同底座。重点理解其核心数据结构
ndarray的连续内存存储机制、C语言原生内存块连续性(C-contiguous vs F-contiguous)、广播机制(Broadcasting)以及避免 Python 级别循环的向量化操作(Vectorization)。 - Pandas:日常业务分析的事实工业标准。重点掌握
DataFrame与Series的双轴索引机制、merge/join/concat数据表关联、groupby分组聚合流水线,以及如何通过转换category类型来减少 70% 以上的内存占用。
2. 现代列式存储演进:Polars 与 PyArrow
随着单机处理数据规模从兆级(MB)增长到十吉级(10GB+),传统 Pandas 的全内存单线程模型常遭遇内存溢出(OOM)。现代数据工程岗位强烈要求掌握以下演进工具:
- Polars:基于 Rust 开发的多线程列式数据处理库,原生采用 Apache Arrow 内存格式。其核心竞争力在于提供惰性求值(LazyFrame)机制,能够在执行前自动对查询树进行谓词下推与列投影优化。
- PyArrow:跨语言零拷贝(Zero-copy)内存共享的标准接口。重点掌握其读取与写入
Parquet压缩列存文件的操作,这是现代数据湖(Data Lake)与分布式引擎互通的关键媒介。
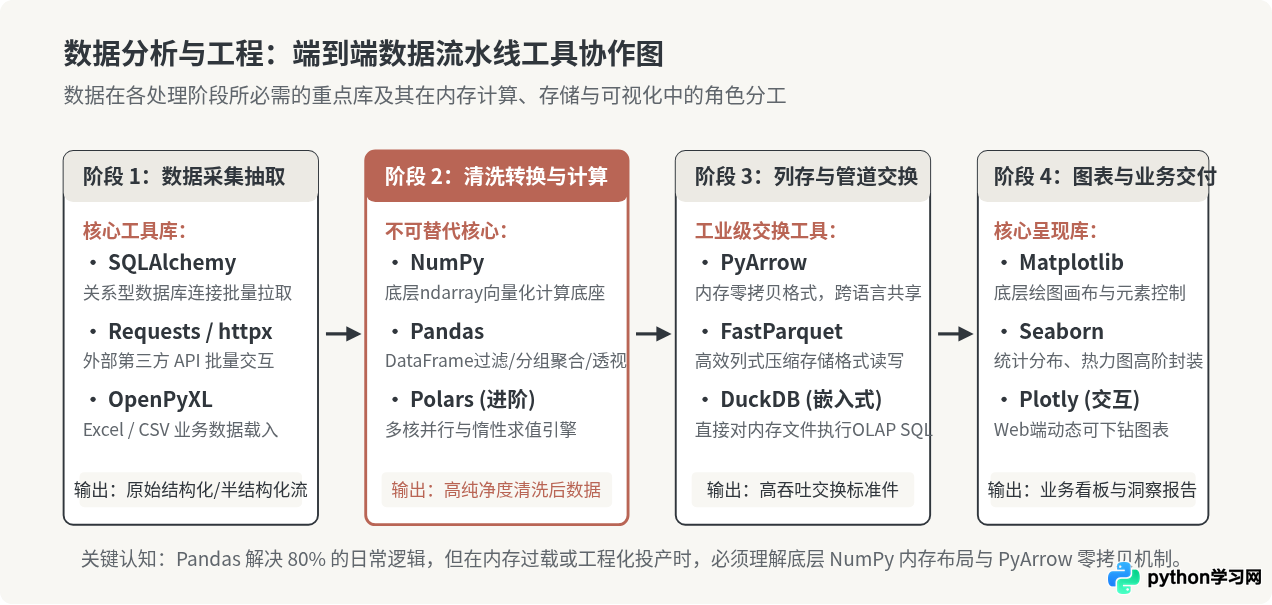
3. 数据可视化呈现:Matplotlib 与 Seaborn
分析结果必须通过图表具象化。掌握重点不在于记住几百个绘图参数,而在于掌握对象分层机制:
- Matplotlib:必须深入理解面向对象绘图模型(
Figure与Axes的包含关系),掌握子图切分、双坐标轴以及画布渲染引擎(Backend)配置。 - Seaborn:建立在 Matplotlib 之上的统计级封装,重点掌握多变量关联分布图(
pairplot)、热力透视矩阵(heatmap)与分类回归拟合线(regplot)。
四、自动化运维与测试开发:以可靠执行与协议交互为核心
测试开发与自动化运维岗位关注的是保障软件质量与系统稳定性。此方向要求的不是业务算法的精巧,而是脚本执行的确定性、异常恢复能力以及对多种系统协议的穿透调用。
1. 自动化测试骨架:Pytest 事实标准
在测试开发领域,Python 内置的 unittest 已经被主流企业边缘化,Pytest 成为绝对的行业事实标准。学习 Pytest 必须彻底攻克以下三大机制:
- Fixture 依赖注入系统:彻底抛弃传统的类继承 setup/teardown 方式。理解 Fixture 的作用域(
function,class,module,session)、yield上下文清理以及自动加载机制(autouse=True)。 - 参数化测试(Parameterized Testing):使用
@pytest.mark.parametrize实现一套代码覆盖数百组测试用例数据,实现数据驱动测试(DDT)。 - 插件生态体系:熟练使用
pytest-xdist实现多进程并行测试加速,结合allure-pytest自动生成企业级测试报告。
2. UI 与接口自动化工具链:Playwright 与 HTTPX
- Playwright(现代端到端测试首选):相比老旧且依赖 WebDriver 独立进程的 Selenium,微软开源的 Playwright 拥有原生的异步事件驱动架构,支持多浏览器上下文秒级隔离、智能自动等待(Auto-waiting,彻底消除繁琐的手动
sleep)、网络请求拦截与重放。 - Requests 与 HTTPX:接口测试与巡检脚本的基础。HTTPX 在保持与 Requests 几乎一致 API 的同时,提供了原生
async/await客户端支持与 HTTP/2 协议兼容,是构建高并发接口监控探针的核心。
3. 基础设施连接与自动化控制:Paramiko 与 Fabric
运维开发工程师需要通过 Python 程序远程批量接管 Linux 服务器集群:
- Paramiko:纯 Python 实现的 SSHv2 协议底层库,负责底层的密钥认证、SFTP 文件传输通道与终端模拟。
- Fabric:基于 Paramiko 构建的高层运维自动化工具,将繁琐的底层套接字包装为简洁的本地/远程命令执行接口,适合编写轻量级集群升级与服务重启编排。
五、人工智能与算法应用工程:从模型底座到生产推理
随着生成式 AI 与大模型工程化落地,算法领域的技能重心已经从早期的“纯从零训练模型”转向“模型微调、推理加速与智能体应用集成”。
1. 深度学习与张量计算底座:PyTorch
在学术界与工业界研发中,PyTorch 已牢牢占据统治地位。掌握 PyTorch 的重点在于:
- 动态计算图与 Autograd 机制:理解
Tensor的数据布局、设备转移(.to("cuda"))以及梯度追踪与反向传播生命周期。 - 标准工程模块:熟练掌握
torch.nn.Module模型定义、DataLoader多进程批次加载与混合精度训练(torch.cuda.amp)。
2. 大语言模型工程:Transformers 与应用框架
- HuggingFace Transformers:LLM 时代的绝对通用底座。必须掌握模型权重加载(
AutoModelForCausalLM)、分词器(AutoTokenizer)、提示词编码与 HuggingFacePipeline接口,并了解 LoRA/QLoRA 等轻量微调加载机制。 - LangChain 与 LlamaIndex:在企业级 RAG(检索增强生成)与智能体(Agent)开发中,重点理解向量数据库索引交互(结合 Chroma / Faiss)、文档切分器(TextSplitter)以及结构化输出解析机制。
3. 模型服务化与推理加速:vLLM、ONNX Runtime 与 FastAPI
模型无法停留在实验室 Jupyter Notebook 中,必须封装成工业级高并发服务:
- vLLM:大模型高吞吐推理服务的事实标准,必须理解其核心的 PagedAttention 机制(显存碎片整理与 KV Cache 管理)以及连续批处理(Continuous Batching)原理。
- ONNX Runtime:针对传统视觉或分类模型,跨平台轻量部署的首选推理引擎。
- FastAPI:作为模型对外的标准 RESTful / SSE 流式接口封装层,承接业务鉴权与推理结果推送。
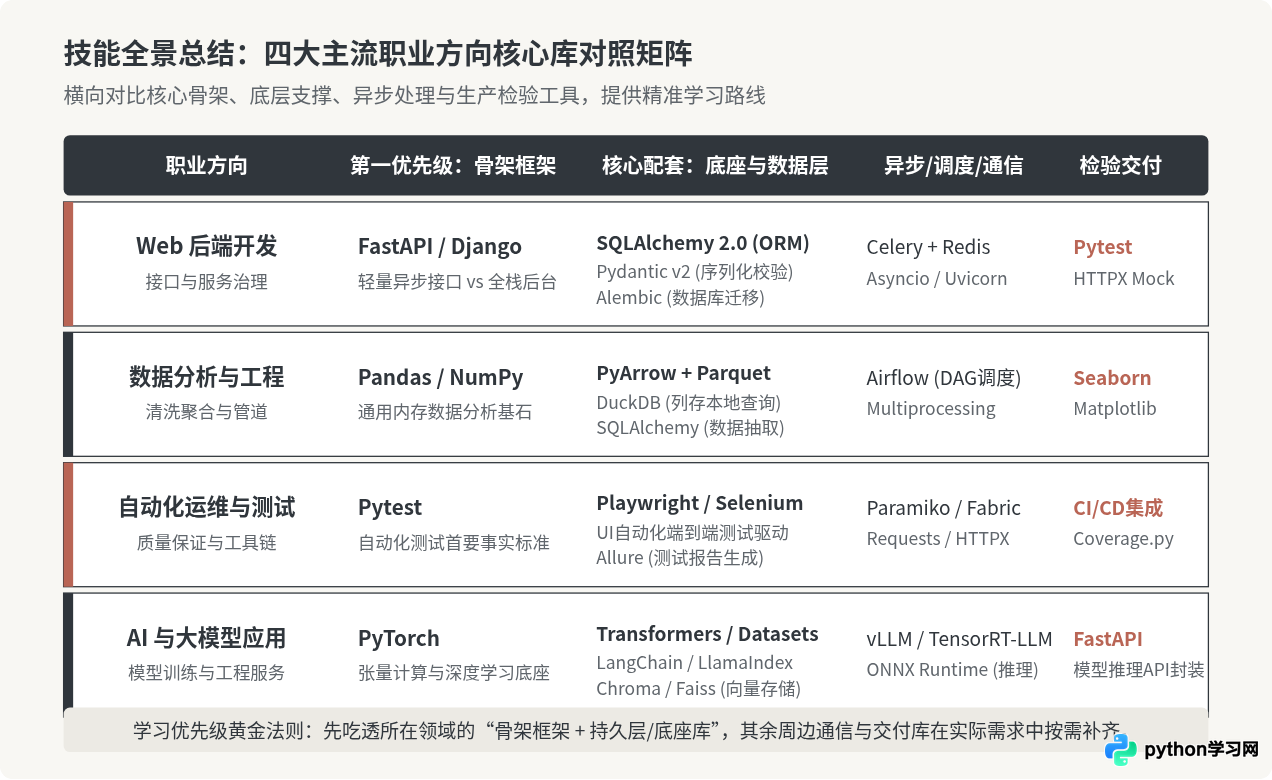
六、四大方向核心技术栈全景对照矩阵
为了帮助读者建立全景视野,下表将四大主流方向的核心技术栈在不同功能层级中的定位进行了归类提炼:
| 职业方向 | 核心业务属性 | 首要骨架框架 | 数据底座 / ORM | 异步调度 / 协议通信 | 质量验证 / 交付工具 |
|---|---|---|---|---|---|
| Web 后端开发 | 高并发服务 / 事务系统 | FastAPI / Django | SQLAlchemy 2.0 / Pydantic | Celery + Redis / Asyncio | Pytest / HTTPX-Mock |
| 数据分析与工程 | 海量数据清洗 / 统计建模 | Pandas / NumPy | PyArrow / Parquet / DuckDB | Airflow / Multiprocessing | Matplotlib / Seaborn |
| 自动化运维与测试 | 质量工程 / 系统编排 | Pytest 框架体系 | Playwright / Selenium | Paramiko / Fabric / HTTPX | Allure / Coverage.py |
| AI 与大模型工程 | 模型微调 / 推理服务化 | PyTorch / Transformers | Chroma / Faiss (向量存储) | vLLM / ONNX Runtime | FastAPI (SSE推理服务) |
七、掌握库与框架时的三个关键避坑准则
许多学习者试图把 Pandas 的几百个函数或 Django 的所有字段类型像背字典一样记下来。框架与库的真正技术门槛从来不是 API 名称,而是其底层生命周期与资源调度机制。例如:掌握 SQLAlchemy 的标志不是会写 session.add(),而是理解 Session 在多线程下的线程安全边界、连接池耗尽排查方法以及事务隔离级别的具体体现。
开源社区每周都会涌现声称“超越 Django”或“比 Pandas 快十倍”的全新库。在初入一个职业方向时,应坚决拥抱工业界渗透率最高的主流库(如 Pytest、Pandas、FastAPI、SQLAlchemy)。主流库不仅意味着完善的文档、活跃的 StackOverflow 社区和极低的踩坑概率,更是企业招聘招聘要求中的通用语言。
衡量一个库是否真正被掌握,唯一可靠的标准是能否用它独立串联起一套完整的业务闭环: Web 方向必须跑通“数据库模型建立 → 接口校验 → 异步任务触发 → Pytest 测试通过”; 数据方向必须跑通“原始多源数据加载 → 异常清洗与透视 → Parquet 列式落盘 → 统计图表导出”。 只有经历过真实环境下的调试与异常处理,这些库与框架才会真正转化为个人在职业市场中的核心竞争力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









