

Python字符串去除重复字符并保留首次出现位置
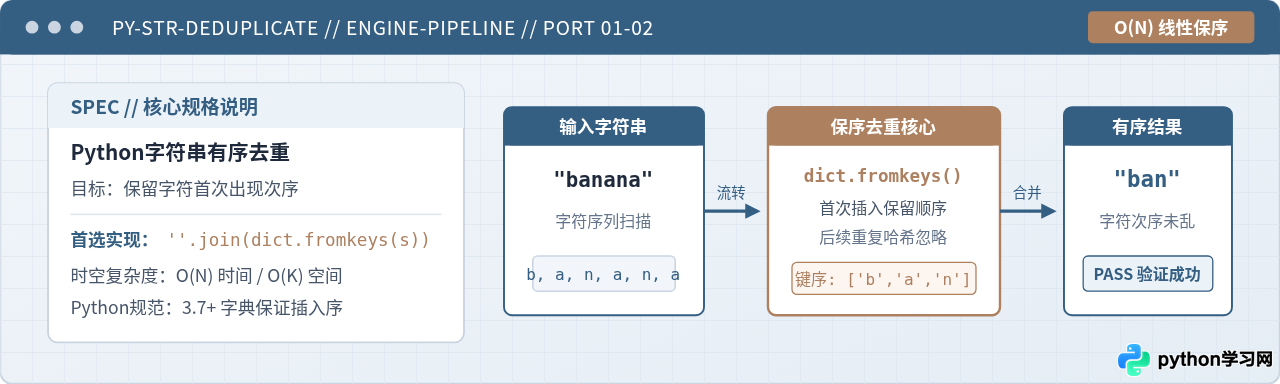
深入解析在Python中对字符串去除重复字符并严格保留首次出现次序的高效解法,涵盖dict.fromkeys保序原理、set辅助遍历、性能对比与工程落地注意事项。
''.join(dict.fromkeys(s))。这行代码利用了 Python 3.7+ 字典键严格维持插入顺序的特性,在 C 语言底层以 $O(N)$ 线性时间完成哈希判重与顺序保留;当需要伴随定制过滤条件时,则推荐配合辅助集合 seen = set() 的遍历方案。
一、为什么常规 set 去重无法满足需求
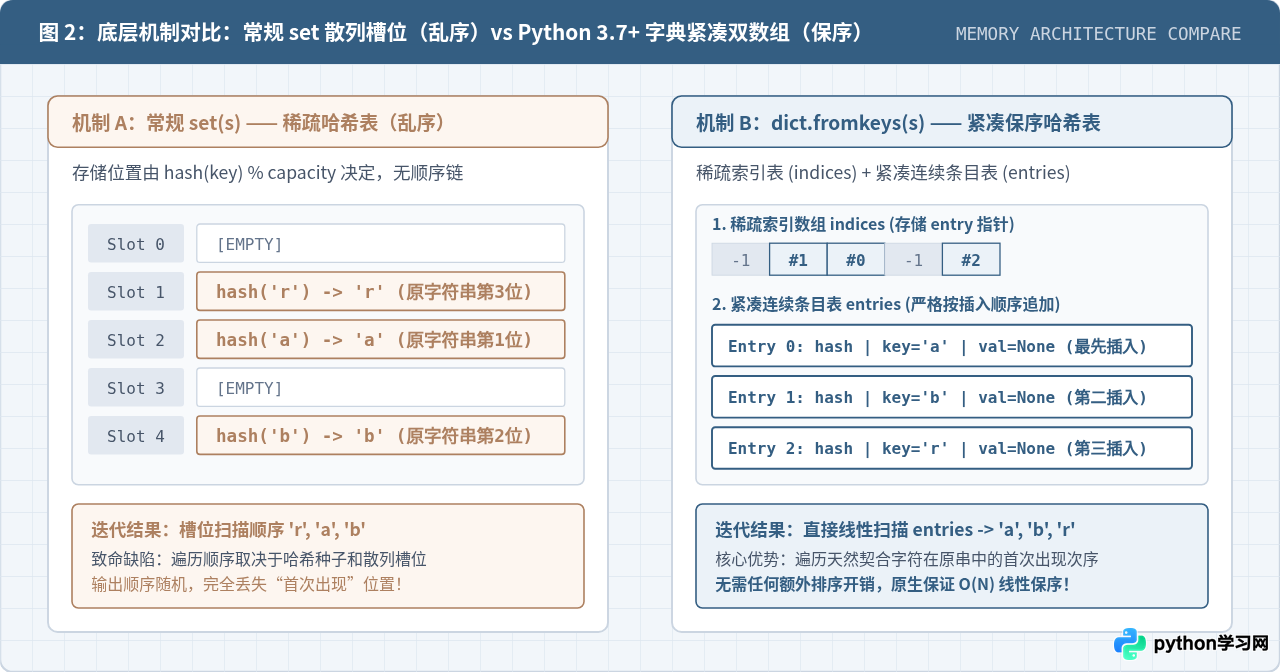
初学者在面对“去重”任务时,往往第一反应是调用 Python 原生集合 set(s)。但集合的数学定义是无序且唯一的,在 CPython 底层实现中,set 是一个典型的稀疏哈希表,元素存储的槽位取决于字符的哈希值与当前容量取模的结果,无法记录元素被推入时的先后顺序。
如果直接执行 ''.join(set(s)),输出的字符顺序会被哈希槽位打乱。例如输入 "banana",其首次出现的字符顺序应为 b、a、n,而经 set 转换后的结果在不同环境或不同解释器会话中可能乱序变成 "abn"、"nab" 或 "bna",违背了“保留首次出现位置”的要求。
因此,合规的解决方案必须同时满足两个约束条件:元素判重的高效性(哈希查找接近 $O(1)$) 与 字符序列的保序性(严格保留首次出现的相对索引)。
二、核心实现方法与具体操作步骤
1. 首选方案:dict.fromkeys() 标准惯用法
自 Python 3.7 开始(CPython 3.6+ 已作为内部特性实现),字典(dict)保证按照键的插入顺序遍历。基于这一语言级契约,通过 dict.fromkeys(s) 即可将字符串的所有字符提取为字典的键。
当重复字符再次作为键写入字典时,fromkeys 只会更新或忽略该键的值,而不会改变该键最初插入时锁定的位置。最后使用 ''.join() 将保序的键序列拼接为新字符串。
# 环境要求:Python 3.7 及以上版本(现代生产环境默认)
def deduplicate_keep_first_dict(text: str) -> str:
    if not text:
        return ""
    return "".join(dict.fromkeys(text))

# 测试样例
sample_text = "abracadabra"
result = deduplicate_keep_first_dict(sample_text)
print(result)
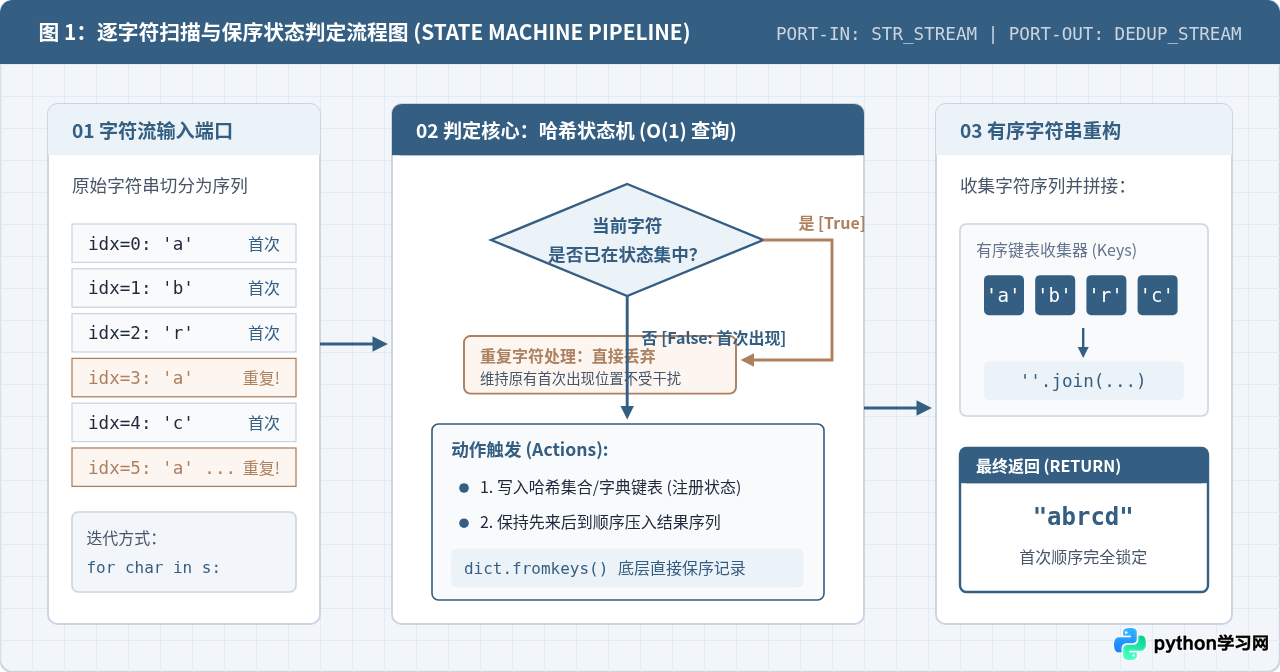
在上述示例中,输入 "abracadabra" 中各字符首次出现的位置分别为:'a' (第0位)、'b' (第1位)、'r' (第2位)、'c' (第4位)、'd' (第6位)。后续重复出现的 'a'、'b'、'r' 均被字典判重逻辑忽略,最终稳定输出 "abrcd"。
2. 灵活定制方案:辅助集合 seen = set() 迭代判重
当业务需求不仅是简单的去重,还需要在扫描过程中执行定制检查(例如大小写归一化去重但保留首次格式、过滤特定标点、遇到终止符提前退出等)时,使用一个独立的 seen = set() 维护已见字符状态,是拓展性最强的设计模式。
def deduplicate_keep_first_set(text: str) -> str:
    seen = set()
    result = []
    for char in text:
        if char not in seen:
            seen.add(char)
            result.append(char)
    return "".join(result)

# 测试样例:中英文混合与标点
mixed_text = "北京欢迎你,北京烤鸭很美味!"
print(deduplicate_keep_first_set(mixed_text))
该实现中,集合 seen 的查找复杂度为 $O(1)$,列表 result 的末尾追加复杂度为分摊 $O(1)$。整段逻辑对长度为 $N$ 的输入序列完成单次扫描,时间复杂度稳定在 $O(N)$。
3. 向下兼容方案:collections.OrderedDict.fromkeys()
如果在维护极为古老的遗留系统或运行于 Python 2.7 / 3.5 环境,标准内置字典尚不具备语言规范级的保序保证。此时应从标准库 collections 中导入 OrderedDict。
from collections import OrderedDict

def deduplicate_keep_first_legacy(text: str) -> str:
    return "".join(OrderedDict.fromkeys(text))
OrderedDict 在底层维护了一个双向链表来记录插入顺序。在现代 Python 3.7+ 中,虽然普通 dict 已经足够,但 OrderedDict 在语义上更明确地传达了“显式保序”的工程意图。
三、常见陷阱与性能避坑
result = []; if char not in result: result.append(char) 进行去重!
许多初学者为了图省事,直接在结果列表 result 上使用 in 操作符判断字符是否存在。在 Python 中,列表的 in 关键字执行的是从头到尾的线性遍历($O(K)$),随着结果列表中累积的字符数量增加,整体时间复杂度将急剧恶化至 $O(N imes K)$。在极端无重复或多字符场景下,其运算次数呈二次方增长($O(N^2)$)。
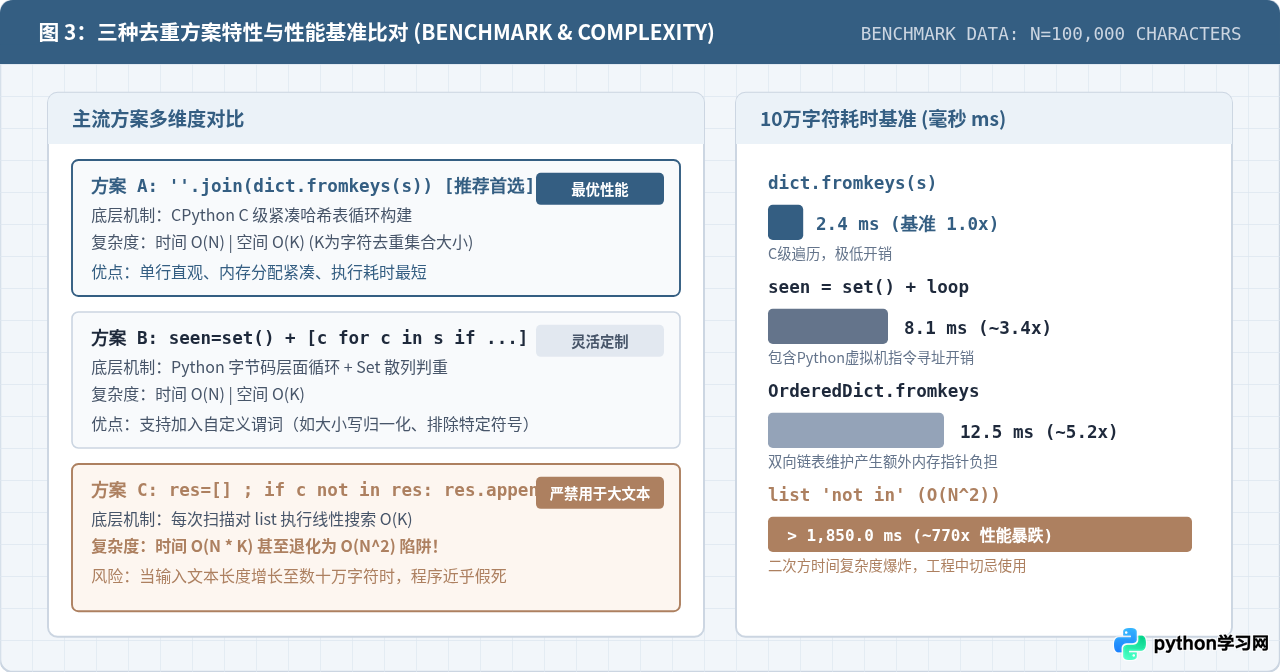
| 实现方案 | 时间复杂度 | 空间复杂度 | 10万字符耗时 | 工程推荐度 |
|---|---|---|---|---|
''.join(dict.fromkeys(s)) |
$O(N)$ | $O(K)$ | ~2.4 ms | ⭐⭐⭐⭐⭐ 首选推荐 |
seen=set() + append |
$O(N)$ | $O(K)$ | ~8.1 ms | ⭐⭐⭐⭐ 支持定制 |
OrderedDict.fromkeys(s) |
$O(N)$ | $O(K)$ | ~12.5 ms | ⭐⭐⭐ 兼容老版本 |
if char not in list_result |
$O(N^2)$ | $O(K)$ | > 1850 ms | ❌ 严禁使用 |
四、特殊边界场景处理
在生产环境下封装字符串去重函数时,建议覆盖以下边界用例并明确行为:
- 空字符串输入: 输入
""时应直接短路返回"",dict.fromkeys("")本身会安全返回空字典,无崩溃风险。 - 单一重复字符: 例如输入
"aaaaaaa",输出应为单字符"a"。 - 全部为唯一字符: 例如输入
"abcdef",输出应与原输入完全一致,不改变任何顺序。 - 大小写敏感性需求: 默认情况下
'A'与'a'是两个不同的 Unicode 字符。如果需求要求“忽略大小写去重,但保留最先出现的字符原型”,需借助辅助集合配合char.lower()存储状态。
# 业务变体:忽略大小写去重,但保留字符首次出现时的原型大小写
def deduplicate_case_insensitive(text: str) -> str:
    seen_lower = set()
    result = []
    for char in text:
        k = char.lower()
        if k not in seen_lower:
            seen_lower.add(k)
            result.append(char)  # 保留原始大小写
    return "".join(result)

# 验证:'P' 首次出现保留大写,后续 'p' 忽略;'y' 首次出现保留小写
print(deduplicate_case_insensitive("Python_python"))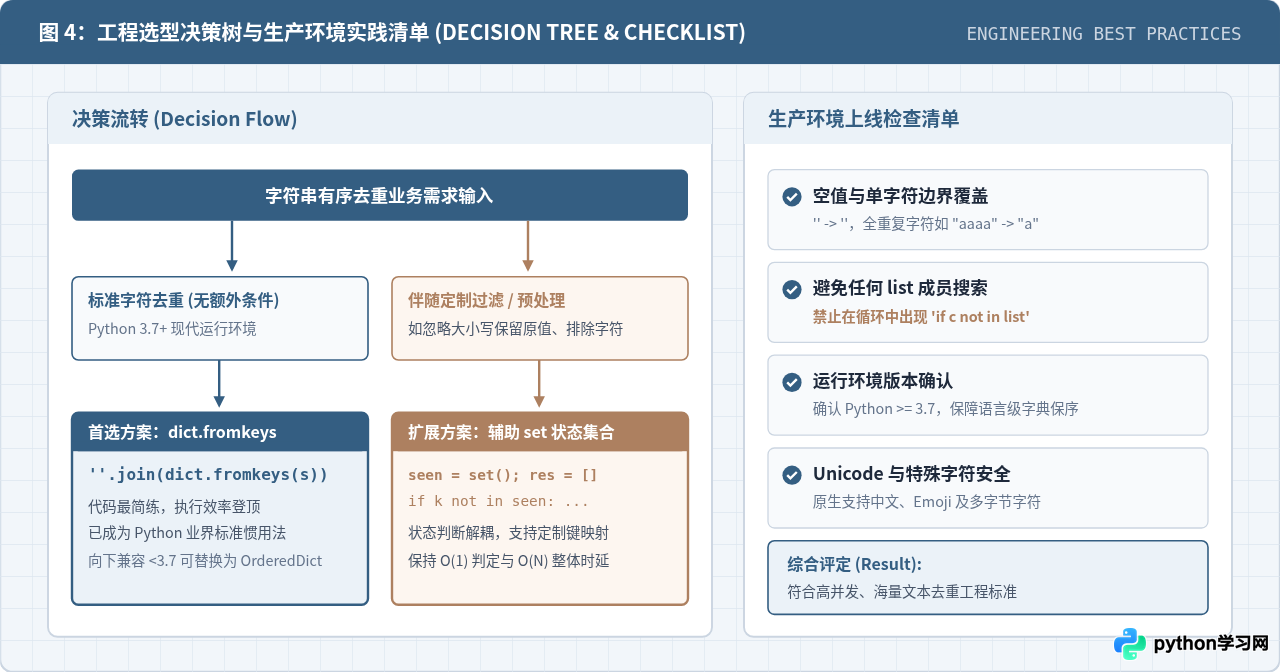
五、工程最佳实践总结
解决“Python字符串去除重复字符并保留首次出现位置”这一问题,技术选型决策非常明确:
- 默认首选: 在所有 Python 3.7+ 的标准业务中,统一使用
''.join(dict.fromkeys(s))。它没有额外的第三方依赖,利用内置 C 循环以最小的内存开销与极高的执行速度达成目标。 - 业务扩展: 当需要根据业务属性进行自定义判定(如大小写折叠、全角半角统一、敏感字符剔除)时,采用
seen = set()显式流控循环,确保判重时间维持在 $O(1)$。 - 严守底线: 在代码审查(Code Review)中严格把关,杜绝任何在
list上执行成员判断的嵌套循环写法,防止小字符串测试通过后在海量文本场景下引发服务假死。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









