

怎么用pandas2.3提前开启infer_string适配3.0?
详细讲解如何在 pandas 2.3 中提前开启 future.infer_string 配置项,平滑迁移适配 pandas 3.0 的默认 Arrow 字符串机制,包含核心原理、配置方法、代码断点排查及工程落地清单。
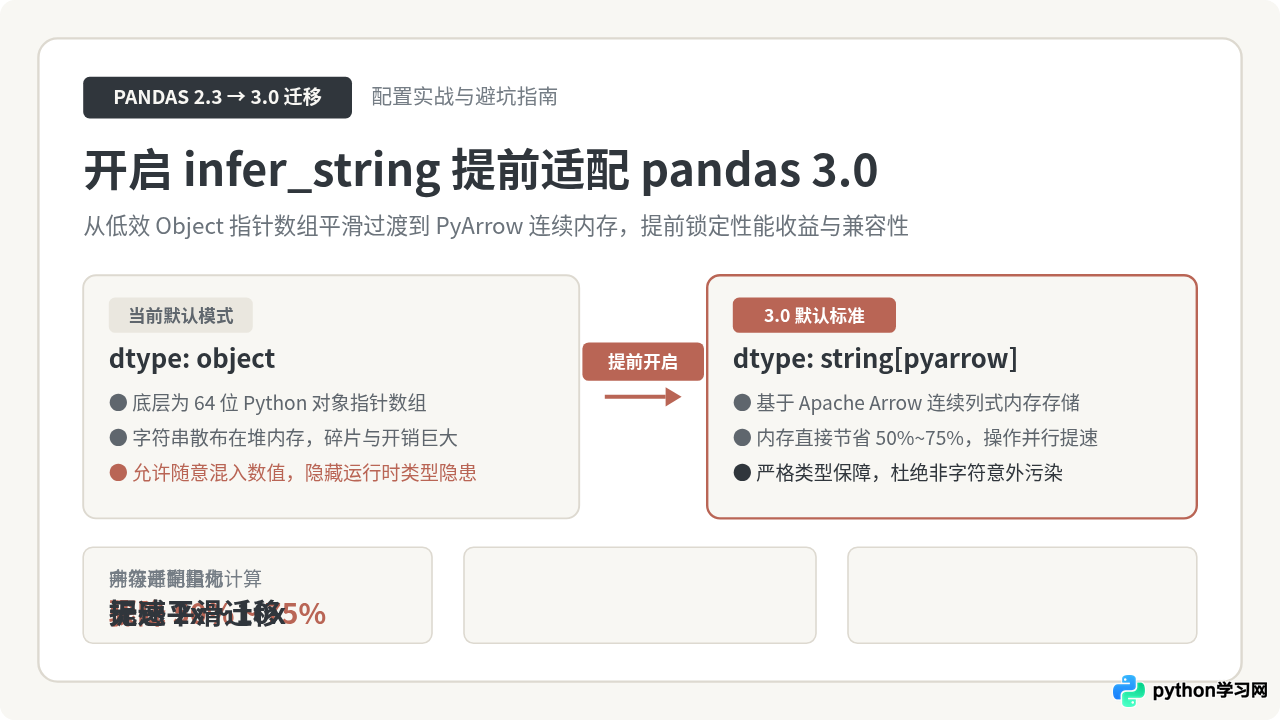
object 字符串存储将被彻底废弃,默认全面转为基于 Apache Arrow 的连续内存字符串类型(string[pyarrow])。如果你正在使用 pandas 2.3,无需等待 3.0 正式上线,只需在环境具备 pyarrow 的前提下,通过 pd.options.future.infer_string = True 或设置环境变量 PANDAS_FUTURE_INFER_STRING=1,就能提前开启全新字符串推断机制。此举不仅能让现有项目立即享受到内存占用降低 50%~75% 和字符串计算提速数倍的红利,更能提前在 CI/CD 中精准定位并消除因类型判定、缺失值语义及外部库对接带来的兼容断点,实现平滑适配。
一、核心结论:一键开启配置与前置要求
在默认情况下,pandas 2.x 读取 CSV、Excel 或从 Python 列表构造包含文本的 Series/DataFrame 时,推断出的列数据类型依然是 object。要提前开启 3.0 的字符串自动推断行为,需要满足一个硬性前置条件并执行一行配置:
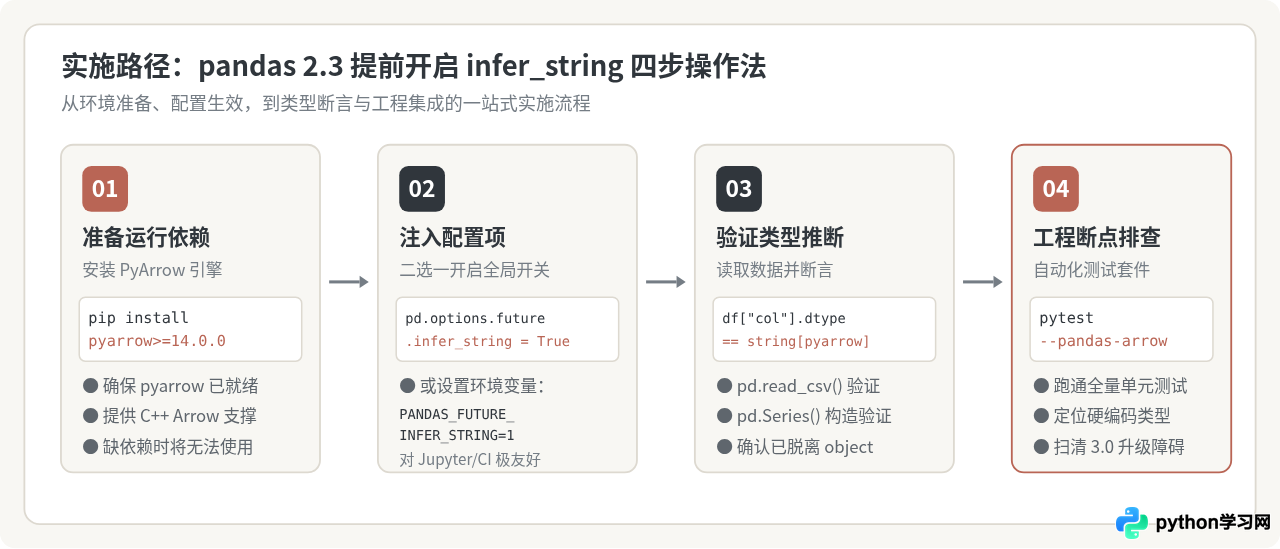
1. 安装必要依赖
推断机制的底层依赖 Apache Arrow C++ 运行时库。如果当前 Python 环境中尚未安装 pyarrow,开启配置后在遇到字符串推断时会抛出缺失依赖的异常。推荐安装 14.0 及以上版本:
# 在终端或虚拟环境中执行依赖安装
pip install "pyarrow>=14.0.0"
2. 代码内开启全局配置
在 Python 脚本、应用主入口或 Jupyter Notebook 的最顶端,导入 pandas 后设置 future.infer_string 为 True:
import pandas as pd

# 方式一:直接通过 options 命名空间属性开启(推荐)
pd.options.future.infer_string = True

# 方式二:通过 set_option 接口开启(等效写法)
pd.set_option("future.infer_string", True)
配置生效后,所有此前会被推断为 object 的字符串列,都将自动转换为 Arrow 支持的 string[pyarrow_numpy] 或 string[pyarrow] 专用字符串类型。
二、技术原理:为什么 pandas 3.0 必须淘汰 Object 字符串?
许多开发者会有疑问:既然 object 已经稳定使用了十几年,为什么 pandas 核心开发团队要将其列为 3.0 的破坏性改动?理解这一点,有助于我们在编写业务逻辑时建立更清晰的性能模型。
在 NumPy 与传统 pandas 中,object 类型的底层本质上是一个“指针数组”。每个元素存储的只是一个 64 位的内存地址(指针),而真正的数据是分散在 Python 运行时堆内存中的一个个 PyUnicodeObject 对象。这种离散设计带来了三大严重痛点:
- 内存膨胀剧烈:即使是一个长度仅为 5 个字母的短字符串(如
"apple"),在 64 位 Python 中包裹的PyUnicodeObject头部开销就高达 48~80 字节,外加 8 字节指针,实际开销是文本本身的 10 倍以上。 - CPU 缓存命中率极低:由于每个字符串对象在堆上独立分配,物理地址完全离散。当执行排序、过滤或正则表达式匹配时,CPU 无法进行线性预取,造成大量的 CPU Cache Miss,性能低下。
- 类型语义失控:
object列本质上是一个万能容器,它既能放字符串,又能混入整数、列表甚至是自定义对象,缺失值通常退化为浮点数np.nan,在大型工程中极易引发隐蔽的类型污染。
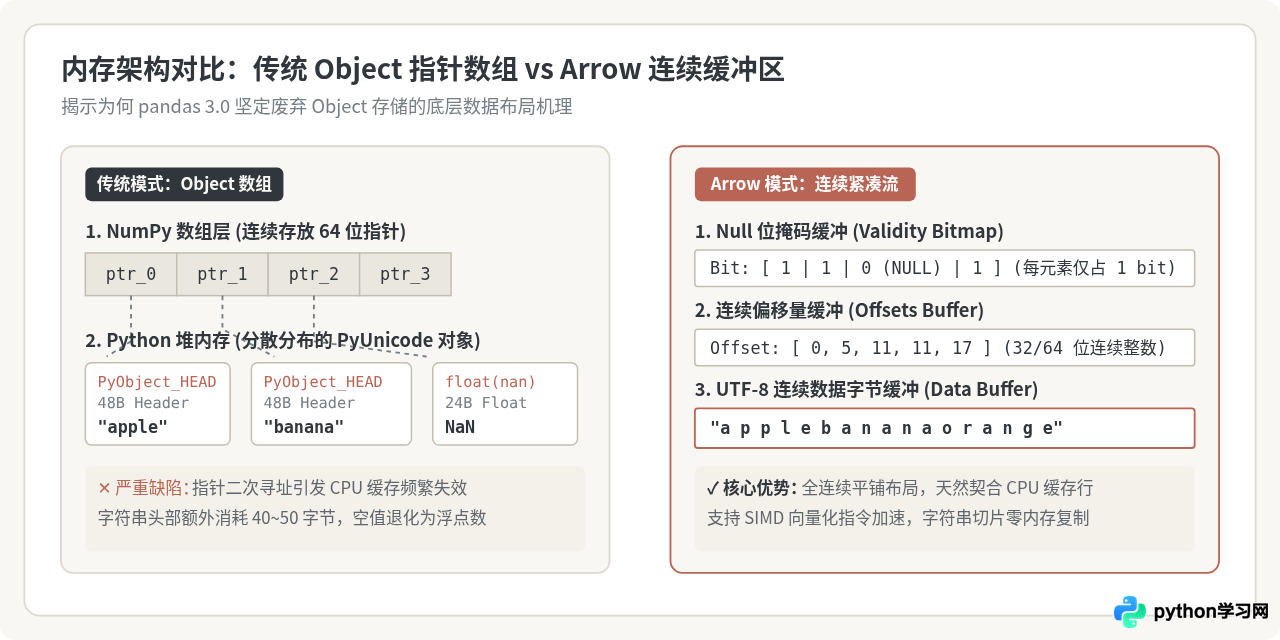
如图 1 所示,开启 infer_string=True 后,pandas 将底层数据托付给 Apache Arrow 连续列式存储格式。Arrow 采用结构严谨的三级连续缓冲区:
- Null 位掩码(Validity Bitmap):用 1 个 bit 记录一个位置是否有效(1 为正常值,0 为 NULL),8 个元素仅占用 1 个字节,实现了严密且轻量的空值追踪。
- 连续偏移量数组(Offsets Buffer):按顺序记录每个字符串在数据区中的起始和终止字节位置。
- 数据字节流(Data Buffer):所有字符串的 UTF-8 编码字节紧凑拼合成一块完全连续的内存区。
得益于这种连续平铺的内存布局,切片操作仅需调整偏移量而无需分配新内存(零拷贝),现代 CPU 还可以直接使用 SIMD(单指令多数据)向量化指令并行扫描文本,带来质的飞跃。
三、详细实操:三种开启路径与类型验证
在真实的工程项目中,根据业务调用场景的不同,建议选用适合的开启路径:
路径 A:应用入口与单脚本全局注入
适用于常规脚本、数据分析清洗流程或独立微服务应用。在业务初始化的配置模块中显式执行:
import pandas as pd

# 在程序启动阶段配置
pd.options.future.infer_string = True

# 构造测试数据
df = pd.DataFrame({
    "user_id": [1001, 1002, 1003],
    "username": ["alice", "bob", "charlie"],
    "city": ["Beijing", None, "Shanghai"]
})

print(df.dtypes)username string[pyarrow_numpy]
city string[pyarrow_numpy]
dtype: object
可以看到,username 与 city 均不再是 object,而是明确推断为 string[pyarrow_numpy](如果系统配置了不同后端,可能显示为 string[pyarrow])。
路径 B:环境变量无侵入注入(推荐用于 CI/CD 与 Jupyter)
如果你不希望侵入现有业务代码,或者要在自动化测试流水线中验证所有用例对 3.0 的适配情况,可以通过环境变量在启动 Python 进程前注入:
# Linux / macOS 终端或 CI 构建脚本中
export PANDAS_FUTURE_INFER_STRING=1
python your_pipeline.py

# 或者针对单次运行注入
PANDAS_FUTURE_INFER_STRING=1 pytest tests/
该环境变量由 pandas 底层直接读取,在模块初始化时就会自动将 pd.options.future.infer_string 设定为 True。
路径 C:通过 pytest fixture 局部隔离验证
如果项目规模庞大,需要逐步对各个子模块进行适配,可以在测试套件的 conftest.py 中定义 fixture,精确控制启用范围:
# tests/conftest.py
import pytest
import pandas as pd

@pytest.fixture(autouse=True)
def enable_infer_string():
    # 测试开始前启用 3.0 字符串推断
    original = pd.options.future.infer_string
    pd.options.future.infer_string = True
    yield
    # 测试结束后还原,避免污染其他未适配模块
    pd.options.future.infer_string = original
四、开启后的直接收益:内存缩减与向量化加速
提前开启 infer_string 不仅是为未来的 pandas 3.0 做准备,在当前的 pandas 2.3 中也能带来立竿见影的性能收益:
| 测试维度 | 未开启 (默认 Object) | 开启后 (Arrow 字符串) | 实测改善与收益 |
|---|---|---|---|
| 内存占用 (100万行字符列) | 约 145 MB ~ 220 MB | 约 42 MB ~ 58 MB | 内存减少 65% ~ 75%,极大缓解 OOM |
字符串包含判定 (.str.contains) |
逐行 Python 解释器调用 | C++ Arrow 原生内核向量化 | 运行速度提升 3x ~ 8x |
分组聚合与排序 (groupby/sort) |
哈希指针比对,高开销 | 紧凑二进制缓冲区直接比对 | 计算吞吐提升 2x ~ 5x |
| 空值一致性 | None、np.nan 与字符串混杂 |
统一位掩码表示缺失值 (pd.NA) |
消除浮点型 NaN 导致的莫名类型推断 |
五、适配 3.0 必查的 4 个潜在代码断点
虽然 Arrow 字符串保持了绝大部分高层 API(如 .str 访问器)的向后兼容,但底层类型的改变仍会击穿某些假设“字符串必定是 object”的历史代码。在开启 infer_string 后,必须重点排查以下 4 个断点:
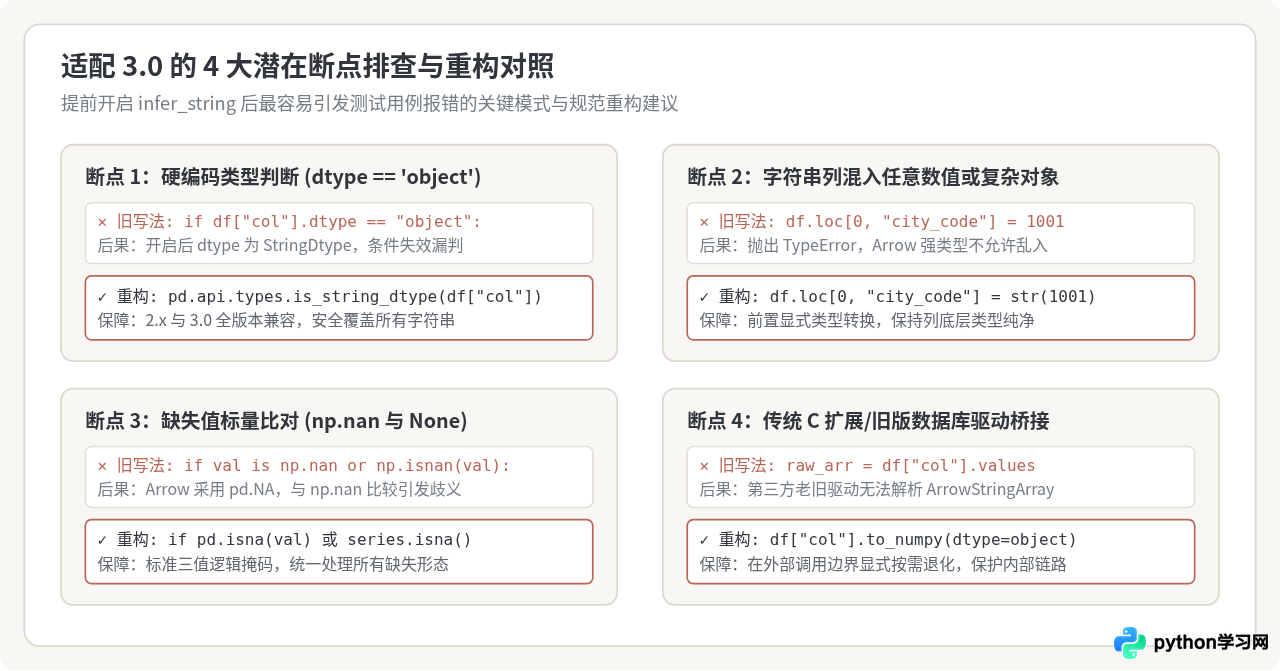
断点 1:硬编码的类型检查逻辑
在旧项目中,很多自动化数据探查或特征工程逻辑会通过 df[col].dtype == "object" 来筛选所有字符串列。在开启 infer_string 后,该列的 dtype 变为 StringDtype,等于 "object" 的判断将直接返回 False,导致逻辑被彻底跳过。
改用 pandas 官方提供的类型检测工具函数 pd.api.types.is_string_dtype(),它既能识别旧的 object 字符串,也能完美识别新的 Arrow 字符串,具备极高鲁棒性:
# 错误写法(在 pandas 3.0 中失效):
string_cols = [c for c in df.columns if df[c].dtype == "object"]

# 正确写法(全版本通用兼容):
string_cols = [c for c in df.columns if pd.api.types.is_string_dtype(df[c])]
断点 2:向字符串列动态混入非文本标量
旧版 object 列允许随意存放不同类型的值。例如有些代码在遇到特殊情况时,会执行 df.loc[0, "code"] = 9999 或存入一个自定义字典。在开启 infer_string 后,Arrow 列强制保持数据同构,向纯文本列存入整型或复杂对象将立即触发 TypeError 或类型强制转换错误。
修复策略:在赋值前必须显式转换类型(如 str(9999)),或者如果该列确实需要承载异构对象,应在构造时显式声明 dtype="object"。
断点 3:缺失值标量比对与判空方式
在旧的 object 列中,缺失值常常是 np.nan(浮点型)或者 None。开发者如果直接写 if val is np.nan: 或者调用 np.isnan(val),在处理 Arrow 字符串列时会遇到问题,因为此时空值表现为标量 pd.NA。
# 隐患写法:
import numpy as np
np.isnan(df["city"].iloc[1])  # 可能抛出 TypeError: ufunc 'isnan' not supported

# 规范写法:
df["city"].isna().iloc[1]       # 或 pd.isna(df["city"].iloc[1]),完全安全
断点 4:与第三方遗留驱动及 C 扩展对接
部分老旧版本的数据库 ORM、特定版本的机器学习库或基于 Cython 编写的内部 C 扩展,在调用 df["col"].values 时预期拿到的是一个纯粹的 NumPy Python 对象指针数组(np.ndarray of PyObject*)。而 Arrow 列返回的是 ArrowStringArray,这可能导致老扩展报出 ValueError: Buffer dtype mismatch。
修复策略:在将数据移交给外部不受控的第三方库前,如果外部库尚未支持 Arrow,可显式调用 df["col"].to_numpy(dtype=object) 进行按需桥接,既保证了内部流程的高性能,又兼顾了对外兼容。
六、工程落地与全景迁移演进路径
从 pandas 2.3 顺利过渡到 3.0,最佳实践不是等版本发布后再仓促应对,而是建立有序的“双轨验证”闭环:
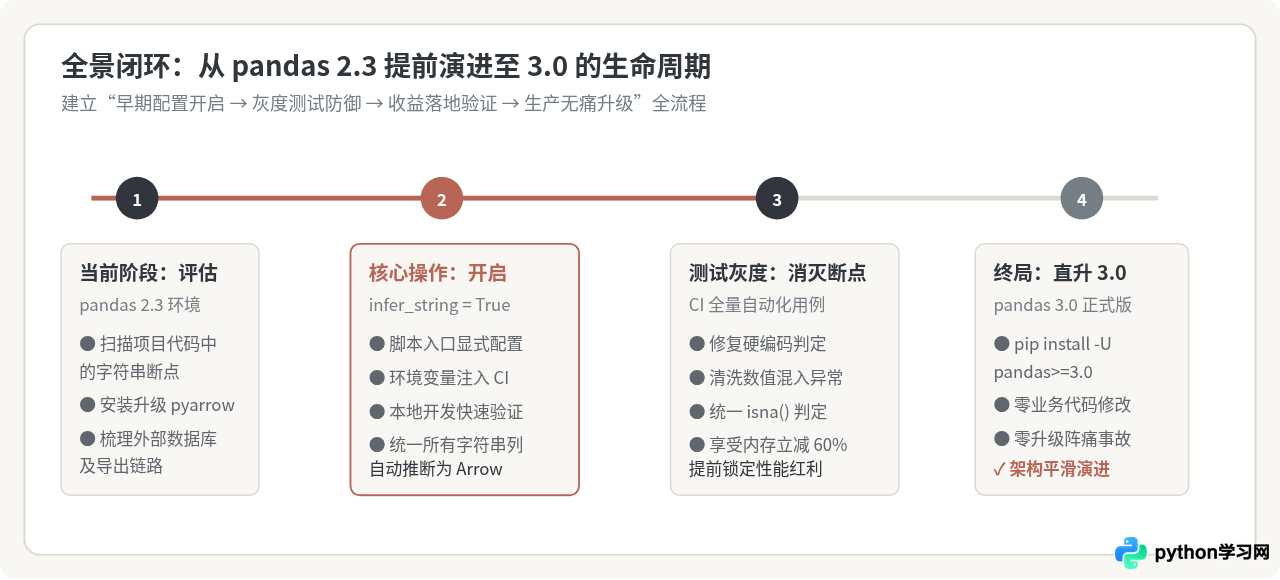
推荐按照以下四个阶段稳步推进:
- 基线排查阶段:使用代码搜索工具全文检索项目代码中的
dtype == 'object'、np.isnan以及对文本列就地赋予非字符串标量的不规范模式,统一重构为官方推荐写法。 - CI 环境变量试跑:在 GitHub Actions、GitLab CI 等持续集成流水线中,新增一个矩阵任务(Matrix Job),设置
PANDAS_FUTURE_INFER_STRING=1运行测试集,提前捕获由于底层类型变动导致的测试失败。 - 预发环境灰度验证:在测试环境与预发布服务中开启该选项,观察内存水位线与 CPU 利用率的变化,确认数据导出、入库等外部接口工作稳定。
- 3.0 零成本平替:当 pandas 3.0 正式发布时,由于代码库中的断点已在 2.3 阶段全部清除,只需直接升级包版本(
pip install -U pandas>=3.0),业务逻辑无需任何改动即可实现无缝衔接。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









