

NumPy2.4怎么改善自由线程Python支持?
深入解析NumPy 2.4如何改善自由线程Python(Python 3.13t/3.14t)支持,涵盖底层架构演进、弃用不安全属性、C API线程安全重构、环境配置验证与多线程并行最佳实践。
一、自由线程 Python 与 NumPy 的演进背景
自由线程 Python(Free-threaded CPython,即 PEP 703 提出的无全局解释器锁构建)彻底移除了 CPython 运行时的全局解释器锁(GIL)。在传统 Python 环境下,无论机器拥有多少物理核心,同一时刻仅能执行一个 Python 字节码线程;而在自由线程构建(构建标签通常带有 t,如 python3.13t)下,多个线程能够真正并行占用不同的 CPU 核心。
NumPy 自 2.1 版本开始提供实验性的自由线程支持,但初期的支持主要集中在让核心模块能够在无 GIL 模式下通过编译并加载。随着 NumPy 2.4 的发布,重点转向了深层次的并发安全加固与生态打通:修复多线程并发下的隐式数据竞态、规范内部内存元数据修改,并适配支持 Python 3.11 至 3.14 的完整生命周期。
二、NumPy 2.4 改善自由线程支持的关键技术举措
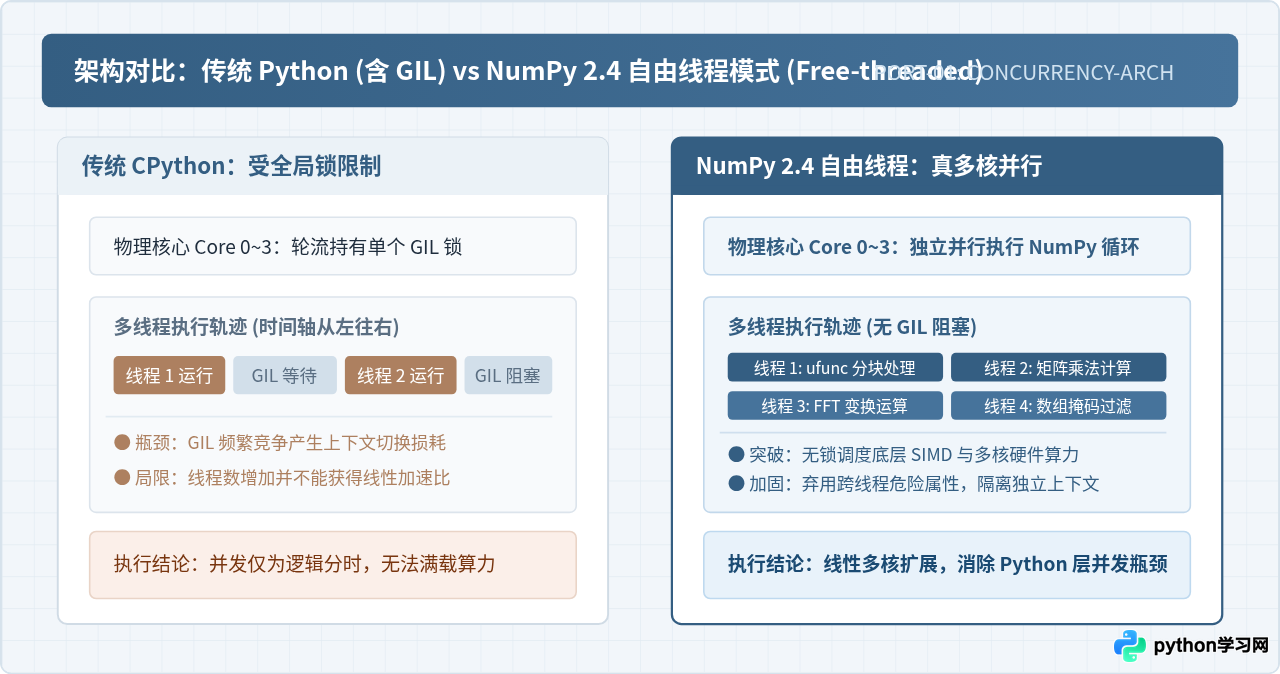
移除 GIL 意味着任何没有被同步机制保护的共享内存和全局状态都可能暴露在竞态条件(Race Condition)之下。NumPy 2.4 并非仅仅去掉编译锁,而是针对多线程高危场景进行了系统性加固:
1. 弃用直接修改 .strides 属性
在历史版本的 NumPy 中,高级开发者可以直接为数组的 arr.strides 赋值以改变内存步长和维数映射。但在自由线程环境下,若一个线程在读取数组或进行通用函数(ufunc)运算的同时,另一个线程正在修改该数组的 strides,底层 C 循环将依据不一致的步长在物理内存中寻址,导致严重的数据错乱甚至解释器崩溃(Segmentation Fault)。
NumPy 2.4 正式将直接修改 .strides 标记为已弃用(Deprecated)。用户如需构建特殊步长视图,必须使用 np.lib.stride_tricks.as_strided 或 np.lib.stride_tricks.strided_window_view 生成全新的不可变视图,确保底层内存描述元数据在并发读写时的不可变性。
2. C API 与 ArrayMethod 调度体系的线程安全化
NumPy 2.4 引入了全新的 PyUFunc_AddLoopsFromSpec C 接口,并基于 ArrayMethod API 重构了循环注册与分发机制。在过去,扩展库注册自定义数据类型(User Dtypes)和通用函数循环时,隐式依赖 GIL 保护全局函数表;而在 2.4 中,ArrayMethod 实现了无锁读取与线程安全初始化,下游库(如 SciPy、PyTorch 及各类领域专用扩展)可以在自由线程环境中安全加载并调用自定义数值循环。
3. 上下文状态(Context-Local State)的严格隔离
数值计算中频繁涉及浮点溢出、除以零处理(np.errstate)以及打印排版参数(np.set_printoptions)。在传统模式下,这些参数往往挂载在全局或线程静态字典中。NumPy 2.4 实现了上下文级别的状态隔离,每个线程在创建时拥有自己的上下文副本。同时,NumPy 2.4 针对 Python 3.14 规范做好了对 -Xthread_inherit_context=1 启动选项的适配支持,避免子线程错误掩码被父线程并发篡改。
4. 引入基于 pytest-run-parallel 的严格并发测试套件
代码是否真正支持自由线程,依赖自动化测试的覆盖。NumPy 2.4 构建管道全面整合了 pytest-run-parallel 与 Google ThreadSanitizer(TSan),针对核心 ufunc、随机数生成器(BitGenerator)以及排序算法(如快速排序、基数排序)实施持续的高并发压力验证,消除了内部引用计数与静态缓存表上的数据竞争。
三、环境准备与支持状态验证步骤
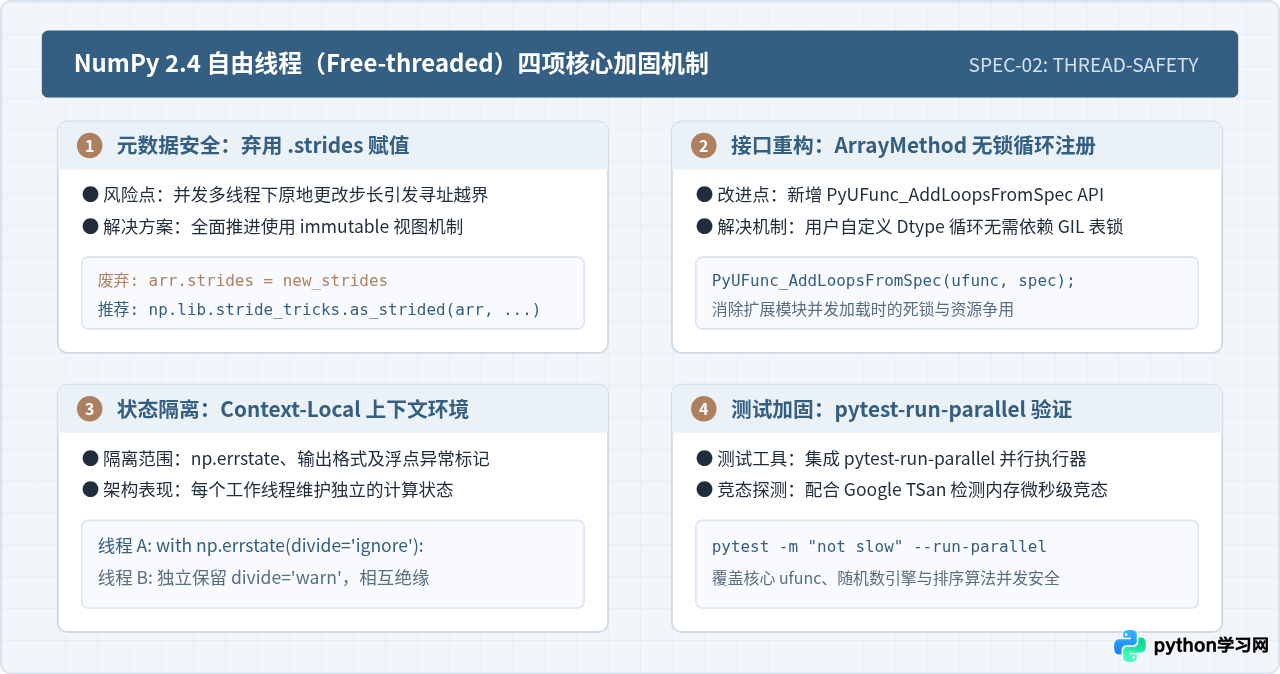
为了体验并使用 NumPy 2.4 的自由线程特性,需要配置一个支持自由线程的 Python 解释器,并安装匹配的 NumPy 轮子包。具体步骤如下:
步骤 1:安装自由线程 CPython(以 Python 3.13t 为例)
你可以通过系统包管理器、pyenv 或官方安装包获取自由线程版本。官方安装器中通常包含一个名为“Free-threaded Python”的可选安装项,安装后二进制文件名为 python3.13t。
# 确认自由线程解释器路径
which python3.13t

# 使用自由线程解释器创建虚拟环境
python3.13t -m venv .venv-nogil

# 激活虚拟环境
source .venv-nogil/bin/activate
步骤 2:验证当前运行时的 GIL 状态
在进入 Python 交互环境或脚本执行前,必须首先确认 GIL 处于完全关闭状态:
import sys

# Python 3.13+ 引入的 GIL 状态自省接口
if hasattr(sys, "_is_gil_enabled"):
    gil_status = sys._is_gil_enabled()
    print(f"当前 GIL 启用状态: {gil_status}")
    assert not gil_status, "警告: 当前未处于自由线程模式!"
else:
    print("当前 Python 版本过低,不支持自由线程探测。")
执行输出示例(自由线程模式下应输出 False):
当前 GIL 启用状态: False步骤 3:安装 NumPy 2.4 预编译 Wheel 包
NumPy 官方发布流程中提供了针对自由线程的 ABI 标签 Wheel(如 cp313-cp313t)。直接使用 pip 安装 2.4.0 或更高版本即可:
pip install --upgrade "numpy>=2.4.0"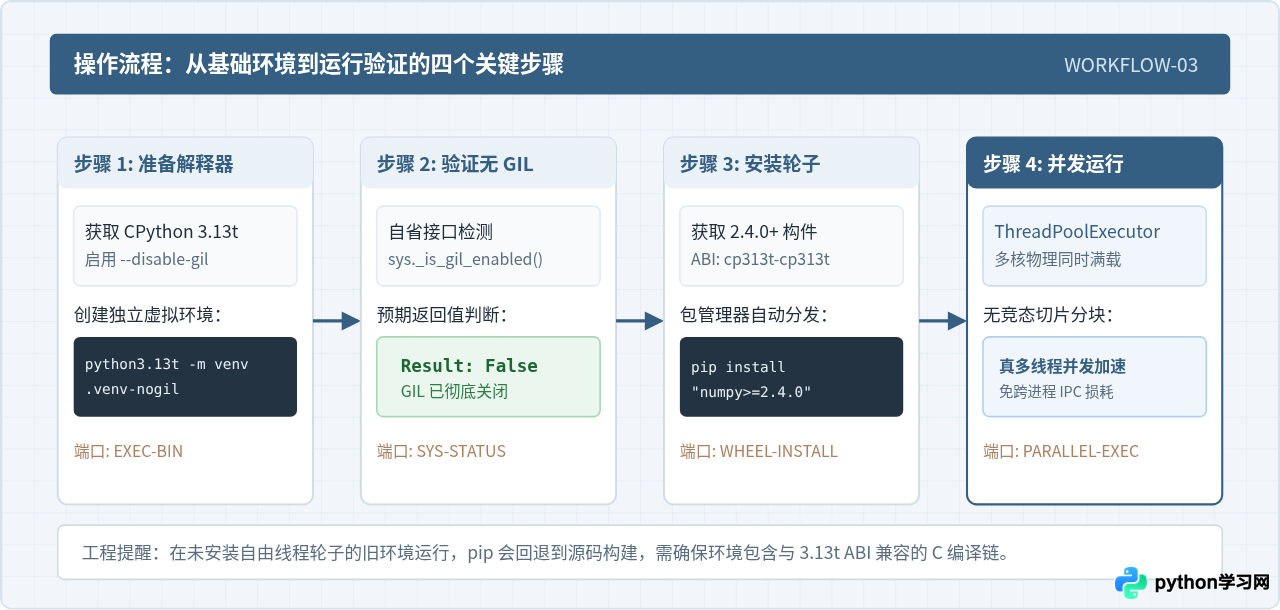
四、自由线程下的并发计算实践与推荐模式
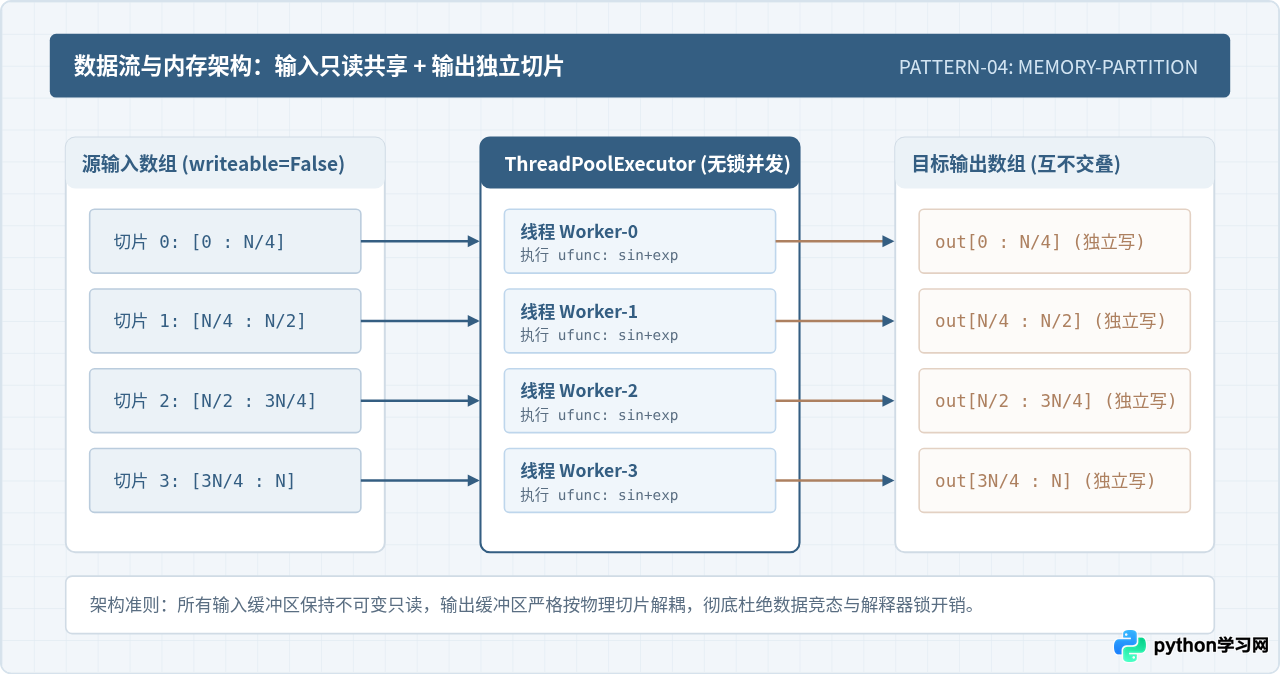
很多开发者误以为“自由线程开启后,现有的多线程代码就能自动获得安全性”。事实上,自由线程仅仅去除了阻塞并发的锁,共享可变数据的竞态条件仍需开发者自行规避。在 NumPy 2.4 中进行多线程加速时,推荐采用只读共享输入、非交叠切片写入的无竞态架构模式。
标准实战示例:分块数组多线程加速
以下为一个完整的计算示例,将一个大型二维浮点数组分块分发至各个工作线程,各线程并发调用 NumPy 的 SIMD 矢量运算函数,并将结果写入预分配的无交叠内存区间:
import sys
import numpy as np
from concurrent.futures import ThreadPoolExecutor

def worker_task(in_chunk: np.ndarray, out_chunk: np.ndarray) -> None:
    """
    工作线程执行函数:
    in_chunk 为输入数组的只读切片
    out_chunk 为预分配输出数组的对应独立切片
    """
    # 纯数值密集型计算 (在自由线程环境下多核真正并发执行)
    temp = np.sin(in_chunk) ** 2 + np.cos(in_chunk) ** 2
    np.exp(temp, out=out_chunk)

def run_parallel_benchmark():
    # 确认运行时状态
    is_nogil = getattr(sys, "_is_gil_enabled", lambda: True)() is False
    print(f"NumPy 版本: {np.__version__}, 自由线程激活: {is_nogil}")

    total_rows = 1_000_000
    cols = 64
    num_workers = 4

    # 1. 创建源数组并标记为只读,避免并发写污染
    data_input = np.random.randn(total_rows, cols).astype(np.float64)
    data_input.flags.writeable = False

    # 2. 预先分配目标输出数组
    data_output = np.empty_like(data_input)

    # 3. 计算每个线程的任务切片边界
    step = total_rows // num_workers
    tasks = []

    with ThreadPoolExecutor(max_workers=num_workers) as executor:
        for i in range(num_workers):
            start_idx = i * step
            end_idx = total_rows if i == num_workers - 1 else (i + 1) * step

            # 生成互不重叠的视图
            sub_in = data_input[start_idx:end_idx]
            sub_out = data_output[start_idx:end_idx]

            # 提交任务
            tasks.append(executor.submit(worker_task, sub_in, sub_out))

        # 等待所有任务完成
        for t in tasks:
            t.result()

    print(f"并行计算成功完成,结果数组形状: {data_output.shape}")

if __name__ == "__main__":
run_parallel_benchmark()在自由线程环境(python3.13t)下运行上述代码,通过系统监控工具(如 top 或 htop)可以直观观察到 4 个线程同时占用 4 个物理核心达到近 400% 的 CPU 使用率,且免除了传统多进程(multiprocessing)跨进程序列化(Pickle)与共享内存映射的额外开销。
五、注意事项与自由线程使用边界
NumPy 2.4 虽已大幅加固自由线程支持,但底层的 C 语言数组依然直接映射物理连续内存,开发者需要特别注意以下使用边界:
如果多个线程在没有加锁保护的情况下,同时向同一个
ndarray 的同一索引位置写入数据,或者一个线程写入的同时另一线程正在读取,会导致数据脏读、未定义数值结果,甚至破坏内存布局。NumPy 数组本身不提供细粒度的内置互斥锁。
基本数值类型(如
float64、int32)直接存储为连续的原始二进制字节,不涉及 Python 对象的生命周期。但 dtype=object 数组内部存储的是 Python 对象的指针。在自由线程环境下,Python 对象本身的引用计数虽然由停用偏向引用计数(Biased Reference Counting)或原子操作管理,但对数组内对象的属性并发修改依然是非线程安全的,务必避免在多线程中混用 dtype=object 数组。
传统的旧接口
np.random.seed() 与全局随机状态是线程间竞争的常见源头。在自由线程中,强烈建议使用现代的 np.random.default_rng(),并为每个并发线程单独实例化独立的生成器或使用 SeedSequence.spawn 派生子流。
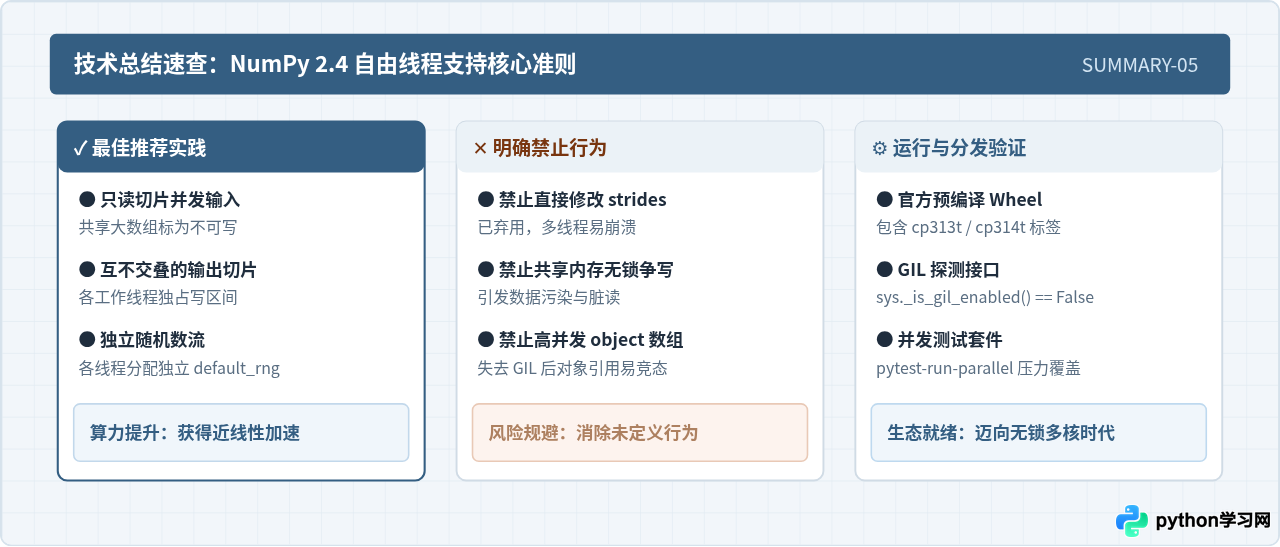
六、NumPy 2.4 自由线程特性总结速查
下表总结了 NumPy 2.4 在自由线程环境下的支持维度、行为变化与开发者操作准则:
| 特性 / 场景 | 传统 Python (含 GIL) | NumPy 2.4 自由线程模式 | 开发者应对准则 |
|---|---|---|---|
| 多线程 CPU 密集计算 | 受 GIL 串行化,单核 100% 瓶颈 | 多核真正并行执行,算力线性扩展 | 采用 ThreadPoolExecutor 替代繁重的多进程方案 |
| 修改 .strides 属性 | 直接赋值修改生效 | 正式弃用 (Deprecated) | 改用 as_strided 或 strided_window_view 创建新视图 |
| 自定义 Dtype 循环注册 | 隐式依靠 GIL 保证全局字典安全 | 通过 PyUFunc_AddLoopsFromSpec 实现无锁注册 |
下游 C 扩展开发者应迁移至 ArrayMethod 新规范 |
| 浮点状态 (np.errstate) | 线程间可能产生伪共享状态干扰 | Context-Local 严格隔离各线程状态 | 安全在局部线程内使用 with np.errstate(...) |
| 对象数组 (dtype=object) | 由 GIL 隐式避免大部分致命竞态 | 无 GIL 保护,并发读写极易竞态 | 多线程避免使用 object 数组,优先纯数值 dtype |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









