

Python核心语法速查:变量、循环与函数基础
针对Python核心语法的速查与实战手册,深度解析变量引用与动态类型、for与while循环流控机制,以及函数参数解构与LEGB作用域机制,提供完整的工程级内联图谱与避坑示例。
一、变量与动态类型系统
在 Python 中,变量并非用于盛放数值的固定“内存容器”,其本质是贴在堆内存对象上的引用标签(Names & References)。当执行赋值操作 x = 100 时,Python 解释器首先在堆区开辟空间创建整型对象 100,随后将当前命名空间中的标识符 x 指向该对象的内存地址。
1. 命名规范与动态类型判定
Python 采用动态类型判定机制:变量本身没有固定类型,其类型完全取决于所指向对象的类别。标识符必须严格遵守蛇形命名法(Snake Case),由小写字母、数字及下划线组成,且不能以数字开头或与系统保留关键字重名。
# 基础类型赋值与类型动态判定
item_count = 42               # int (整型)
unit_price = 19.99            # float (浮点型)
user_label = "sys_monitor"    # str (字符串)
is_active = True              # bool (布尔型)

# 推荐:使用 isinstance 进行运行时类型检查(支持继承链多态)
if isinstance(item_count, int):
print("校验通过:item_count 为整型")2. 核心分界:不可变对象与可变对象
理解 Python 数据结构的关键在于区分不可变对象(Immutable)与可变对象(Mutable)。这一区别直接决定了赋值传递、切片拷贝与函数传参时的行为逻辑:
| 对象分类 | 包含类型 | 内存特征 | 修改操作后果 |
|---|---|---|---|
| 不可变对象 (Immutable) | int, float, str, tuple, frozenset, bytes |
对象创建后内部状态固化,其值与内存地址不可变 | 任何“修改”操作都将引发新对象创建并重新绑定变量引用 |
| 可变对象 (Mutable) | list, dict, set, bytearray |
对象内部包含指针列表,可动态追加、替换或删除元素 | 允许就地修改(In-place mutation),内存地址 id() 保持不变 |
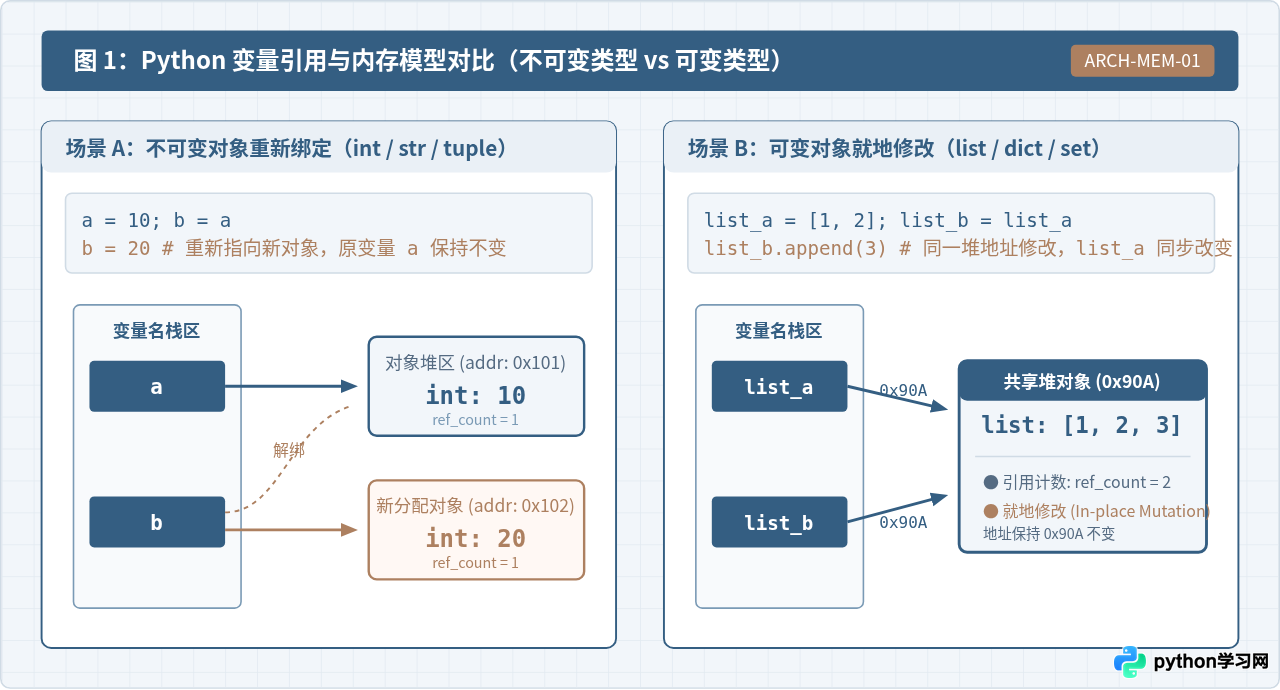
执行 list_b = list_a 仅仅是复制了指针,二者指向同一堆内存。若需要生成完全独立的副本,切勿直接赋值:
- 一维浅拷贝:使用
list_b = list_a.copy()或切片list_b = list_a[:]。 - 多层嵌套深拷贝:当列表内包含子列表或字典时,浅拷贝无法复制内层对象,必须显式调用
import copy; list_b = copy.deepcopy(list_a)。
二、循环结构与控制流
Python 提供了两种核心循环结构:基于迭代协议的 for ... in 循环,以及基于布尔状态判定的 while 条件循环。配合 break、continue 及特有的 else 子句,可以构建清晰严谨的流控逻辑。
1. for 循环与迭代工具链
在 Python 中,for 循环专为遍历可迭代对象(Iterable)而设计。尽量避免编写类似 C 语言风格的 for i in range(len(items)),而应优先使用 Pythonic 的解构与聚合内置函数:
records = ["200_OK", "404_NotFound", "500_ServerError"]

# 场景 A:同时获取索引与元素,使用 enumerate(seq, start=0)
for index, status in enumerate(records, start=1):
    print(f"条目 [{index}]: {status}")

# 场景 B:同步并行遍历多个等长序列,使用 zip()
endpoints = ["/api/auth", "/api/user", "/api/pay"]
for ep, st in zip(endpoints, records):
print(f"路由: {ep} -> 响应: {st}")条目 [2]: 404_NotFound
条目 [3]: 500_ServerError
路由: /api/auth -> 响应: 200_OK
路由: /api/user -> 响应: 404_NotFound
路由: /api/pay -> 响应: 500_ServerError
2. 循环控制与 else 判定逻辑
在循环体中,continue 用于立即终止当前迭代步并进入下一轮条件判定;break 则立即终止整个循环并跳转至循环体外部。尤其需要注意,Python 的 for 和 while 均支持 else 子句:只有当循环自然穷尽(即未触发 break)时,else 块才会执行。
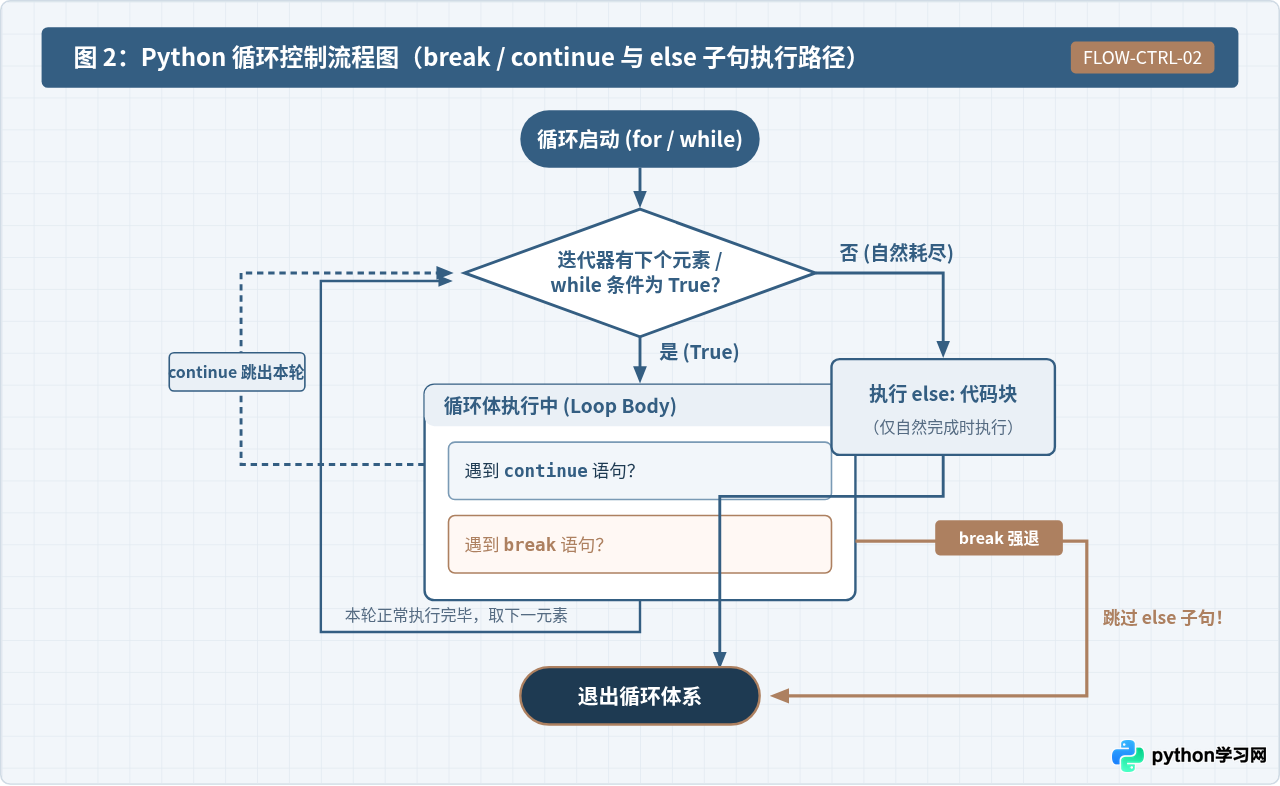
下面是一个标准的资源探测与兜底处理示例,展示了 for-else 结构在搜索逻辑中的经典用法:
target_port = 8080
scanned_ports = [22, 80, 443, 3306]

for port in scanned_ports:
    if port == target_port:
        print(f"匹配命中:发现服务运行在端口 {port}")
        break
else:
    # 仅在循环完整跑完且没有执行 break 时触发
print(f"检索完毕:目标端口 {target_port} 未在开放列表中,启动兜底配置")在直接遍历 for item in my_list: 的同时执行 my_list.remove(item),会导致底层迭代指针产生索引偏移,使得紧邻的下一个元素被无提示静默跳过。正确做法是使用列表推导式生成新容器,或对原列表的浅拷贝副本进行遍历:
# 正确做法:通过推导式过滤生成新列表
clean_data = [x for x in raw_data if x != "invalid"]
三、函数基础与参数解构
函数是 Python 实现逻辑抽象与代码复用的基本单元。通过 def 语句声明,配合严格的形参装载顺序与 *args、**kwargs 动态解构,可以编写出高度灵活且易维护的工程接口。
1. 签名顺序与解构机制
Python 函数的形参定义必须严格遵守以下声明序列:位置参数 → 默认参数 → 可变位置参数 (*args) → 命名关键字参数 → 可变关键字参数 (**kwargs)。若颠倒顺序,解释器将在语法解析阶段直接抛出 SyntaxError。
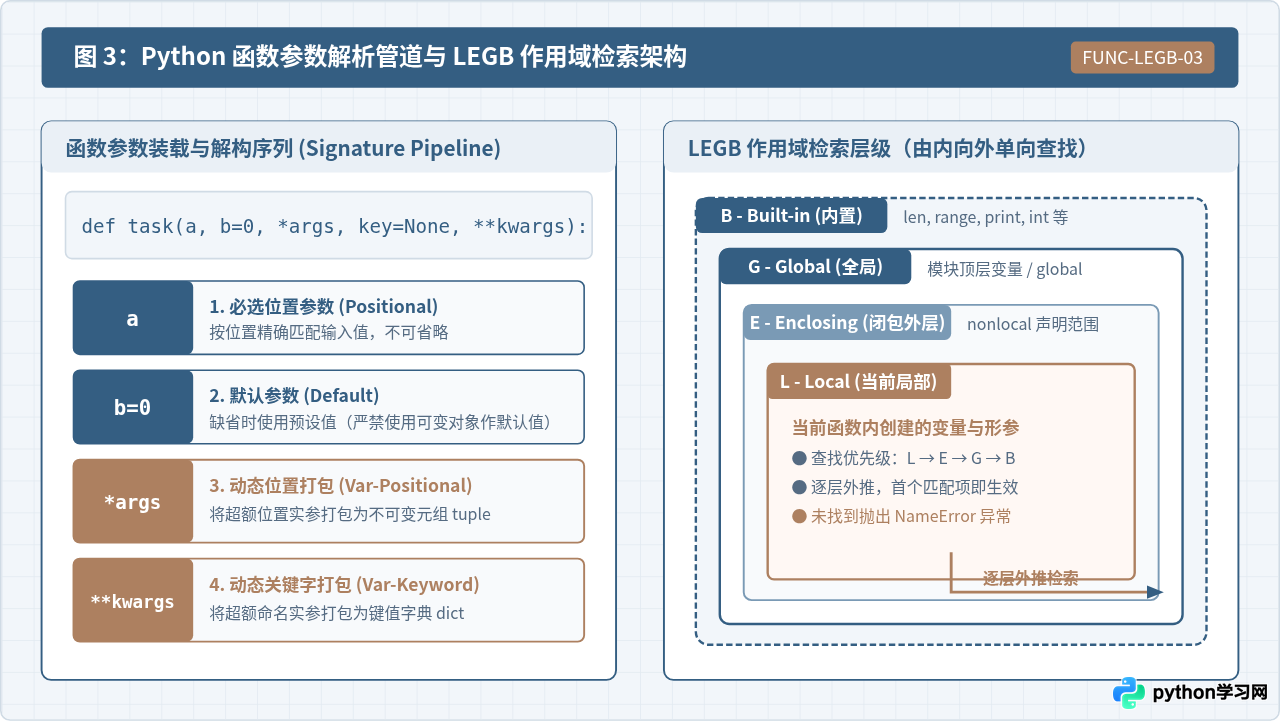
以下代码演示了多级参数组合与解构调用的规范实现:
def dispatch_job(job_name, timeout=30, *extra_tags, retry_limit=3, **env_vars):
    # 任务调度函数,验证形参打包机制
    print(f"执行作业: {job_name} | 超时: {timeout}s | 最大重试: {retry_limit}")
    print(f"附加标签元组 (*args): {extra_tags}")
    print(f"环境变量字典 (**kwargs): {env_vars}")

    # 多值返回:Python 本质将其打包为不可变元组 (Tuple) 返回
    return True, "SUCCESS"

# 函数调用与返回值解构赋值
status, message = dispatch_job(
    "backup_db",
    60,
    "prod", "nightly",
    retry_limit=5,
    CLUSTER="east-1", LOG_LEVEL="INFO"
)附加标签元组 (*args): ('prod', 'nightly')
环境变量字典 (**kwargs): {'CLUSTER': 'east-1', 'LOG_LEVEL': 'INFO'}
2. 作用域与 LEGB 逐级解析规则
在函数内部访问变量时,Python 解释器按照 L → E → G → B 的顺序由内向外单向查找标识符:
- L (Local - 局部作用域):当前函数内定义的变量与实参。
- E (Enclosing - 闭包外层函数):外部嵌套函数(如高阶函数包装器)中的作用域。
- G (Global - 全局作用域):当前模块文件顶层定义的变量。
- B (Built-in - 内置作用域):解释器内置函数与异常,如
len,range,Exception。
Python 中的默认参数只在模块加载并定义函数时求值一次,而不是在每次调用时重新创建。若使用 def add_item(val, container=[]),该列表对象将在所有调用之间持久共享,导致严重的交叉污染隐患:
# ❌ 错误示范:造成跨调用污染
def bad_append(val, target=[]):
    target.append(val)
    return target

# ✅ 工程标准范式:使用 None 作为哨兵值并在函数体内动态初始化
def safe_append(val, target=None):
    if target is None:
        target = []
    target.append(val)
    return target
四、核心语法速查对照与综合实践
为了便于日常编码快速定位语法细节,下表将变量、循环与函数的核心操作模式与标准写法进行了归纳:
| 核心语法维度 | 标准用法范式 | 关键机制与工程建议 |
|---|---|---|
| 变量深浅拷贝 | copy.deepcopy(obj) |
针对包含嵌套列表/字典的复合数据,必须进行深拷贝以切断内存引用。 |
| 序列带序号遍历 | for i, v in enumerate(seq, 1): |
解耦下标与内容访问,消除显式维护递增计数器 count += 1 的繁琐。 |
| 多列表配对循环 | for a, b in zip(list_a, list_b): |
以最短序列截断;若需补齐缺失值,改用 itertools.zip_longest。 |
| 带兜底检索循环 | for ... break ... else: |
消除外部额外的布尔标志变量 found = False,简化查找判断链路。 |
| 函数默认形参 | param=None + 内部 if param is None |
彻底避免可变对象跨会话持久化污染问题。 |
| 闭包修改外层变量 | nonlocal counter |
仅用于修改闭包外层(Enclosing)局部变量;修改全局变量使用 global。 |
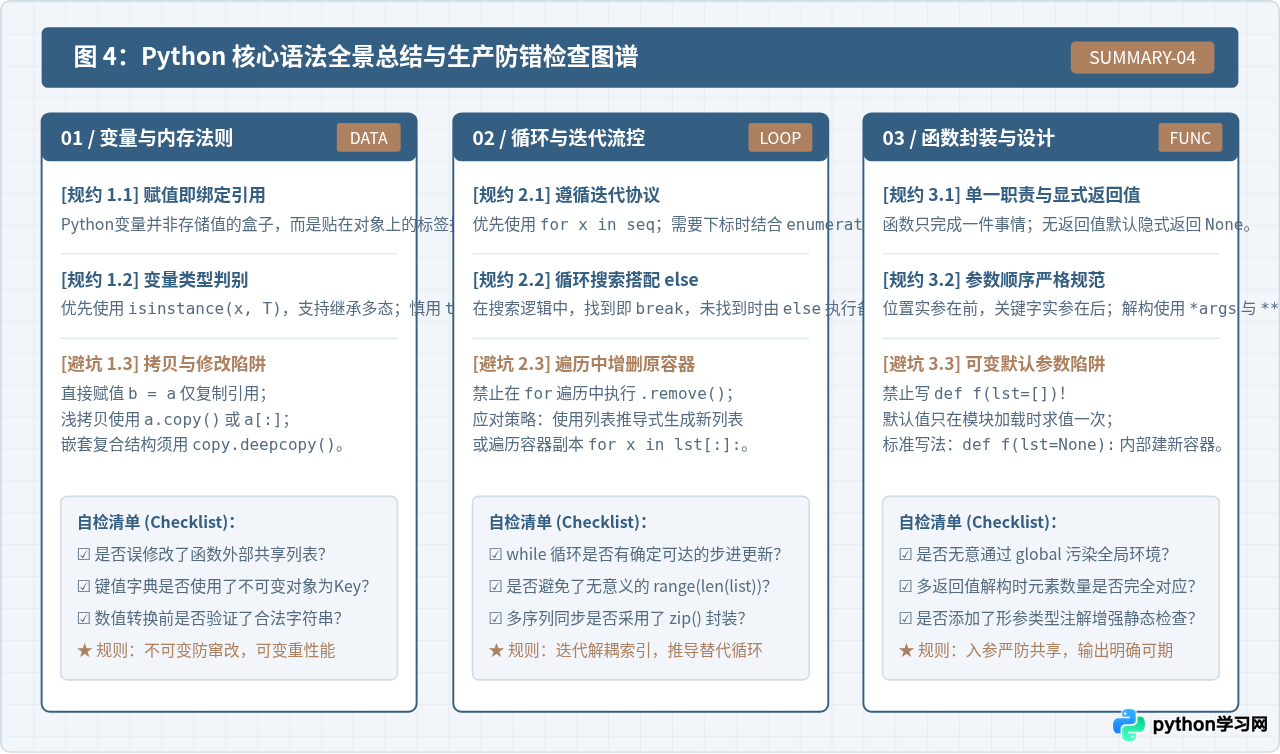
综合实践示例:数据管道解析与统计处理器
以下完整案例整合了可变字典状态管理、多重循环流控判定,以及带动态解构的函数定义,演示三者在实际业务场景中的协同工作方式:
def process_telemetry_batch(raw_payloads, filter_level="INFO", *required_keys, **options):
    # 批处理遥测数据:组合动态参数解构、for-else 校验与字典状态统计
    summary = {"processed": 0, "dropped": 0, "valid_records": []}
    strict_mode = options.get("strict_mode", False)

    for index, record in enumerate(raw_payloads, start=1):
        # 1. 验证级别过滤
        if record.get("level") != filter_level:
            summary["dropped"] += 1
            continue

        # 2. 检查是否包含所有必需字段(for-else 模式)
        for key in required_keys:
            if key not in record:
                if strict_mode:
                    print(f"告警:条目 [{index}] 缺少关键字段 '{key}',跳过该记录")
                summary["dropped"] += 1
                break
        else:
            # 所有 required_keys 均验证通过,未触发 break
            summary["processed"] += 1
            summary["valid_records"].append(record["id"])

    return summary

# 模拟业务输入流并执行调用
sample_data = [
    {"id": 101, "level": "INFO", "timestamp": 1698700100, "host": "srv-a"},
    {"id": 102, "level": "DEBUG", "timestamp": 1698700105, "host": "srv-b"},
    {"id": 103, "level": "INFO", "timestamp": 1698700110},  # 缺少 host
]

result = process_telemetry_batch(
    sample_data,
    "INFO",
    "id", "timestamp", "host",
    strict_mode=True
)

print("处理完成统计结果:", result)处理完成统计结果: {'processed': 1, 'dropped': 2, 'valid_records': [101]}
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









