

怎么使用Python Lock解决多线程数据竞争问题
深入浅出讲解在Python多线程并发场景下,如何使用threading.Lock互斥锁消除数据竞争问题。包含竞态条件底层字节码成因、with上下文管理器规范用法、RLock重入区别及死锁防范实战。
在 Python 多线程程序中,当多个线程并发读写同一个全局变量或共享数据结构(如累加计数器、扣减账户余额、追加公共列表)时,操作系统的抢占式调度会在代码执行的中间阶段强制进行上下文切换,导致写入覆盖并引发数据竞争(Race Condition)。解决该问题的标准做法是使用 Python 标准库 threading 模块中的互斥锁(threading.Lock),将操作共享资源的临界区代码封装起来,确保同一时刻仅有一个线程持有锁并执行修改。本文将通过底层字节码还原数据竞争的产生过程,并详细演示 threading.Lock 的标准步骤、with 上下文生命周期、超时非阻塞控制与死锁规避策略。
一、数据竞争的本质:为什么看似简单的代码会出错?
许多开发者在编写多线程程序时,常误以为单行递增操作(如 count += 1)是天然安全的。然而在并发测试中,如果启动 10 个线程,每个线程各对全局变量累加 100,000 次,最终统计得到的累计值往往远低于理论上的 1,000,000,且每次运行的输出结果均不相同。这种由于多线程执行时序交错导致结果取决于“谁跑得快”的不确定性错误,就是典型的数据竞争(Race Condition)。
数据竞争之所以发生,是因为看似简洁的 count += 1 在 CPython 解释器中并不是一个原子操作(Atomic Operation)。借助 Python 内置的 dis 模块反编译该表达式,可以看到它在底层由至少四条字节码指令协同完成:
# count += 1 对应的 CPython 底层字节码指令序列
1. LOAD_GLOBAL              0 (count)     # 从全局符号表中读取当前 count 值压入线程操作数栈
2. LOAD_CONST               1 (1)         # 将常量 1 压入栈顶
3. BINARY_OP                0 (+)         # 弹出两个值执行加法运算,将新值留存栈顶
4. STORE_GLOBAL             0 (count)     # 将运算结果写回全局变量 count 的内存地址
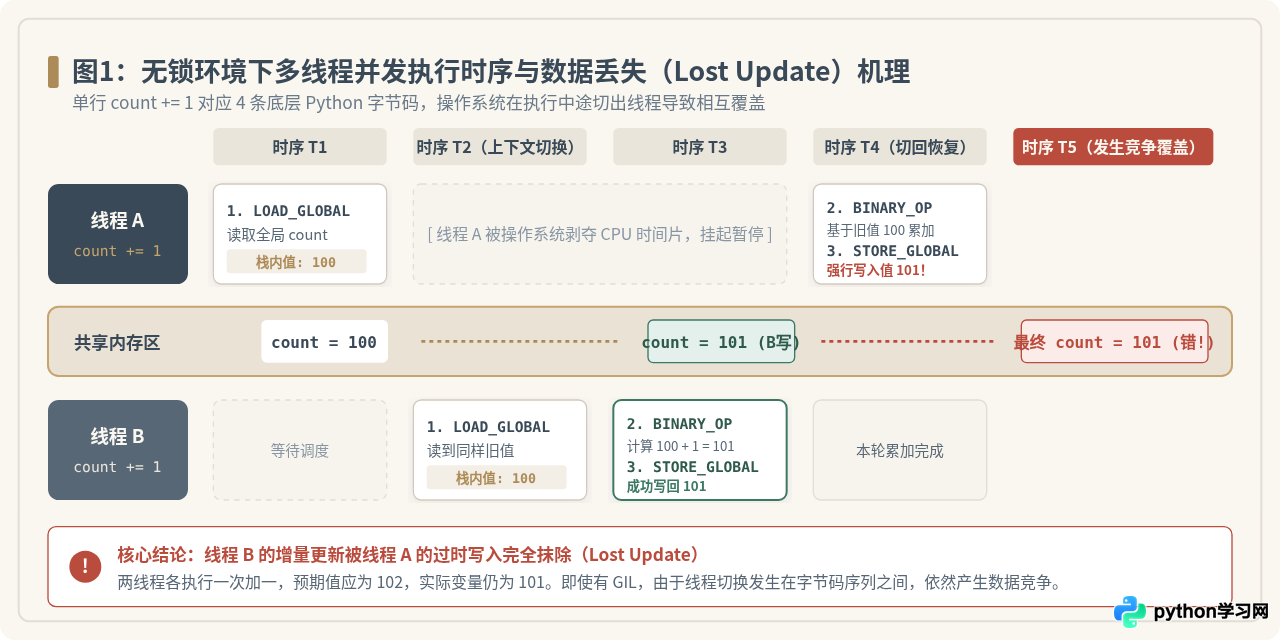
CPython 采用抢占式线程调度,虽然解释器内部存在全局解释器锁(GIL),但 GIL 会在线程执行了指定数量的字节码后主动释放,以便其他就绪线程轮换执行。当线程 A 执行完 LOAD_GLOBAL 读到数值 100 后,时间片耗尽并被操作系统切出;随后线程 B 获得调度,完整执行了读取、加法和写回,将内存中的 count 更新为 101。此时线程 A 恢复执行,它继续使用自身私有栈里记录的旧值 100 执行加法得到 101,并强行写回全局变量。最终,线程 B 所做的一次累加操作被完全抹除,造成更新丢失(Lost Update)。
下面的代码完整复现了上述无锁状态下的数据竞争问题:
import threading

# 全局共享的可变状态
counter = 0

def unsafe_worker():
    global counter
    for _ in range(100000):
        counter += 1  # 存在数据竞争的临界区操作

threads = []
for _ in range(10):
    t = threading.Thread(target=unsafe_worker)
    threads.append(t)
    t.start()

for t in threads:
    t.join()

print(f"预期值: 1000000, 实际计算结果: {counter}")预期值: 1000000, 实际计算结果: 684210
注:实际数值在每次执行时随机变动,这证明了缺乏同步机制时多线程并发的不可预测性。
二、使用 Python Lock 的基本步骤与推荐范式
要彻底消除数据竞争,核心思路是构建临界区(Critical Section)——即保证在任何给定的时刻,全局只允许一个线程处于读取并修改共享资源的代码块中。Python 标准库 threading 模块提供了原生的 Lock(互斥锁)对象来达成这一目标。
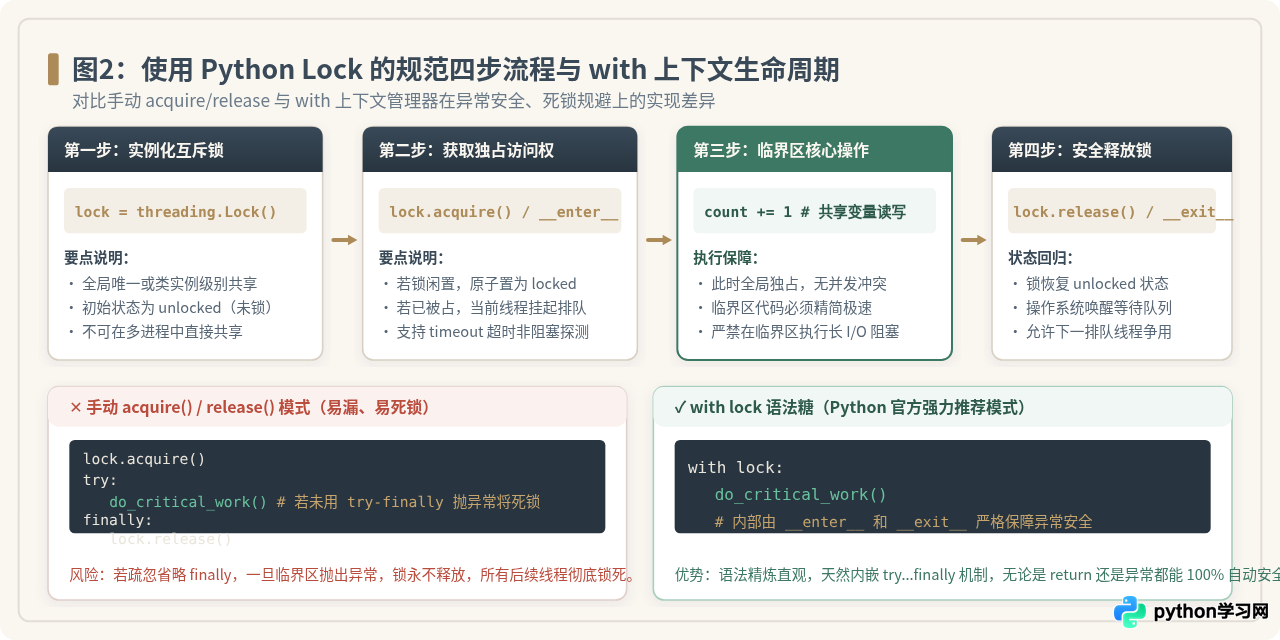
1. 标准四步操作流程
- 创建互斥锁对象:在线程外部调用
lock = threading.Lock()实例化锁,通常将其作为模块全局对象或宿主类的成员属性。 - 进入临界区前获取锁:线程调用
lock.acquire()。如果此时锁是空闲状态,线程立即持有锁并将锁置为已锁定;若已被其他线程占用,当前线程自动被操作系统阻塞挂起,进入休眠排队状态。 - 在临界区内操作数据:独占访问共享数据,完成业务计算或状态写入。
- 退出临界区后释放锁:调用
lock.release()将锁恢复为空闲状态,由操作系统的线程调度器自动唤醒排队中的下一个就绪线程。
2. 核心语法推荐:with 上下文管理器
在实际工程开发中,应严格避免手动调用 lock.acquire() 和 lock.release()。若临界区内部因数据校验失败抛出未捕获异常、触发了 return、或者发生逻辑中断,手写的 release() 将被跳过,导致锁永远处于已占用状态,整个进程内的后续并发线程全部永久卡死。
Python 互斥锁实现了上下文管理协议(Context Manager)。使用 with lock: 结构,Python 解释器会在进入代码块时自动执行 __enter__(调用 acquire),并在代码块退出时(无论正常执行完毕还是产生异常)自动在 __exit__ 中调用 release(),从而在语言底层提供 100% 的异常安全保证。
使用 with lock: 对并发累加程序进行修复后的完整正确代码如下:
import threading

counter = 0
# 1. 实例化全局共享的互斥锁
counter_lock = threading.Lock()

def safe_worker():
    global counter
    for _ in range(100000):
        # 2 & 3 & 4. 通过上下文管理器安全加锁、更新与自动释放
        with counter_lock:
            counter += 1

threads = []
for _ in range(10):
    t = threading.Thread(target=safe_worker)
    threads.append(t)
    t.start()

for t in threads:
    t.join()

print(f"加锁后计算结果: {counter}")加锁后计算结果: 1000000
注:多次反复运行,结果均精准等于 1,000,000,数据竞争彻底消除。
三、进阶控制:超时机制与非阻塞尝试(Try-Acquire)
默认情况下,lock.acquire() 或 with lock: 都是阻塞式(blocking=True)的。这意味着如果锁正被另一个耗时较长的线程持有,当前线程将被无期限挂起,直到锁被释放。在对响应时间要求严苛的场景(如 Web 请求处理、UI 主线程交互)中,无限制的等待可能造成系统吞吐量严重下降甚至假死。
为了应对这种场景,acquire() 方法提供了两个关键控制参数:
blocking=False(非阻塞尝试):线程在调用瞬间立即检查锁的状态。如果锁可用,成功加锁并返回True;若已被占用,不再等待而是立即返回False。这允许线程执行降级方案,例如将任务推入重试队列或直接告知用户系统繁忙。timeout=<float>(带超时的阻塞):指定线程最长愿意等待的秒数。在超时阈值到达前若锁释放,则成功获取并返回True;若超时仍未获取,则返回False并恢复向下执行。
import threading
import time

resource_lock = threading.Lock()

def responsive_task(task_id: int):
    # 尝试获取锁,最多等待 1.5 秒,超时则放弃并降级处理
    acquired = resource_lock.acquire(blocking=True, timeout=1.5)
    if acquired:
        try:
            print(f"[任务 {task_id}] 成功获取锁,开始处理关键资源")
            time.sleep(1.0)  # 模拟业务操作
        finally:
            resource_lock.release()
            print(f"[任务 {task_id}] 任务完成,锁已释放")
    else:
        # 超时降级逻辑,不会卡死线程
        print(f"[任务 {task_id}] 获取锁超时,执行降级分流方案")
四、常见陷阱与死锁防范:Lock 与 RLock 的选择
引入锁虽然消除了数据竞争,但也引入了新的并发风险——死锁(Deadlock)。死锁发生时,一个或多个线程处于永远等待对方释放锁的僵死状态,导致整个程序停摆。在工程实践中,必须重点防范以下两大典型死锁场景。
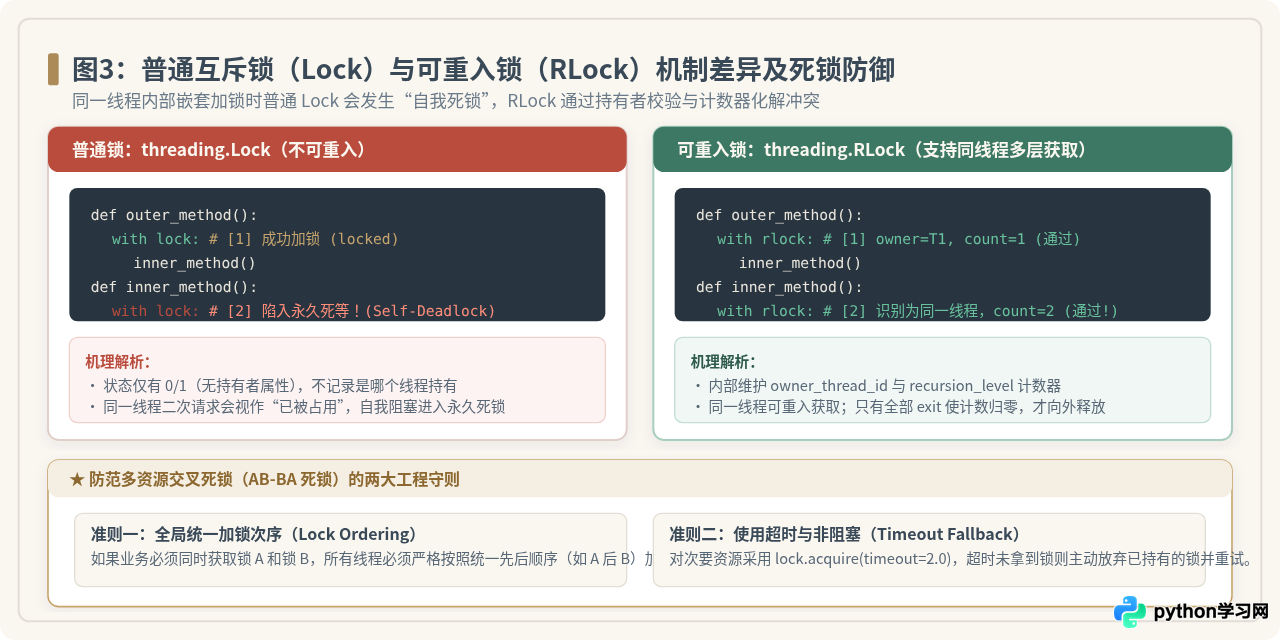
1. 同一线程内部嵌套调用导致的自我死锁:改用 threading.RLock
Python 标准的 threading.Lock 是不可重入互斥锁。它只维护一个二元状态(0 表示空闲,1 表示占用),并不记录持有锁的具体线程 ID。如果同一个线程在尚未释放锁的情况下,由于函数嵌套调用或递归执行再次请求该锁,Lock 会将其误判为冲突请求,导致该线程被自己阻塞,从而陷入永远无法醒来的自我死锁(Self-Deadlock)。
解决此类问题的标准做法是使用可重入锁(threading.RLock)。RLock 在内部记录了当前持有锁的线程标识符(Owner Thread ID)以及一个递归重入计数器(Recursion Level):
- 如果当前线程就是锁的拥有者,再次调用
acquire()不会挂起,而是直接通过并将计数器加 1; - 每次退出
with块或调用release()时,计数器相应减 1; - 只有当计数器完全归零时,锁才真正回归空闲状态并向其他并发线程开放。
2. 多资源交叉竞争引发的循环等待(AB-BA 死锁)
当业务逻辑需要同时保护多组独立资源时,极易发生交叉锁定死锁。例如:
- 线程 1 先获取了
lock_A,正准备申请lock_B; - 与此同时,线程 2 先获取了
lock_B,正准备申请lock_A; - 两个线程各持有一把锁并阻塞等待对方释放另一把锁,形成闭环等待。
防范规则:工程中必须确立全局统一加锁顺序原则(Lock Ordering)。如果多个锁需要同时持有,所有线程必须严格按照统一的顺序(例如始终按锁对象创建的哈希值、字母序或资源 ID 先锁 A 后锁 B)获取,绝不能逆序申请。
3. 锁的粒度控制平衡
锁的粒度指临界区所保护的代码范围:
- 粒度过粗:如果将耗时的网络 HTTP 请求、文件磁盘读写或复杂数学计算也一并包进
with lock:中,多线程并发将彻底退化为低效的单线程串行执行。 - 粒度过细:过度将代码拆解为微小锁块,不仅会因为频繁的上下文切换与锁竞争显著损耗性能,还可能破坏复合业务流程(如“先查余额后扣款”)的整体原子性。
- 工程准则:只加锁纯内存中的共享变量读写语句。所有耗时的 I/O、格式转换和独立运算必须在进入
with lock:之前或退出之后执行。
五、澄清核心误区:有 GIL 为什么还需要 Lock?
在讨论 Python 并发时,初学者最常产生的困惑是:“CPython 解释器已经内置了 GIL(全局解释器锁),保证同一时刻只有一个线程在运行 Python 代码,为什么还会出现数据竞争?”
理解这一点的关键在于区分解释器自身的内存安全与应用程序层面的业务数据一致性:
| 对比维度 | GIL(全局解释器锁) | threading.Lock(应用互斥锁) |
|---|---|---|
| 保护对象 | CPython 解释器自身的 C 层内部数据结构(引用计数、垃圾回收、对象管理) | 用户自定义的业务共享变量(计数器、字典、订单状态、账户余额) |
| 控制级别 | 保证单个底层字节码(Bytecode)执行时的原子性 | 保证由多个字节码组成的完整复合操作或临界区业务的原子性 |
| 切换时机 | 根据指令时钟强制轮转(每执行一段指令或遇到 I/O 就释放并切换) | 开发者主动控制,在退出 with 语句前绝不被其他线程侵入 |
| 职责归属 | 解释器系统自动管理,开发者不可直接干预 | 由应用开发者根据多线程共享状态显式声明与管理 |
如第一节所示,单行 Python 代码 count += 1 包含四条字节码。GIL 仅仅保证执行 LOAD_GLOBAL 这单条指令时解释器自身不会崩溃,但它允许在 LOAD_GLOBAL 和 STORE_GLOBAL 之间切换线程。因此,GIL 绝不能替代应用层互斥锁,多线程共享可变状态必须显式使用 threading.Lock 进行保护。
六、总结与选型决策指南
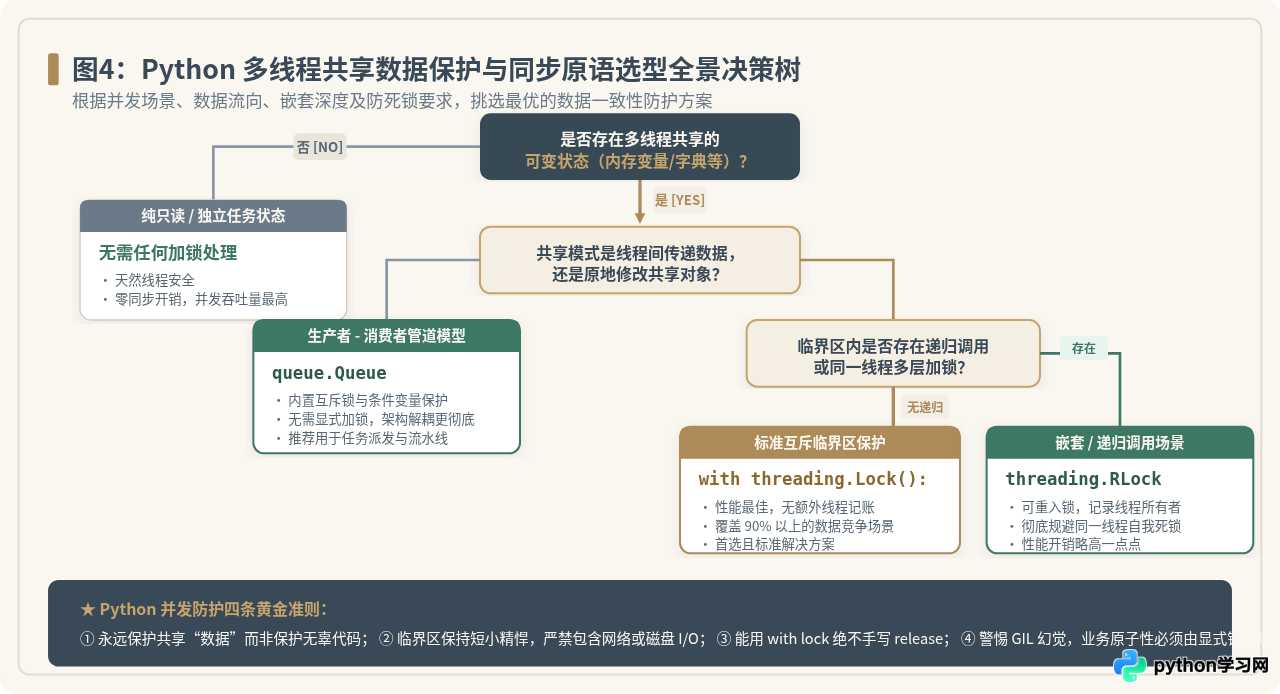
在 Python 多线程开发中,消灭数据竞争并不意味着无节制地随处加锁。针对不同的并发数据交互模式,Python 生态提供了层次丰富的同步工具。
最佳实践选型原则
- 优先考虑无共享设计:如果可以通过将数据按线程切分、各自处理并最终合并(Map-Reduce 模式),应尽量避免多线程共享可变状态,从根本上杜绝竞态条件。
- 线程间通信首选
queue.Queue:在典型的生产者-消费者架构中,推荐使用标准库queue.Queue进行任务分发。它在底层已经完整封装了锁和条件变量,线程安全且高度解耦,能省去手动加锁的心智负担。 - 原地修改共享变量首选
threading.Lock搭配with:针对绝大多数计数累加、状态标志翻转、共享字典更新等场景,使用with lock:是性能最优、代码最简洁、最不易出错的标准解法。 - 涉及递归或对象方法相互调用时选用
threading.RLock:当复杂面向对象组件内部的方法同时加锁且存在父子嵌套调用时,务必使用可重入锁以防止自我死锁。 - 防范死锁的防御性策略:尽量保持临界区简短;涉及多个锁时严格按照固定顺序获取;关键业务路径搭配
timeout参数建立超时退出机制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









