

Python多条件排序技巧:怎么按多个字段优先级排序
详细讲解Python中如何按多个字段的优先级进行多条件排序。深入解析元组逐项比较机制、operator模块高性能提速、混合升序降序的处理方案以及None缺失值的避坑技巧。
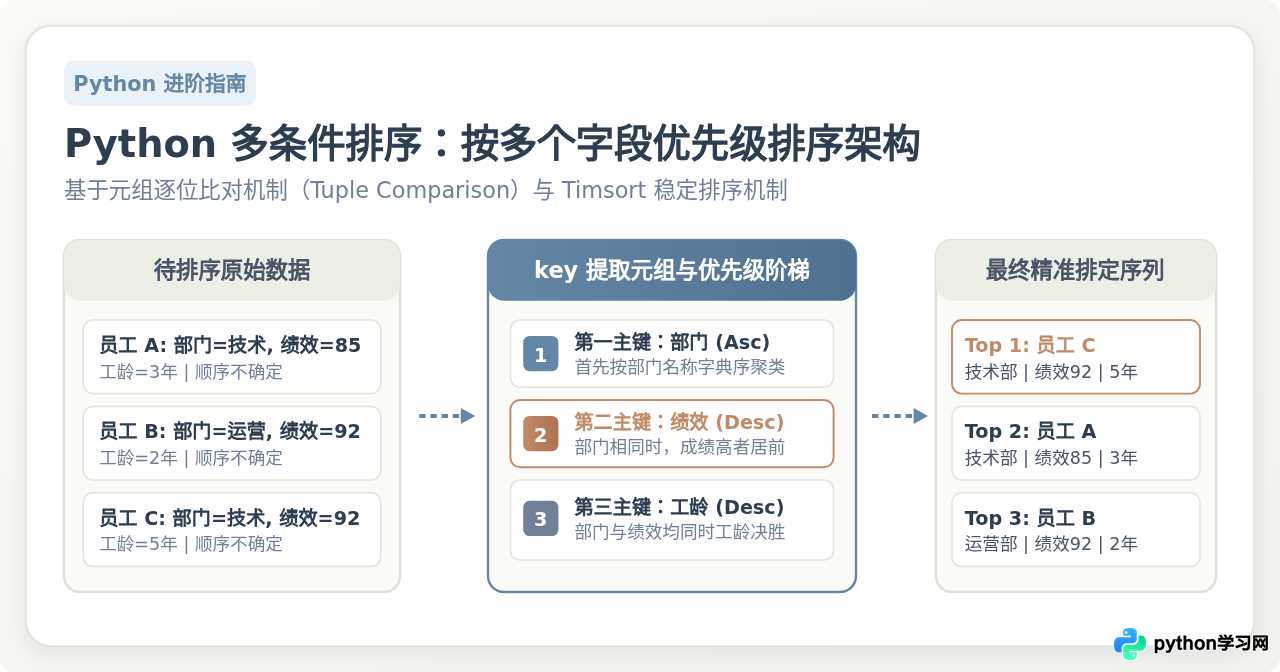
在 Python 中对列表进行多条件排序时,最直接且高效的做法是利用 sort() 或 sorted() 函数的 key 参数返回一个元组(Tuple)。因为 Python 比较元组时会按照从左到右的顺序逐位比对元素:只有当前一位元素相同时,才会继续比较下一位元素,这与业务开发中“第一优先级、第二优先级、第三优先级”的多字段级联排序需求完美重合。针对字段间升序降序混合的复杂场景,可以通过数值取负或利用 Python 底层 Timsort 算法的稳定性进行多轮反向排序来实现。
一、核心原理:元组比较规则与优先级判断
要掌握 Python 的多条件排序,首先需要清楚元组(Tuple)在 Python 内部的比较机制。当 Python 比较两个元组 (A1, B1, C1) 和 (A2, B2, C2) 的大小时,遵循严格的词典序(Lexicographical Order)与短路机制(Short-circuiting):
- 逐位比较:首先比较索引为 0 的主字段。如果
A1 < A2,整个元组立即判定为小于;如果A1 > A2,立即判定为大于。 - 平局顺延:只有当
A1 == A2(即主字段完全一致出现平局)时,Python 才会去比较索引为 1 的次字段B1和B2。 - 短路停止:一旦在某一位分出了先后,后续无论还有多少个字段,Python 都会立即停止比较,不再执行后面的取值与运算。
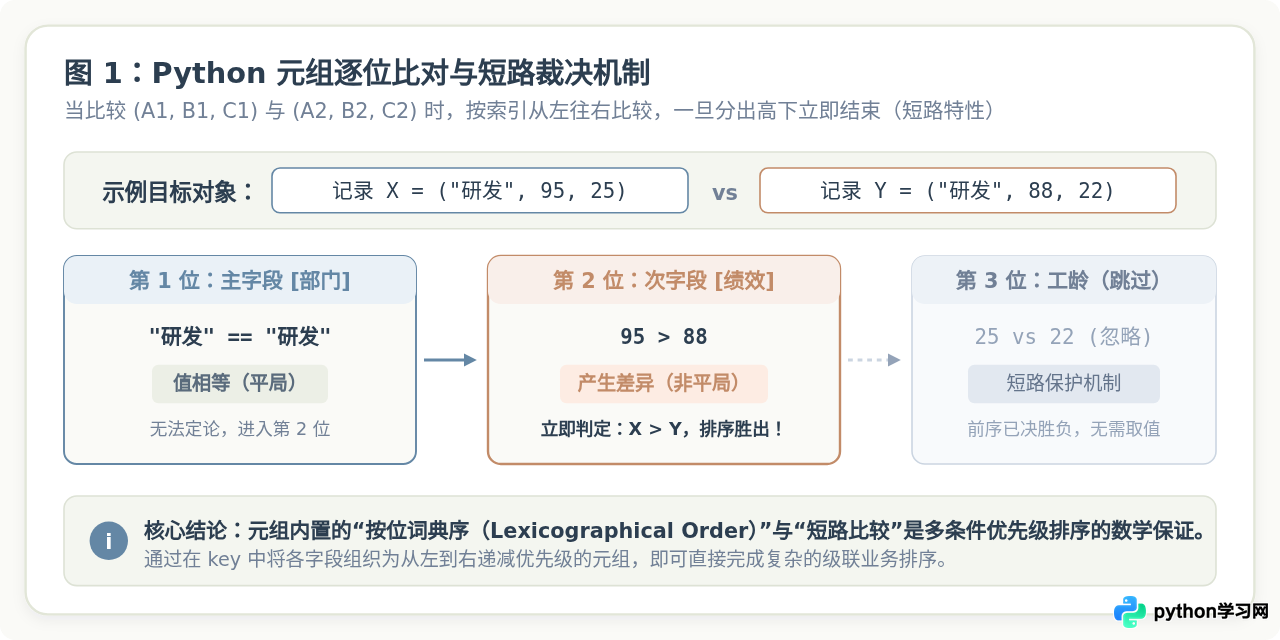
这种语言层面的短路特性带来了两重好处:第一,语义逻辑与多字段业务排序完全对齐;第二,能够避免不必要的次级字段计算,从而保障极高的高频比较效率。
二、基础实战:同向多字段排序(全升序或全降序)
在日常开发中最常见的数据形态是“字典构成的列表”或“对象构成的列表”。如果要求的所有字段排序方向一致(全部升序或全部降序),可以通过 lambda 表达式或标准库 operator 模块快速完成。
1. 针对字典列表使用 lambda 构造元组键
假设我们有一组员工考评记录,要求首先按“部门(dept)”升序排列;当部门相同时,按“绩效评分(score)”升序排列;绩效再相同时,按“工龄(years)”升序排列:
employees = [
    {"name": "张三", "dept": "研发", "score": 90, "years": 3},
    {"name": "李四", "dept": "运营", "score": 95, "years": 2},
    {"name": "王五", "dept": "研发", "score": 90, "years": 5},
    {"name": "赵六", "dept": "研发", "score": 85, "years": 4},
]

# key 函数返回元组:(部门, 绩效, 工龄)
sorted_employees = sorted(
    employees,
    key=lambda x: (x["dept"], x["score"], x["years"])
)

# 排序输出说明:
# 1. 赵六 (研发, 85, 4)
# 2. 张三 (研发, 90, 3)  - 与王五同部门同分数,工龄更短排在前面
# 3. 王五 (研发, 90, 5)
# 4. 李四 (运营, 95, 2)  - 运营拼音首字母在研发之后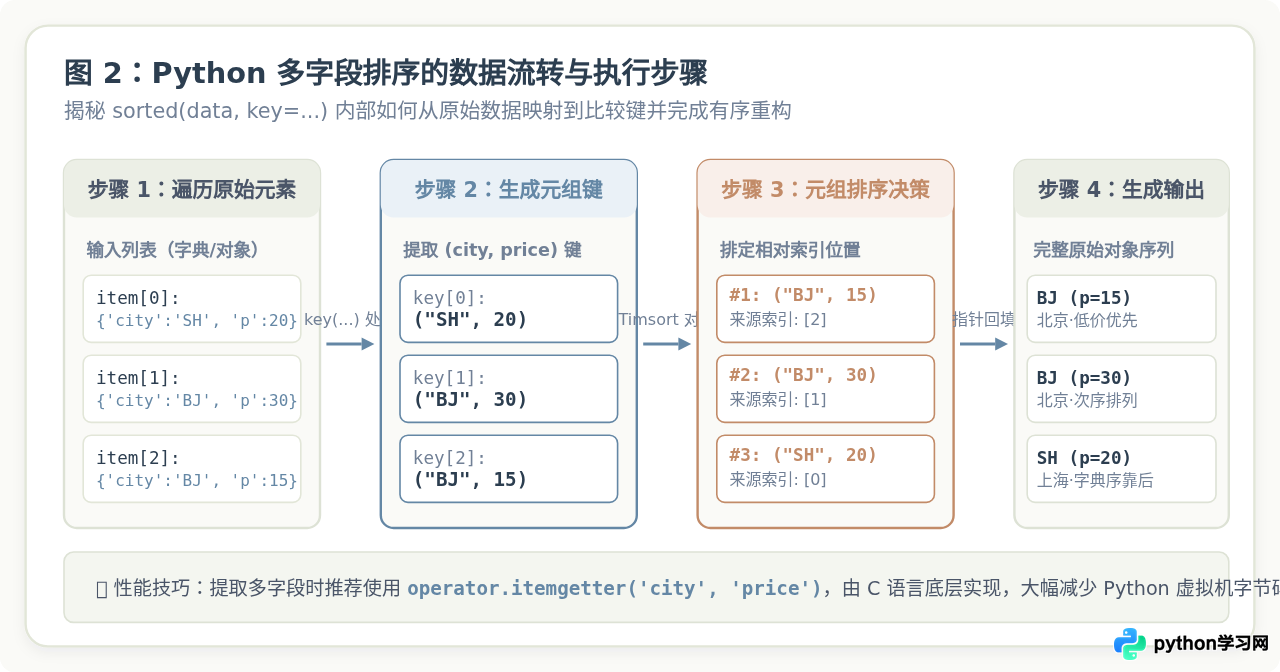
2. 性能倍增技巧:使用 operator.itemgetter
虽然 lambda 写法非常灵活,但如果处理的数据量达到数万条甚至百万条级别,每次比较都触发 Python 层的函数调用会有较为明显的额外开销。Python 提供了内置的 operator.itemgetter,它完全由底层 C 语言编写,提取多个键时会自动打包为元组,性能通常比 lambda 快 20% 到 50%:
from operator import itemgetter

# 传入多个字段名,itemgetter 会直接返回对应字段的元组
sorted_fast = sorted(employees, key=itemgetter("dept", "score", "years"))operator.attrgetter('dept', 'score', 'years') 替代 itemgetter,同样能以 C 级速度完成多属性的元组化提取。
三、进阶场景:混合升序与降序的高级解法
实际业务中最棘手的问题是“不同字段升降序不一致”。例如:部门按升序排列(ASC),但绩效必须按从高到低降序排列(DESC),若绩效相同再按工龄升序排列(ASC)。因为 sorted() 的 reverse=True 参数是全局生效的,会将整个元组全部倒序,无法直接解决局部倒序的需求。
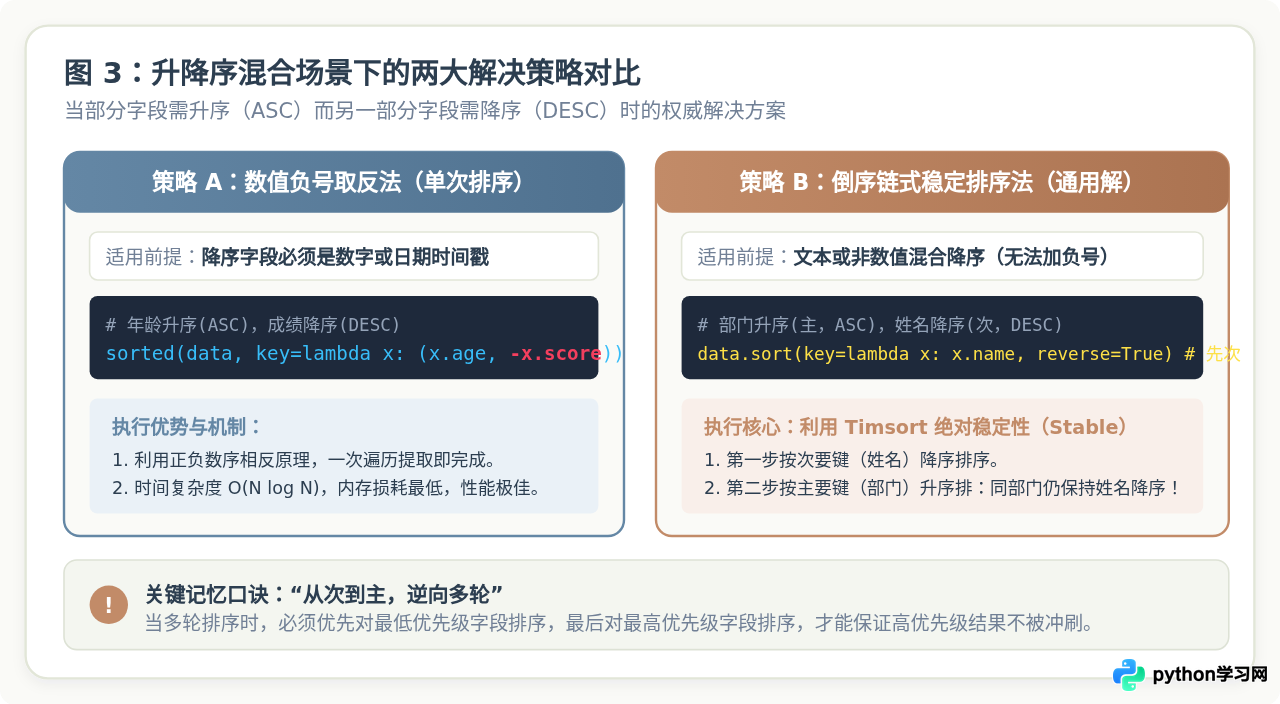
解法一:数值字段加负号(推荐首选)
如果需要降序排列的字段是数值类型(如整数、浮点数、或可以转换为数值的时间戳),最优雅高效的技巧是:直接在该字段前添加负号 -。负号将数值的大小顺序完全翻转,从而在全局升序的机制下自然实现了局部降序:
# 需求:部门升序 (ASC) + 绩效降序 (DESC) + 工龄升序 (ASC)
sorted_mixed = sorted(
    employees,
    key=lambda x: (
        x["dept"],     # 文本升序
        -x["score"],   # 绩效加负号,95 变为 -95,85 变为 -85。由于 -95 < -85,分数高的排在前面!
        x["years"]     # 工龄正常升序
    )
)
这种写法只需一次排序、内存无额外消耗,且保持了极佳的代码可读性。
解法二:倒序链式稳定排序(处理字符串等非数值降序)
当需要降序的字段是字符串或自定义对象时,由于字符串无法直接使用负号 - 取反,我们就需要利用 Python 排序算法的黄金特性——稳定排序(Stable Sort)。
从 Python 2.3 开始,Python 内置的排序算法为 Timsort。Timsort 具备绝对的稳定性:当两个元素的排序键相等时,它们在排序后的相对顺序保持原样不变。借助这一特性,我们可以采用“从次到主,逆向多轮”的法则:
- 首先对次要优先级字段单独进行排序(设置其所需的
reverse方向); - 最后对主要优先级字段进行排序(设置其所需的
reverse方向)。
# 场景:部门降序 (DESC,字符串) + 姓名升序 (ASC,字符串)
# 无法对字符串加负号,采用原地稳定排序链:

# 第一步:先按次要字段“姓名”进行升序排序
employees.sort(key=lambda x: x["name"], reverse=False)

# 第二步:再按主要字段“部门”进行降序排序
employees.sort(key=lambda x: x["dept"], reverse=True)

# 原理验证:第二步在对“部门”降序排序时,若遇到同属“研发部”的员工,
# Timsort 会保证它们在第一步排好的“姓名升序”相对次序原封不动保留!四、边界与防御:None 缺失值与不可比类型处理
在真实业务数据中,某些排序字段经常会出现 None(空值)。在 Python 2 中 None 默认小于任何数字,但在 Python 3 中,直接比较数字与 None 会直接抛出严重异常:TypeError: '<' not supported between instances of 'NoneType' and 'int'。
使用布尔哨兵键分离 None 值
在 Python 中,布尔值 False 相当于数值 0,True 相当于数值 1,即 False < True。我们可以将“是否为 None”作为一个布尔标识放入元组的第一位:
data = [
    {"id": 1, "score": 88},
    {"id": 2, "score": None},
    {"id": 3, "score": 95},
    {"id": 4, "score": None},
    {"id": 5, "score": 72},
]

# 需求:有效成绩降序排,缺失数据 (None) 垫底排在最后
sorted_data = sorted(
    data,
    key=lambda x: (
        x["score"] is None,                # 有分数的为 False(0),None 为 True(1),0 < 1 故有分数的在前
        -x["score"] if x["score"] is not None else 0  # 避免对 None 加负号报错
    )
)
通过元组前置 x['score'] is None,不仅完美化解了类型不兼容导致的报错崩溃,还能通过调整布尔表达式精确控制 None 究竟是沉底还是置顶。
五、总结与技术选型决策树
根据字段类型、升降同构性以及数据体量,多条件排序的技术选型路径可以归纳如下:
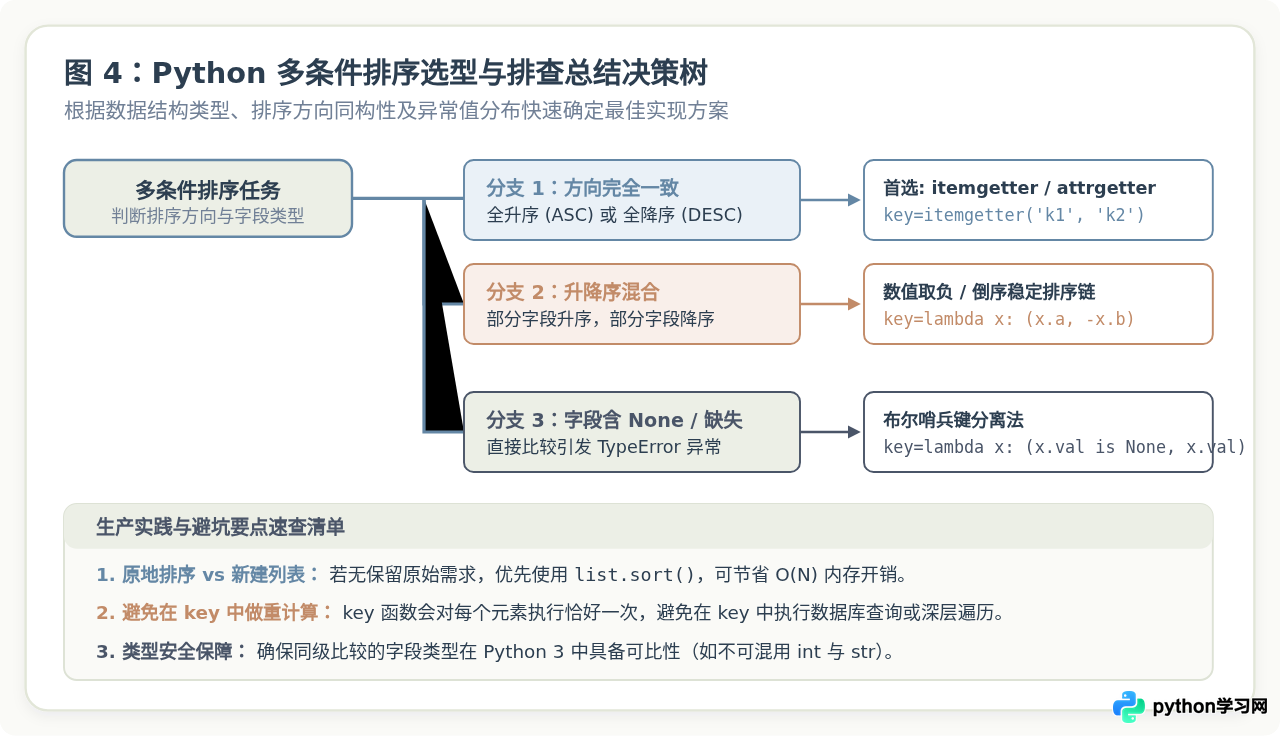
| 场景分类 | 适用特征 | 推荐写法 | 时间复杂度 |
|---|---|---|---|
| 同向多字段(全升序) | 字典或类对象,字段同向排列 | key=operator.itemgetter('f1', 'f2') |
O(N log N) |
| 数值混合升降序 | 降序字段为 int / float / timestamp | key=lambda x: (x.f1, -x.f2) |
O(N log N) |
| 非数值混合升降序 | 降序字段为 str 或自定义对象 | 按优先级从低到高执行多次 list.sort() |
O(K · N log N) |
| 字段含 None / 缺失值 | 可能存在空值的混合字段 | key=lambda x: (x.f is None, x.f) |
O(N log N) |
在实际工程中,优先推荐使用 key 返回元组的单次排序方式。只要合理利用元组的短路比较规则、负号取反技巧以及哨兵键,就能兼顾业务逻辑的准确性、运行效率以及代码的整洁度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









