

为什么不建议在Python中使用np.matrix类
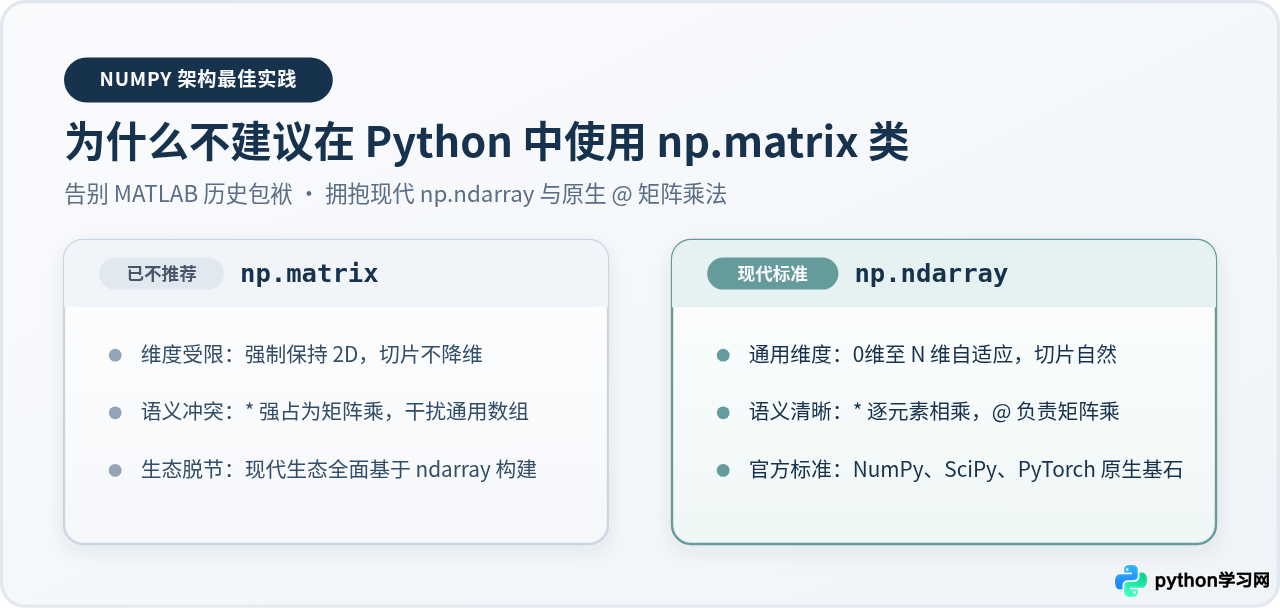
深入解析为什么NumPy官方明确不建议在现代Python中使用np.matrix类,剖析其强制二维陷阱、乘法语义混乱与生态割裂问题,并提供从np.matrix迁移到np.ndarray与@运算符的完整重构实操指南。
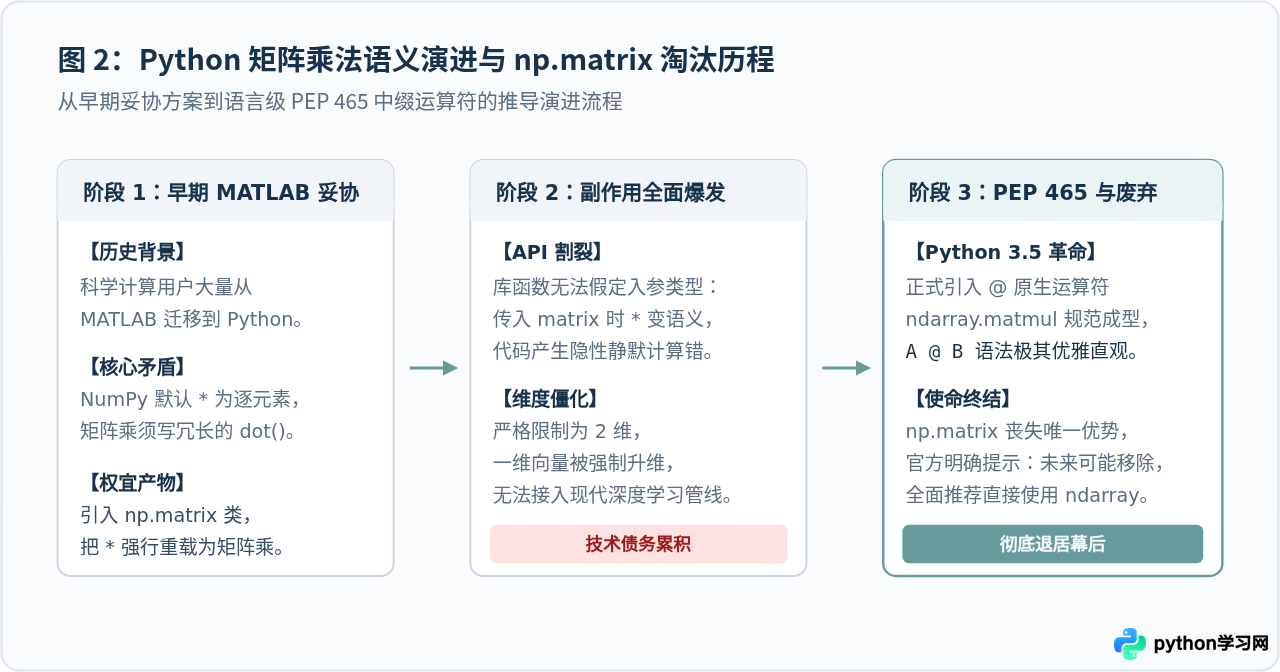
如果你在阅读较老的 Python 教程、学术论文复现源码或线性代数脚本时,可能会频繁看到 np.matrix(或 np.mat、np.asmatrix)的身影。然而,在当前的 NumPy 官方文档中,该类已被明确标注为“Pending Deprecation(待废弃 / 不再推荐)”,并明确建议所有用户在任何新代码中全面改用标准的 np.ndarray。
简单直接的答案是:np.matrix 存在的唯一历史理由(通过 * 进行矩阵乘法)早在 Python 3.5 引入原生 @ 运算符后便已不复存在;而它强制保持二维的硬性约束,不仅破坏了切片降维的通用语义,还会在函数传参和第三方科学计算库调用中引发难以排查的维度广播与静默计算 Bug。
一、历史渊源:np.matrix 因何而生,又为何失去价值
要理解为什么不再需要 np.matrix,首先需要回到 Python 科学计算发展的早期阶段。
在 NumPy 早期,大量科研人员和工程师习惯了 MATLAB 的线性代数语法风格。在 MATLAB 中,所有变量默认都是二维矩阵,乘法符号 * 直接代表线性代数中的矩阵相乘(Matrix Multiplication)。而在 Python 的原生语法中,标准数组 np.ndarray 的 * 符号被设计为执行逐元素相乘(Hadamard积 / Element-wise Multiplication)。如果要在 np.ndarray 上计算两个矩阵的乘积,只能写出较为冗长的函数调用:
# Python 3.5 之前,使用 ndarray 计算矩阵乘法必须依赖 dot
result = np.dot(np.dot(A, B), C)
为了照顾这部分习惯矩阵运算的用户,NumPy 派生出了 np.matrix 类。它继承自 np.ndarray,但做出了两个特殊调整:
- 强行改变乘法语义:将
*重载为矩阵乘法,逐元素相乘改由np.multiply()执行; - 强行保持二维:无论如何切片或运算,对象的维度(ndim)必须恒等于 2。
然而,转折点出现在 PEP 465。Python 3.5 正式在语言核心引入了专门的矩阵乘法中缀运算符 @(对应特殊方法 __matmul__)。NumPy 的 np.ndarray 随即全面支持 @ 运算符。从此,使用标准多维数组书写矩阵乘法变得极为直观优雅:A @ B @ C。这一语言级别的更新,瞬间抽离了 np.matrix 存在的根本支柱。
二、致命缺陷一:强制维持二维带来的“切片与维度陷阱”
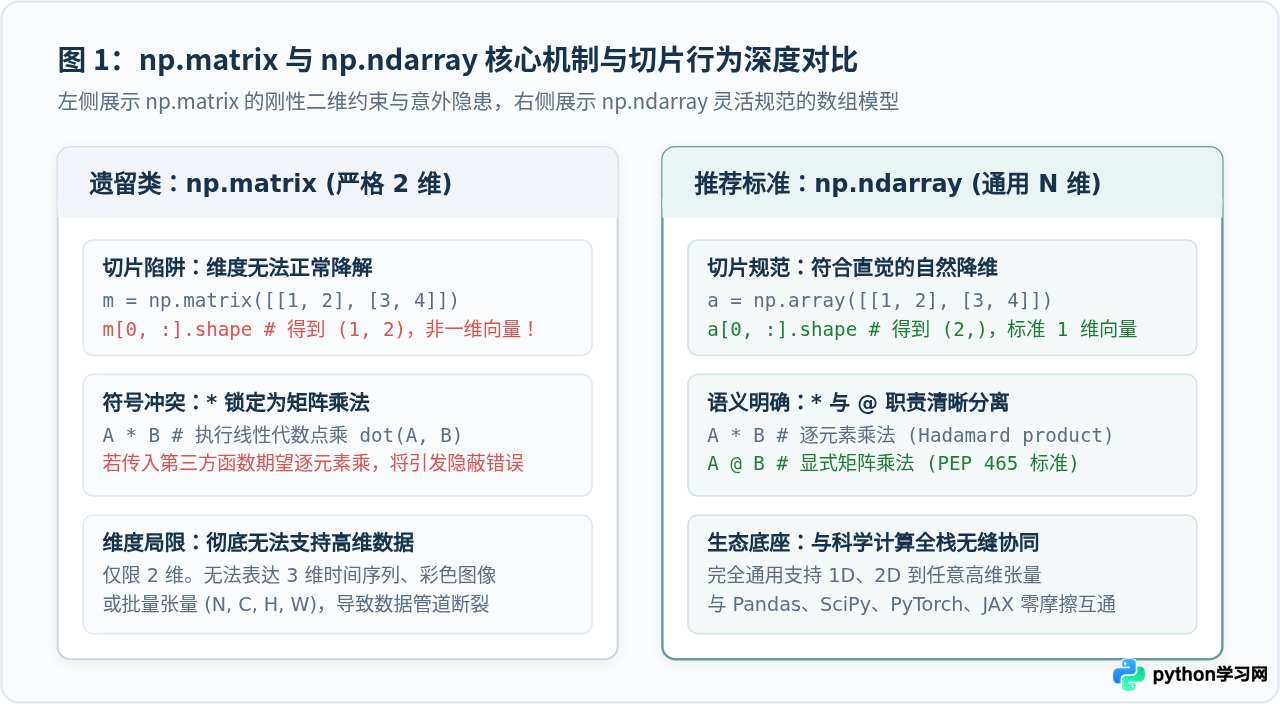
np.matrix 与 np.ndarray 最本质的底层差异,在于它对维度的刚性限制。很多开发者最初认为“保持二维更省心”,但实际工程中这往往是灾难的来源。
1. 切片无法自然降解为一维向量
在标准的 np.ndarray 中,从二维数组中提取单行或单列,会自然降维成直观的一维向量(形状为 (n,))。而 np.matrix 无论如何索引,输出永远都是一个形状为 (1, n) 或 (n, 1) 的二维矩阵:
import numpy as np

# 标准 ndarray 行为
arr = np.array([[10, 20, 30], [40, 50, 60]])
row_arr = arr[0, :]
print(row_arr.shape)   # 输出示例: (3,) —— 干净的一维数组

# np.matrix 行为
mat = np.matrix([[10, 20, 30], [40, 50, 60]])
row_mat = mat[0, :]
print(row_mat.shape)   # 输出示例: (1, 3) —— 仍然是二维!即使取标量 mat[0, 0] 也可能得到 (1, 1)
当你的函数需要将提取出的向量传递给其他算法(例如求解点积、传给绘制折线图的 Matplotlib、或者作为特征传入 Scikit-learn)时,接收端往往期望的是一维数组 (n,)。如果传入的是 (1, n),可能会直接报出 ValueError: Expected 1D array,或者在做广播运算时产生意料之外的矩阵扩展。
三、致命缺陷二:运算符语义冲突与生态静默 Bug
更隐蔽、更危险的风险发生在代码复用和团队协作场景中。
在 Python 的科学计算生态中,绝大多数第三方库(包括 SciPy、Pandas、PyTorch、TensorFlow 等)都默认所有类似数组的对象遵循 np.ndarray 的基本行为准则:* 即逐元素乘法。假设有这样一个用于数据归一化或加权的通用函数:
def apply_weights(data, weights):
    # 作者期望执行逐元素权重乘法 (Hadamard 积)
    return data * weights
如果调用者传入的是标准的 np.ndarray,data * weights 会按照广播机制正确执行逐元素缩放。但如果调用者不经意间传入了一个 np.matrix 对象,这行代码将静默转为线性代数矩阵乘法!
- 如果两个输入的维度恰好不满足矩阵乘法的行列匹配条件,代码会抛出
ValueError: shapes not aligned,此时问题尚且能被发现; - 如果输入的矩阵碰巧是方阵,矩阵相乘将顺利完成并返回一个数值完全错误的假结果。这种静默计算逻辑错误在大型数值模拟或模型训练中极难被排查。
SciPy 等核心库在近期版本中已经逐步收紧对 np.matrix 的支持,部分线性代数求解器甚至会在传入 np.matrix 时直接发出告警或报错。此外,现代深度学习涉及大量 3 维(如序列批次 (B, T, D))和 4 维(如图像批次 (N, C, H, W))张量,只能存活在 2 维世界的 np.matrix 根本无法参与这些计算流程。
四、标准替代方案:语法速查与行为对照
废弃 np.matrix 并不会带来任何表达能力上的缺失。下表详细列出了在 np.ndarray 下如何对等且更清晰地表达原本 np.matrix 的各项操作:
| 运算意图 | 过时的 np.matrix 写法 | 现代标准的 np.ndarray 写法 | 技术解释 |
|---|---|---|---|
| 创建二维矩阵 | np.matrix([[1, 2], [3, 4]]) |
np.array([[1, 2], [3, 4]]) |
标准的 N 维多维数组构造 |
| 矩阵相乘 | A * B |
A @ B |
PEP 465 中缀运算符,语义明确 |
| 逐元素相乘 | np.multiply(A, B) |
A * B |
回归 Python 数组的标准 Hadamard 积 |
| 矩阵求逆 | A.I |
np.linalg.inv(A) |
明确调用线性代数求解库,避免非方阵假属性 |
| 伪逆 (Pseudo-inv) | 无专属属性 | np.linalg.pinv(A) |
针对奇异矩阵或长方阵的稳定求逆 |
| 共轭转置 | A.H |
A.conj().T |
组合基础方法,通用性更强 |
| 转置 | A.T |
A.T |
两者均支持标准转置属性 |
五、迁移重构实操:从 np.matrix 平滑升级的 4 个步骤
如果你的代码库中残留了历史的 np.matrix,可以遵循以下 4 个清晰步骤完成现代重构:
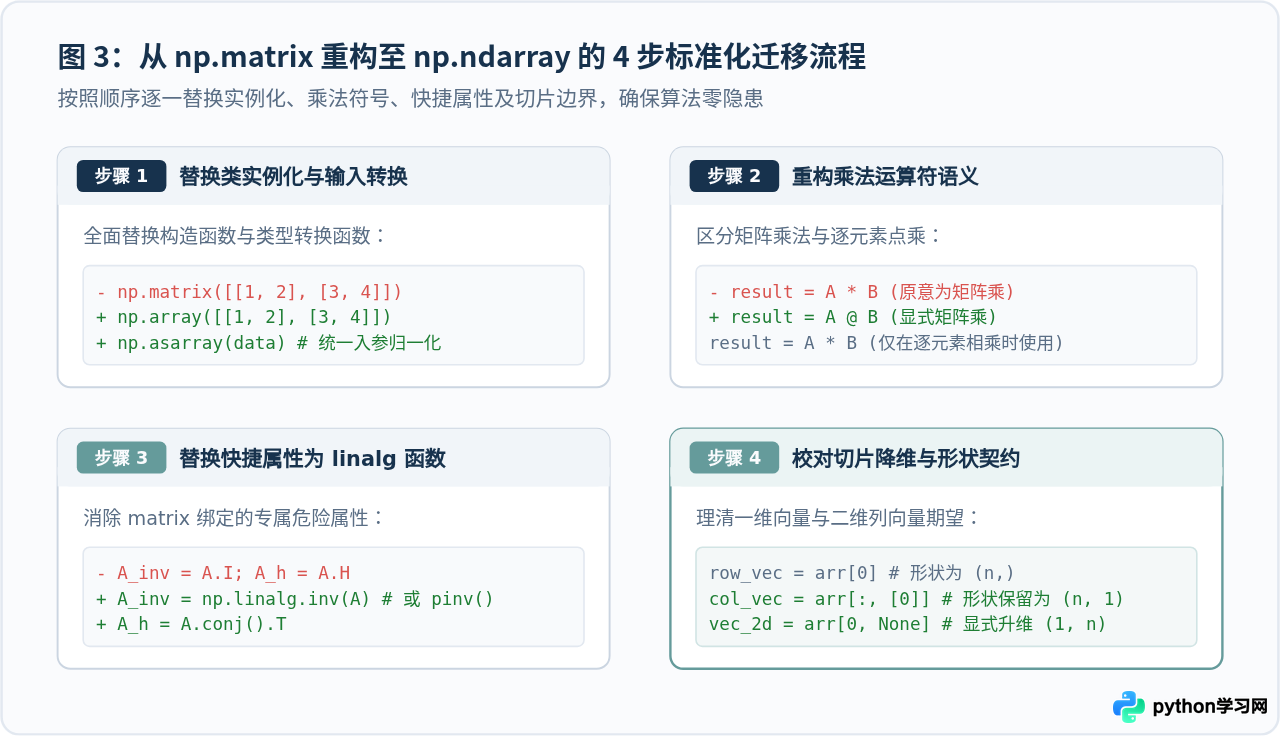
步骤 1:替换实例化与工厂函数
将所有 np.matrix() 或 np.mat() 调用全局替换为 np.array()。在编写接受外部输入的公共函数时,使用 np.asarray() 确保入参统一降解为标准 ndarray,构筑安全防线:
# 改造前
m = np.matrix([[1.0, 2.0], [3.0, 4.0]])

# 改造后
a = np.array([[1.0, 2.0], [3.0, 4.0]])
步骤 2:检查并拆分乘法操作符
全局检索代码中涉及矩阵实例的 * 操作符。如果数学上是在做矩阵乘法(点积),替换为 @;如果是想按位置相乘,保留 * 并移除之前冗杂的 np.multiply():
# 改造前 (matrix 下的矩阵相乘与逐元素相乘)
dot_res = m1 * m2
elem_res = np.multiply(m1, m2)

# 改造后 (ndarray 下职责分离)
dot_res = a1 @ a2
elem_res = a1 * a2
步骤 3:重构逆矩阵属性 .I 与共轭转置 .H
np.matrix 附带的 .I 属性虽然短小,但它掩盖了求逆可能失败的数学风险,且对于不可逆矩阵的行为不透明。改用 np.linalg.inv() 或 np.linalg.pinv():
# 改造前
m_inv = m.I

# 改造后
a_inv = np.linalg.inv(a)  # 标准求逆
# 若矩阵可能为奇异阵或长方阵,推荐使用伪逆:
a_pinv = np.linalg.pinv(a)
步骤 4:确认切片输出的维度契约
迁移后,arr[0] 会返回一维形状 (n,)。如果后续某些老函数严格要求二维列向量或行向量,通过 None(即 np.newaxis)或 reshape() 显式声明,而非依赖类隐式保持:
# 显式构造特定形状,语义清晰不留歧义
row_vector = a[0, None]    # 形状明确为 (1, n)
col_vector = a[:, [0]]     # 形状明确为 (n, 1)
六、工程选型总结与决策建议
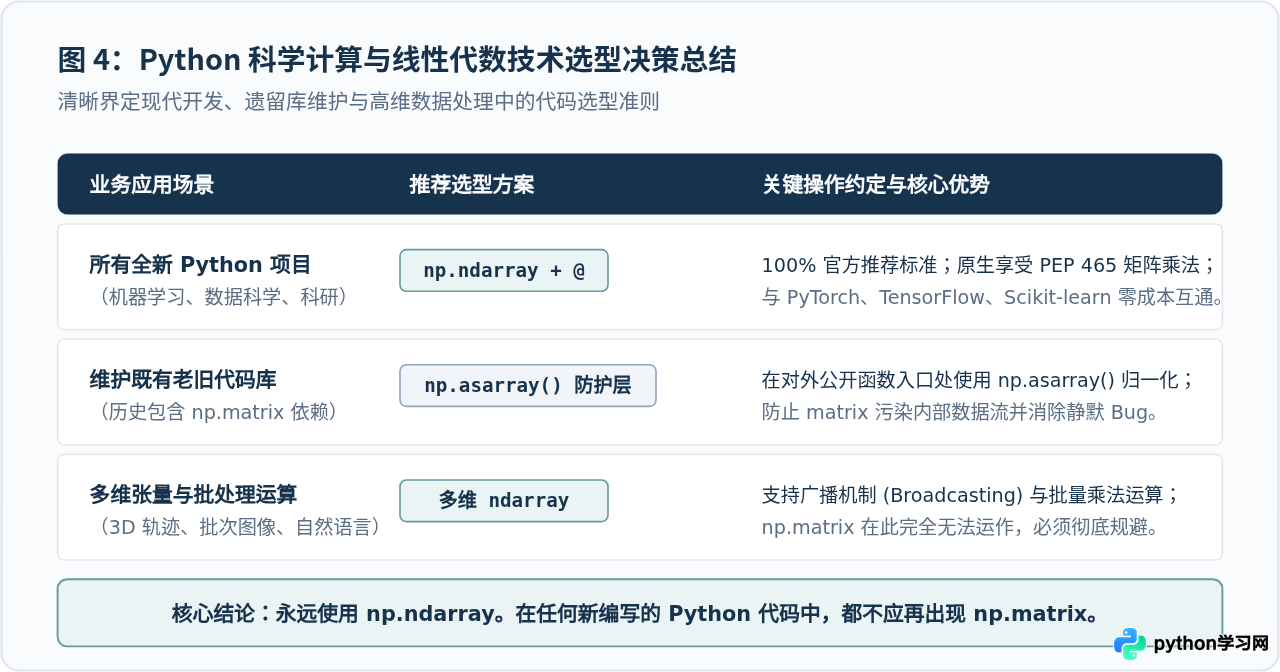
总结来说,np.matrix 是 Python 发展历史上一个过渡性质的妥协产物。在 Python 3.5 以后:
- 它没有任何独特优势:
np.ndarray配合@已经提供了同样简洁甚至更严谨的语法体验; - 它存在明显的负面效应:破坏数组通用抽象、阻碍高维扩展、并在切片与函数复用中带来未预期的维度陷阱;
- 官方废弃不可逆转:虽然为了保持向后兼容暂未在最新版本中强行删除,但它已被排除在未来优化和生态主流之外。
对于所有 Python 开发者而言,拥抱 np.ndarray 并熟练使用 @ 运算符,是编写现代、健壮且易于维护的科学计算代码的唯一正确选择。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









