

怎么设置User-Agent防止Python爬虫被屏蔽
详细讲解在Python爬虫中如何通过设置与轮换User-Agent请求头,避免因默认客户端标识而直接被目标网站拦截或屏蔽的实用教程。
requests.get("https://example.com/data") 请求目标网站,控制台立刻返回了醒目的 403 Forbidden 或要求滑动验证码;但如果复制相同的网址在电脑浏览器中直接打开,页面却能秒速、正常地完整展示。这一现象的核心根源,往往正是 HTTP 请求标头中的 User-Agent 暴露了爬虫身份。本文将具体讲解 User-Agent 的拦截原理、如何提取真实浏览器的标头、在主流 Python 库中的具体配置语法,以及如何通过构建动态轮换池来有效防止爬虫被网站屏蔽。
一、为什么默认请求会被网站立即拦截
HTTP 协议规定,客户端每次向服务端发起请求时,都会在请求头(Request Headers)中附带一个名为 User-Agent(简称 UA)的键值对。它的初衷是告诉服务端当前发起请求的软件名称、版本号、操作系统类型及渲染引擎,以便服务端返回最适合该客户端尺寸与特性的网页内容。
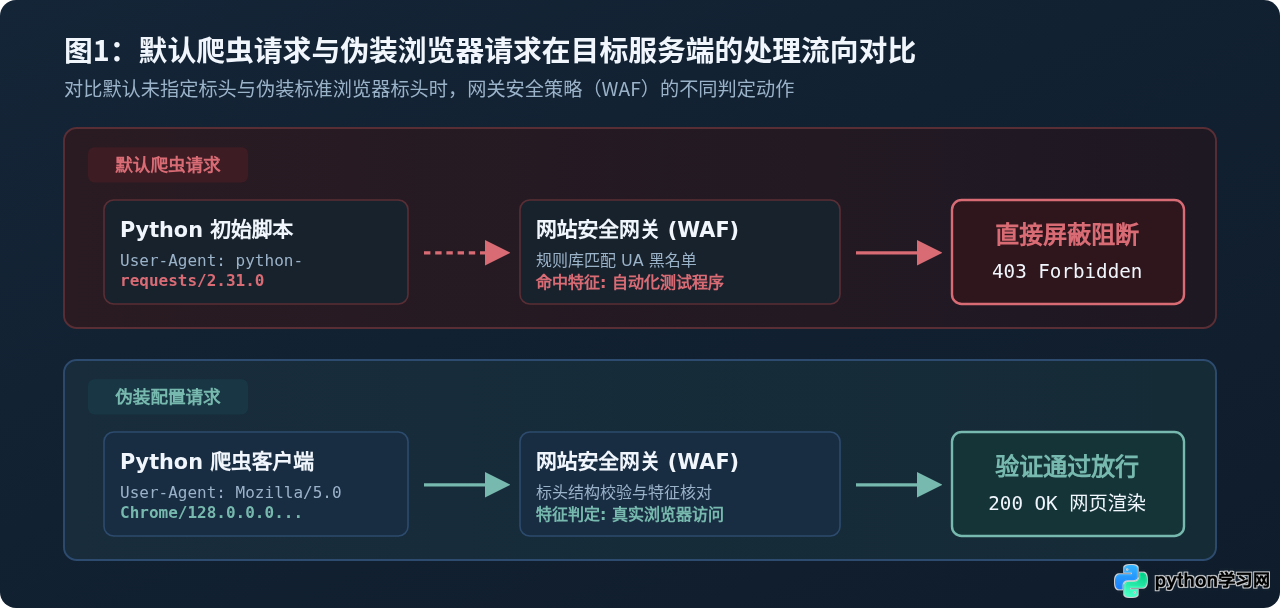
然而,Python 的网络请求库在默认情况下并不会隐蔽自身。例如常用的 requests 库,在不指定任何标头时,会自动发送如下标识:
# requests 发送的默认 User-Agent 字符串
User-Agent: python-requests/2.31.0
对于网站运维人员和 Web 应用防火墙(WAF)而言,python-requests、Python-urllib、aiohttp 或 Scrapy 都是极其显眼的自动化特征。服务端安全网关只需配置一条简单的正则匹配规则,就可以直接对所有包含上述特征的请求返回 403 Forbidden,甚至直接将发起请求的 IP 地址拉入临时黑名单。反之,如果在请求中带上主流桌面浏览器的合法 UA,服务端就会将该请求优先视作普通用户的网页浏览,从而放行初次访问。
二、如何从现代浏览器中提取合法的 User-Agent
要让爬虫的请求看起来像真正的浏览器,最可靠的素材来源就是日常使用的桌面浏览器。不要凭空手工编写 UA 字符串,因为各浏览器的内核版本号、渲染引擎版本与平台参数有着严格的对应关系,随意拼凑错误的格式反而会增加被拦截的风险。
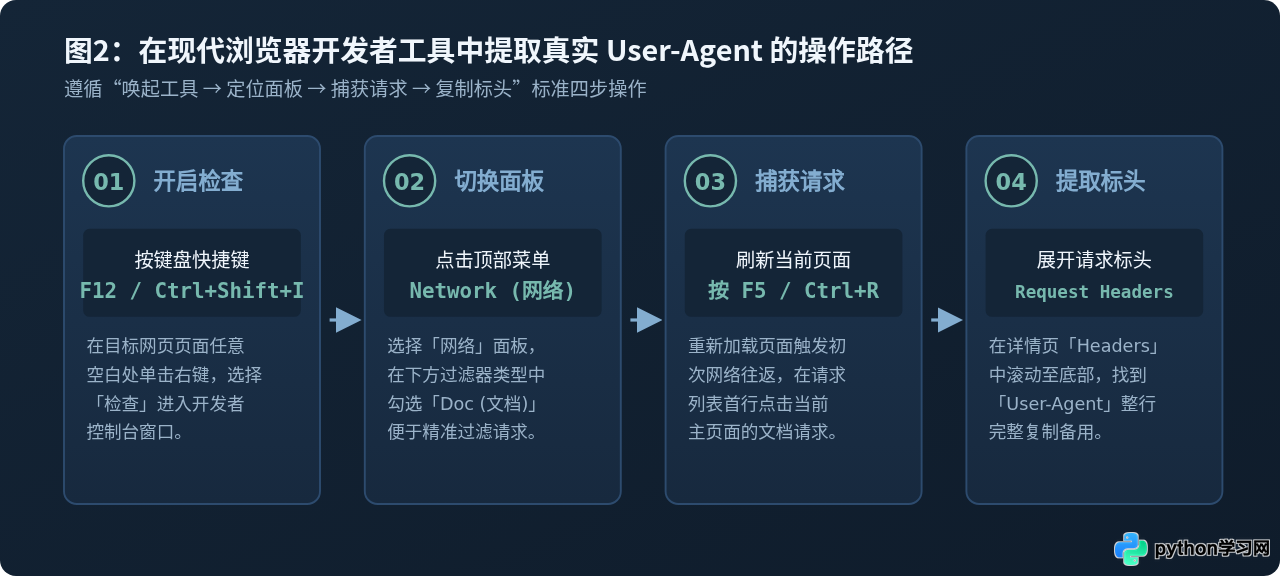
你可以直接使用 Google Chrome、Microsoft Edge 或 Firefox 自带的“开发者工具”提取本机最新的合法 UA:
- 开启开发者工具:在浏览器中打开任意目标网页,按下键盘快捷键
F12(macOS 用户可按Option + Command + I),或者在网页空白处右键单击,选择「检查」。 - 切换到网络面板:在打开的开发者工具顶部栏中,切换到「网络」(Network)选项卡。建议在下方的资源类型过滤器中选择「文档」(Doc),以过滤掉无关的图片和脚本请求。
- 捕获主页面请求:按下
F5或快捷键刷新当前页面,请求列表顶端会出现当前主页面的初始文档加载项。 - 复制完整标头:点击该文档请求,在右侧展开的详情窗格中点击「标头」(Headers),向下滚动找到「请求标头」(Request Headers)区域,其中的
User-Agent整行内容即为合法的客户端标识。
以常见的 Windows 11 环境下的 Google Chrome 为例:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36
其中包含了操作系统信息(Windows NT 10.0)、排版引擎兼容性声明(AppleWebKit/537.36)、实际浏览器品牌与主版本号(Chrome/128),以及为了历史兼容而保留的 Safari 标识。复制时需保证整行完整,不可截断。
三、在 Python 主流网络库中配置 User-Agent 的具体做法
获取到真实的 User-Agent 后,需要在代码中将其包装为 HTTP 标头字典并传递给网络请求方法。以下整理了常用库的具体配置代码与执行对比。
1. requests 库的基础配置与 Session 会话配置
在单次 requests.get() 或 requests.post() 请求中,可通过关键字参数 headers 传入字典:
import requests

url = "https://httpbin.org/headers"

# 构造标准请求头字典
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
}

response = requests.get(url, headers=headers, timeout=10)
print("HTTP 状态码:", response.status_code)
print("服务端接收到的 UA:", response.json().get("headers", {}).get("User-Agent"))HTTP 状态码: 200
服务端接收到的 UA: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36
如果需要在多页面抓取过程中保持同一个连接池和 Cookie,推荐使用 requests.Session() 对象。在 Session 实例中一次性设置 headers,后续所有调用都会自动带上该配置:
import requests

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36"
})

# 会话内后续请求自动继承该标头
resp1 = session.get("https://httpbin.org/headers")
resp2 = session.get("https://httpbin.org/get")
print("会话请求状态码:", resp1.status_code, resp2.status_code)
2. 使用 Python 内置 urllib 标准库配置
在无法安装第三方依赖的受限环境下,可以使用内置的 urllib.request。由于 urllib.request.urlopen() 默认 UA 为 Python-urllib/3.x,需先构建 urllib.request.Request 对象再进行调用:
from urllib.request import Request, urlopen
import json

url = "https://httpbin.org/headers"
headers = {
    "User-Agent": "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36"
}

# 将 URL 和 headers 封装进 Request 对象
req = Request(url, headers=headers)
with urlopen(req, timeout=10) as resp:
    data = json.loads(resp.read().decode("utf-8"))
    print("返回状态码:", resp.status)
    print("确认标头:", data["headers"]["User-Agent"])
3. 在现代异步库 httpx 与 aiohttp 中配置
现代高性能异步爬虫中,httpx 和 aiohttp 同样支持全局或会话级标头注入:
# 1. httpx 客户端配置
import httpx
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:129.0) Gecko/20100101 Firefox/129.0"}
with httpx.Client(headers=headers) as client:
    r = client.get("https://httpbin.org/headers")

# 2. aiohttp 异步客户端配置
import aiohttp, asyncio
async def fetch():
    async with aiohttp.ClientSession(headers=headers) as session:
        async with session.get("https://httpbin.org/headers") as resp:
            return await resp.json()
四、构建 User-Agent 动态轮换机制降低风控风险
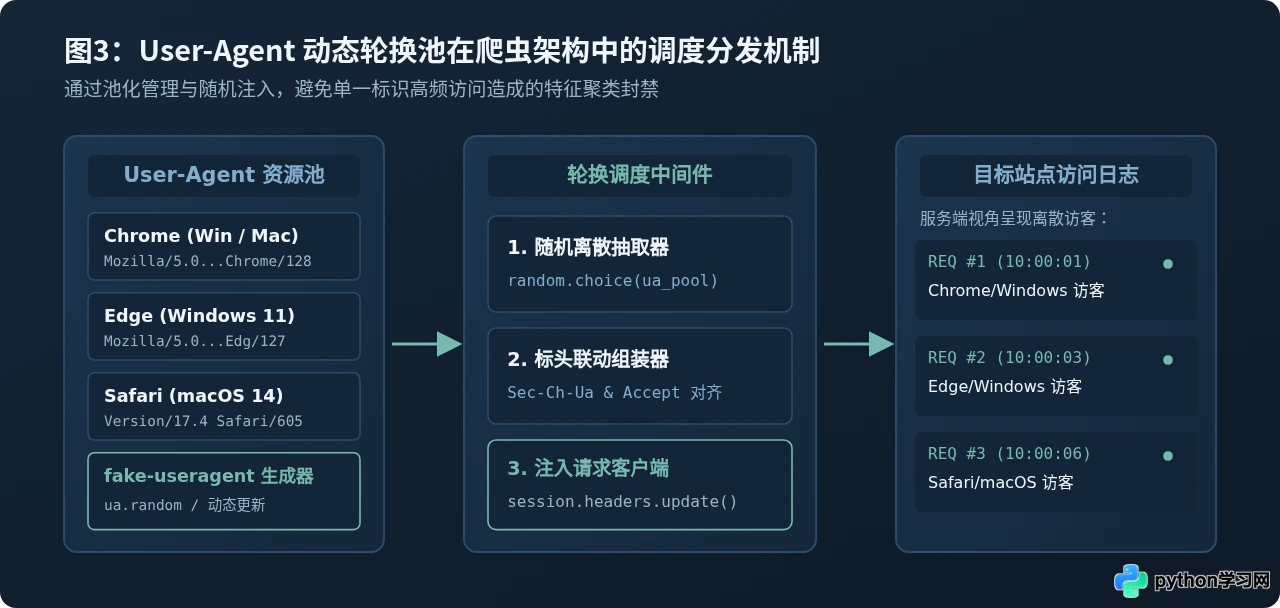
将 User-Agent 设置为一个静态的 Chrome 字符串,确实能通过第一道静态字符串黑名单校验。但如果爬虫需要抓取成百上千个页面,如果服务端在短时间内监测到同一个 IP 地址使用完全相同的固定 User-Agent 发起数百次密集请求,行为特征依然与正常人工浏览明显不符,极易触发基于频率的特征聚合风控。
为了进一步稀释特征,成熟的爬虫程序会维护一个包含多种操作系统与不同版本浏览器的“User-Agent 资源池”,在每次请求发起前动态随机挑选一个使用。
方法 A:基于标准列表与 random.choice 实现轻量级轮换
如果项目不需要额外引入复杂的外部库,可以定义一个包含主流平台合法 UA 的列表,并在请求时借助 random.choice() 抽取:
import random
import requests

# 整理覆盖 Windows、macOS 以及主要主流浏览器的常见合法 UA
UA_POOL = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:129.0) Gecko/20100101 Firefox/129.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.5 Safari/605.1.15",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36 Edg/128.0.0.0"
]

def fetch_with_random_ua(target_url):
    selected_ua = random.choice(UA_POOL)
    headers = {
        "User-Agent": selected_ua,
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9"
    }
    return requests.get(target_url, headers=headers, timeout=8)

# 连续两次调用查看随机效果
print("请求 1 状态:", fetch_with_random_ua("https://httpbin.org/headers").status_code)
print("请求 2 状态:", fetch_with_random_ua("https://httpbin.org/headers").status_code)
方法 B:利用 fake-useragent 库生成动态标识
开源库 fake-useragent 能够自动收集真实全球统计数据中的流行浏览器 UA。使用时需要特别注意设置 fallback 保底值,避免因本地网络环境无法访问线上版本库而抛出异常或死锁:
# 终端安装命令: pip install fake-useragent
from fake_useragent import UserAgent
import requests

# 初始化 UserAgent 对象并设置兜底字符串
fallback_ua = "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.0.0 Safari/537.36"
ua = UserAgent(fallback=fallback_ua, browsers=['chrome', 'edge', 'firefox'])

for i in range(3):
    random_header = {"User-Agent": ua.random}
    response = requests.get("https://httpbin.org/headers", headers=random_header)
    cur_ua = response.json().get("headers", {}).get("User-Agent")
    print(f"迭代 {i+1} 采用 UA:", cur_ua)
五、注意事项与超出 User-Agent 范围的防屏蔽策略
很多开发者在伪装了 User-Agent 后发现依然会被封禁,便误以为是 UA 伪装失效了。实际上,现代反爬虫系统(如 Cloudflare、Akamai、阿里云 WAF)是一套多层次的交叉验证防护网。设置合法的 User-Agent 只是越过了第一道“准入门槛”,要建立稳定可靠的数据采集系统,还需要理解以下边界与配合手段:
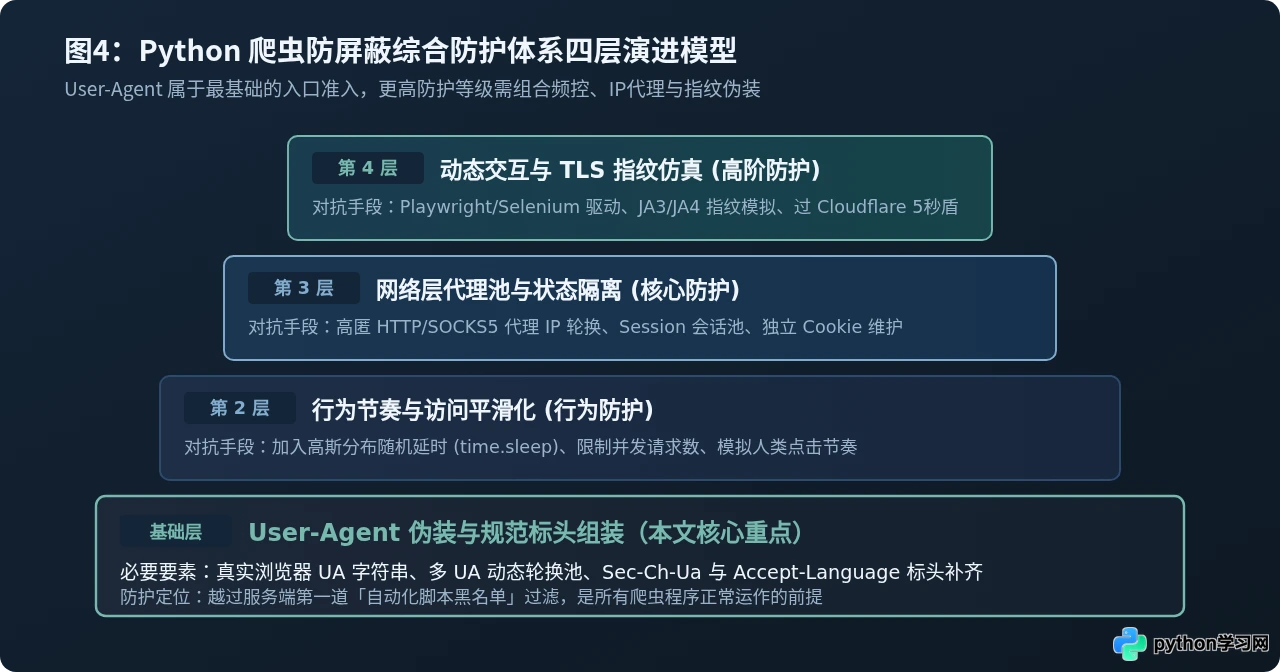
| 防护层级 | 检查特征维度 | 可能出现的屏蔽现象 | 针对性解决措施 |
|---|---|---|---|
| 标头伪装层 | User-Agent、Sec-Ch-Ua、Accept-Language | 403 Forbidden、418 I'm a teapot | 配置最新真实 UA,补齐 Client Hints 和语言标头 |
| 访问频率层 | 单位时间内单 IP 的请求峰值与间隔规律 | 429 Too Many Requests、出现图形验证码 | 加入 time.sleep(random.uniform(1.0, 3.0)) 随机平滑延时 |
| 网络通信层 | IP 地址信誉库、数据中心/机房 IP 段标记 | 直接 TCP 连接超时、返回 Cloudflare 封锁页 | 使用高匿名动态住宅代理 IP 池分担流量 |
| 指纹与执行层 | TLS/JA3 指纹、HTTP/2 特性、Canvas/WebRTC 探测 | 返回空壳 HTML、无限循环 5 秒盾挑战 | 使用 curl_cffi 伪造 TLS 指纹,或使用 Playwright 真实渲染 |
1. 大小写与格式错误:虽然标准 HTTP 标头不区分大小写,但部分自建防火墙网关严格匹配 User-Agent。请始终使用标准的驼峰横杠写法,避免写成 user_agent(下划线错误)或末尾多余的空格换行符。
2. Client Hints 与 UA 平台矛盾:新版 Chrome 引入了 Sec-Ch-Ua-Platform 标头。如果你的 User-Agent 字符串声明是 Windows 操作系统,但请求头却附带了 "Sec-Ch-Ua-Platform": "macOS",这种明显的矛盾会直接将你的爬虫判定为伪造脚本并予以阻断。
结语
设置合法的 User-Agent 是编写 Python 爬虫程序最基础、也最不可或缺的一步。在实际工程实践中,建议将从浏览器获取合法 UA、在 Session 中统一定义标头以及结合业务规模适度轮换作为编码的基本规范。在此基础之上,结合合理的请求时间间隔与代理调度,即可有效规避绝大多数网站的基础防护拦截,保障数据采集链路的稳定运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









