

Python常用代码片段大全:字符串、列表与文件操作模板
精选Python日常开发中最高频使用的字符串清洗、列表重构与文件读写操作模板,包含完整可复用的代码片段、原理解析、架构数据流与避坑指南。
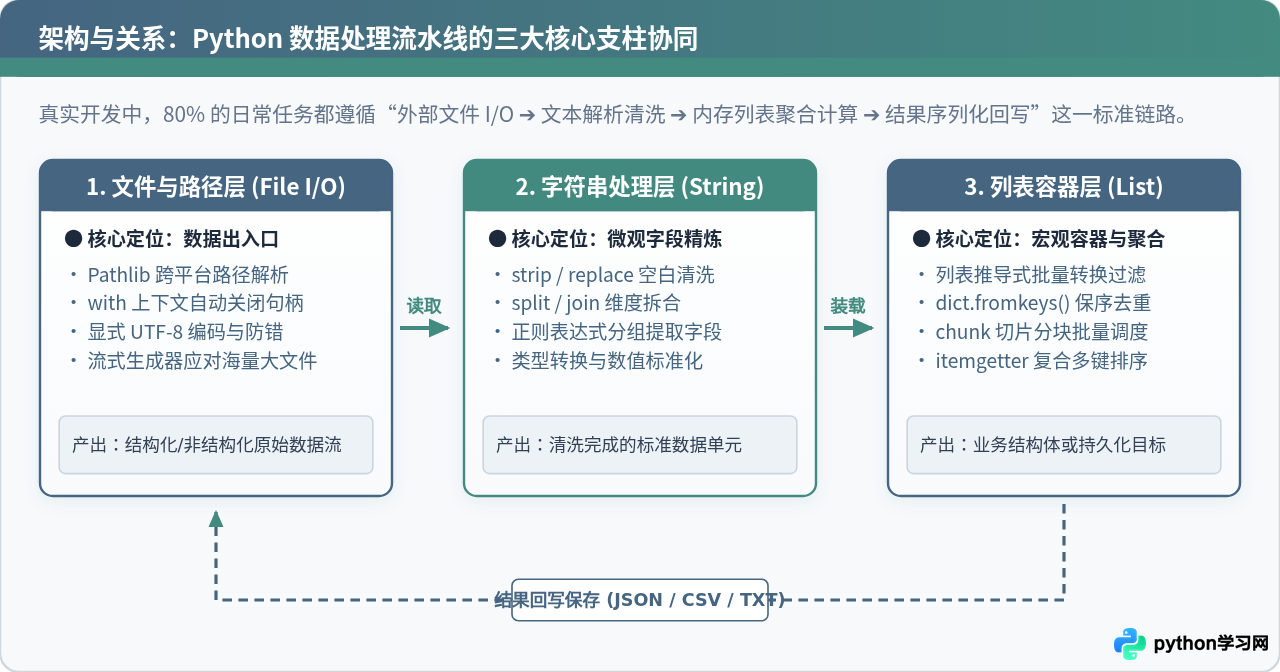
一、数据流转全景:三大基石的协同关系
在编写具体的业务代码前,理清数据在系统中的流动路径至关重要。无论是解析 Web 访问日志、处理 CSV 业务报表,还是清洗抓取的文本数据,程序的数据流向基本都遵循“输入 ➔ 变换 ➔ 聚合 ➔ 输出”的经典模型。
文件操作模块(如 pathlib.Path 与内置 open)充当数据的“出入口”;字符串(str)负责微观层面的字符级规范化、切分与信息抽取;而列表(list)则作为宏观容器承载批量的规整结构,完成去重、切片分块、复合排序与内存缓冲。
二、字符串(String)高频处理模板
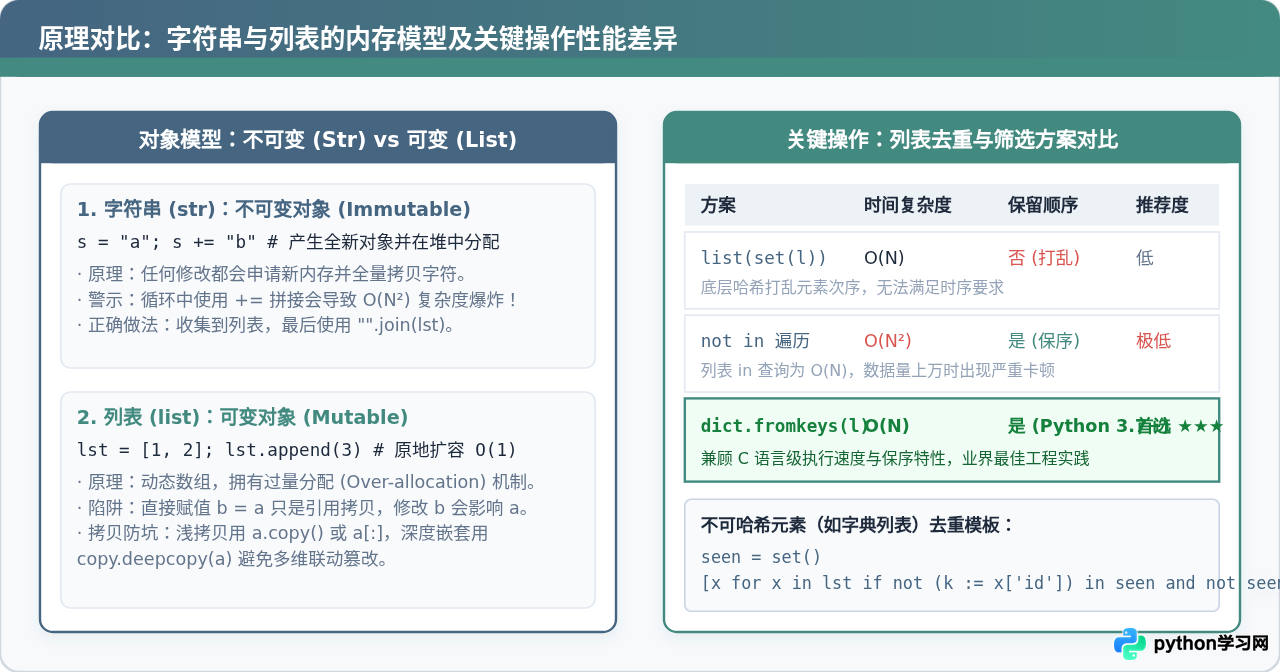
Python 的字符串是不可变对象(Immutable)。这意味着所有的清洗、替换、裁剪方法都会返回一个全新的字符串对象,而不会修改原字符串。这一特性保证了线程安全和哈希稳定性,但在进行频繁拼装时需要选用正确的工程方法。
1. 文本空白规范化与特殊不可见字符清理
从外部爬虫、用户表单或 PDF/Word 导出的文本中,常常混杂着连续空格、全角空格、制表符甚至换行符。仅使用 str.strip() 只能清理首尾,中间的混乱空白依然存在。
import re

def clean_whitespace(text: str) -> str:
    # 清理文本首尾空白,并将中间任意多个连续空白字符(含 \t, \r, \n 等)合并为单个空格
    if not text:
        return ""
    # \s+ 匹配一个或多个空白字符(包含全角空格与制表符)
    return re.sub(r'\s+', ' ', text).strip()

# 示例使用
raw_input = "  Python   全栈开发 \t\n   实战教程    \r\n"
cleaned = clean_whitespace(raw_input)
# 示例输出: 'Python 全栈开发 实战教程'
print(f"清洗结果: '{cleaned}'").replace().replace() 链式调用,建议使用 str.maketrans() 和 str.translate(),底层在 C 语言层完成单次遍历,效率提升可达数倍。
2. 多分隔符安全拆分与键值对解析
日志或配置文件中,一行数据可能同时使用逗号、分号、竖线或空格分割。使用 re.split() 可以一次性处理多种分隔符,同时自动剔除空字段。
import re

def split_by_delimiters(text: str, delimiters: str = r'[,;|\s]+') -> list:
    # 根据正则匹配的多种分隔符拆分字符串,并过滤掉空项
    tokens = re.split(delimiters, text.strip())
    return [token for token in tokens if token]

raw_tags = "Python; Django, FastApi | Flask   Tornado"
tags = split_by_delimiters(raw_tags)
# 示例输出: ['Python', 'Django', 'FastApi', 'Flask', 'Tornado']
print(f"解析后的标签列表: {tags}")
3. 正则表达式命名分组提取结构化字段
处理日志或特定格式的文本行时,使用命名分组 (?P<name>pattern) 可以让解析结果直接转为直观的 Python 字典,极大地增强代码的可读性与容错能力。
import re
from typing import Optional

LOG_PATTERN = re.compile(
    r'^(?P<ip>\d{1,3}(?:\.\d{1,3}){3})\s+-\s+\[(?P<time>[^\]]+)\]\s+'
    r'"(?P<method>[A-Z]+)\s+(?P<url>\S+)\s+HTTP/\d\.\d"\s+'
    r'(?P<status>\d{3})\s+(?P<bytes>\d+)'
)

def parse_log_line(line: str) -> Optional[dict]:
    match = LOG_PATTERN.match(line.strip())
    if match:
        data = match.groupdict()
        # 类型转换
        data['status'] = int(data['status'])
        data['bytes'] = int(data['bytes'])
        return data
    return None

# 示例解析
sample_log = '192.168.1.105 - [31/Oct/2026:10:00:00 +0800] "GET /api/v1/users HTTP/1.1" 200 4096'
parsed = parse_log_line(sample_log)
# 示例输出: {'ip': '192.168.1.105', 'time': '...', 'method': 'GET', 'url': '/api/v1/users', 'status': 200, 'bytes': 4096}
print(f"提取结构化字段: {parsed}")
4. 现代 f-string 格式化与对齐填充
Python 3.6 引入的 f-string 不仅性能优于 % 操作符和 str.format(),而且内置了强大的对齐、数值微调和千分位格式化能力:
price = 128456.789
ratio = 0.8523
title = "Python自动化"

# 1. 浮点精度与千分位分隔符
formatted_price = f"金额: {price:,.2f} 元"  # 金额: 128,456.79 元

# 2. 百分比格式化
formatted_ratio = f"完成率: {ratio:.1%}"    # 完成率: 85.2%

# 3. 字符宽度与对齐 (左对齐 <、居中 ^、右对齐 >,前面可加填充字符)
table_col = f"|{title:*^20}|"             # |*****Python自动化*****|

# 4. 调试自省 (Python 3.8+ 支持 f'{var=}')
user_id = 10024
debug_str = f"调试信息: {user_id=}, {price=:.2f}" # 调试信息: user_id=10024, price=128456.79
三、列表(List)高效处理模板
列表是 Python 中最常用的顺序集合,底层基于动态数组实现,支持 \(O(1)\) 的尾部添加和索引随机访问。处理列表时,核心关注点在于“推导式的合理使用”、“高性能保序去重”以及“分块批处理”。
1. 列表推导式与多条件复合筛选
列表推导式(List Comprehension)由底层 C 语言循环驱动,通常比手写 for 循环配合 append() 快 20%~40%。但应避免超过两层的嵌套推导,以免破坏可读性。
# 场景:从一组混合字典中提取状态为活跃的用户邮箱,并统一转为小写,过滤无效值
users = [
    {"id": 1, "email": "Alice@Tech.com", "active": True},
    {"id": 2, "email": "", "active": True},
    {"id": 3, "email": "BOB@SERVICE.ORG", "active": False},
    {"id": 4, "email": " Charlie@Example.CN ", "active": True},
]

active_emails = [
    cleaned_email
    for u in users
    if u.get("active") and (raw := u.get("email", "").strip())
    if (cleaned_email := raw.lower())
]
# 示例输出: ['alice@tech.com', 'charlie@example.cn']
print(f"清洗后的邮箱列表: {active_emails}")
2. 高性能保序去重模板(支持可哈希与不可哈希对象)
许多开发者习惯使用 list(set(seq)) 进行去重,但这会彻底破坏原本的元素先后顺序。在 Python 3.7+ 中,字典默认保留插入顺序,因此 dict.fromkeys() 成为效率最高、代码最短的保序去重方案。
from typing import TypeVar, Iterable, Callable

T = TypeVar('T')

# 方案 A: 基础可哈希类型(数字、字符串、元组)保序去重
def deduplicate_preserve_order(items: list) -> list:
    # 基于 dict.fromkeys 的 O(N) 极速保序去重
    return list(dict.fromkeys(items))

numbers = [3, 1, 2, 3, 4, 1, 5, 2]
print("去重结果:", deduplicate_preserve_order(numbers))
# 示例输出: [3, 1, 2, 4, 5]

# 方案 B: 复杂不可哈希类型(如字典列表),依据特定字段保序去重
def deduplicate_by_key(items: Iterable[dict], key_func: Callable[[dict], any]) -> list:
    seen = set()
    result = []
    for item in items:
        val = key_func(item)
        if val not in seen:
            seen.add(val)
            result.append(item)
    return result

data_stream = [
    {"order_id": 101, "item": "Keyboard"},
    {"order_id": 102, "item": "Mouse"},
    {"order_id": 101, "item": "Keyboard Duplicate"},
]
unique_orders = deduplicate_by_key(data_stream, key_func=lambda x: x["order_id"])
# 示例输出: [{'order_id': 101, 'item': 'Keyboard'}, {'order_id': 102, 'item': 'Mouse'}]
print("字典列表去重:", unique_orders)
3. 列表切片分块(Chunking)与批量调度
在批量调用第三方 API、向数据库执行 executemany 批量插入,或分批发送通知时,把一个包含数万条数据的庞大列表切分为固定大小的小批次(Chunk)是必不可少的模板操作。
from typing import Generator, Sequence

def chunk_list(seq: Sequence, chunk_size: int) -> Generator:
    # 将序列均匀切分为长度不超过 chunk_size 的块(惰性生成器)
    if chunk_size <= 0:
        raise ValueError("chunk_size 必须大于 0")
    for i in range(0, len(seq), chunk_size):
        yield seq[i : i + chunk_size]

# 示例:将 10 个元素按每批 3 个分块
records = [f"rec_{i}" for i in range(1, 11)]
for batch_idx, batch in enumerate(chunk_list(records, chunk_size=3), start=1):
    print(f"批次 {batch_idx}: {batch}")
# 批次 1: ['rec_1', 'rec_2', 'rec_3']
# 批次 2: ['rec_4', 'rec_5', 'rec_6']
# 批次 3: ['rec_7', 'rec_8', 'rec_9']
# 批次 4: ['rec_10']
4. 复合多键排序与多维字典排序
Python 内置的 sort()(就地排序)和 sorted()(返回新列表)采用稳定的 Timsort 算法。当需要按照“优先级从高到低、时间从早到晚”等多重条件排序时,通过传递元组作为 key 即可实现:
from operator import itemgetter

tasks = [
    {"name": "Task A", "priority": 2, "cost": 15},
    {"name": "Task B", "priority": 1, "cost": 25},
    {"name": "Task C", "priority": 2, "cost": 10},
    {"name": "Task D", "priority": 3, "cost": 5},
]

# 要求:首先按 priority 降序(优先级数字越大越优先),若 priority 相同则按 cost 升序(成本越低越好)
# 技巧:对需要逆序的数值字段取负号 -x['priority']
sorted_tasks = sorted(tasks, key=lambda t: (-t['priority'], t['cost']))

for t in sorted_tasks:
    print(f"{t['name']}: 优先级 {t['priority']}, 成本 {t['cost']}")
# 输出结果:
# Task D: 优先级 3, 成本 5
# Task C: 优先级 2, 成本 10
# Task A: 优先级 2, 成本 15
# Task B: 优先级 1, 成本 25
四、文件读写与路径操作模板(现代 Pathlib 体系)
传统 Python 代码常用 os.path.join()、os.path.exists() 等函数,不仅代码冗长,而且容易在跨平台开发(Windows 反斜杠 \ 与 Linux/macOS 正斜杠 /)时出现路径拼接 bug。从 Python 3.4 起引入的 pathlib.Path 已经成为文件与路径操作的标准方案。
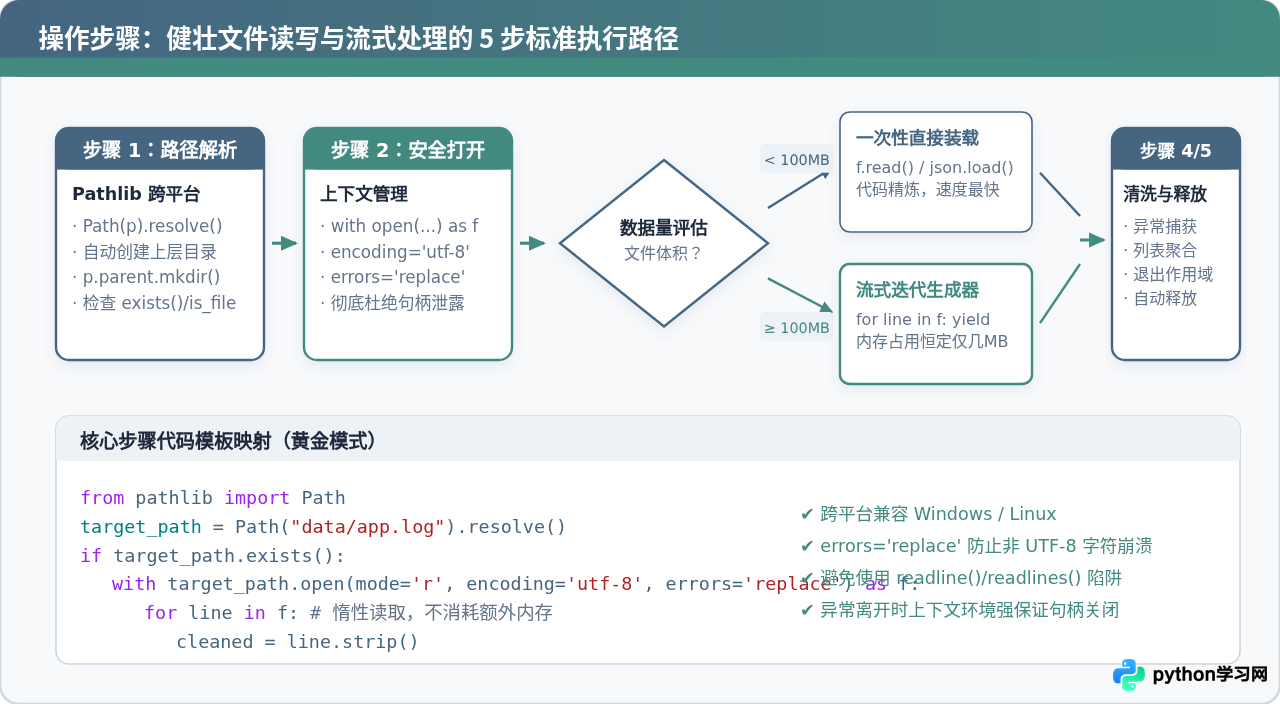
1. 跨平台路径管理与安全目录建制
在写入文件前,必须确保目标文件的父级目录已经存在,否则系统会抛出 FileNotFoundError。使用 Path.mkdir(parents=True, exist_ok=True) 可以一次性创建整个目录树且不惧目录已存在。
from pathlib import Path

def ensure_parent_and_get_path(file_path: str | Path) -> Path:
    # 标准化路径,并确保其父级目录树完整创建
    path = Path(file_path).resolve()
    # parents=True 递归创建多级目录,exist_ok=True 目录存在时不报错
    path.parent.mkdir(parents=True, exist_ok=True)
    return path

output_log = ensure_parent_and_get_path("logs/app/2026/service.log")
print(f"绝对路径确认: {output_log}")
print(f"文件名: {output_log.name}, 后缀: {output_log.suffix}, 父目录: {output_log.parent}")
2. 安全文本读写与防乱码编码规范
在 Windows 操作系统中,若调用 open() 时不传 encoding 参数,系统默认会采用 GBK 或系统区域编码,导致在 Linux/macOS 服务器部署时产生 UnicodeDecodeError。
encoding='utf-8'。若文件是由微软 Excel 导出的 CSV 文件,由于其附带 UTF-8 BOM 标记,读取时应指定 encoding='utf-8-sig',以防首个字段名称包含不可见的 \ufeff 乱码。
from pathlib import Path

def safe_write_text(file_path: str | Path, content: str) -> None:
    # 安全覆盖写入文本,确保编码为 UTF-8
    p = ensure_parent_and_get_path(file_path)
    with p.open(mode='w', encoding='utf-8', errors='replace') as f:
        f.write(content)

def safe_read_text(file_path: str | Path) -> str:
    # 安全读取文本,遇到未知损坏字符自动替换而非抛出异常中断任务
    p = Path(file_path).resolve()
    if not p.is_file():
        raise FileNotFoundError(f"目标文件不存在: {p}")
    with p.open(mode='r', encoding='utf-8', errors='replace') as f:
        return f.read()

# 测试写入与读取
test_file = "scratch/demo.txt"
safe_write_text(test_file, "Python 编程:字符串、列表与文件 I/O 模板。\n第二行数据。")
content = safe_read_text(test_file)
print("读取内容预览:\n" + content)
3. 大文件流式逐行处理生成器模板(内存恒定)
如果一个日志文件或数据集体积超过 1GB,切勿使用 f.readlines() 或 f.read().splitlines(),这会一次性将几 GB 的数据全部加载进内存,引发服务器 OOM(内存溢出崩溃)。正确的做法是利用文件句柄本身的迭代器协议配合 Python 生成器:
from pathlib import Path
from typing import Generator

def stream_large_file(file_path: str | Path) -> Generator:
    # 大文件逐行流式读取器,无论文件多大(10GB+),内存占用恒定在几 MB 以内
    p = Path(file_path).resolve()
    if not p.is_file():
        return

    with p.open(mode='r', encoding='utf-8', errors='replace') as f:
        for line in f:
            # 及时清洗行末换行符
            cleaned_line = line.rstrip('\r\n')
            if cleaned_line:  # 过滤纯空行
                yield cleaned_line

# 结合生成器进行逐行处理与聚合
# for line in stream_large_file("huge_access.log"):
#     process_log_entry(line)
4. 结构化 JSON 与 CSV 数据持久化模板
对于表格型和配置型数据,标准库的 json 和 csv 模块提供了原生的安全读写方式。以下是生产开发中最稳健的读写模板:
import json
import csv
from pathlib import Path

# --- A. JSON 模板 ---
def save_json(file_path: str | Path, data: dict | list) -> None:
    p = ensure_parent_and_get_path(file_path)
    with p.open('w', encoding='utf-8') as f:
        # ensure_ascii=False 确保中文字符不被转义为 \uXXXX,indent=2 保持缩进
        json.dump(data, f, ensure_ascii=False, indent=2)

def load_json(file_path: str | Path) -> dict | list:
    p = Path(file_path).resolve()
    with p.open('r', encoding='utf-8') as f:
        return json.load(f)

# --- B. CSV DictReader / DictWriter 模板 ---
def save_dict_to_csv(file_path: str | Path, rows: list, fieldnames: list) -> None:
    p = ensure_parent_and_get_path(file_path)
    # 注意 newline='',防止 Windows 系统写入 CSV 时多出一行空行
    with p.open('w', encoding='utf-8-sig', newline='') as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(rows)

def load_dict_from_csv(file_path: str | Path) -> list:
    p = Path(file_path).resolve()
    with p.open('r', encoding='utf-8-sig', newline='') as f:
        reader = csv.DictReader(f)
        return [dict(row) for row in reader]
五、综合实战模板:端到端日志清洗与统计管道
下面我们把上述“文件读取 ➔ 字符串解析清洗 ➔ 列表容器组织去重 ➔ 汇总写回”串联为一个完整的生产级脚本模板。该模板模拟处理一批日志文件,提取错误信息并汇总导出为清洗后的 CSV 报表。
from pathlib import Path
import re
import csv
from collections import Counter

LOG_EXTRACT_RE = re.compile(r'^\[(?P<time>[^\]]+)\]\s+\[(?P<level>[A-Z]+)\]\s+(?P<msg>.*)$')

def process_log_pipeline(input_log_path: str | Path, output_csv_path: str | Path) -> None:
    # 完整端到端流水线:
    # 1. 流式读取日志文件
    # 2. 字符串正则清洗提取
    # 3. 列表推导与过滤
    # 4. 统计聚合与持久化输出
    src = Path(input_log_path).resolve()
    dst = Path(output_csv_path).resolve()

    if not src.is_file():
        print(f"未找到输入文件: {src}")
        return

    parsed_records = []

    # 1. 安全打开并流式读取
    with src.open(mode='r', encoding='utf-8', errors='replace') as f:
        for line in f:
            line_str = line.strip()
            if not line_str:
                continue
            # 2. 字符串提取
            if match := LOG_EXTRACT_RE.match(line_str):
                record = match.groupdict()
                parsed_records.append(record)

    # 3. 列表操作:过滤出 ERROR 级别,并保序去重
    error_records = [r for r in parsed_records if r.get('level') == 'ERROR']

    # 基于消息内容去重
    seen_messages = set()
    unique_errors = []
    for r in error_records:
        clean_msg = re.sub(r'\s+', ' ', r['msg']).strip()
        r['msg'] = clean_msg
        if clean_msg not in seen_messages:
            seen_messages.add(clean_msg)
            unique_errors.append(r)

    # 按时间降序排列
    unique_errors.sort(key=lambda x: x['time'], reverse=True)

    # 4. 持久化回写到 CSV
    dst.parent.mkdir(parents=True, exist_ok=True)
    with dst.open(mode='w', encoding='utf-8-sig', newline='') as f:
        fieldnames = ['time', 'level', 'msg']
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(unique_errors)

    print(f"处理完成!解析总记录数: {len(parsed_records)},有效去重错误: {len(unique_errors)} 条,已导出至: {dst}")
六、避坑指南与全景决策树
为了在实际编写代码时快速排查隐患,我们将字符串、列表与文件 I/O 中最容易引发线上故障的典型陷阱及其正规解法汇总如下:
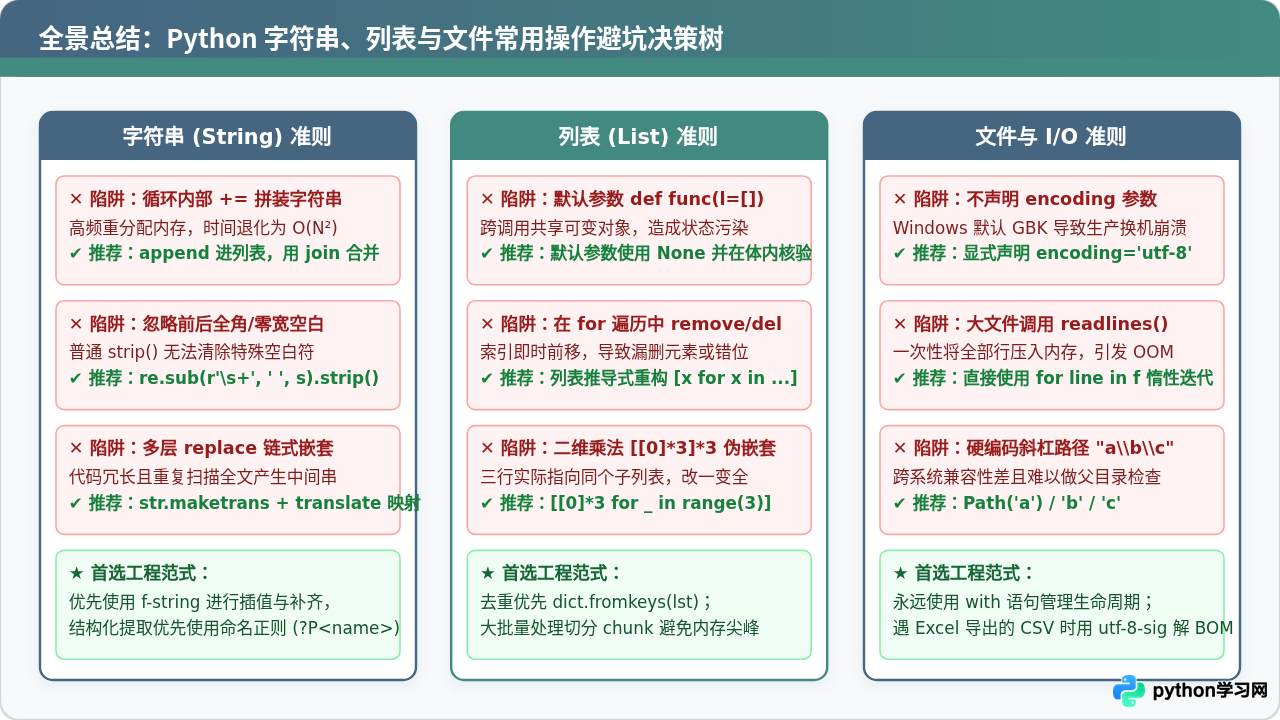
核心避坑清单
| 操作模块 | 常见错误做法 | 引发后果 | 标准修复范式 |
|---|---|---|---|
| 字符串 (String) | 在循环内使用 s += token 频繁拼接 |
每次拼接均重新分配内存,复杂度为 \(O(N^2)\),耗时剧增 | 将内容先 append() 到列表,最终执行 "".join(lst) |
| 字符串 (String) | 直接使用 text.strip() 清洗多空白混排 |
中间的换行、制表符及多个空格依然残留 | 使用 re.sub(r'\s+', ' ', text).strip() 彻底规范化 |
| 列表 (List) | 函数定义形参设置默认列表 def foo(data=[]) |
所有调用共享同一个列表对象,出现不可预期的状态污染 | 使用 def foo(data=None),并在函数内部 if data is None: data = [] |
| 列表 (List) | 在 for item in lst: 迭代循环中直接执行 lst.remove(item) |
内部游标跳跃,导致部分满足条件的元素被漏检 | 使用列表推导式重构生成新列表,或逆序遍历 for i in reversed(range(len(lst))) |
| 列表 (List) | 使用 list(set(seq)) 快速去重 |
集合的哈希机制打乱原本顺序,破坏时序业务语义 | 首选 list(dict.fromkeys(seq)),兼顾 \(O(N)\) 高性能与严格保序 |
| 文件 (File I/O) | 调用 open(path) 缺省 encoding 参数 |
跨系统运行时在 Windows 环境默认解析为 GBK 抛出解码异常 | 必须显式声明 open(path, encoding='utf-8') |
| 文件 (File I/O) | 对超大日志文件直接调用 f.readlines() |
几 GB 甚至几十 GB 的文本一次性载入内存,引发系统 OOM 崩溃 | 直接利用文件句柄迭代:for line in f: 结合生成器逐行消费 |
pathlib、re、csv、json)以及迭代器协议的透彻理解。牢记上述模板与防坑规则,能在日常开发中规避绝大部分隐蔽 Bug,大幅提升代码的健壮性与运行效率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









