

Python怎么读写文本文件和CSV数据
全面解析Python读写文本文件与CSV数据的标准实践。详细讲解内置open()上下文管理、UTF-8编码防乱码、逐行流式读取,以及标准库csv模块的reader、writer、DictReader与DictWriter用法,并给出生产环境下的常见报错排查与工具选型依据。
open() 函数与标准库 csv 模块即可安全高效地完成。掌握这两类数据的关键,在于使用 with 语句管理文件生命周期、显式声明 encoding='utf-8' 消除跨平台乱码,并在处理结构化数据时正确控制 newline='' 参数与表头映射。
一、纯文本文件的安全读取与写入
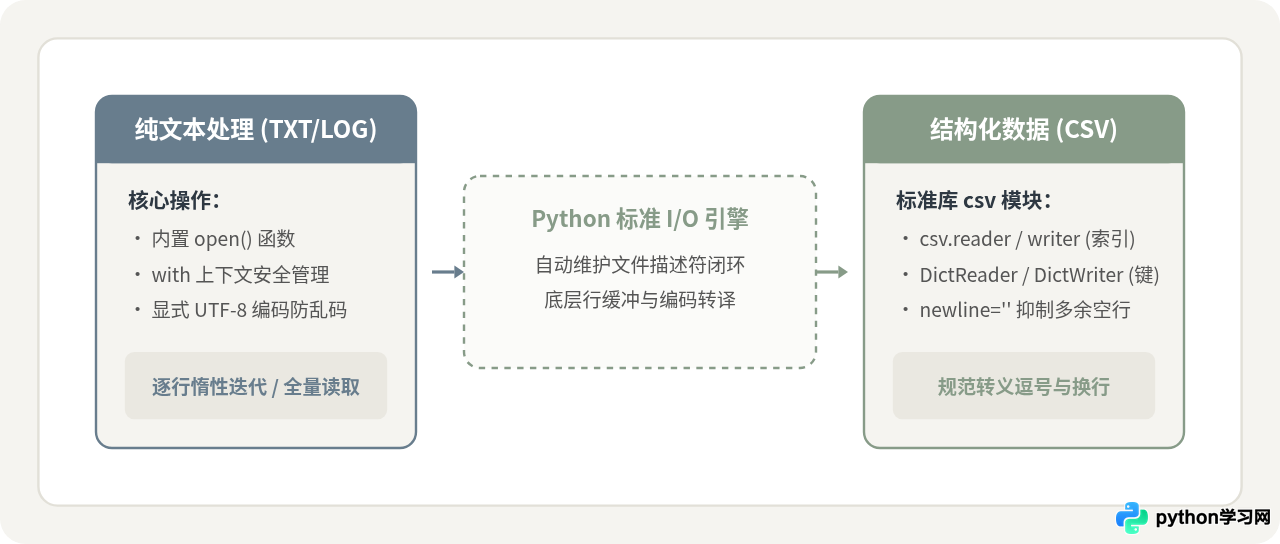
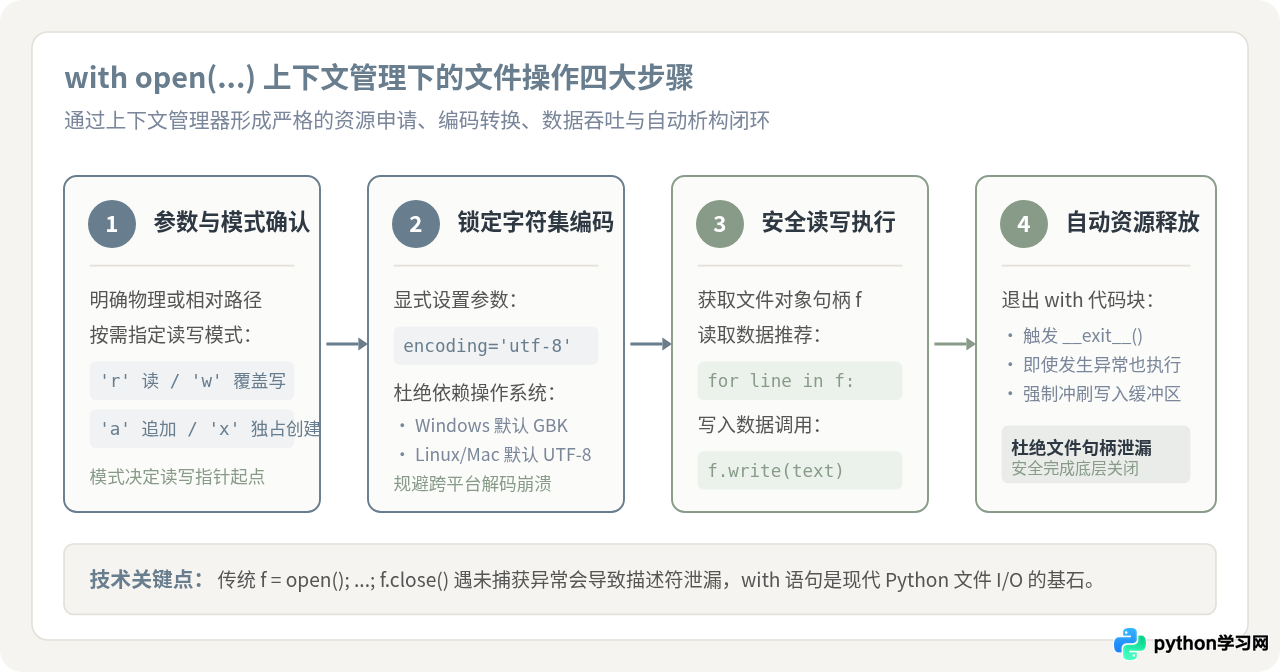
处理纯文本是文件 I/O 的起点。在 Python 中操作文本文件,核心要求是“打开即受控、读写不泄漏、编码有声明”。直接调用 f = open(...) 并在末尾手动 f.close() 的写法存在严重缺陷:一旦在读写过程中出现未捕获的异常,代码将跳过 close(),造成操作系统文件描述符泄漏。因此,现代 Python 统一推荐使用 with 上下文管理器。
1. 写入文本文件:覆盖写入与追加写入
写入文本通常使用两种模式:'w'(Write,覆盖写)和 'a'(Append,追加写)。为了避免因平台差异出现中文字符错乱,必须显式指定 encoding='utf-8'。
# 1. 覆盖写入模式('w'):若文件已存在,会直接清空原内容;若不存在则新建
with open('notes.txt', mode='w', encoding='utf-8') as f:
    f.write("第一行:系统初始化完成\n")
    f.write("第二行:记录参数配置\n")

# 2. 追加写入模式('a'):文件指针定位在文件末尾,在原内容后补充
with open('notes.txt', mode='a', encoding='utf-8') as f:
f.write("第三行:追加新的执行日志\n")当以 mode='w' 打开文件时,操作系统在建立文件句柄的瞬间就会将文件长度截断为零。这意味着即便后续没有执行任何 f.write(),原有内容也已丢失。对于需要保存历史数据的业务,必须使用 'a' 模式,或者使用 'x'(独占创建)模式以在文件已存在时直接报错保护原文件。
2. 读取文本文件:四种方式的差异与选择
读取文件时,很多初学者习惯直接使用 f.read(),但这在面对大文件时极具隐患。Python 提供了四种主要的文本读取方式,各自适用于不同的数据规模:
f.read():将整个文件一次性读入为一个完整的字符串。适合几十 KB 至数 MB 的小型配置文件或短文本,若用于 GB 级日志会直接耗尽可用内存导致程序崩溃。f.readline():单次只读取一行并包含行末的换行符。通常配合while循环进行条件探测。f.readlines():一次性将文件所有行读取并装入一个列表(list[str])。虽然支持按索引切片,但它同样会将整个文件装载进内存。for line in f:(强烈推荐):利用 Python 文件对象自带的惰性生成器机制。底层依靠系统行缓冲区,仅在迭代到当前行时才进行内存读取,内存占用始终保持在 O(1) 的极低水平。
# 推荐范式:逐行迭代处理(无论文本 100KB 还是 10GB 均能平稳运行)
with open('notes.txt', mode='r', encoding='utf-8') as f:
    for line_number, line in enumerate(f, start=1):
        # line 末尾自带换行符 '
',用 .strip() 清除空白
        clean_text = line.strip()
        if clean_text:
            print(f"[{line_number}] {clean_text}")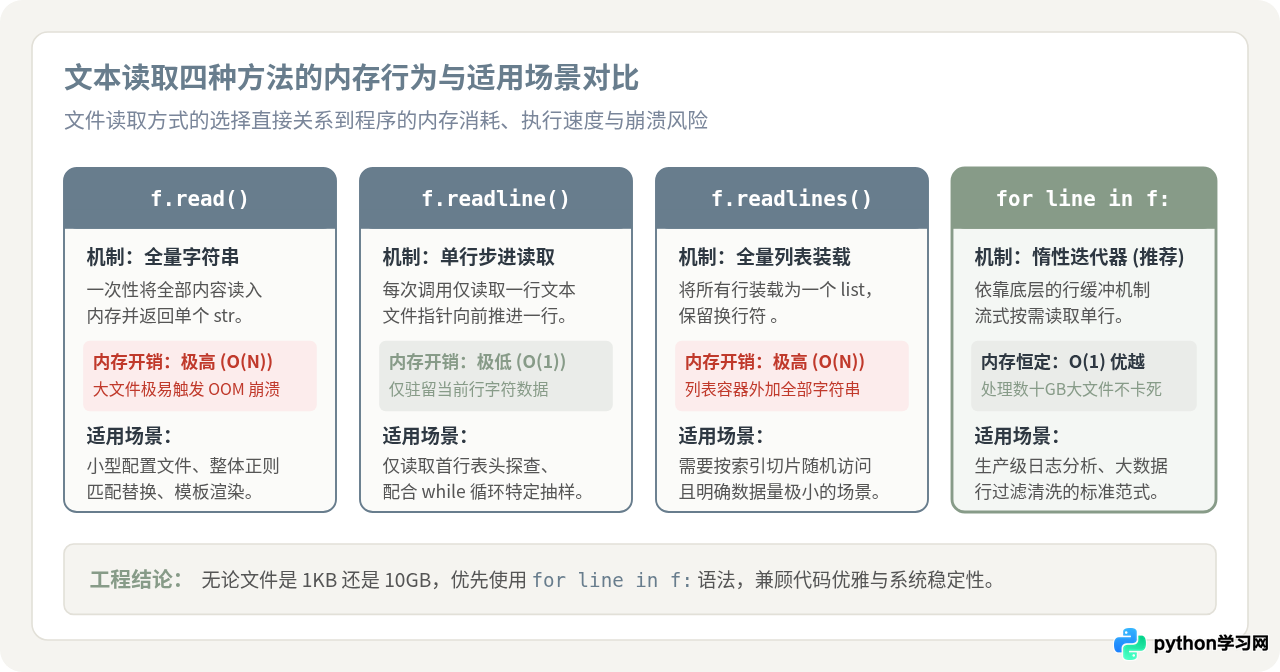
二、CSV 数据的规范读取与写入
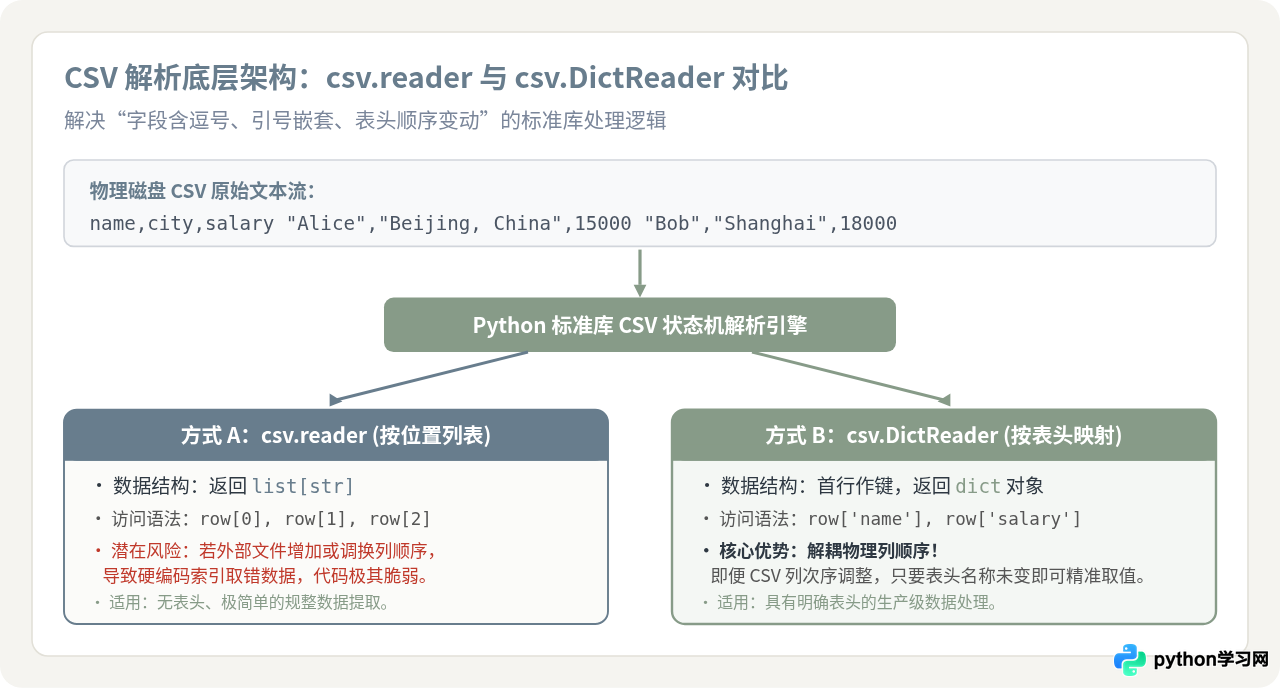
CSV(Comma-Separated Values,逗号分隔值)本质上是纯文本,但许多开发者容易犯一个常见错误:试图用 line.split(',') 自行解析。现实中的 CSV 经常包含带逗号的文本(例如地址 "Beijing, China")、包含双引号的转义字符、以及跨行内容。标准的 split() 会彻底破坏列对齐,因此必须使用 Python 标准库中的 csv 模块。
1. 读取 CSV:基础 reader 与字典 DictReader
csv 模块主要提供两种读取接口:基于索引列表的 csv.reader 和基于字典映射的 csv.DictReader。
import csv

# 准备测试数据
csv_file_path = 'users.csv'

# 方式一:使用 csv.reader(按数字下标访问)
with open(csv_file_path, mode='r', encoding='utf-8') as f:
    reader = csv.reader(f)
    header = next(reader)  # 提取表头
    print(f"表头字段: {header}")
    for row in reader:
        # row 是一个字符串列表,例如 ['张三', '技术部', '8500']
        print(f"姓名: {row[0]}, 部门: {row[1]}, 薪资: {row[2]}")

# 方式二:使用 csv.DictReader(按字段名键值访问,强力推荐)
with open(csv_file_path, mode='r', encoding='utf-8') as f:
    dict_reader = csv.DictReader(f)
    for row in dict_reader:
        # row 是字典,无需关心列的实际物理顺序
print(f"员工 {row['name']} 所属部门为 {row['department']}")在生产环境中,外部 CSV 文件经常因为系统升级而在中间插入新列,或者调换列顺序。如果使用 row[1] 这种硬编码数字索引,代码会无声无息地取到错误数据,甚至在后续类型转换时抛出异常。而 csv.DictReader 将首行直接作为字典的 Key,无论列顺序如何变化,只要表头名称匹配,代码就能稳定运行。
2. 写入 CSV 数据:必须特别注意 newline='' 参数
在 Python 中写入 CSV 时,有一个至关重要却极易遗漏的参数:open() 中的 newline=''。如果在打开文件时未添加此参数,在 Windows 等系统上每写入一行数据,输出文件中就会凭空多出一行空白行。
产生空行的原因:csv.writer 按照标准 CSV 规范默认在行尾生成
;若 open() 采用默认参数,Python 的底层文本 I/O 引擎会再次对换行符进行系统转换,把其中的
转换成
,最终写入了
,导致多数文本编辑器和 Excel 解析为多余的空行。指定 newline='' 则禁止了系统级二次转换。
import csv

# 写入数据列表
employees = [
    {"name": "李雷", "department": "市场部", "city": "Beijing, China", "salary": 9200},
    {"name": "韩梅梅", "department": "产品部", "city": "Shanghai", "salary": 11000}
]

fieldnames = ["name", "department", "city", "salary"]

# 使用 DictWriter 进行规范写入
with open('output_staff.csv', mode='w', encoding='utf-8', newline='') as f:
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()  # 写入表头行
    writer.writerows(employees)  # 批量写入多行数据
三、方案权衡:标准库 csv 模块 vs 第三方 Pandas
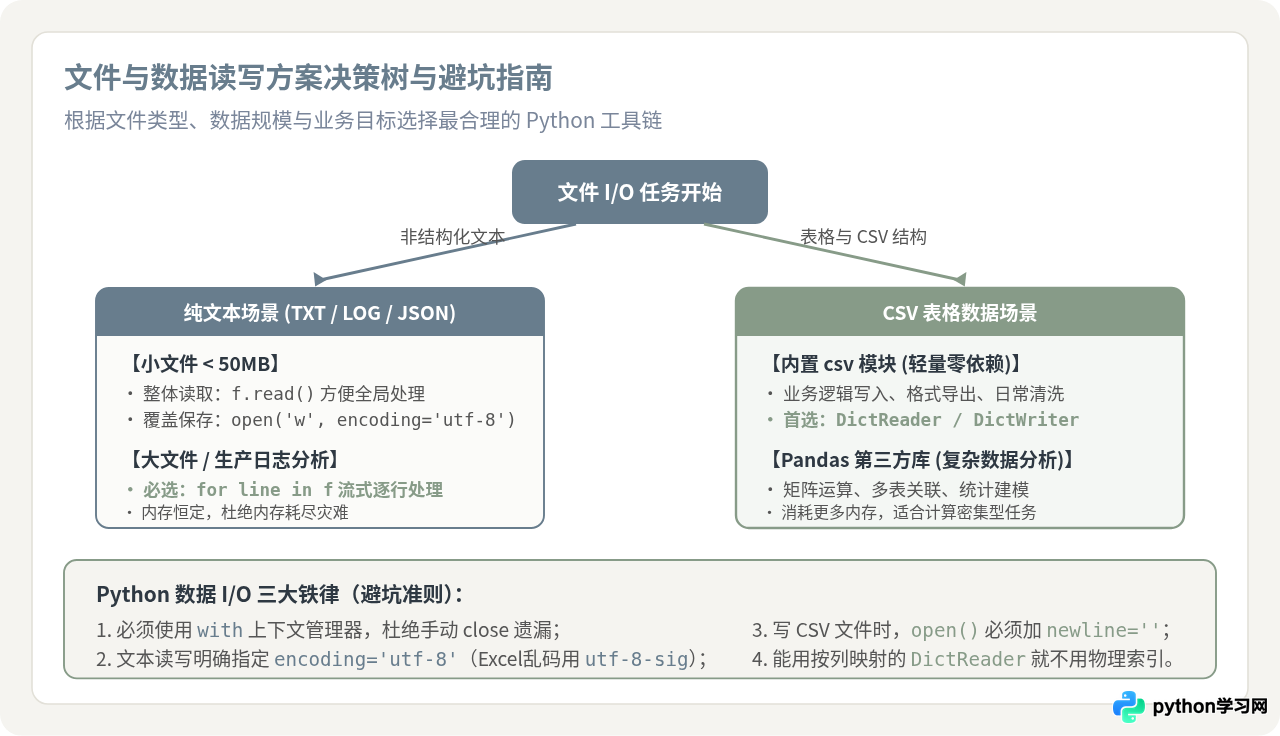
很多初学者会问:既然业界常提 import pandas as pd,为什么还要学习基础的 open() 和 csv 模块?两者并非互斥替代,而是在不同业务场景下的权衡取舍:
| 对比维度 | 标准库 open() + csv 模块 | 第三方库 Pandas (pd.read_csv) |
|---|---|---|
| 环境依赖 | 零第三方依赖,Python 自带,开箱即用 | 需安装额外依赖包(pandas、numpy 等,安装体积较大) |
| 内存占用机制 | 按行流式处理,内存恒定(极低) | 全量载入内存构建 DataFrame,内存通常为文件大小的 3-5 倍 |
| 适用场景 | 自动化脚本、流水线数据搬运、单行过滤清洗、轻量导出 | 多表关联(Join/Merge)、分组统计(GroupBy)、矩阵运算与可视化 |
| 代码启动耗时 | 毫秒级启动,无额外导入开销 | 模块导入与数据类型推断存在明显的冷启动耗时 |
选型原则:如果你的任务是日常的数据抓取、日志收集、简单的字段拼接或格式转换,请坚持使用标准库 csv 模块,它轻便、安全且不会给运行环境带来依赖困扰;只有在确实需要复杂的统计学计算、多维数据切片或矢量化运算时,才引入 Pandas。
四、三大高频报错排查与防御指南
在实际读写文件与 CSV 过程中,以下三个报错出现频率最高,掌握其发生根源便可轻松规避:
1. UnicodeDecodeError: 'gbk' codec can't decode byte...
根源:在 Windows 系统上,Python 默认采用系统的 ANSI/GBK 编码打开文件,当遇到 UTF-8 保存的文件时便会解码失败。
解决方案:永远在 open() 中显式补充 encoding='utf-8'。若文件是由旧版 Windows 软件生成的纯 GBK 文本,则对应声明 encoding='gbk'。
2. FileNotFoundError: [Errno 2] No such file or directory
根源:使用了相对路径(如 open('data.csv')),而终端运行脚本时的当前工作目录(Current Working Directory)并非脚本所在目录。
解决方案:使用 pathlib.Path 或 os.path 锚定当前脚本所在目录:
from pathlib import Path

# 获取当前脚本所在绝对目录,再拼接目标文件名
BASE_DIR = Path(__file__).resolve().parent
target_path = BASE_DIR / "data.csv"

with open(target_path, 'r', encoding='utf-8') as f:
    data = f.read()
3. 用 Excel 打开导出的 CSV 发现中文乱码
根源:微软 Excel 在打开 UTF-8 编码的 CSV 文件时,若文件头部缺少 BOM(Byte Order Mark)签名,会默认按照系统的本地编码(如简体中文 Windows 的 GBK)进行解析,从而将 UTF-8 误判为乱码。
解决方案:若生成 CSV 的明确用途是用 Excel 打开,可将编码参数设为 encoding='utf-8-sig',Python 会自动在文件开头写入 3 字节的 BOM 标头(\xEF\xBB\xBF),使 Excel 自动识别为 UTF-8 编码正常显示。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









