

从零到能写脚本:Python技能快速进阶指南
面向初学者的Python脚本进阶指南,解析如何从零起步掌握实用自动化脚本开发,涵盖路径处理、数据提取、异常保护与参数化实战。
编写实用的 Python 自动化脚本,并不需要读者事先通读数百页的面向对象理论或掌握庞大的 Web 开发框架。真实脚本的核心逻辑非常清晰:通过程序读取指定输入、批量执行规则转换、最后输出目标结果。只要掌握输入输出(IO)、基础数据结构(列表与字典)、条件循环流程以及 Python 自带的标准库工具,就能在短时间内独立写出解决重复劳动的高效工具。
一、认识脚本思维:从交互单行到单文件任务
许多初学者在命令行交互环境(如 Python REPL 或 Jupyter Notebook)中能逐行敲出代码,但面对具体任务时,往往不知道如何组织成一个可以双击或通过终端调用的独立文件。这二者之间的关键区别在于运行模式与任务边界。
交互式编程适合试验单条语句的返回值;而脚本则是一个自包含的运行单元。它具有明确的起点和终点,执行时自动完成“检查输入数据”、“逐项清洗或运算”、“将结果写入文件或控制台”的完整流程,并在遇到异常时给出明确反馈。
二、脚本的数据架构:输入、处理与输出(IPO模型)
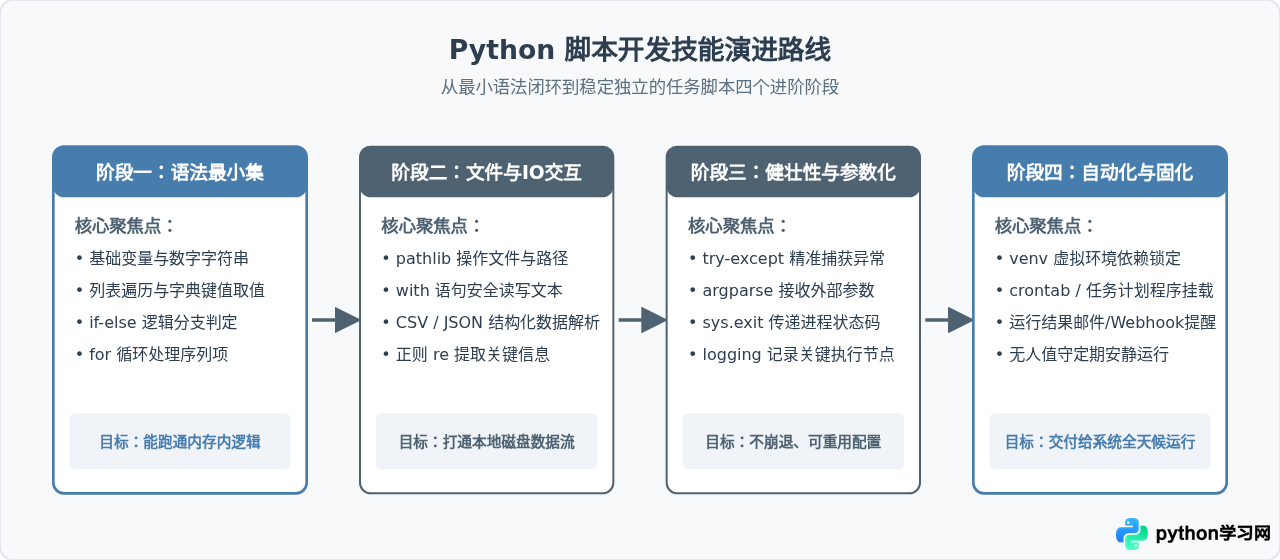
任何自动化脚本都可以拆解为 IPO(Input - Process - Output)三段式架构。明确这三个阶段的分工,能让代码脉络清晰,避免把路径扫描、业务计算和文件保存混杂在一起。
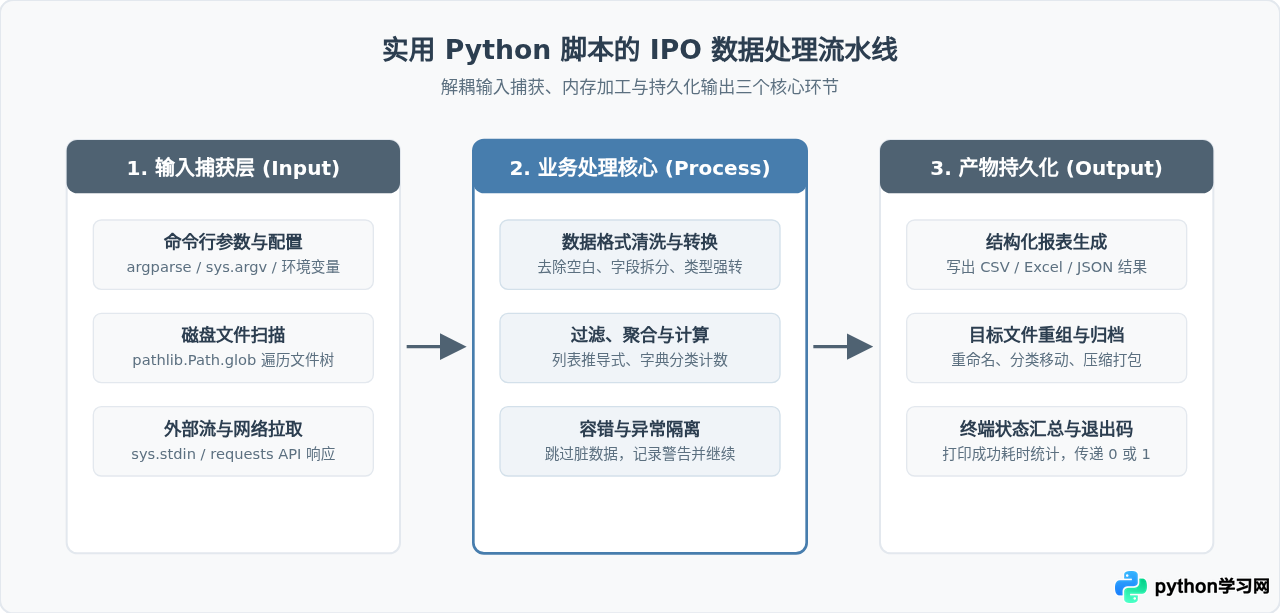
在这个模型下,编写脚本的过程就是依次实现这三个阶段。初学者最容易犯的错误是在循环中直接读写硬盘文件,导致逻辑耦合极深且难以排查报错。推荐的做法是:先将数据全部抽取到内存中规范的数据结构中,再执行纯粹的内存运算,最后集中批量写入目标介质。
三、写出第一个实用脚本:日志统计与异常文件归档
为了让理解更加具体,我们来看一个工作中最典型的自动化需求:系统产生了大量文本日志文件,需要扫描指定文件夹,提取其中的错误行(ERROR),生成汇总报告并自动将问题文件移至备份目录。
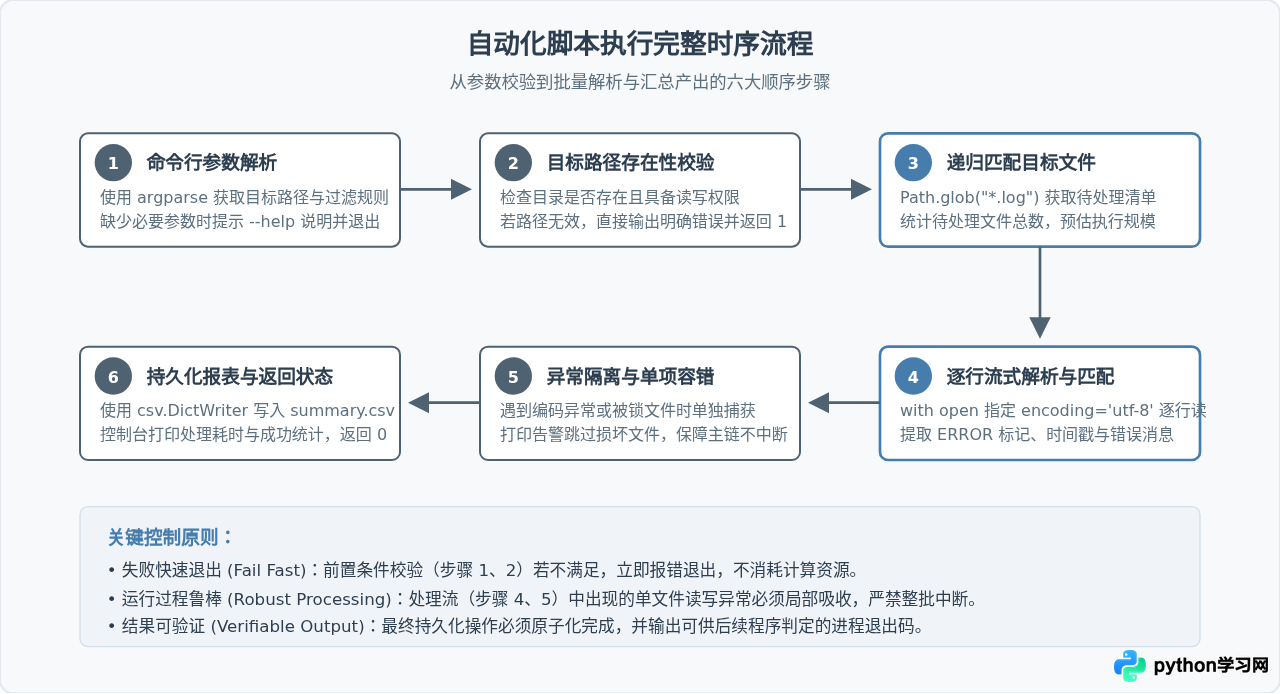
1. 操作步骤与时序流程
编写该脚本涉及 6 个严密的顺序动作。任何一个阶段出现异常,都需要进行针对性的防御控制。
2. 完整实战代码示例
以下是具备工业级健壮性的单文件 Python 脚本源码。代码仅依赖 Python 3 内置标准库,无需使用 pip install 安装第三方包:
import argparse
import csv
import sys
from pathlib import Path


def parse_arguments():
    """解析外部传入的命令行参数"""
    parser = argparse.ArgumentParser(
        description="扫描指定目录下的日志文件,提取 ERROR 记录并生成汇总报表"
    )
    parser.add_argument(
        "--input-dir",
        required=True,
        type=str,
        help="待扫描的日志文件夹路径",
    )
    parser.add_argument(
        "--output-csv",
        default="error_summary.csv",
        type=str,
        help="汇总报告保存路径(默认:error_summary.csv)",
    )
    return parser.parse_args()


def scan_and_extract_errors(log_file: Path):
    """
    流式读取单个日志文件,提取包含 ERROR 的行。
    使用局部异常处理,防止单个异常文件导致全盘退出。
    """
    records = []
    try:
        with log_file.open("r", encoding="utf-8", errors="replace") as f:
            for line_no, line in enumerate(f, start=1):
                if "ERROR" in line:
                    clean_content = line.strip()
                    records.append({
                        "file_name": log_file.name,
                        "line_number": line_no,
                        "error_text": clean_content
                    })
    except (OSError, PermissionError) as err:
        print(f"[警告] 无法读取文件 {log_file}: {err}", file=sys.stderr)
    return records


def save_summary_csv(output_path: Path, records: list):
    """将汇总错误记录原子化写出为标准 CSV 文件"""
    fieldnames = ["file_name", "line_number", "error_text"]
    with output_path.open("w", encoding="utf-8", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(records)


def main():
    args = parse_arguments()
    source_dir = Path(args.input_dir).resolve()
    target_csv = Path(args.output_csv).resolve()

    # 1. 前置校验:检查目录是否存在
    if not source_dir.is_dir():
        print(f"[错误] 输入目录不存在或不是有效目录:{source_dir}", file=sys.stderr)
        sys.exit(1)

    print(f"[*] 开始扫描目录:{source_dir}")
    log_files = list(source_dir.glob("*.log"))

    if not log_files:
        print("[提示] 该目录下未匹配到任何 *.log 文件,任务结束。")
        sys.exit(0)

    print(f"[*] 发现 {len(log_files)} 个日志文件,开始并发/流式提取...")

    total_records = []
    for current_file in log_files:
        errors = scan_and_extract_errors(current_file)
        if errors:
            total_records.extend(errors)

    # 2. 持久化输出
    save_summary_csv(target_csv, total_records)
    print(f"[完成] 共提取 {len(total_records)} 条错误记录,已保存至:{target_csv}")
    sys.exit(0)


if __name__ == "__main__":
    main()
运行与验证方式:在终端中输入 python analyze_logs.py --input-dir ./server_logs --output-csv ./report.csv。若目录存在且包含日志,脚本将输出处理进度并在目标路径生成合法的 CSV 文件。通过 echo $?(Linux/macOS)或 echo %ERRORLEVEL%(Windows)可以检查进程退出码是否为 0。
四、进阶核心能力:让脚本从“能跑”到“稳定”
完成一个简单脚本后,初学者往往会遇到“在自己电脑上能跑,换台电脑就报错”或者“数据量一大就卡死”的问题。要实现技能的快速进阶,必须掌握以下四项关键防护原则。
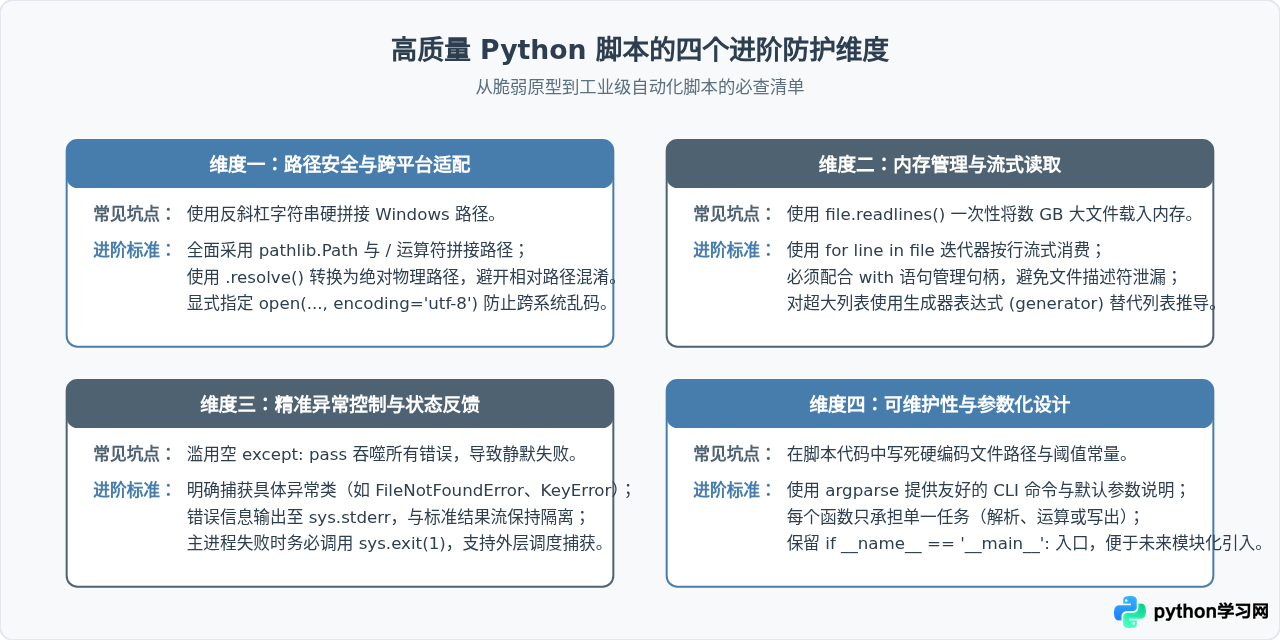
1. 彻底淘汰原始的 os.path 字符串拼接
自 Python 3.4 引入 pathlib 以后,面向对象的文件系统路径已成为标准实践。初学者常写的 os.path.join(dir, file) 在跨平台(Windows 倒斜杠与 POSIX 正斜杠)时容易产生转义问题。使用 Path 对象不仅语法简洁直观,还内置了检查文件类型、获取扩展名、读取文本等多项常用功能:
path.exists()与path.is_file():安全验证路径真实性。path.parent与path.name:直接获取父目录与文件名,无需繁琐的字符串切割。path.glob("*.csv"):无需引入glob库即可进行模式匹配。
2. 防御性文件打开与显式字符集编码
Windows 系统的默认文本编码通常为 GBK/ANSI,而现代开发环境产生的数据多为 UTF-8。如果不显式指定 encoding="utf-8",脚本在 Windows 命令行下运行极易抛出 UnicodeDecodeError。另外,在处理外部不可控文件时,添加 errors="replace" 可以在遇到损坏字符时自动将其替换为占位符,从而保护整个批处理流程不至于中途崩溃。
五、脚本进阶练习与下一步计划
要想巩固从零到编写脚本的这一跃升,建议初学者按照以下真实场景亲自动手练习:
- 下载文件夹整理器:读取系统下载文件夹,按文件扩展名(如 .pdf, .jpg, .zip)自动创建子文件夹并分门别类归档。
- 批量 Excel/CSV 报表合并器:遍历一个目录下的所有月度销售数据表格,核对字段表头,将有效行合并汇总为单张年度数据大表。
- 网页与接口健康巡检器:使用标准库
urllib.request定期访问一组服务接口,记录其响应耗时与状态码,并在连续失败时打印告警。
只要始终坚持“明确输入、纯粹处理、稳妥持久化”的原则,辅以必要的路径与异常防护,任何人都能在短时间内用 Python 写出可靠耐用的自动化工具,彻底摆脱低效的重复劳动。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









