

Python使用requests库下载文件并保存到本地
详细讲解在Python中使用requests库从网络下载文件并安全保存到本地磁盘的方法,涵盖小文件直接写入、大文件流式分块下载、文件名解析与异常处理机制。
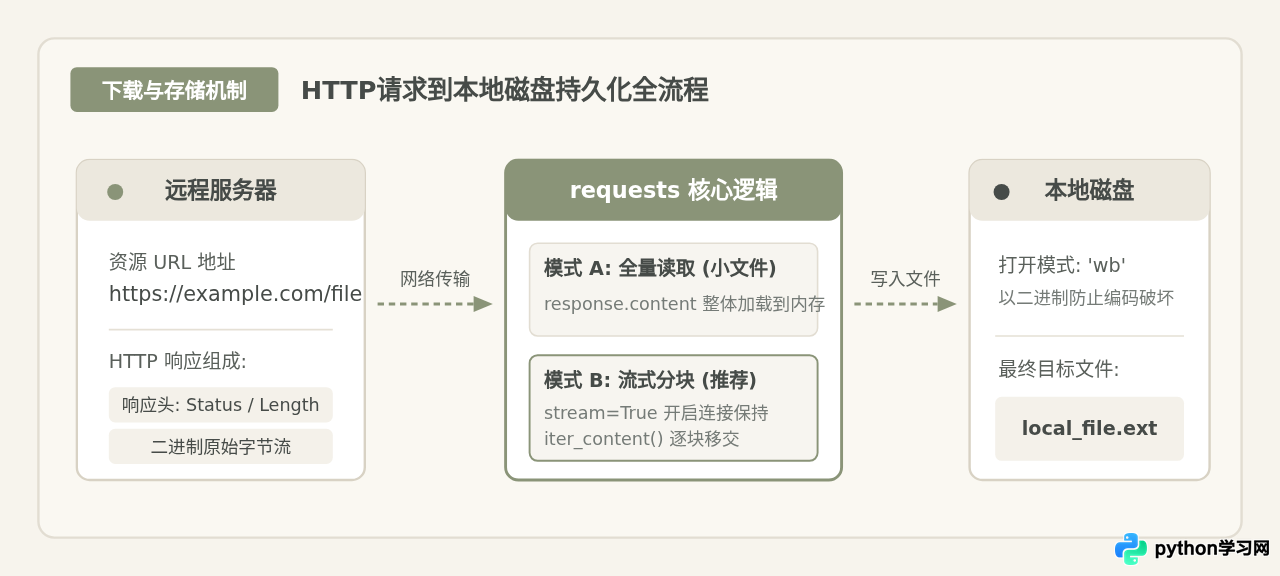
在 Python 中使用 requests 库下载文件并保存到本地,核心逻辑是通过发送 HTTP GET 请求获取远程服务器的数据流,并在本地以二进制写入模式("wb")创建目标文件,将响应内容持久化写入磁盘。对于文本或体积微小的资源,可以直接写入响应正文;而对于图片、压缩包、视频等常规及大体积文件,必须开启流式模式(stream=True)并通过 iter_content() 逐块写入,以避免耗尽系统内存。
一、准备工作与最简下载实现
在编写代码前,需要确保运行环境中已安装 requests 库。如果尚未安装,可在终端执行标准安装命令:
pip install requests对于几百 KB 到数 MB 以内的小型静态文件(如头像图标、纯文本文档、小型 JSON),可以直接通过 requests.get() 发起请求,并通过 response.content 获取返回的完整二进制字节流,随后用 Python 内置的文件操作写入磁盘:
import requests

url = "https://httpbin.org/image/png"
local_filename = "downloaded_image.png"

# 1. 发起网络请求
response = requests.get(url)

# 2. 检查响应状态码(若返回 4xx 或 5xx 会抛出 HTTPError 异常)
response.raise_for_status()

# 3. 以二进制写入模式保存到本地
with open(local_filename, "wb") as f:
    f.write(response.content)

print(f"文件已成功保存为:{local_filename}")
这段代码中包含两个至关重要的技术细节:
- 使用
"wb"模式而非"w":网络传输的文件绝大多数是二进制数据(如图片、可执行程序、ZIP 包)。如果在open()时使用文本写入模式"w",Python 会尝试对数据执行字符解码,并在不同操作系统下自动转换换行符(如 Windows 下将\n转换为\r\n),这会彻底破坏二进制文件的内部结构,导致文件损坏无法打开。 - 使用
response.content而非response.text:response.text是根据字符集解码后的 Unicode 字符串,只适用于纯文本网页;response.content则是未经解码的原始bytes数据,是保存文件的正确来源。
二、核心操作:大文件的流式分块下载
上述全量读取方式存在一个明显的瓶颈:response.content 会一次性把远端整个文件加载到计算机的物理内存中。如果要下载的文件大小为 2GB,而运行环境的可用内存只有 1GB,程序就会立即遭遇 MemoryError 甚至被系统直接终止。
针对任意大小的文件,标准做法是启用流式下载(Streaming Downloads)。其核心思想是让 requests 暂不一次性拉取全部数据,而是建立连接后,由开发者按指定的块大小(Chunk Size)边读取边写入。
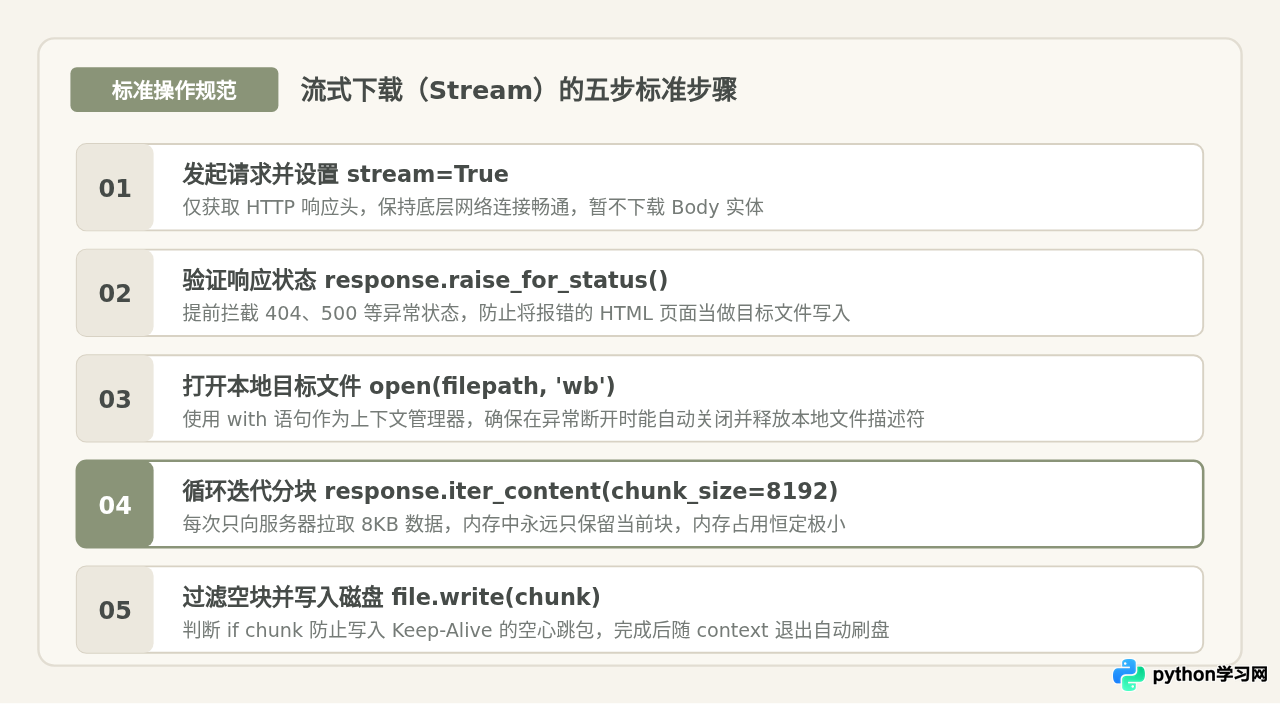
流式下载的完整参考代码如下:
import requests

def download_file_stream(url: str, save_path: str, chunk_size: int = 8192):
    """
    流式下载远程文件并写入本地
    :param url: 文件下载链接
    :param save_path: 本地保存的目标完整路径
    :param chunk_size: 分块字节大小,默认 8KB (8192 字节)
    """
    # 关键:开启 stream=True
    with requests.get(url, stream=True, timeout=(5, 30)) as response:
        # 校验 HTTP 状态码
        response.raise_for_status()

        # 写入本地文件
        with open(save_path, "wb") as f:
            for chunk in response.iter_content(chunk_size=chunk_size):
                # 过滤可能存在的保持连接的空块
                if chunk:
                    f.write(chunk)

# 调用示例
download_file_stream("https://example.com/large_archive.zip", "local_archive.zip")在这里,chunk_size 设置为 8192(即 8KB)。在实际开发中,一般建议设置为 8192(8KB)到 65536(64KB)或者 1048576(1MB)。太小会导致系统频繁发生 I/O 上下文切换,降低下载吞吐量;太大则会短暂增大每次迭代的内存开销。
三、深层辨析:全量读取与流式分块的底层差异
很多初学者会疑惑:“既然全量读取只需写两行代码,并且平时下载几兆的文件也从未报错,为什么还要大费周章使用 stream=True 和循环写入?”
这种做法在个人练习或处理小图标时看似可行,但在自动化脚本、生产爬虫或系统后台任务中,全量读取存在不可忽视的隐患。下图直观展示了两种机制在内存占用与数据流动上的根本差别:
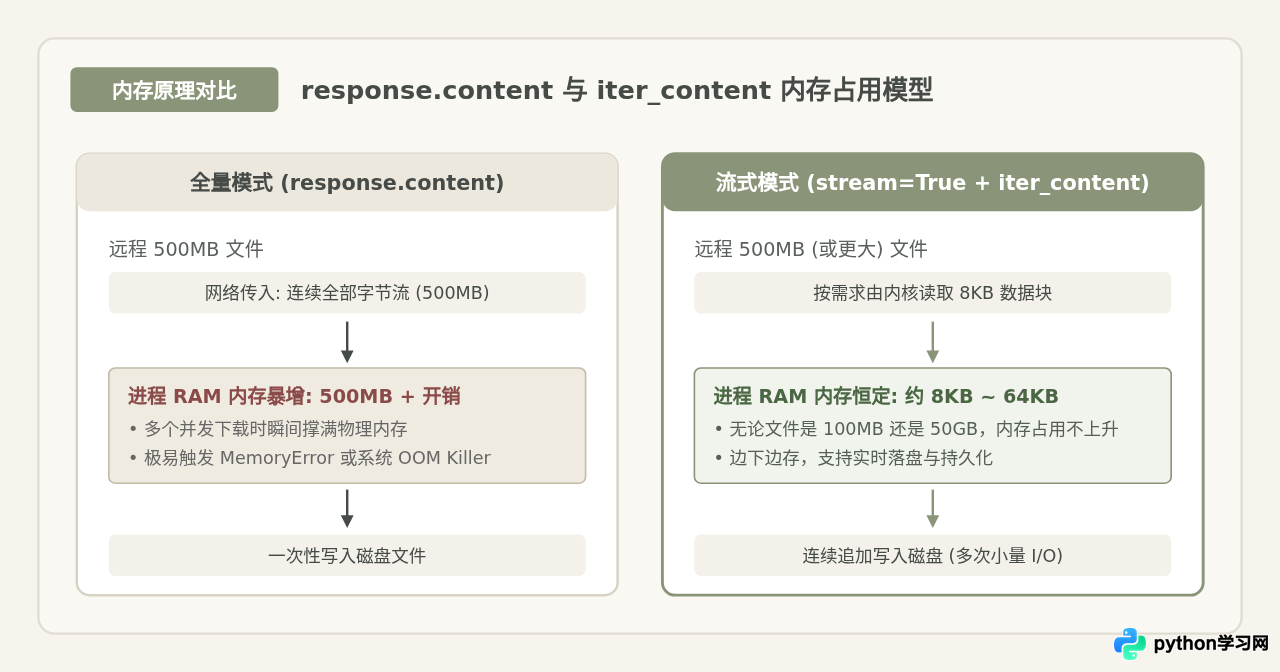
因此,对于不同场景,应建立明确的判断依据:
- 全量读取成立的条件:确认目标文件大小极小(例如小于 2MB),且程序是单次、一次性运行的简易脚本。此时直接写入更为简洁。
- 必须使用流式分块的场景:未知文件体积、大文件、批量连续下载,以及需要显示下载进度条的场景。
四、健壮性防护:状态校验、超时控制与文件名提取
在实际网络环境中,如果仅仅写出下载逻辑,很容易遇到连接卡死、保存了 404 报错网页、或本地文件名与远端不一致等问题。以下是构建健壮下载逻辑的三个核心防护措施:
1. 响应状态拦截与伪文件防护
当请求的 URL 失效返回 404 Not Found,或者服务器内部错误返回 500 时,HTTP 请求本身并未抛出 Python 代码异常,服务器仍会返回一个 HTML 格式的错误提示页面。如果不加判断直接 f.write(content),本地就会生成一个名称是 video.mp4 但内容实际是 <html><body>404 Not Found...</body></html> 的损坏文件。
解决方法是在打开本地文件写入前,明确调用 response.raise_for_status()。该方法会在状态码大于等于 400 时主动抛出 requests.exceptions.HTTPError,避免无效写入。
2. 网络超时参数的配置
requests.get() 默认不会设置超时时间(即 timeout=None)。如果远程服务器因网络阻塞未能返回数据,或者建立了 TCP 连接后不再发送字节,程序将无限期挂起阻塞。
在生产环境下,必须明确传入 timeout。建议以元组形式分别指定“连接超时”与“读取超时”:
# timeout=(连接超时秒数, 读取响应超时秒数)
response = requests.get(url, stream=True, timeout=(5, 30))
3. 确定真实的本地文件名
许多下载链接的 URL 末尾并不包含文件后缀,甚至可能是一个由哈希串或查询参数组成的动态地址(例如 https://example.com/download?id=12345)。要获取服务器推荐的文件名,不能仅靠截取 URL,而应首先检查响应头中的 Content-Disposition:
import re
from urllib.parse import urlparse, unquote

def extract_filename(response, fallback_url: str) -> str:
    """从 Content-Disposition 响应头或 URL 路径解析文件名"""
    cd = response.headers.get("content-disposition")
    if cd:
        # 尝试匹配 filename= 或 filename*=
        match = re.search(r'filename\*?=(?:UTF-8\'\')?["\']?([^"\';\r\n]+)', cd, re.IGNORECASE)
        if match:
            return unquote(match.group(1))

    # 若无响应头,则从 URL 路径截取
    path = urlparse(fallback_url).path
    filename = path.split("/")[-1]
    return unquote(filename) if filename else "downloaded_file.bin"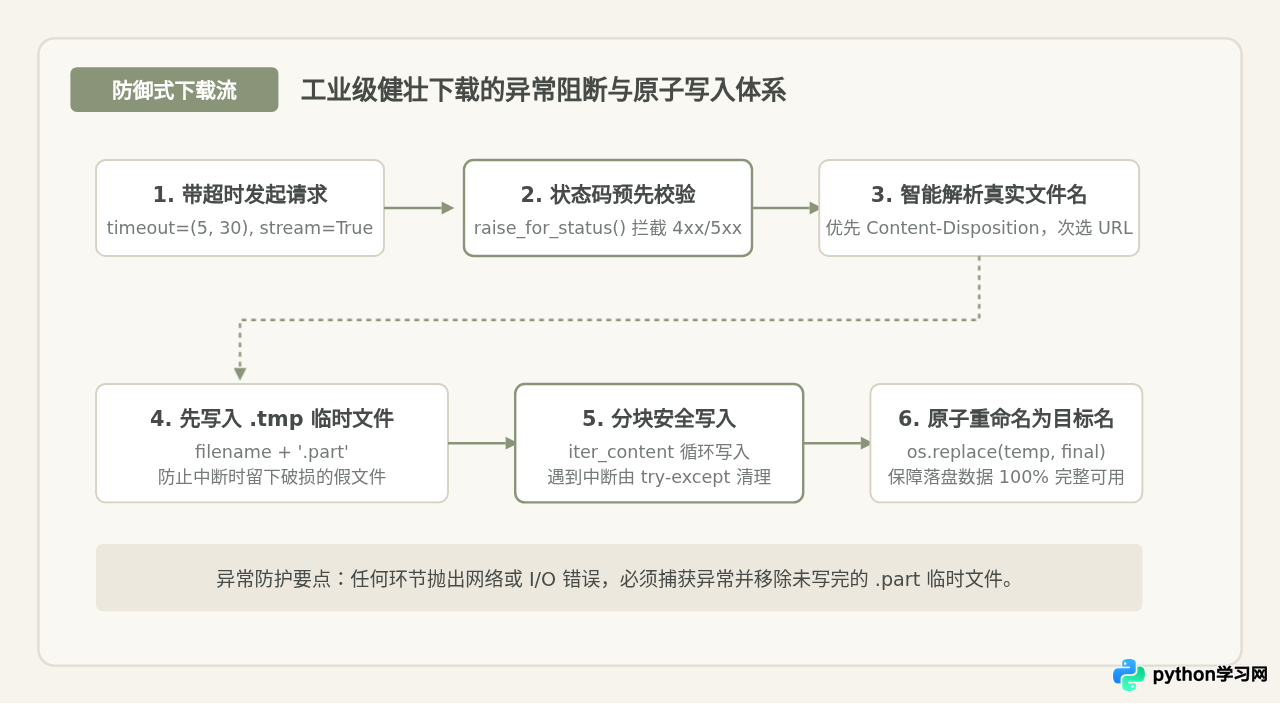
五、生产级完整示例:具备原子写入与进度提示的下载器
结合上述所有健壮性设计,下面提供一个可在生产环境直接复用的完整脚本。该脚本不仅进行了异常捕获和超时配置,还先将数据写入带有 .part 后缀的临时文件,全部下载无误后再重命名为目标文件,彻底杜绝了下载中断后留下半截损坏文件的问题:
import os
import requests

def safe_download(url: str, dest_dir: str = "./", filename: str = None) -> str:
    """
    健壮的工业级文件下载器
    :param url: 下载链接
    :param dest_dir: 目标保存目录
    :param filename: 自定义文件名(若为 None 则自动从响应头或 URL 提取)
    :return: 本地保存的绝对路径
    """
    os.makedirs(dest_dir, exist_ok=True)

    # 设置连接与读取超时
    try:
        with requests.get(url, stream=True, timeout=(6, 60)) as res:
            res.raise_for_status()

            # 若未指定文件名,自动推断
            if not filename:
                from urllib.parse import urlparse, unquote
                import re
                cd = res.headers.get("content-disposition", "")
                match = re.search(r'filename\*?=(?:UTF-8\'\')?["\']?([^"\';\r\n]+)', cd)
                if match:
                    filename = unquote(match.group(1))
                else:
                    path = urlparse(url).path
                    filename = unquote(os.path.basename(path)) or "download.bin"

            final_path = os.path.join(dest_dir, filename)
            temp_path = final_path + ".part"

            # 写入临时文件
            with open(temp_path, "wb") as f:
                for chunk in res.iter_content(chunk_size=65536):  # 64KB 块
                    if chunk:
                        f.write(chunk)

            # 下载完成,原子重命名
            os.replace(temp_path, final_path)
            print(f"下载完成并已校验落盘: {final_path}")
            return final_path

    except requests.exceptions.RequestException as err:
        print(f"网络请求发生错误: {err}")
        # 清理残余的临时文件
        if 'temp_path' in locals() and os.path.exists(temp_path):
            os.remove(temp_path)
        raise
    except IOError as err:
        print(f"本地磁盘文件写入失败: {err}")
        if 'temp_path' in locals() and os.path.exists(temp_path):
            os.remove(temp_path)
        raise

if __name__ == "__main__":
    # 测试示例
    test_url = "https://www.w3.org/WAI/ER/tests/xhtml/testfiles/resources/pdf/dummy.pdf"
    safe_download(test_url, dest_dir="./downloads")
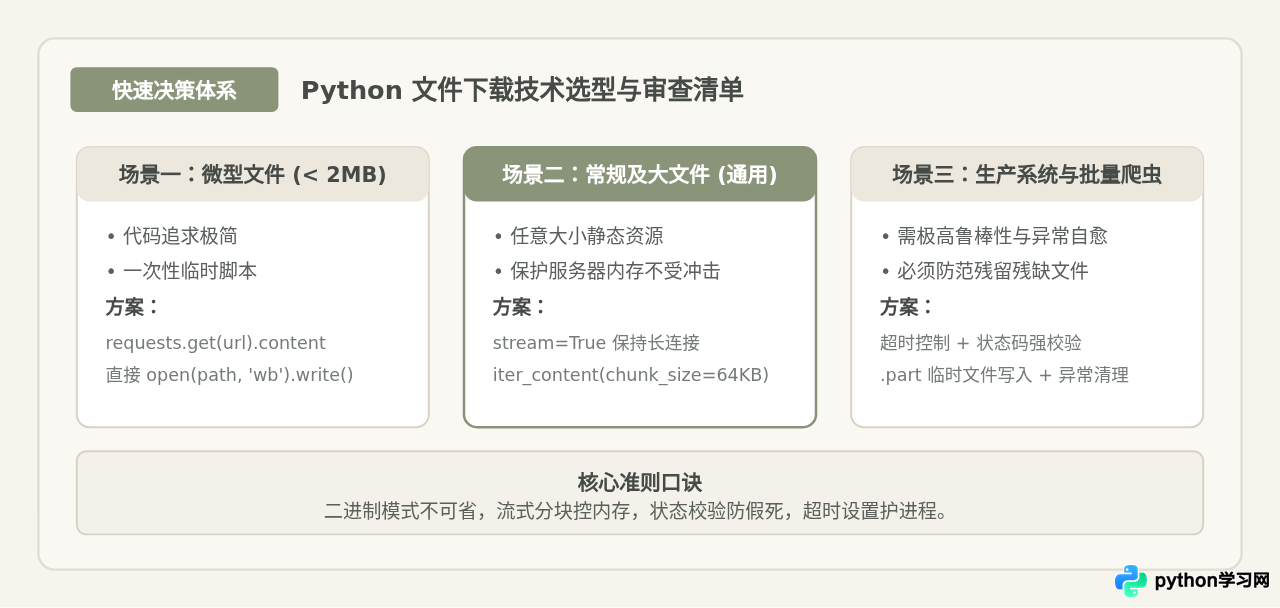
六、实践总结与决策清单
使用 requests 下载并保存文件时,遵循以下要点可以规避 99% 的常见故障:
| 考量维度 | 推荐方案 | 关键原因 |
|---|---|---|
| 文件打开模式 | open(..., "wb") |
防止操作系统对二进制字节执行换行符转义或文本编码导致数据损坏。 |
| 内存控制方式 | stream=True + iter_content() |
保持内存开销恒定,避免下载大文件或多线程并发时触发系统内存耗尽。 |
| 网络超时保护 | timeout=(5, 30) |
防止因远端服务器无响应或断网导致当前 Python 进程永久挂起。 |
| HTTP 状态校验 | response.raise_for_status() |
及时拦截 404/500 等错误状态,防止将报错的 HTML 网页保存为目标二进制。 |
| 文件落盘策略 | .part 临时文件写入后再 os.replace |
避免网络中断后留下半截损坏文件,保证落盘文件的原子完整性。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









