

Python列表、元组、集合与字典的核心区别
深入剖析Python中列表(list)、元组(tuple)、集合(set)与字典(dict)的底层存储模型、可变性、有序性与时间复杂度差异,提供清晰的业务选型决策指南与高频避坑实践。
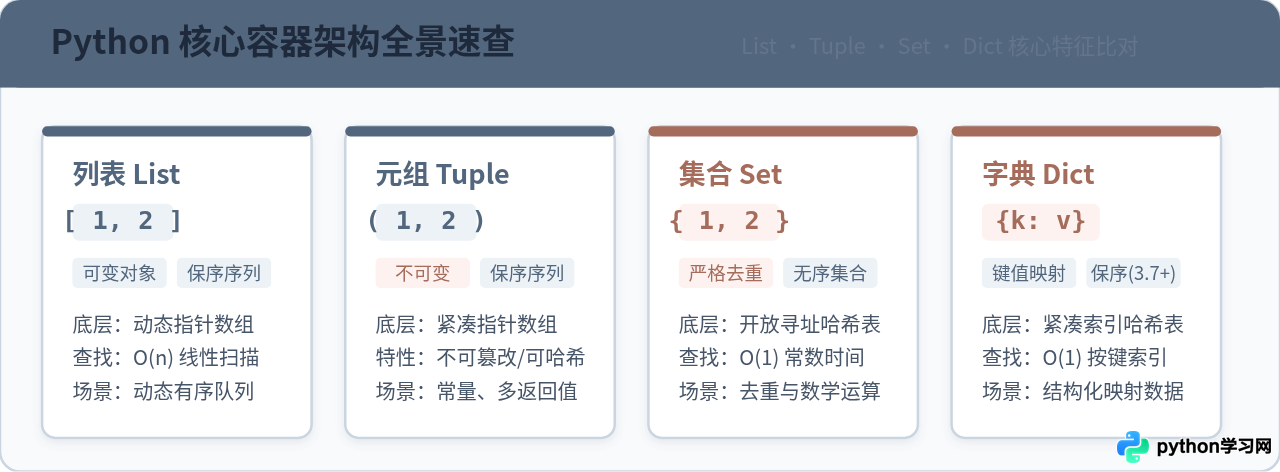
在 Python 中,列表(list)、元组(tuple)、集合(set)和字典(dict)是最常用的四大内置容器。初学者往往习惯按外层符号记忆它们(中括号、小括号、大括号),但在实际工程中,容器选型的依据从来不是语法外壳,而是底层存储结构带来的性能契约:数据是否需要键值映射、是否依赖位置次序、能否接受就地修改,以及元素是否必须保证唯一。理解这四者的核心区别,本质上是弄清“连续指针数组与开放寻址散列表”两种物理内存组织模型与“业务数据契约”之间的对应关系。
一、底层存储架构:连续数组与散列表的分野
要透彻理解四种容器的行为差异,首先需要从 CPython 的底层实现切入。Python 中的数据结构并没有凭空创造存储方式,它们在内存层面严格划分为两个阵营:连续指针数组和开放寻址散列表。
1. 连续指针数组(List 与 Tuple)
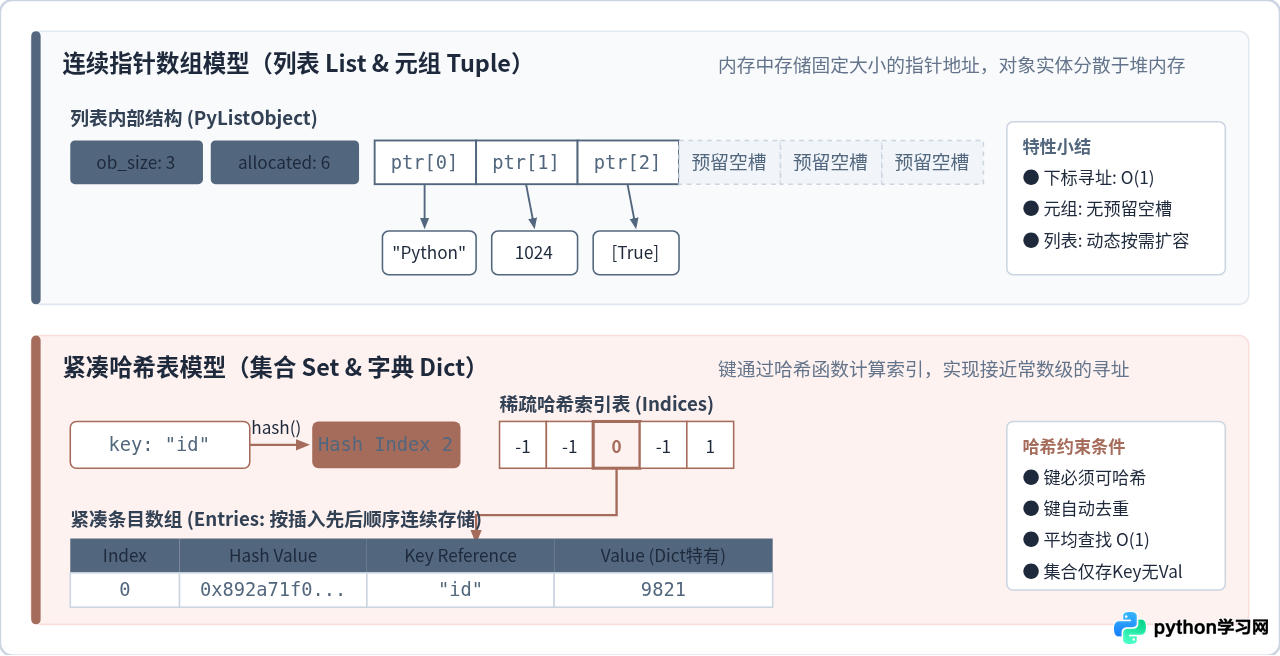
列表和元组在物理内存中均维护了一块连续的内存区域,专门用来存放对象的指针(PyObject*)。这意味着容器本身并不直接内嵌存储具体的数据对象,而是整齐地保存着各个对象在内存中的绝对地址。
这种设计的优势在于下标随机访问:计算 container[i] 时,系统只需通过基地址加上偏移量 base + i * sizeof(void*) 即可在 O(1) 常数时间内完成寻址。然而,两者的内存生命周期管理截然不同:
- 元组(Tuple):具有固定长度,在初始化时根据元素数量精确分配内存,没有任何容量冗余,结构最为紧凑。
- 列表(List):为了支持
append和extend等动态插入操作,CPython 为其设计了过度分配(Over-allocation)缓冲机制。列表内部同时维护着ob_size(实际元素数)与allocated(已分配内存插槽数)。当插槽占满时,列表会按一定比例(通常约为当前大小的 1.125 倍并补齐对齐)申请更大的连续空间并将原有指针复制过去。
2. 开放寻址散列表(Set 与 Dict)
集合与字典则完全摒弃了基于线性位置的指针排列,采用哈希表(Hash Table)组织数据。自 Python 3.6 起,字典采用了紧凑哈希表实现,将结构拆分为“稀疏哈希索引表(Indices)”与“紧凑条目数组(Entries)”。
当向字典存入或检索某个键时,Python 会先计算该键的哈希值 hash(key),通过位运算定位到稀疏索引表中的槽位,再通过槽位记录的序号找到紧凑条目数组中的实际键值对。由于哈希计算和数组偏移均在瞬间完成,其平均查找、插入与删除的时间复杂度均能达到 O(1)。集合的机制与字典完全同源,差异仅在于条目数组中不保存 Value,只保存 Key。
二、四大核心维度的对比与代码验证
建立底层认识之后,我们可以从四个与日常编码最为紧密的维度,具体考察它们展现出的行为边界。
维度一:可变性(Mutability)与不可变防线
列表和字典属于可变对象(Mutable),支持就地修改。对它们执行追加、删除或修改键值时,容器的内存物理地址(id())保持不变。
元组属于不可变对象(Immutable),一旦初始化完成,其长度和内部槽位引用的指针便被固化,无法新增、删除或替换元素。集合自身是可变容器,但其内部容纳的每一个元素必须是不可变(可哈希)的。
值得特别注意的是元组的“浅层不可变(Shallow Immutability)”:元组锁定的仅仅是自身的引用指针,并不保护其内部元素所引用的子对象。如果元组内嵌套了一个列表,该列表的内容依然可以随意改变。
# 验证浅层不可变性
nested_tuple = (1, 2, ["alpha", "beta"])
print("初始元组:", nested_tuple)

# 修改元组内部的列表元素(合法操作)
nested_tuple[2].append("gamma")
print("修改内部列表后:", nested_tuple)

# 尝试直接替换元组的元素槽位(将抛出异常)
try:
    nested_tuple[0] = 99
except TypeError as e:
print("抛出异常:", type(e).__name__, "-", e)初始元组: (1, 2, ['alpha', 'beta'])
修改内部列表后: (1, 2, ['alpha', 'beta', 'gamma'])
抛出异常: TypeError - 'tuple' object does not support item assignment维度二:元素有序性(Ordering)与索引检索
关于“是否有序”,需要分清两个层面的含义:一是是否维护插入顺序,二是是否支持下标位置索引。
- 列表与元组:绝对保序,且全面支持从 0 开始的正向索引、负数倒序索引以及任意切片语法(如
seq[1:3])。 - 字典:在 Python 3.7+ 已正式成为语言规范的保序容器,会严格保留键值对的插入先后次序。但字典仅支持按键检索(
dict[key]),不支持按位置下标切片。 - 集合:完全无序。集合输出时的顺序由散列表当前的哈希槽位分布决定,不仅无法保证插入顺序,更无法使用任何下标或切片访问。
# 集合与列表的有序性差异
sample_list = [30, 10, 20, 10]
sample_set = {30, 10, 20, 10}

print("列表切片访问 [0:2]:", sample_list[0:2])
print("集合内容:", sample_set)

try:
    # 集合不支持下标访问
    _ = sample_set[0]
except TypeError as e:
print("集合下标访问报错:", type(e).__name__, "-", e)列表切片访问 [0:2]: [30, 10]
集合内容: {10, 20, 30}
集合下标访问报错: TypeError - 'set' object is not subscriptable维度三:元素唯一性与哈希协议(Hashable)
列表和元组允许任意数量的重复元素存在,并忠实记录每一次出现的物理位置。
集合的全部元素、以及字典的键(Keys),必须遵循严格的唯一性。在存入新元素时,Python 会同时通过 hash(x) == hash(y) 与 x == y 判断是否冲突。如果判定为重复,旧值将被覆盖或忽略。
因为哈希寻址要求键的哈希值在生命周期内必须稳定恒定,所以任何可变对象(如列表、字典、集合自身)都无法通过可哈希性检验,不可作为集合元素或字典的键。
# 哈希协议限制验证
valid_dict = {(1, 2): "元组作为键合法"}
print("合法字典:", valid_dict)

try:
    # 尝试使用列表作为字典的键
    invalid_dict = {[1, 2]: "列表作为键非法"}
except TypeError as e:
print("不可哈希异常:", type(e).__name__, "-", e)合法字典: {(1, 2): '元组作为键合法'}
不可哈希异常: TypeError - unhashable type: 'list'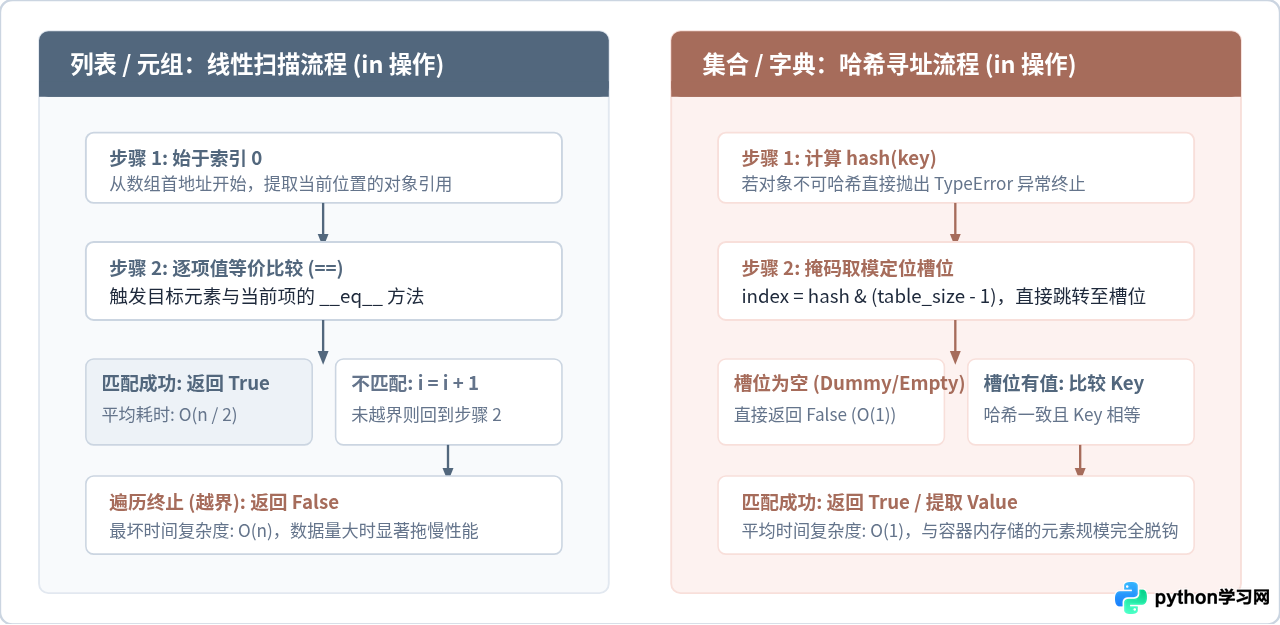
三、时空复杂度与内存开销评估
底层结构直接投射在运行效率上。在编写高频调用的业务模块或处理大规模数据时,选错容器类型可能导致程序运行速度出现数量级上的滑坡。
| 操作项 | 列表(List) | 元组(Tuple) | 集合(Set) | 字典(Dict) |
|---|---|---|---|---|
| 下标/键寻址 | O(1) | O(1) | 不支持 | O(1) |
| 包含性检测 (item in c) | O(n) 线性穷举 | O(n) 线性穷举 | O(1) 哈希瞬时 | O(1) 仅针对Key |
| 末尾追加 (Append) | 分摊 O(1) | 不支持 (需新建) | O(1) (add) | O(1) (键赋值) |
| 中间插入/删除 | O(n) 内存数据搬移 | 不支持 | O(1) | O(1) |
| 内存消耗级别 | 中等 (预留缓冲) | 极紧凑 (无冗余) | 较高 (哈希稀疏表) | 较高 (稀疏表+条目) |
包含性检测(in)的真实差异
许多性能瓶颈源于在循环体内部对一个长列表频繁使用 if item in my_list:。由上表可见,列表必须从头至尾遍历指针(最坏情况遍历全部 n 项);而如果把数据提前转为集合或字典,判断操作将直接通过哈希定位,不论容器中包含 10 个元素还是 100 万个元素,耗时基本维持恒定。
内存占用差异实测
我们可以通过标准库的 sys.getsizeof() 直观查看容纳相同整数时各容器的基础字节开销:
import sys

# 容纳 5 个相同整数的容器开销对比
items = [10, 20, 30, 40, 50]
t_obj = (10, 20, 30, 40, 50)
s_obj = {10, 20, 30, 40, 50}
d_obj = {10: 1, 20: 1, 30: 1, 40: 1, 50: 1}

print("元组内存开销:", sys.getsizeof(t_obj), "bytes")
print("列表内存开销:", sys.getsizeof(items), "bytes")
print("集合内存开销:", sys.getsizeof(s_obj), "bytes")
print("字典内存开销:", sys.getsizeof(d_obj), "bytes")元组内存开销: 80 bytes
列表内存开销: 104 bytes
集合内存开销: 728 bytes
字典内存开销: 184 bytes可以看到,元组以 80 字节保持着极致的紧凑性;列表由于动态管理稍大;而集合为了在哈希冲突下保持 O(1) 效率,直接申请了相对庞大的基础哈希桶(CPython 默认起步即为数百字节)。这是典型的以空间换取时间的工程权衡。
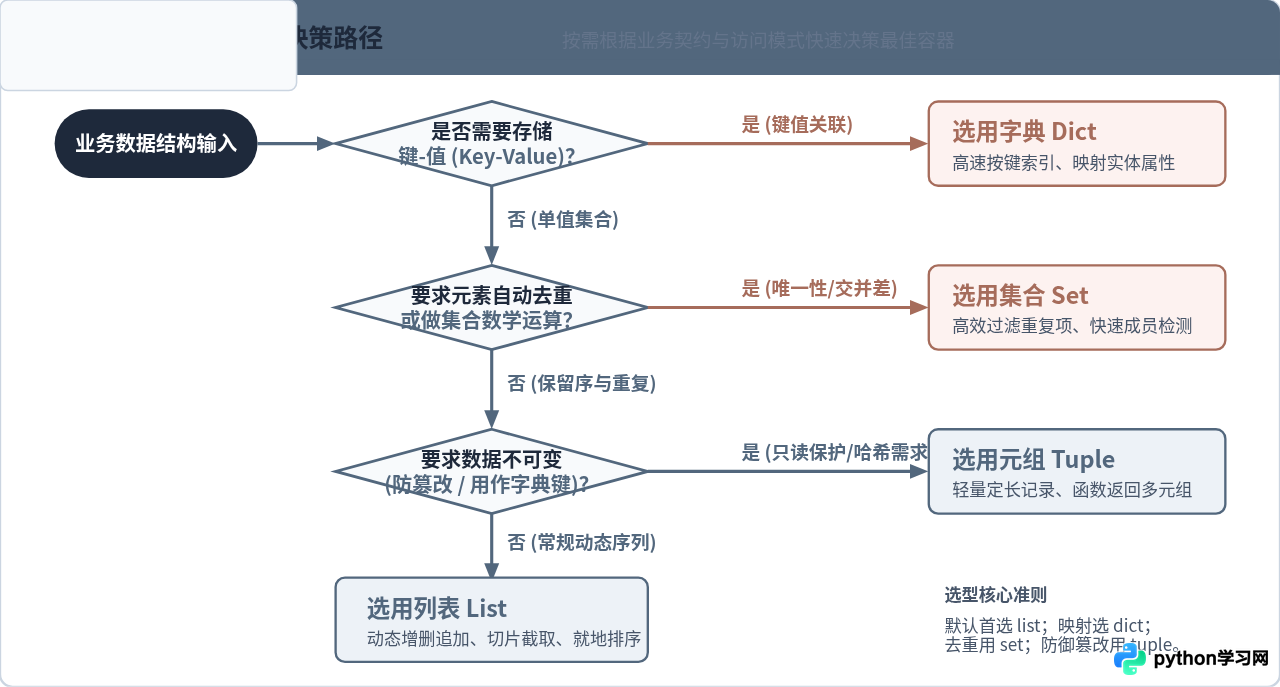
四、业务场景选型四步法
在实际业务开发中,选择容器并不需要死记硬背特征,只需按照如下决策流程逐步过滤:
- 第一步(关系维度):数据项之间是否需要“键-值”映射来表达属性关系?如果是(例如用户信息、接口响应参数、配置字典),毫不犹豫选用 字典(Dict)。
- 第二步(唯一性与运算维度):若仅是一组单纯的值序列,判断是否需要高频过滤重复项,或者需要求交集、并集、补集?如果是(例如标签去重、在线用户 ID 过滤、权限求交),选用 集合(Set)。
- 第三步(防御性与可哈希维度):数据项是否属于不可更改的固定常量记录,或者是否需要作为字典的复合键?如果是(例如三维坐标点
(x, y, z)、数据库查询只读记录、函数返回的多个固定参数),选用 元组(Tuple)。 - 第四步(动态集合维度):数据是否需要在后续逻辑中动态增删、就地反转、排序,或者按索引切片截取?只要满足常规动态顺序管理,默认选用 列表(List)。
五、高频踩坑场景与防御性编程
由于对容器特性的理解不全面,实际项目中经常出现一些极具隐蔽性的 Bug。这里总结最典型的三个陷阱:
陷阱 1:使用可变容器作为函数默认参数
在 Python 中,函数定义中的默认参数在模块加载时只被计算和创建一次。如果把 list 或 dict 直接设为默认值,多次调用该函数将共享同一个容器实例,造成跨调用的状态数据污染。
# 错误示范:共享可变默认参数
def add_item_bad(val, target=[]):
    target.append(val)
    return target

# 正确写法:使用不可变的 None 作为哨兵
def add_item_good(val, target=None):
    if target is None:
        target = []
    target.append(val)
    return target

print("错误调用 1:", add_item_bad("A"))
print("错误调用 2:", add_item_bad("B"))  # target 累积了之前的数据!
print("正确调用 1:", add_item_good("A"))
print("正确调用 2:", add_item_good("B"))错误调用 1: ['A']
错误调用 2: ['A', 'B']
正确调用 1: ['A']
正确调用 2: ['B']陷阱 2:遍历列表的同时就地执行删除
列表内部依靠紧凑索引遍历。在 for item in my_list: 循环体内直接执行 my_list.remove(item) 或 del 会导致后续元素向前位移,使得遍历指针跳过紧挨着的下一个元素。
raw_data = [1, 2, 2, 3, 4]

# 错误做法:直接遍历中删除
for num in raw_data:
    if num == 2:
        raw_data.remove(num)
print("就地删除后的残留结果:", raw_data)  # 第二个 2 会被跳过!

# 正确做法:使用列表推导式生成新列表,或倒序遍历
clean_data = [x for x in [1, 2, 2, 3, 4] if x != 2]
print("推导式过滤的正确结果:", clean_data)就地删除后的残留结果: [1, 2, 3, 4]
推导式过滤的正确结果: [1, 3, 4]陷阱 3:使用 set() 去重导致原本的顺序被打乱
list(set(seq)) 是一种流传甚广的去重技巧,但由于集合是散列表,去重后原本由列表维系的元素先后顺序将被破坏。如果业务场景需要保持原顺序去重,应利用字典天然的保序去重特性:
items_with_dups = ["apple", "banana", "apple", "cherry", "banana"]

# set 去重:顺序不可控
set_dedup = list(set(items_with_dups))
print("set 去重结果 (失序):", set_dedup)

# dict.fromkeys() 去重:严格保留首次出现的先后顺序
ordered_dedup = list(dict.fromkeys(items_with_dups))
print("dict 去重结果 (保序):", ordered_dedup)set 去重结果 (失序): ['cherry', 'banana', 'apple']
dict 去重结果 (保序): ['apple', 'banana', 'cherry']六、核心区别全景总结
综上所述,Python 列表、元组、集合与字典并非互为替代品,而是针对不同访问频次、内存敏感度和数据契约而量身打造的组件。
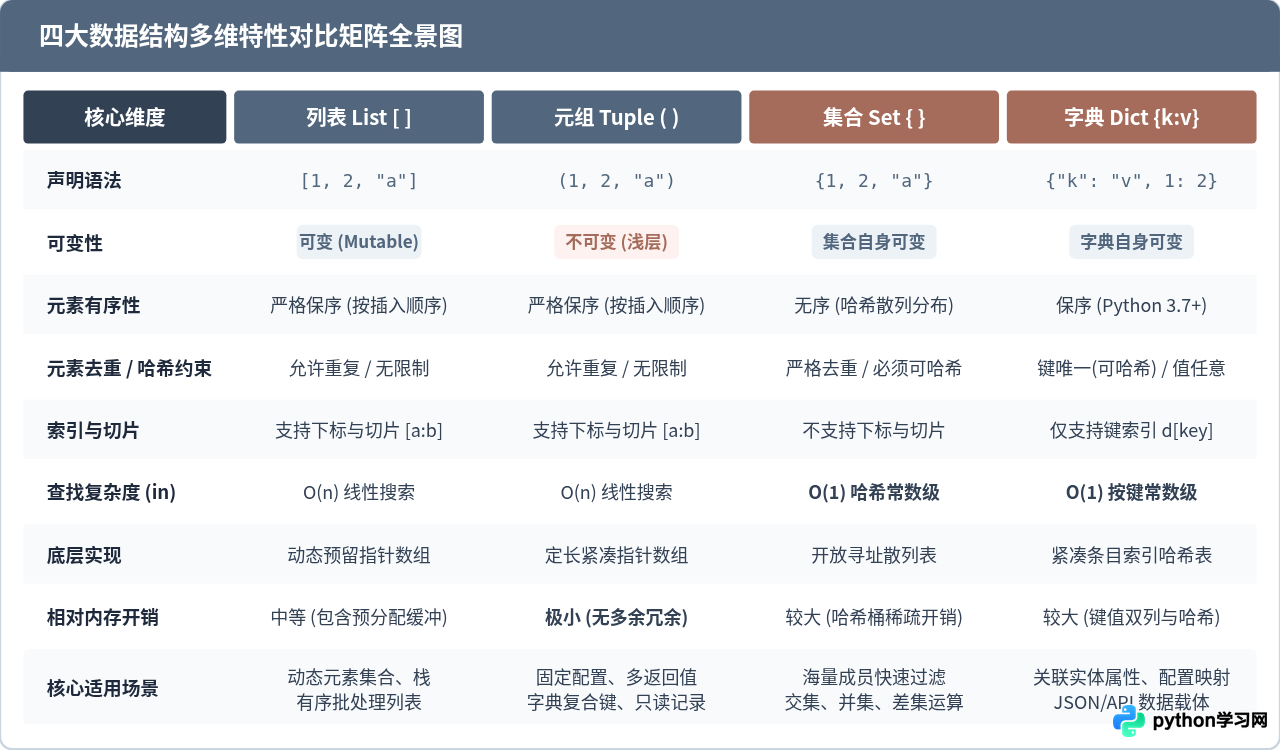
简而言之:列表是动态有序的工作台,元组是防篡改的轻量记录单,集合是高速排重的过滤器,字典是清晰灵活的键值数据库。结合业务场景的数据流动方式,选用具备最恰当约束的数据结构,不仅能够让代码意图更加清晰自解释,也能在系统规模扩张时保障高效稳定的运行性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









