

为什么选择Python?从开发效率与生态优势看语言核心价值
从认知负担、语法一致性、胶水协同架构、四步落地决策与工程适用边界,系统剖析选择Python作为核心生产力语言的核心价值与权衡考量。
一、开发效率的本质来源:语法直观性与心智负担控制
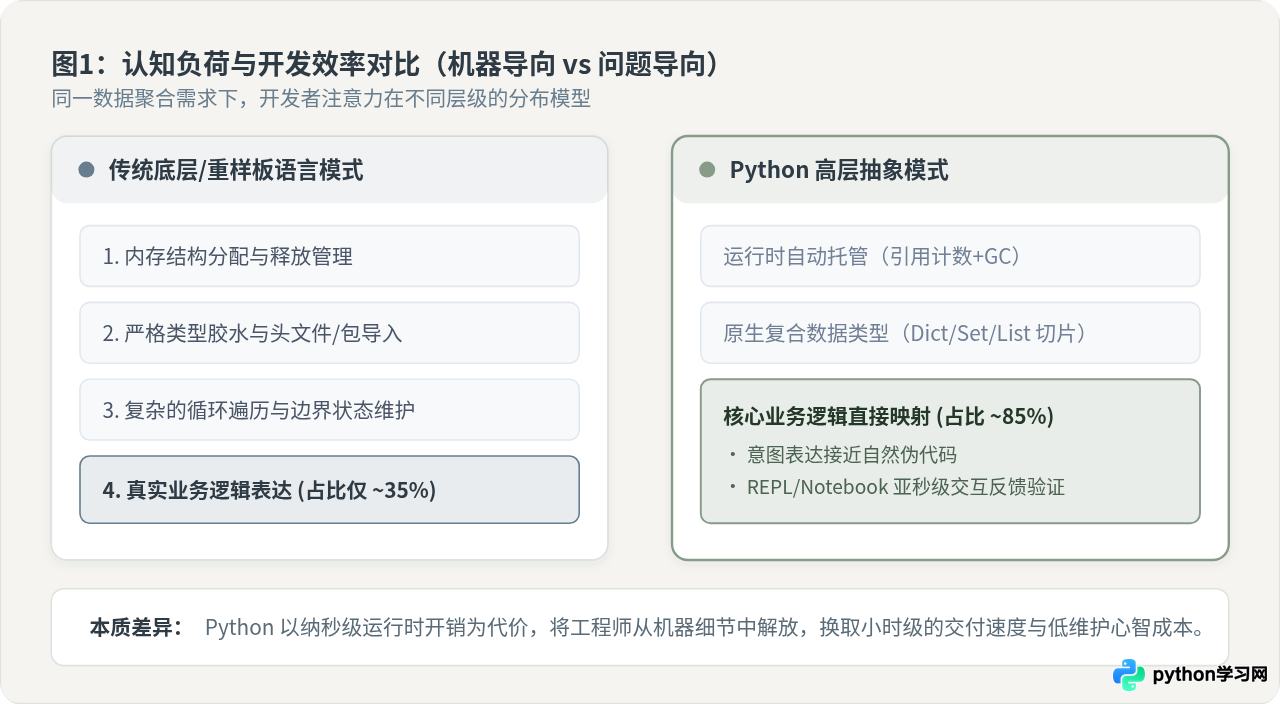
评估一门编程语言对开发效率的影响,关键指标不是敲击键盘的代码字数,而是工程师将大脑中的业务逻辑转化为可执行代码时所需消耗的心智带宽。传统系统级或静态强约束语言在提供极致底层控制的同时,也迫使开发者时刻分心处理指针、内存生命周期、冗长的类型脚手架与类型转换。
为了直观说明这一差异,我们设定一个相同的实际场景:读取结构化文本数据,按指定类别聚合数值,并计算每个类别的平均值。在需要手动管理内存或使用严格编译期模板的语言中,开发者必须完成结构体声明、动态数组分配、哈希查找、指针安全校验以及异常释放保护;而在 Python 中,开发者可以直接借助内置的高阶抽象原生结构完成任务:
# 示例环境:Python 3.10+ 标准库环境
from collections import defaultdict

def calculate_category_averages(records: list[tuple[str, float]]) -> dict[str, float]:
    """按类别汇总并计算均值"""
    sums = defaultdict(float)
    counts = defaultdict(int)

    for category, value in records:
        sums[category] += value
        counts[category] += 1

    return {cat: round(sums[cat] / counts[cat], 2) for cat in sums}

# 示例输入数据
data = [("CPU", 12.5), ("Memory", 45.0), ("CPU", 17.5), ("Disk", 88.0), ("Memory", 55.0)]
print(calculate_category_averages(data))在这段代码中,没有一行业务无关的内存对齐或样板代码声明。Python 的动态数据容器(如 defaultdict、字典推导式)使代码的视觉形态与数学逻辑完全一致。这种“代码即伪代码”的特性,显著缩短了从问题分析到原型跑通的时间,大幅降低了团队成员之间的代码阅读与维护沟通成本。
Python 鼓励高表达力,但不鼓励晦涩的代码竞赛。当推导式或切片嵌套超过两层时,认知负担会骤增,此时应拆解为清晰的具名函数或显式循环,保持代码的自解释性。
二、生态优势的双层模型:“胶水语言”如何打破性能与敏捷的矛盾
在传统的计算机科学认知中,动态高级语言通常面临“写得快但跑得慢”的固有权衡。然而,Python 在机器学习、数据科学与高并发后端等领域的高速扩张,证明了其突破这种权衡的独特范式:双层胶水协同架构。
Python 并不孤立地依靠自身的字节码解释器来执行密集矩阵运算或大规模网络 I/O,而是充当了现代计算体系的“通用控制平面与调度中枢”:
- 顶层交互与编排:使用纯 Python 编写业务控制流、数据过滤逻辑与参数组织,保持极高的业务敏捷度与可重构性。
- 底层原生计算引擎:通过标准 C-API、PyO3(Rust)或 ctypes 等技术,直接把重度计算负载委托给由 C、C++、Fortran 或 CUDA 编写的底层共享库。
以现代数据工程中的 NumPy 与 PyTorch 为例,当开发者调用 a + b 或 torch.matmul() 时,Python 解释器只负责纳秒级的参数解析与函数路由,实际执行过程直接调用底层的 SIMD 向量化指令或 GPU Tensor Core 并行算子。在此过程中,全局解释器锁(GIL)被底层代码安全释放,物理硬件的多核算力得以完全释放。
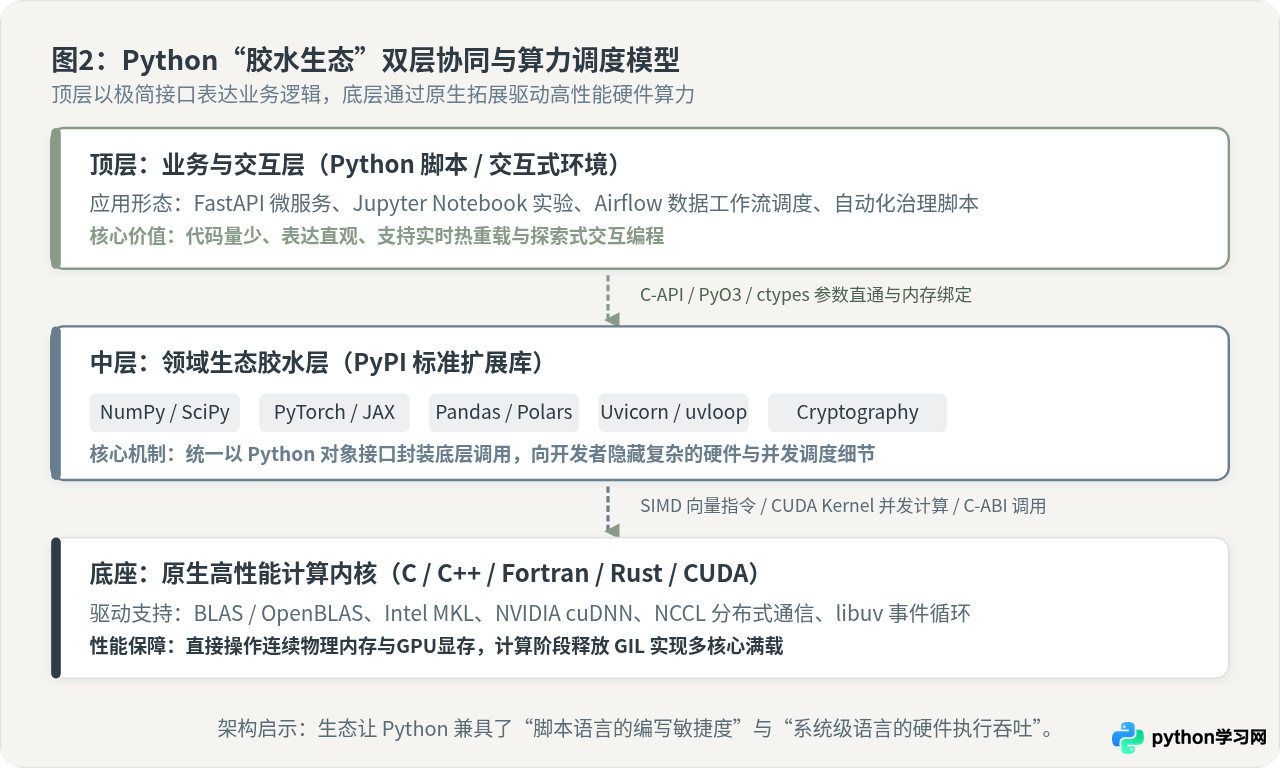
这种架构赋予了 Python 独特的生态雪球效应:任何系统级语言写出的优秀算法库,都可以迅速打包为 Python 扩展;而业务开发者无需学习 C++ 或 CUDA 的繁琐细节,即可在几分钟内通过 pip install 获得顶尖水准的工程与算力支持。
三、从技术选型到落地验证的四步决策流程
面对具体项目的技术选型,技术决策者不应基于主观偏好,而应建立严谨的评估依据。以下是经过行业检验的 Python 选型四步实施流程:
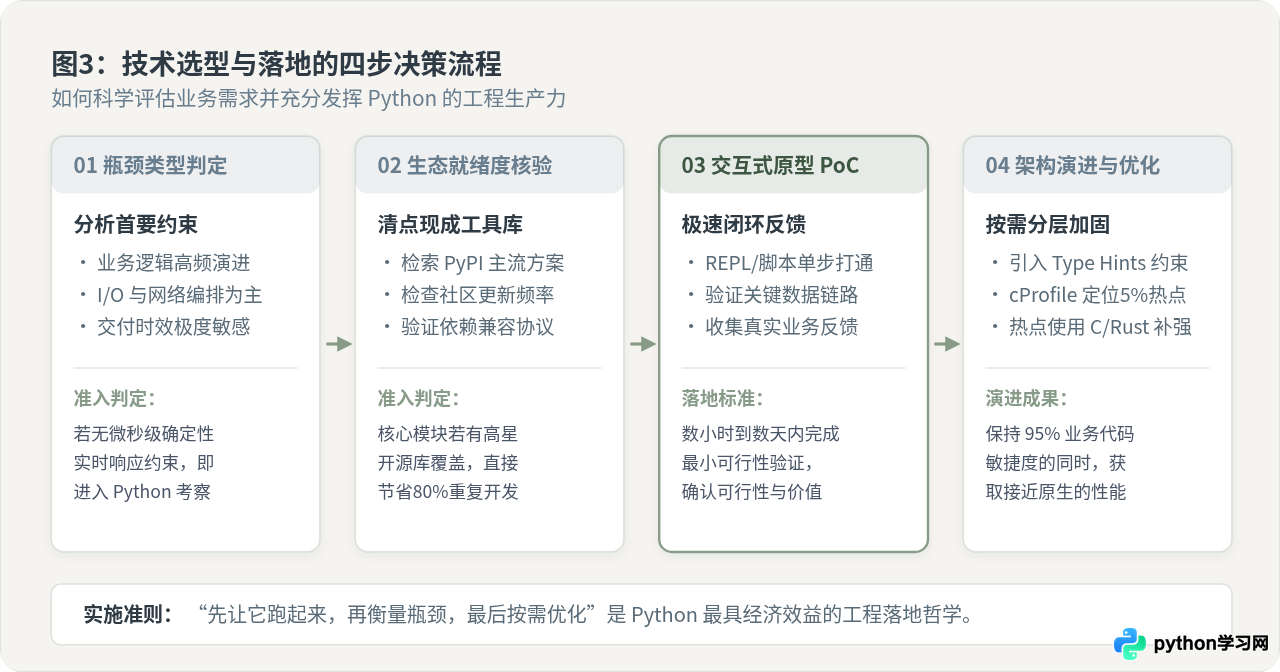
1. 第一步:系统瓶颈类型判定
分析目标系统的核心约束。如果系统瓶颈属于 I/O 密集型(如 API 网关、微服务业务网格、数据爬取与清洗)或 需求频繁演进的业务系统,Python 能以最低的人工工时完成开发;若系统对确定性微秒级延迟有绝对要求,则应谨慎评估。
2. 第二步:PyPI 领域生态就绪度核验
在立项阶段系统检索 PyPI。如果核心需求(如工业协议解析、特定金融数据接口、大模型推理调度)已存在被广泛采用、维护活跃的成熟开源库,选择 Python 即可避免数十个人月甚至更长时间的重复造轮子成本。
3. 第三步:交互式原型(PoC)快速验证
利用 Python 原生交互式命令行(REPL)或 Jupyter Notebook 环境,以极低的代码量搭建最小可行原型(PoC)。通常在数小时到两天内即可完成端到端链路的可行性验证,极大降低前期的技术试错与沉没成本。
4. 第四步:渐进式架构加固与性能调优
在原型验证通过进入工程化量产后,按需开启渐进式防护措施:通过 typing 模块引入类型注解提升多人协作质量;运行性能剖析工具(如 cProfile)定位占系统 5% 运行时间的关键热点,仅对该局部热点采用向量化或引入 Rust 扩展,兼顾极致交付效率与系统承载力。
四、适用边界与工程权衡:认识真实的技术局限
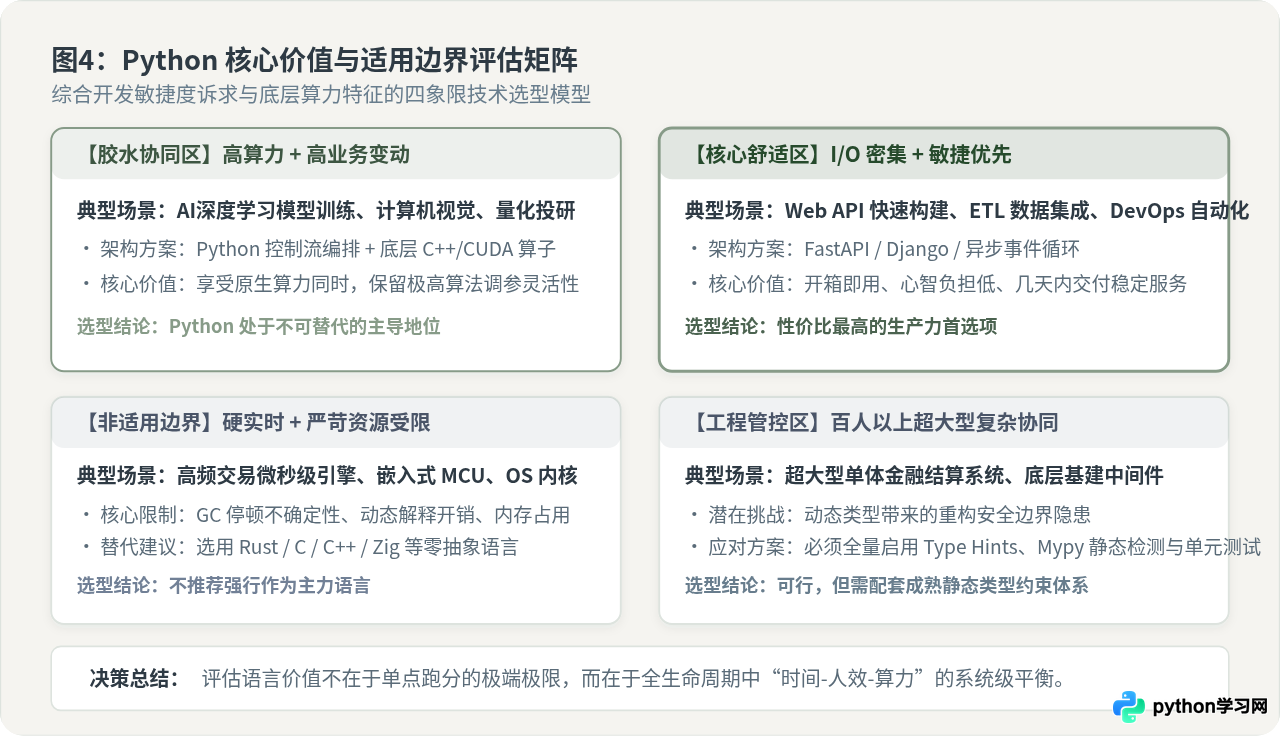
成熟的技术选型绝不盲目神化任何单项工具。Python 在提供无与伦比的开发效率与生态繁荣的同时,其语言特性在特定工程场景下也存在不可忽视的限制条件:
| 限制维度 | 底层原因 | 工程表现与影响 | 行业主流解决/规避策略 |
|---|---|---|---|
| 多线程 CPU 密集瓶颈 | CPython 的全局解释器锁(GIL)机制保证内存安全,但限制单进程内纯 Python 字节码的多核并行。 | 在多线程执行密集纯 Python 循环时,无法利用多个 CPU 核心,甚至因线程切换降低吞吐。 | 采用多进程模型(multiprocessing / Celery)、将密集计算交由释放 GIL 的底层库(NumPy)或拥抱 Python 3.13+ 的自由线程(free-threading)构建。 |
| 大型代码库重构成本 | 动态弱契约特性允许变量在运行时动态绑定类型,在代码规模膨胀时缺乏编译器静态检查。 | 接口参数变更时,隐式属性缺失可能漏至生产环境运行时才抛出 AttributeError。 |
强制要求全量类型标注(Type Hints),并在 CI/CD 流程中引入 mypy 或 pyright 进行静态类型守门。 |
| 内存占用与硬实时响应 | 每个 Python 对象封装了 PyObject 头信息,垃圾回收(引用计数+代际标记)引入停顿。 | 基础内存开销高于裸指针结构,GC 触发时可能产生毫秒级抖动,无法满足确定性实时时钟。 | 嵌入式硬实时、微控制器、高频交易等纳秒级确定性场景,坚决采用 C/C++/Rust 等系统级语言。 |
五、核心价值总结:全生命周期的工程经济学
综上所述,“为什么选择 Python”的根本答案并不在于它是单项跑分中最快的工具,而在于它在软件工程全生命周期中所体现的综合经济学价值:
- 极速的产品迭代与试错能力:在技术快速变革的竞争环境中,比竞争对手早数周验证业务模式,其商业价值远高于单台服务器节约的电费与内存成本。
- 全行业覆盖的统一技术资产:无论工程团队面临的是云原生 Web 开发、数据仓库自动化、网络安全渗透还是深度学习落地,Python 提供了一致的语法体系与互通的生态资产,有效打破了不同团队间的技术孤岛。
- 渐进可伸缩的工程架构:通过现代类型提示、异步非阻塞架构与高性能扩展集成,Python 能够平滑地从单文件自动化脚本成长为承载千万级流量的企业级基础服务。
当你需要快速解决问题、连接不同系统,并且希望团队把 90% 的智慧聚焦于业务本身而非机器细节时,Python 永远是综合回报率极高、最值得优先考虑的战略级语言。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









