

大型系统架构中Python和Java的混合使用策略
深入解析在大型分布式系统架构中混合使用Python与Java的核心策略,包括微服务边界划分、gRPC与Kafka跨语言通信契约、工程治理、链路追踪及性能调优实践。
一、技术栈边界划分与能力互补
大型系统架构采用混合技术栈,根本目的不是为了迎合开发者的个人喜好,而是基于工程成本、系统吞吐量与算法迭代频率所做出的工程权衡。如果边界划分不清晰,双语言系统极易退化成团队协作的噩梦。因此,清晰的职责分工是构建稳定双栈架构的第一前提。
Java 的职责边界(Core Transaction & Business Logic): Java 适用于构建系统的主干通道。大型系统的网关路由、账户鉴权、资金结算、分布式事务管理以及核心订单生命周期流转,需要极高的吞吐稳定性、低延迟抖动和可控的垃圾回收表现。依托 Spring Boot、Micronaut 或 Quarkus 等框架,Java 能够提供高度规范的领域驱动设计(DDD)落地环境。
Python 的职责边界(AI, Data & Algorithm Pipeline): Python 适用于构建系统的智能与数据分支。在大模型推理集成(LangChain、vLLM)、图像处理、风控离线特征提取、推荐策略排序以及自然语言解析领域,主流底层库(如 PyTorch、TensorFlow、NumPy)均以 Python 为首要交互层。在这些场景中,Python 扮演着高性能 C/C++ 底层算子的高级胶水调度器。
| 对比维度 | Java 服务节点 | Python 服务节点 |
|---|---|---|
| 核心优势场景 | 交易事务、高并发 RPC、长生命周期状态机、核心数据持久化 | 深度学习推理、向量计算、特征工程、统计分析、敏捷脚本 |
| 并发与执行模型 | JVM 多线程(OS 线程/虚拟线程),原生无全局锁限制 | GIL(全局解释器锁)限制下的单进程多线程,依赖多进程或异步 IO |
| 接口形态诉求 | 强契约约束、编译期类型检查、严格向前兼容 | 灵活的数据结构解构、向量张量传输、动态流式响应 |
| 水平扩缩容特点 | 启动相对较重(JIT 预热),稳态吞吐高,资源占用平稳 | 依赖容器快速横向扩容,常伴随 GPU / NPU 硬件资源绑定 |
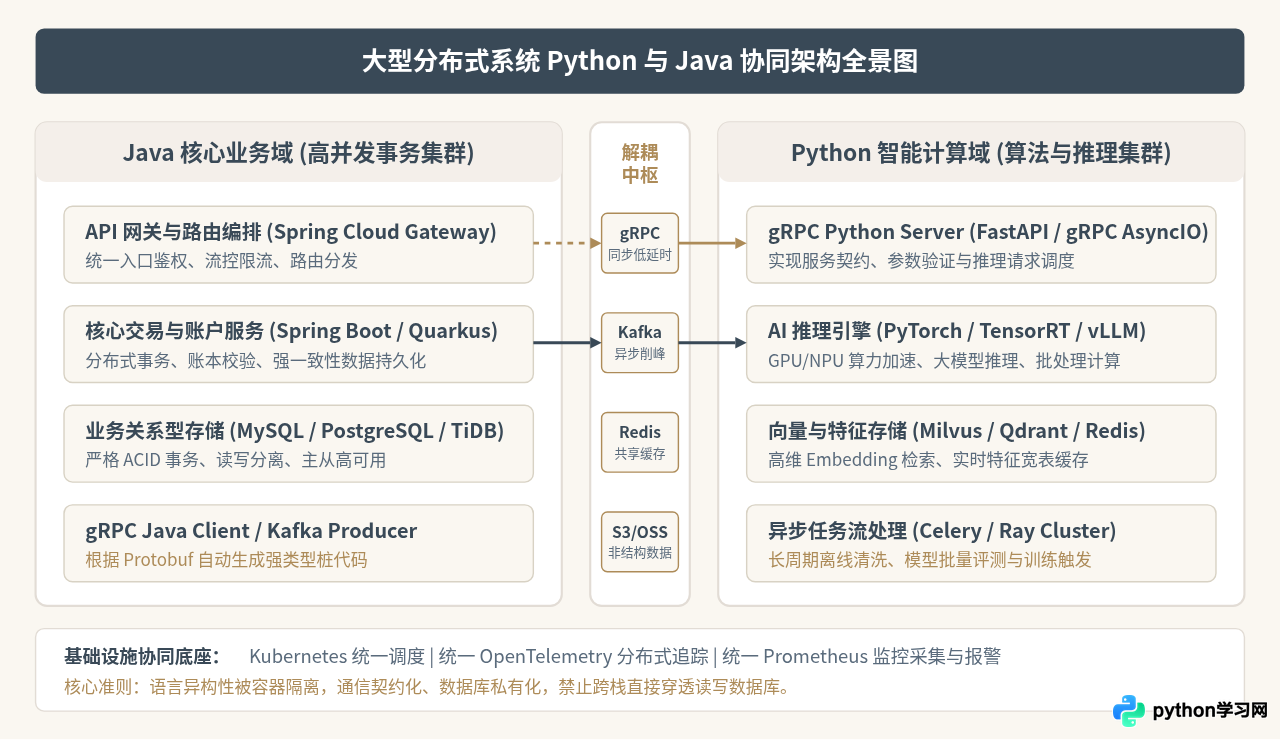
二、坚守“进程外解耦”核心原则
在技术演进过程中,部分团队尝试过使用 JNI(Java Native Interface)、Jython 或 Py4J 在同一个操作系统进程内直接调用代码。在大型分布式系统中,应严格禁止在生产主链路中使用进程内跨语言调用。
原因主要体现在三个方面:
- 内存与生命周期管理冲突:JVM 拥有高度精密的垃圾回收器(ZGC、G1),而 CPython 的内存分配依赖引用计数和全局解释器锁(GIL)。一旦 Python 内部底层 C 模块发生内存泄漏或出现段错误(Segmentation Fault),将导致整个宿主 JVM 进程非预期崩溃,使得上层的隔离保护机制完全失效。
- 并发模型的不匹配:Java 的多线程能轻易利用多核 CPU 处理海量并发请求,但在同一进程内调用 Python 代码时,会被 Python 的 GIL 强制串行化,形成极难排查的线程挂起与吞吐量骤降。
- 部署与扩展维度不一致:Java 服务的瓶颈通常在堆内存大小与 CPU 计算,依赖通用计算节点;Python 深度学习服务则依赖 GPU 算力池与专用驱动库(CUDA、cuDNN)。强行打包在一起,会导致集群资源调度变得极为低效。
因此,现代系统架构唯一推荐的解耦方式是:通过独立容器/Pod部署,使用标准的网络协议进行进程外交互。
三、跨语言通信与契约协同模式
为了实现进程外的高效协同,架构设计通常划分为三种通信模式:基于 gRPC 的强类型同步调用、基于 Kafka 的异步削峰解耦,以及面向海量数据传输的共享存储模式。
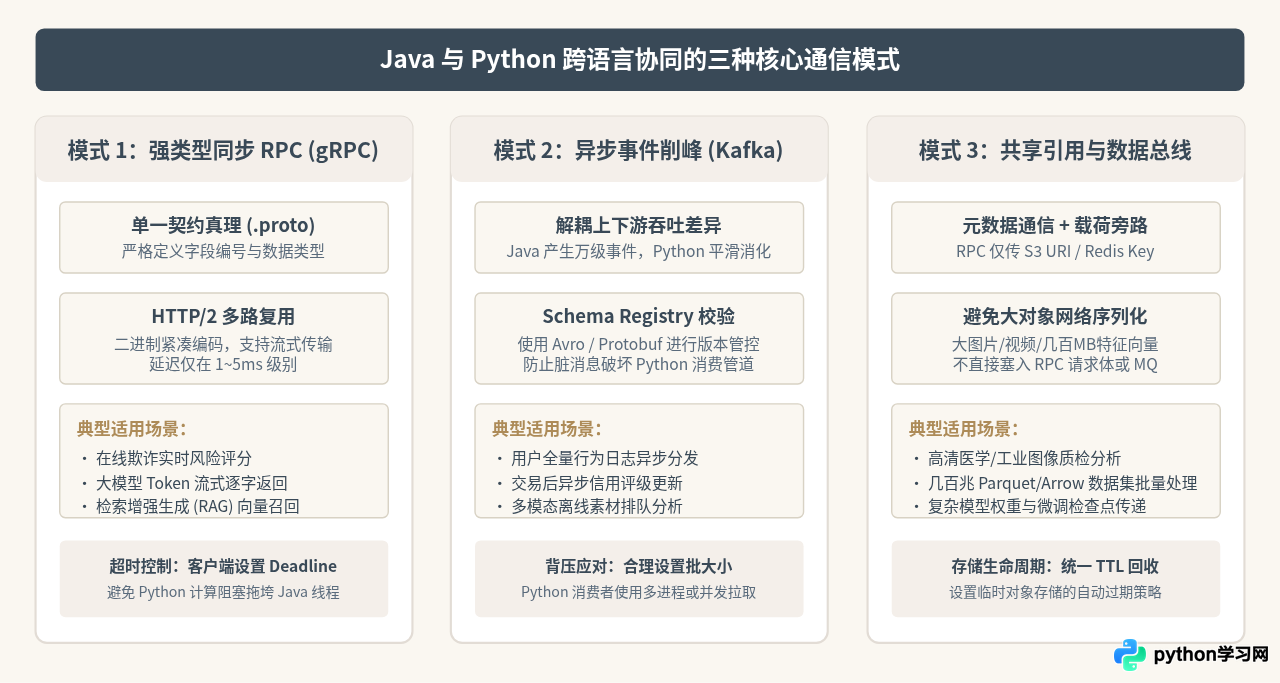
以契约优先(Contract-First)构建接口
为了防止 Java 与 Python 工程师因接口字段变更反复扯皮,必须将 Protocol Buffers(.proto)定义作为**独立 Git 仓库管理**。任何接口改动必须经由该契约仓库,并在 CI 流程中同时编译出 Java jar 包与 Python wheel 包。
以一个典型的实时风险评估服务为例,契约定义如下:
// risk_service.proto
syntax = "proto3";

package antifraud.v1;
option java_multiple_files = true;
option java_package = "com.enterprise.antifraud.v1";
option java_outer_classname = "RiskServiceProto";

service RiskAssessmentService {
  // 实时同步风险评分
  rpc EvaluateTransaction (TransactionRiskRequest) returns (RiskAssessmentResponse);
}

message TransactionRiskRequest {
  string transaction_id = 1;
  int64 user_id = 2;
  double amount = 3;
  string currency = 4;
  string client_ip = 5;
  int64 timestamp_epoch_ms = 6;
  map<string, string> context_features = 7;
}

message RiskAssessmentResponse {
  string transaction_id = 1;
  double risk_score = 2;       // 0.0 到 1.0
  string action = 3;           // ACCEPT, REVIEW, REJECT
  repeated string trigger_rules = 4;
}
Java 端客户端调用示例(强类型、带超时控制):
// RiskEvaluationClient.java (由 Spring 托管的服务层)
package com.enterprise.trade.service;

import com.enterprise.antifraud.v1.RiskAssessmentResponse;
import com.enterprise.antifraud.v1.RiskAssessmentServiceGrpc;
import com.enterprise.antifraud.v1.TransactionRiskRequest;
import io.grpc.ManagedChannel;
import io.grpc.StatusRuntimeException;
import org.springframework.stereotype.Service;
import java.util.concurrent.TimeUnit;

@Service
public class RiskEvaluationClient {
    private final RiskAssessmentServiceGrpc.RiskAssessmentServiceBlockingStub riskStub;

    public RiskEvaluationClient(ManagedChannel channel) {
        this.riskStub = RiskAssessmentServiceGrpc.newBlockingStub(channel);
    }

    public RiskAssessmentResponse evaluate(String txId, long userId, double amount) {
        TransactionRiskRequest request = TransactionRiskRequest.newBuilder()
                .setTransactionId(txId)
                .setUserId(userId)
                .setAmount(amount)
                .setCurrency("CNY")
                .setTimestampEpochMs(System.currentTimeMillis())
                .putContextFeatures("channel", "APP_IOS")
                .build();

        try {
            // 严格设置 150 毫秒的超时,绝不允许算法端慢响应拖垮交易主链路
            return riskStub.withDeadlineAfter(150, TimeUnit.MILLISECONDS)
                           .evaluateTransaction(request);
        } catch (StatusRuntimeException e) {
            // 超时或 Python 节点异常时的降级兜底逻辑
            return fallbackAssessment(txId, e);
        }
    }

    private RiskAssessmentResponse fallbackAssessment(String txId, Exception e) {
        // 记录错误日志并触发降级熔断:默认为人工审核(REVIEW)或跳过软拦截
        return RiskAssessmentResponse.newBuilder()
                .setTransactionId(txId)
                .setRiskScore(0.5)
                .setAction("REVIEW")
                .addTriggerRules("ALGO_SERVICE_TIMEOUT_FALLBACK")
                .build();
    }
}
Python 端服务端实现示例(异步并发、集成算法模型):
# server.py (Python 端算法服务)
import asyncio
import logging
from concurrent import futures
import grpc
from antifraud.v1 import risk_service_pb2, risk_service_pb2_grpc

class RiskAssessmentServicer(risk_service_pb2_grpc.RiskAssessmentServiceServicer):
    def __init__(self, model_pipeline):
        self.model = model_pipeline

    async def EvaluateTransaction(self, request, context):
        # 提取 Java 端传递的强契约结构体数据
        tx_id = request.transaction_id
        user_id = request.user_id
        amount = request.amount

        # 调用 C 扩展加速的模型进行实时推理 (在线程池中运行避免阻塞主 Loop)
        score, decision, rules = await asyncio.to_thread(
            self.model.predict,
            user_id=user_id,
            amount=amount,
            features=dict(request.context_features)
        )

        return risk_service_pb2.RiskAssessmentResponse(
            transaction_id=tx_id,
            risk_score=float(score),
            action=decision,
            trigger_rules=rules
        )

async def serve():
    server = grpc.aio.server(options=[
        ('grpc.max_receive_message_length', 16 * 1024 * 1024),
        ('grpc.keepalive_time_ms', 30000),
    ])
    risk_service_pb2_grpc.add_RiskAssessmentServiceServicer_to_server(
        RiskAssessmentServicer(model_pipeline=None), server
    )
    server.add_insecure_port('[::]:50051')
    await server.start()
    await server.wait_for_termination()

if __name__ == '__main__':
    asyncio.run(serve())
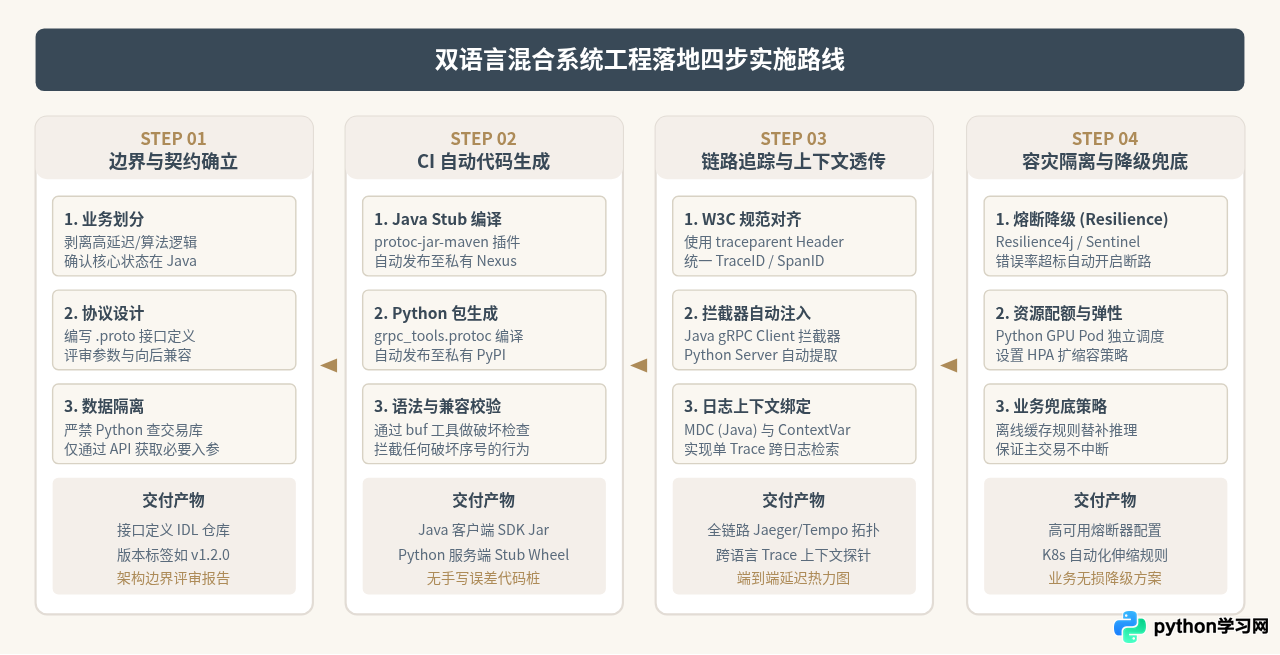
四、实施落地四步操作流程
建立混合语言系统不能一蹴而就,需要通过清晰的演进阶段逐步落地。以下是从契约定义、构建发布到观测治理的标准操作步骤。
五、双栈治理的关键陷阱与工程实践
1. 分布式链路追踪(Trace Context Propagation)
跨语言系统最常见的运维痛点是“故障排查两头扯皮”。Java 工程师认为自己的请求发出去了,Python 工程师坚称没有收到。解决该问题的铁律是**统一 OpenTelemetry 标头规范**。
在 gRPC 传输中,通过元数据(Metadata / HTTP/2 Headers)透传 traceparent。Java 端发起 RPC 时自动注入:
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01
Python 端的 gRPC 拦截器在接收到请求时提取该头信息,将其绑定到 Python 的当前执行上下文(contextvars),并在记录日志时输出相同的 TraceID。这样在 Kibana、Loki 或 Jaeger 中,输入一次 TraceID 便可同时串联 Java 的事务日志和 Python 的模型推理耗时。
2. 资源与并发隔离:避免 Python GIL 与 Java 线程池雪崩
Java 侧通常具备极高的线程并发度。一个 Tomcat 或 Netty 容器可能同时维持数千个工作线程。如果向 Python 算法集群发起无限制的并发 RPC,极易导致 Python 节点的事件循环严重堵塞,CPU 负载飙升。
1. 客户端限流:在 Java 端的 gRPC 通道前配置信号量隔离或连接池配额,严格限制飞往 Python 节点的并发请求上限(In-flight Requests)。
2. 服务端多进程部署:Python 节点单进程受 GIL 约束,单容器应使用 uvicorn --workers 4 或多进程 gRPC Server,或者在 Kubernetes 中部署为“小规格多副本”(如 2 Core 4GB 单 Pod)的 Horizontal Pod Autoscaler(HPA)集群。
3. 超时必须严格:Java 端调 Python 必须配置 Deadline(如 100~300ms)。超时后 Java 端主动放弃并走降级逻辑,同时 gRPC 会向 Python 端发送 CANCELLED 信号,及时中断 Python 端无谓的计算开销。
3. 契约兼容性与版本治理策略
在持续交付场景下,Java 核心系统与 Python 算法系统的发版节奏通常不同步。算法服务可能每周迭代数次,而核心账务服务两周一次发版。
- 严禁重用字段编号:在 Protocol Buffers 中,字段编号(Tag Number)是二进制编解码的唯一标识。已弃用的字段必须使用
reserved关键字锁定,严禁修改编号含义。 - 只能新增可选字段:新版算法若需要额外入参,必须以新增字段形式补充,老版本 Java 客户端未传该字段时,Python 端必须具备合理的缺省值处理逻辑。
- 契约变更流水线自动化:在代码仓库中集成
buf lint与buf breaking --against '.git#branch=main',在 Pull Request 阶段直接阻断任何破坏向下兼容性的修改。
六、架构治理与选型决策全景
综合上述分析,在大型分布式系统中有效融合 Python 与 Java,其本质是一场关于“解耦边界、通信契约与容灾治理”的工程实践。
七、总结
大型系统架构的技术演进,最终会从“追求单一语言的一统天下”,走向“根据计算特征与生产效率匹配最佳技术栈”的实用主义道路。Java 与 Python 的组合,恰好形成了稳定与灵活、高吞吐事务与密集型算法计算的最佳互补。
落实这套混合策略的关键在于恪守工程红线:**以进程外容器化为底座,以强类型 Protobuf 契约为法典,以异步事件队列为缓冲,以统一 OpenTelemetry 为眼睛**。通过这套标准化的协同体系,不仅能彻底释放 Python 在 AI 与算法创新层面的生产力,更能牢牢守护 Java 在企业级核心交易链路中的稳定性与可靠性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









