

Python生态系统优势解析:丰富的第三方库怎么加速开发
深入解析Python生态系统与第三方库如何加速软件开发全流程,涵盖生态体系架构、关键场景选型对比、质量与安全评估SOP以及高效集成方法。
Python 在现代软件工程中能够实现极高的研发交付效率,核心驱动力并非来自语法本身的紧凑,而是源于其背后庞大且高度协同的第三方库生态系统。开发团队不需要从套接字通信、内存管理或矩阵乘法等底层细节从头构建,而是通过官方分发体系直接引入经受过海量工业级场景验证的成熟模块。本文将从生态协作架构、研发路径效益对比、典型认知辨析、选型准入流程以及效能沉淀五个维度,系统拆解第三方库是如何在不同开发阶段大幅压缩研发周期并保证工程稳定性的。
一、生态系统分层架构:从基础设施到垂直方案
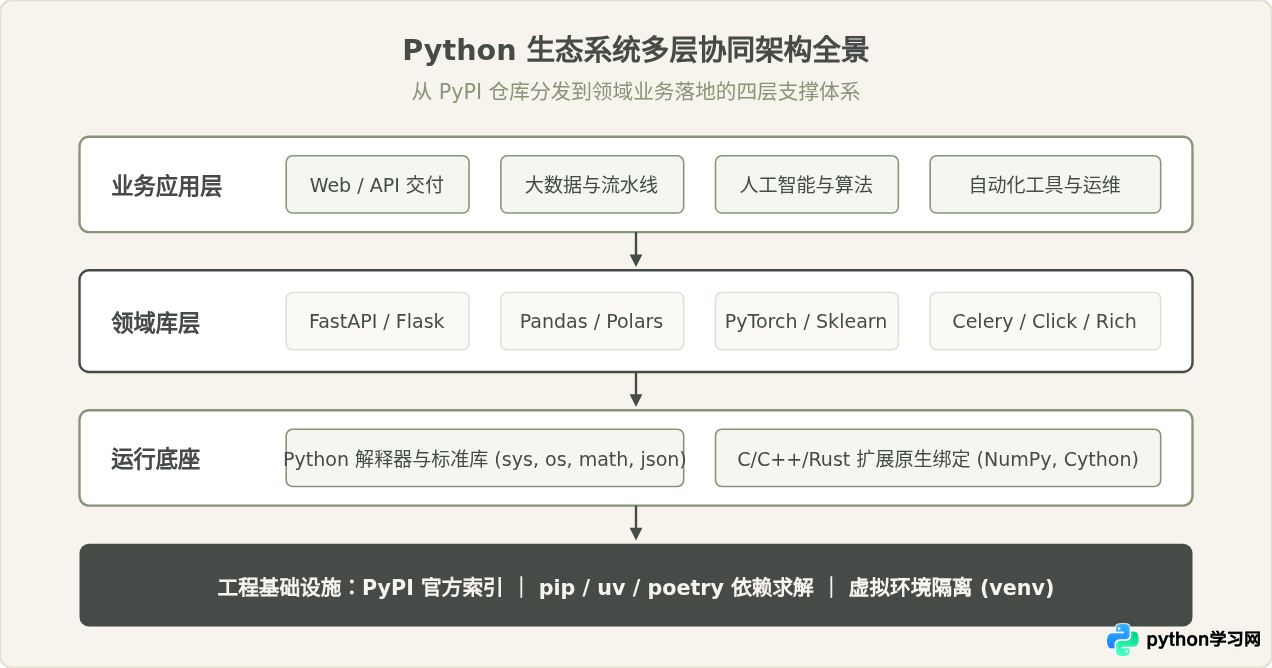
要理解第三方库为什么能够加速开发,首先需要厘清 Python 生态的分发和集成机制。Python 拥有标准库(Standard Library)作为底座,在此之上,PyPI(Python Package Index)聚集了超过数十万个开源软件包。这些包通过声明式依赖工具(如 pip、uv 或 poetry)与隔离的虚拟环境结合,构成了层次分明的协作网络。
在这个结构中,底层的性能密集型计算通常由 C、C++ 或 Rust 实现,并通过 CPython C-API 暴露给上层;中层库则在此基础上统一协议标准与设计模式;顶层应用库则直接面向 Web、数据科学、机器学习或运维自动化等业务领域。这种分层解耦机制让开发者只需书写顶层的声明式逻辑,就能直接调动底层经过深度优化的软硬件算力。
二、开发效率跃迁:手写轮子与依赖复用的实际对比
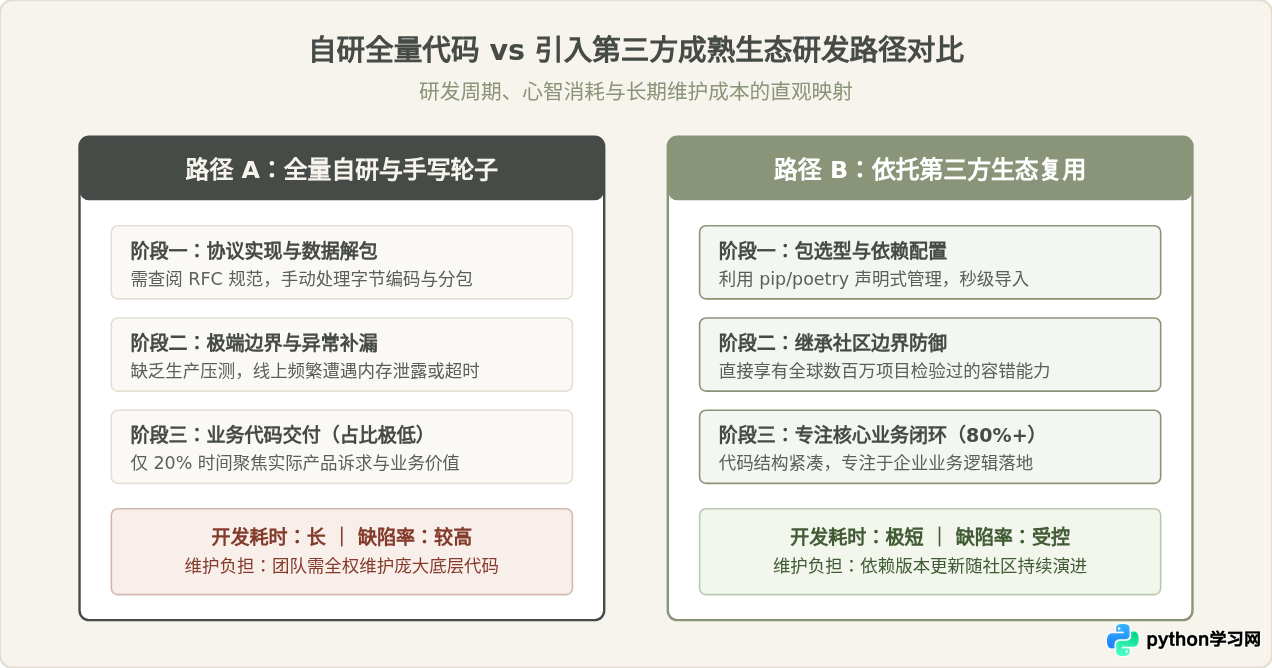
为了直观感受第三方库如何节约研发时间,我们以常见的“HTTP API 交互与异常重试机制”为例进行代码量和复杂度对比。如果使用 Python 极底层的原生标准库 urllib 并实现可靠的超时重试和状态处理,通常需要编写大量样板代码:
# 示例 1:使用底层标准库实现带超时与重试的请求(纯手写方式)
import urllib.request
import urllib.error
import time

def fetch_data_urllib(url, max_retries=3, timeout=5):
    attempt = 0
    while attempt < max_retries:
        try:
            req = urllib.request.Request(url, headers={"User-Agent": "CoreApp/1.0"})
            with urllib.request.urlopen(req, timeout=timeout) as response:
                if response.status == 200:
                    return response.read().decode("utf-8")
        except (urllib.error.URLError, urllib.error.HTTPError) as err:
            attempt += 1
            if attempt >= max_retries:
                raise RuntimeError(f"请求失败,超出最大重试次数: {err}")
            time.sleep(1)
    return None
而在实际工程开发中,开发者只需引入社区标准库 requests 或现代异步库 httpx,配合经过生产环境验证的适配器,只需几行代码即可完成相同乃至更为健壮的连接池复用与策略配置:
# 示例 2:引入第三方成熟库实现连接池与指数退避重试
import requests
from urllib3.util.retry import Retry
from requests.adapters import HTTPAdapter

def fetch_data_requests(url):
    session = requests.Session()
    # 自动重试策略:针对500、502、503等服务端偶发错误进行退避重试
    retries = Retry(total=3, backoff_factor=0.5, status_forcelist=[500, 502, 503, 504])
    session.mount("https://", HTTPAdapter(max_retries=retries))

    resp = session.get(url, timeout=5, headers={"User-Agent": "CoreApp/1.0"})
    resp.raise_for_status()
    return resp.text
通过对比显而易见,第三方库为开发者节省的不仅是表面的行数,更包含了以下隐藏在底层的高昂成本:
- 异常边界覆盖:成熟库封装了网络抖动、DNS 延迟、SSL 证书握手与半开连接等多种偶发边界异常,避免开发者在线上环境中反复踩坑。
- 连接复用与资源回收:内建底层 Socket 连接池(HTTP Keep-Alive),极大降低重复握手的延迟与系统句柄消耗。
- 心智模型简化:将复杂的网络协议状态机收敛为
get()、post()及统一的raise_for_status()方法,让业务代码意图一目了然。
三、常见认知辨析:调包是不是“不求甚解”?
在开发讨论中,常能听到一种质疑:“Python 开发者只是调包侠,过度依赖第三方库会导致不理解技术底层,性能和可控性也会大打折扣。”这种说法看似有理,并在特定条件下确实存在警示价值,但将其绝对化则忽略了现代软件工程的分工本质。
原观点的合理成分:如果团队对引入的包毫无甄别,不了解其内部时空复杂度、连接池管理或异步机制,直接在关键路径调用,遇到死锁或内存激增时确实会无从下手,形成严重的“技术黑盒”。
需要修正的地方:专业工程中的“调包”绝非盲目堆砌,而是基于软件架构契约的代码复用。例如使用 NumPy 或 Polars,底层其实是 SIMD 向量化指令集与 C/Rust 并行计算,其运行效率通常远超开发者手写的单线程 Python 循环。真正的高效开发要求“善用高层抽象,明晰底层约束”,而非拒绝成熟组件。
为了直观说明合理复用与盲目依赖的边界,下表列出了常见开发场景下的对比:
| 业务场景 | 过度/盲目依赖的典型反例 | 专业工程的合理依赖实践 |
|---|---|---|
| 字符串格式与简单校验 | 仅为了判断一个非空字符串或修剪空格,额外引入体积庞大的第三方工具包 | 优先使用 Python 原生内置方法(如 str.strip()、in 操作符),保持无额外依赖 |
| 大规模数值与矩阵运算 | 坚持在纯 Python 中嵌套三层 for 循环,拒绝引入外部数学库 |
果断引入 NumPy 或 SciPy,依托底层 BLAS/LAPACK 原生二进制加速 |
| 复杂数据模型校验与解析 | 自写几十个 if-else 校验字段类型,规则变动时极易遗漏报错 |
采用 Pydantic 声明式数据模型,集成类型提示与自动类型转换验证 |
四、第三方库选型与准入标准流程(SOP)
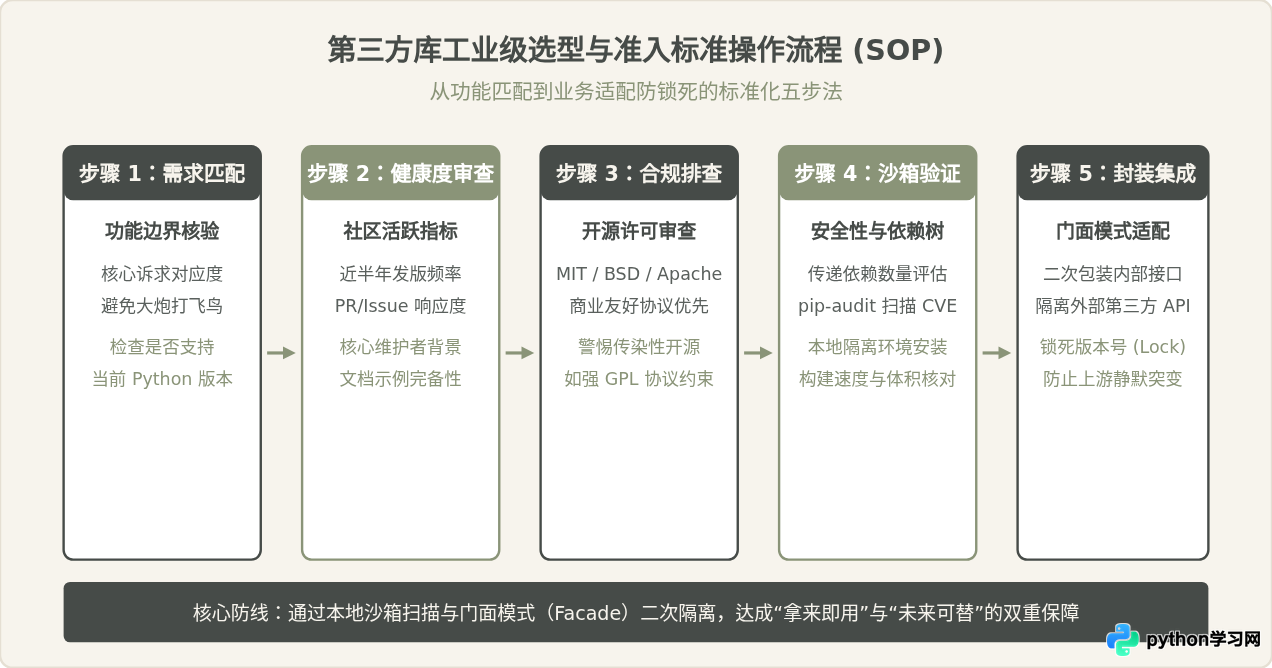
利用生态加速开发的前提是“引入健康的资产,而非引入负债”。如果随意安装未经维护的废弃库,后续排查隐患和修补安全漏洞的时间将彻底抵消前期节省的工时。因此,成熟研发团队应当遵循严格的五步选型与准入操作流程:
关键实操说明:门面模式二次隔离
在步骤 5 中,强烈建议业务核心逻辑不要直接弥散调用第三方包的具体类名。例如在集成第三方短信服务或云存储客户端时,先在项目内部声明一个抽象类或适配函数:
# 示例 3:利用门面模式将业务系统与具体第三方库解耦
from abc import ABC, abstractmethod

class StorageClient(ABC):
    @abstractmethod
    def upload_file(self, local_path: str, remote_name: str) -> str:
        """统一上传规范"""
        pass

# 具体第三方库实现(例如将来更换库时仅需修改此处)
class S3StorageAdapter(StorageClient):
    def __init__(self, bucket_name: str):
        import boto3  # 依赖仅被收敛在适配器模块内部
        self.client = boto3.client("s3")
        self.bucket = bucket_name

    def upload_file(self, local_path: str, remote_name: str) -> str:
        self.client.upload_file(local_path, self.bucket, remote_name)
        return f"https://{self.bucket}.s3.amazonaws.com/{remote_name}"
这种做法既享受了第三方库即装即用的加速度,又将项目与具体供应商彻底解耦,未来若需要替换为兼容库或自建服务,整个业务层无需改动一行代码。
五、生态驱动的四大效能杠杆与工程总结
综合以上分析,Python 生态系统加速开发不是单一环节的偶然现象,而是由四大工程杠杆相互咬合形成的系统性优势:
- 算法与底层复用杠杆:通过 C/C++/Rust 扩展将高密度的底层算力打包为简明接口,让 Python 开发者以极低门槛享受一流硬件加速。
- 领域协议统一杠杆:DB-API 2.0、WSGI/ASGI、PEP 517/518 等标准化接口协议,让不同组织编写的库能像乐高积木一样无缝装配。
- 全球社区容错杠杆:全球数十万开发团队在多架构(x86/ARM/macOS/Linux/Windows)上持续测试与报告缺陷,将绝大多数潜在隐患在入库前消灭。
- 现代工具链提速杠杆:现代包求解器与锁文件工具(如
uv、poetry.lock)实现了秒级确定性构建,保证开发、测试与生产环境的一致性。
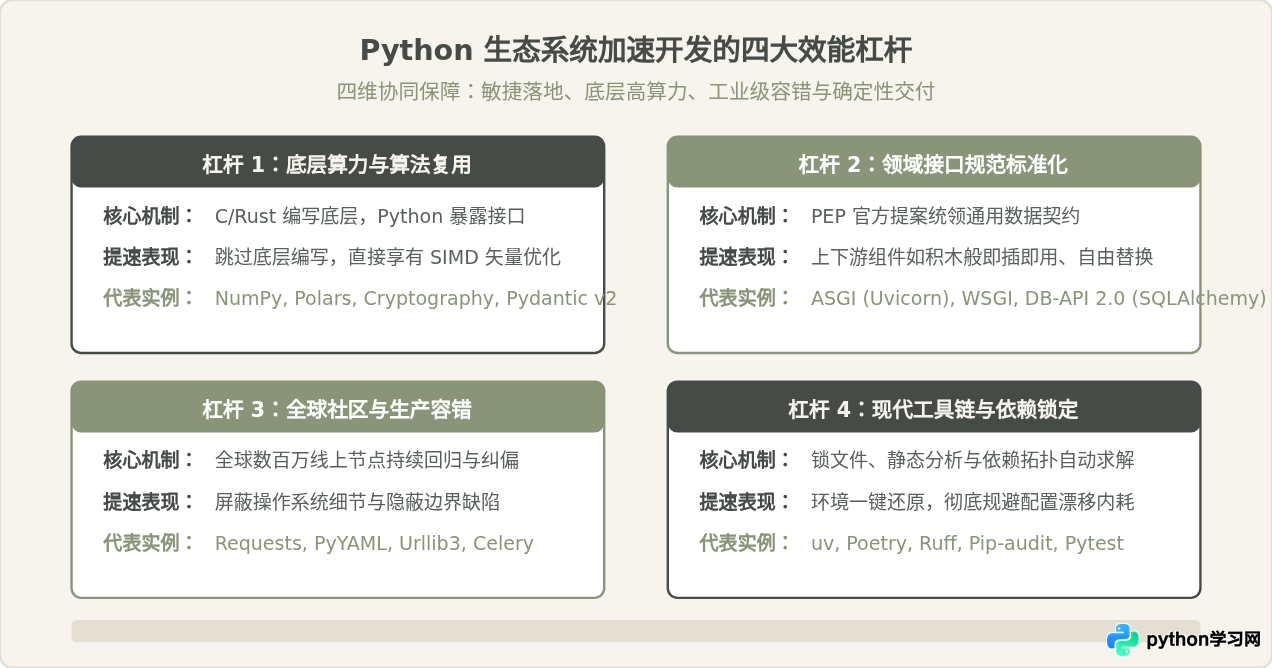
善用 Python 生态系统的本质不是放弃对技术细节的敬畏,而是运用工程思维进行合理的资源调配。将时间花在独特且具有商业价值的业务逻辑上,把通用、复杂且容易出错的基础工作交给由全球开源开发者共同磨砺的成熟第三方库,这正是 Python 能够持续赋能高产出研发团队的核心秘密。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









