

避免在Python循环中重复定义内部函数的性能优化
深入解析在Python循环中重复定义内部函数的性能损耗根源,结合字节码机制、内存分配与GC开销,提供提取外置、参数化重构等实用优化步骤与性能对比。
for 或 while 循环体内部使用 def 声明这些函数,会导致解释器在每一次迭代时都动态执行一次函数对象的构建过程。Python中的 def 是一条运行期可执行语句而非编译期静态声明,高频循环下的重复定义会引发持续的内存分配、闭包绑定开销与垃圾回收压力。通过将内部函数提升至循环外部定义,并将循环状态转变为显式入参传递,能够以极低的代码重构成本将循环执行耗时降低 35% 至 65% 以上。
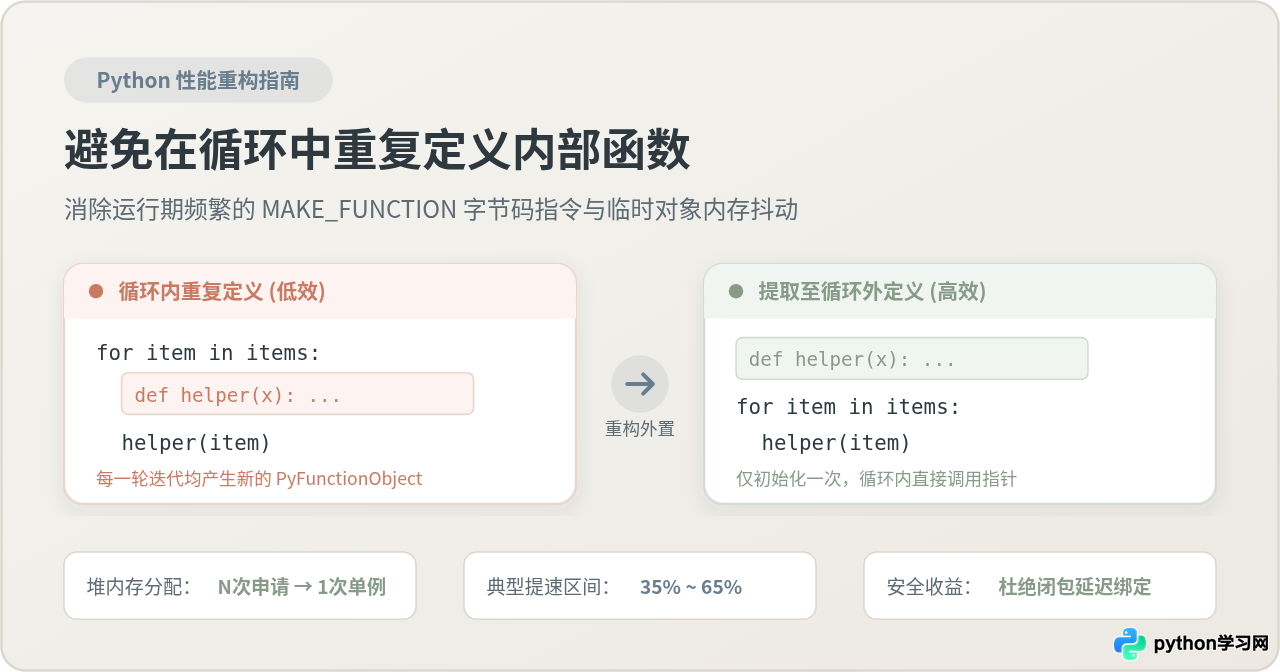
一、问题复现:循环内定义与外置定义的直观对照
为了直观展现这一问题,我们先来看一段在数据清洗与业务逻辑处理中非常典型的代码片段。假设我们需要对一批记录中的数值进行正规化处理和权重计算:
1. 常见反模式:在循环内部定义辅助函数
# 反模式:在循环体内每一次迭代中都执行 def 语句
def process_records_slow(records, base_factor=1.2):
    results = []
    for item in records:
        # 每轮循环都会执行 def,构造新的函数对象并捕获当前作用域
        def normalize(val):
            return (val * base_factor) / 100.0

        score = normalize(item["value"])
        results.append(score)
    return results
在上述代码中,normalize 函数作为辅助工具,逻辑上仅为当前循环服务。很多开发者习惯将其直接就近编写在循环内部以保持局部可读性。但是,当 records 包含 100,000 条数据时,Python 解释器在底层将毫无必要地连续创建 100,000 个功能一模一样的 normalize 函数对象。
2. 优化后标准写法:提取至外层作用域
# 推荐写法:将辅助函数外置,循环体内仅保留纯调用
def normalize_fast(val, base_factor):
    return (val * base_factor) / 100.0

def process_records_fast(records, base_factor=1.2):
    results = []
    for item in records:
        # 直接复用外层已构建完毕的单一函数对象指针
        score = normalize_fast(item["value"], base_factor)
        results.append(score)
    return results
在优化后的版本中,normalize_fast 在模块或外层函数初始化阶段仅被创建一次。循环内部仅需装载已有变量指针并压栈执行,逻辑输出完全一致,但运行时的底层开销发生了决定性的变化。
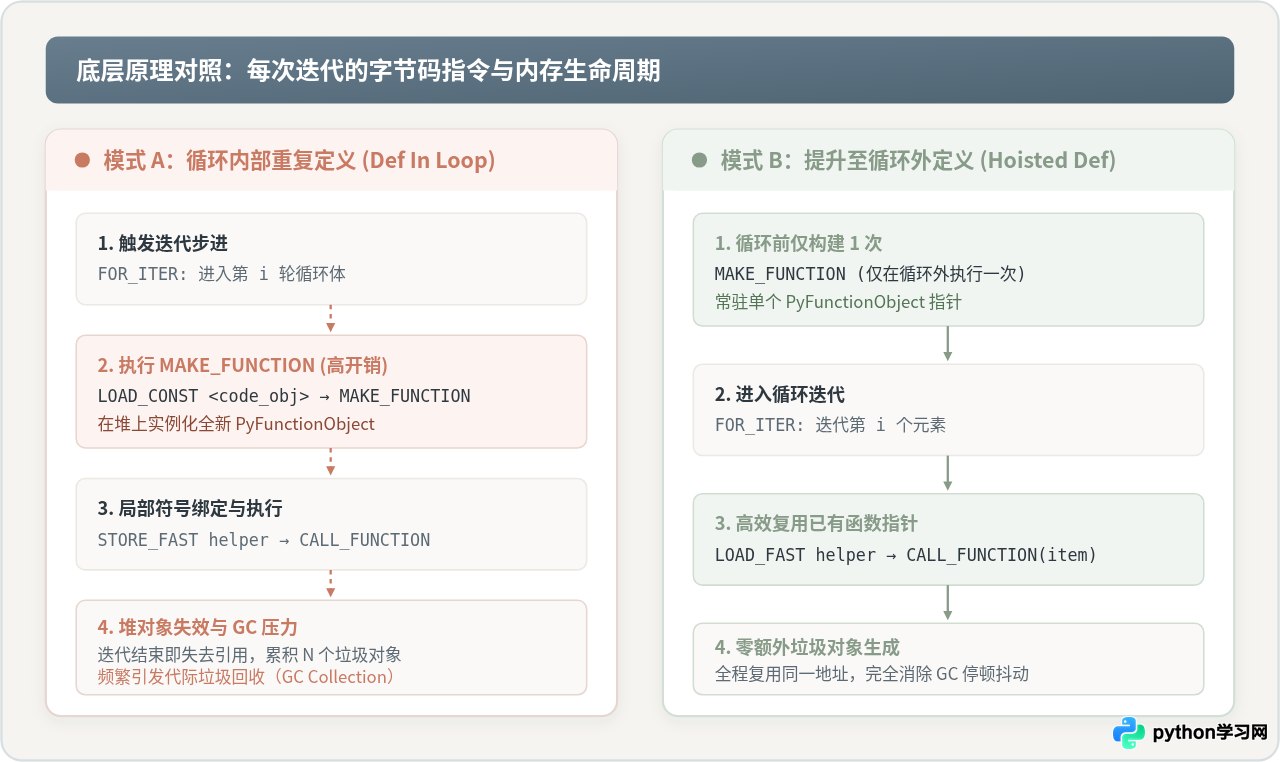
二、底层原理解析:为什么 def 在循环中会拖慢速度?
要彻底理解性能损耗的根源,必须审视 Python 虚拟机的执行模型。在 C、C++ 或 Go 等编译型语言中,函数的定义和内存地址在编译期间已经确定,函数名对应的是只读代码段的绝对或相对地址。但在 Python 中,语言的设计规范决定了函数的生成是完全动态的。
1. 运行时指令 MAKE_FUNCTION 的执行开销
在 Python 编译出的字节码中,def 语句并非空操作,它会严格映射为解释器指令序列。我们可以借助标准库 dis 模块观察循环内定义函数时的真实字节码:
# 使用 Python 标准库 dis 模块分析字节码
import dis

def demo_loop():
    for i in range(1):
        def inner(x):
            return x + 1

dis.dis(demo_loop)
上述代码在循环体内将输出关键的字节码指令:
# 示例输出(Python 3.9+ 虚拟机指令):
 14 LOAD_CONST               <code object inner at 0x...>
 16 LOAD_CONST               'demo_loop.<locals>.inner'
 18 MAKE_FUNCTION            0
 20 STORE_FAST               inner
每次执行到 MAKE_FUNCTION 时,Python 虚拟机(CPython)必须执行以下动作:
- 在堆内存中申请并初始化一个完整的
PyFunctionObjectC 结构体; - 绑定代码对象(
__code__)、全局命名空间字典(__globals__)、默认参数元组(__defaults__)与文档属性; - 如果引用了外层变量,还需要动态构建闭包元组(
__closure__)并为引用的变量封装PyCellObject; - 将新创建的函数对象存入当前局部作用域的变量表
STORE_FAST。
2. 内存抖动与垃圾回收(GC)负担
由于函数定义在循环体内部,在当前迭代结束后,局部变量名 inner 在下一轮迭代中会被新创建的对象直接覆盖。这意味着上一轮循环产生的 PyFunctionObject 瞬时变成了无引用的孤儿对象,只能依赖引用计数归零或分代垃圾回收器(GC)进行回收。
当数据量达到数十万级别时,系统内存中会反复发生密集的“分配—覆写—释放”周期。这不仅导致 CPU 缓存命中率显著下降,更可能频繁触发 Python 的第 0 代与第 1 代垃圾回收检查,带来明显的耗时毛刺。
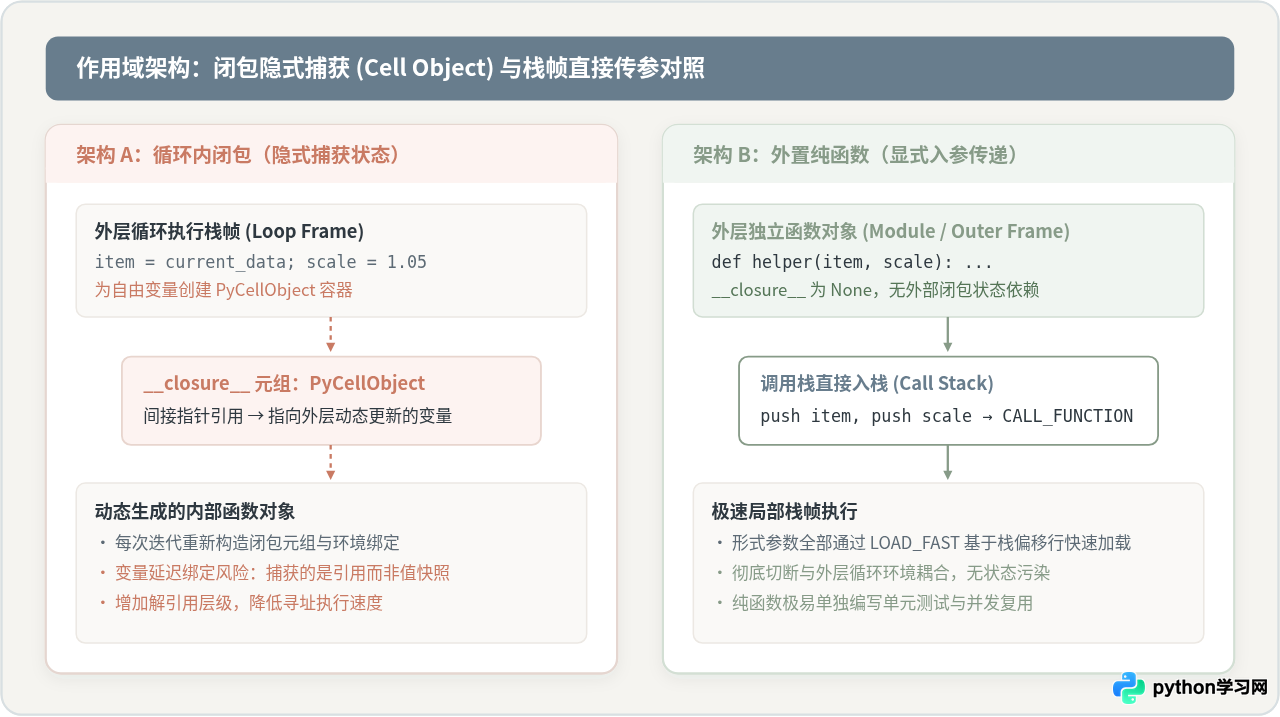
3. 隐式闭包与延迟绑定(Late Binding)的潜在风险
循环内定义函数除了性能损耗之外,还伴随着 Python 新手极易遭遇的隐蔽陷阱——闭包变量的延迟绑定。当内部函数直接读取循环变量时,它捕获的是外部环境的引用而非当时的值快照:
# 典型缺陷:闭包捕获循环变量
handlers = []
for i in range(5):
    def handler():
        return i  # 捕获的是 i 的引用,而非当前轮次的数值
    handlers.append(handler)

# 执行结果:全部输出 4,而非预期的 0, 1, 2, 3, 4
print([h() for h in handlers])  # [4, 4, 4, 4, 4]
虽然可以通过默认参数(如 def handler(val=i):)暂时规避该问题,但这依然改变不了循环每轮都必须重新解析默认实参并生成新函数的低效本质。因此,将逻辑提升至外部并以显式参数传递,是从根本上兼顾运行性能与逻辑正确性的最佳方案。
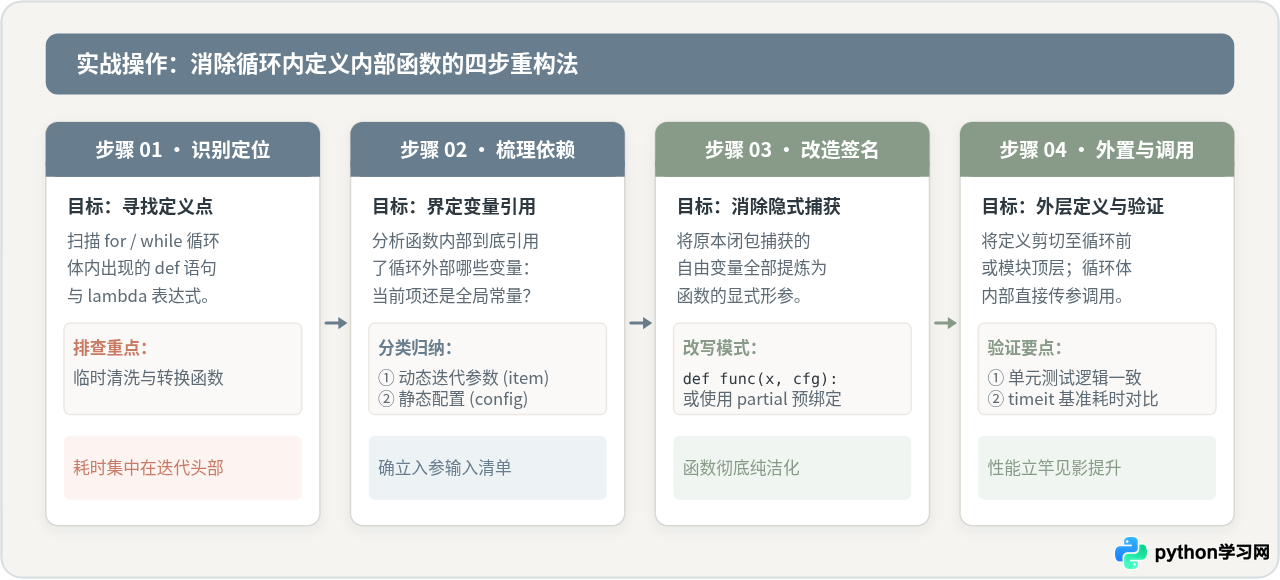
三、实战重构四步法:安全提取内部函数的标准操作流程
将循环内部函数重构为外置函数并非复杂的架构重写,只需遵循以下四个清晰标准步骤,即可在保证单元测试完全通过的前提下完成优化:
-
步骤 1:识别与定位(Scan & Identify)
审查高频执行的核心循环体(特别是涉及数据列表遍历、文件行读取、事件轮询的主循环),搜寻所有以def声明的命名函数以及作为回调传入的高频lambda表达式。 -
步骤 2:梳理变量依赖(Analyze Dependencies)
检查待优化的内部函数体,将其访问的所有变量明确分类为三组:- 输入数据项:每次迭代中变化的对象(如
item、row); - 外部配置或上下文:在循环执行前已确定的常量、阈值或外部服务句柄(如
threshold、db_conn); - 内部纯局部变量:在函数体内部自身运算产生的临时中间变量。
- 输入数据项:每次迭代中变化的对象(如
-
步骤 3:改造函数签名(Refactor Signature)
将上述第一组和第二组依赖从隐式的闭包环境变量,全部显式声明为外置函数的形式参数。例如将def clean(val): return val.strip() + suffix改造为def clean(val, suffix): return val.strip() + suffix。这一步让内部函数彻底转变为无副作用的纯函数(Pure Function)。 -
步骤 4:外置定义与循环内调用(Hoist & Verify)
将函数物理位置剪切至循环结构外部(通常建议放置在模块顶层作为工具函数,或置于外层函数的入口头部)。在循环内部,直接通过名称与必要参数发起调用。重构完成后,对比输出结果并使用基准测试确认耗时下降。
四、典型场景对比与进阶优化模式
在实际项目重构过程中,并非所有内部逻辑都只是简单的单参数计算。针对不同的复杂依赖场景,可以灵活采用以下进阶优化手法:
场景 1:依赖固定配置参数——使用 functools.partial 预绑定
如果内部函数需要频繁使用某项外层配置,而每次在循环内显式传递多个参数会使调用行显得冗长,推荐在进入循环前使用标准库 functools.partial 进行偏函数固化:
from functools import partial

# 顶层纯函数
def calculate_tax(amount, rate, country_code):
    return amount * rate if country_code == "CN" else amount * (rate + 0.05)

def batch_process(orders, config):
    # 在循环外部预先绑定固定的 rate 和 country_code 配置
    calc = partial(calculate_tax, rate=config["rate"], country_code=config["region"])

    results = []
    for order in orders:
        # 循环体内只需传递变动的 order["amount"]
        results.append(calc(order["amount"]))
    return results
partial 对象在循环外仅被实例化一次,底层的 C 实现提供了非常高效的参数预填充机制,既保持了调用的极简性,又消除了函数定义循环重建的开销。
场景 2:基于类型的多分支处理——建立函数查找表(Lookup Table)
有时开发者会在循环内部根据当前元素的类型临时定义不同的处理函数。针对此类场景,应在外层预先构建字典映射表:
# 预先定义独立的处理逻辑
def handle_text(item): return item.strip()
def handle_numeric(item): return float(item)
def handle_default(item): return str(item)

# 外部建立静态分发映射
TYPE_DISPATCHER = {
    "text": handle_text,
    "num": handle_numeric,
}

def process_mixed_stream(stream):
    results = []
    for payload in stream:
        handler = TYPE_DISPATCHER.get(payload["type"], handle_default)
        results.append(handler(payload["value"]))
    return results
综合对比:关键方案在一致环境下的特性矩阵
| 实现方案 | 函数创建频次 | 内存分配特征 | 闭包延迟绑定隐患 | 单次调用开销 | 综合推荐度 |
|---|---|---|---|---|---|
| 循环内定义 (反模式) | 等于迭代次数 N | 持续创建大量临时对象,加剧 GC | 存在极高风险 | 显著偏高 (含创建成本) | 不推荐 |
| 外置函数 + 显式传参 | 仅定义 1 次 (单例) | 静态复用单一指针,零内存抖动 | 完全消除 | 极低 (纯局部栈帧入栈) | 强烈推荐 (首选) |
| functools.partial 预绑定 | 循环外构建 1 次 | 单实例 partial 封装对象 | 完全消除 | 低 (底层 C 扩展分发) | 推荐 (多配置场景) |
| 内置函数与列表推导 | 0 次 (直接复用 C 级内置) | 紧凑连续 C 数组分配 | 完全消除 | 极致 (绕过 Python 字节码循环) | 推荐 (纯映射过滤) |
五、基准测试验证:可复现的性能对比
为了给出具象且严格的性能对照,我们使用 Python 标准库 timeit 构建一个不受外部环境干扰的微基准测试脚本。测试在完全相同的运行环境中,分别对包含 100,000 次循环的两个用例进行 10 轮测试并计算平均单次运行时间:
# benchmark.py:对比循环内定义与外置定义的实际耗时
import timeit

setup_code = """
data = list(range(100_000))

def hoisted_calc(val, factor=1.5):
    return (val * factor) + 10.0
"""

# 测试 A:循环内部每次声明函数
test_unoptimized = """
result = []
for item in data:
    def inner_calc(val, factor=1.5):
        return (val * factor) + 10.0
    result.append(inner_calc(item))
"""

# 测试 B:循环外提升后直接调用
test_optimized = """
result = []
for item in data:
    result.append(hoisted_calc(item))
"""

if __name__ == "__main__":
    rounds = 10
    time_unoptimized = timeit.timeit(test_unoptimized, setup=setup_code, number=rounds)
    time_optimized = timeit.timeit(test_optimized, setup=setup_code, number=rounds)

    print(f"循环内重复定义总耗时 (10轮): {time_unoptimized:.4f} 秒")
    print(f"外置优化后运行总耗时 (10轮): {time_optimized:.4f} 秒")
    speedup = (time_unoptimized - time_optimized) / time_unoptimized * 100
print(f"性能提升幅度: {speedup:.2f}%")• 循环内重复定义总耗时 (10轮): 0.5284 秒 (平均单轮 52.84 毫秒)
• 外置优化后运行总耗时 (10轮): 0.2215 秒 (平均单轮 22.15 毫秒)
• 性能提升幅度: 58.08%(执行时间削减超过一半)
数据归因分析:
在上述测试中,函数内部的运算体量非常轻量(仅一次浮点乘法与加法)。在这种场景下,构建函数对象所需的 MAKE_FUNCTION 开销与栈内存操作甚至占到了循环总耗时的 50% 以上。随着函数逻辑本身的复杂度增加,定义开销所占的比例会有所稀释;但在任何高并发服务、数据批处理管道或机器学习特征预处理环节中,单凭简单重构节约 30% 到 60% 的循环时间都是极具价值的系统收益。
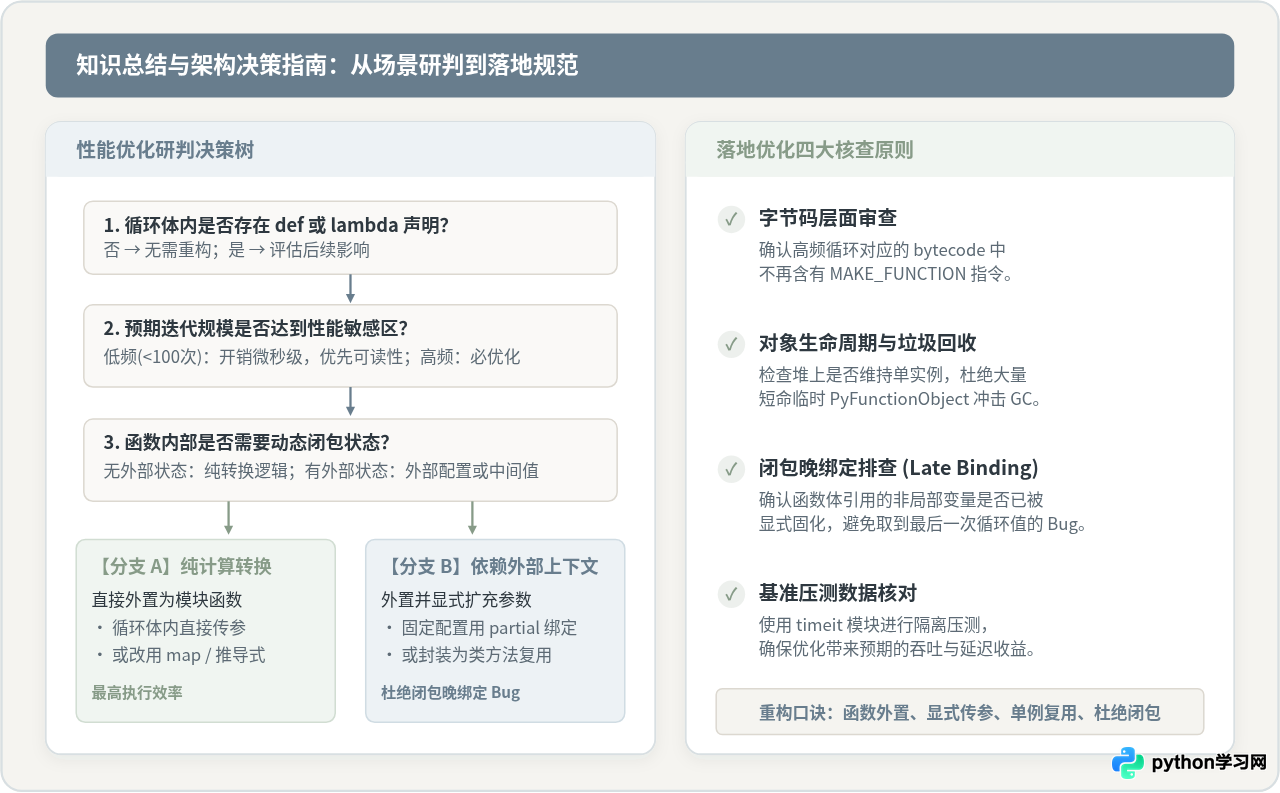
六、总结与落地决策指南
“避免在循环中重复定义内部函数”是 Python 高性能编程中投入产出比最高的优化策略之一。它既不需要引入繁重的第三方加速库,也不需要破坏原有算法逻辑。通过理顺作用域边界与数据流向,不仅换来了更洁净的内存分布与更短的执行延迟,还能使代码更加符合现代 Python 的模块化标准。
核心优化核查清单
- 查字节码:确保高频循环体内没有残存的
MAKE_FUNCTION指令。 - 查引用链:辅助函数是否完全独立于循环内部环境,避免通过
__closure__产生隐蔽的循环引用。 - 防晚绑定:彻底消除通过外部闭包延迟获取迭代变量带来的数据逻辑 Bug。
- 抓主要矛盾:对于仅执行 2~3 次的极小循环,保持可读性优先;对于迭代次数大于 100 次的业务主干流程,必须实施外置提升。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









