

Python自动化常用模块盘点:办公、Web与运维库推荐
全面盘点Python在办公文档处理、Web交互与系统运维三大核心场景的常用自动化模块。对比openpyxl与pandas在表格处理中的差异,解析requests与Playwright的技术选型,并介绍psutil与Fabric等运维工具的标准落地实践。
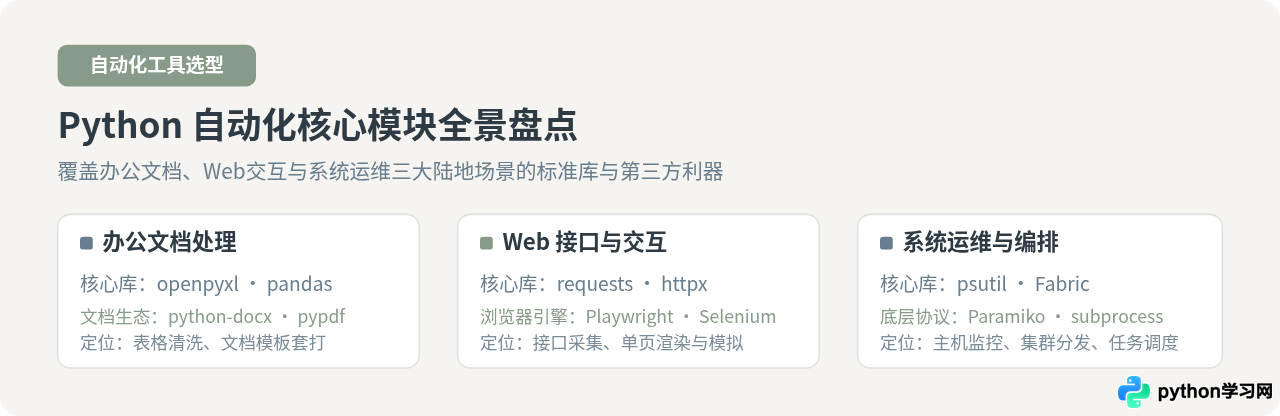
一、办公自动化常用模块:Excel、Word与PDF处理
日常办公中最繁重的体力劳动往往集中在报表整合、合同套打以及发票扫描件拆合上。Python 免除了用户手动启动 Microsoft Office 或 WPS 软件的开销,直接在内存中解析和重构底层文件规范(如 OpenXML 规范与 PDF 页面树)。
1. 表格自动化:openpyxl 与 pandas 的选型差异
Excel 处理是办公自动化的核心环节。初学者往往困惑何时使用 openpyxl,何时使用 pandas。这两者在底层机制与应用定位上存在鲜明的差别:
- openpyxl:专精于 Excel 原生格式与模板定制。它能精确读取与修改每一个单元格的字体粗细、背景填充色、边框样式、合并单元格以及原生计算公式(如
=SUM(A1:A10)),适合“高保真交付”给客户或财务部门的标准排版报表。 - pandas:专精于大规模二维数据计算与多源数据整合。它采用底层 C 优化的向量化运算,能够瞬间完成十万行级数据的分组汇总(
groupby)、多表关联(merge)、透视表计算与缺失值清洗。但它对单元格颜色、边框和复杂公式不具备精细控制能力。
在工程实践中,推荐的最佳模式是“pandas 算数据,openpyxl 控格式”:先用 pandas 完成多源原始数据的清洗过滤并导出基础表,再用 openpyxl 载入该表格,补充表头样式、隔行底色与求和公式。
# 示例:使用 openpyxl 格式化月度对账明细
import openpyxl
from openpyxl.styles import Font, PatternFill, Alignment, Border, Side

wb = openpyxl.Workbook()
ws = wb.active
ws.title = "月度销售对账"

# 写入表头与测试数据
headers = ["订单编号", "客户名称", "采购件数", "单价(元)", "总金额(元)"]
ws.append(headers)

sample_rows = [
    ["ORD-20261001", "华东分销中心", 120, 45.0, None],
    ["ORD-20261002", "华南零售网点", 300, 38.5, None],
    ["ORD-20261003", "北方仓储中心", 85, 92.0, None],
]

for row_idx, r in enumerate(sample_rows, start=2):
    ws.append(r)
    # 动态写入 Excel 原生公式,避免写入静态硬编码计算值
    ws[f"E{row_idx}"] = f"=C{row_idx}*D{row_idx}"

# 设置表头灰蓝背景与白字加粗
header_fill = PatternFill(start_color="687D8D", end_color="687D8D", fill_type="solid")
header_font = Font(name="Microsoft YaHei", size=11, bold=True, color="FFFFFF")
thin_border = Border(
    left=Side(style='thin', color='D0D5DD'),
    right=Side(style='thin', color='D0D5DD'),
    top=Side(style='thin', color='D0D5DD'),
    bottom=Side(style='thin', color='D0D5DD')
)

for col in range(1, len(headers) + 1):
    cell = ws.cell(row=1, column=col)
    cell.fill = header_fill
    cell.font = header_font
    cell.alignment = Alignment(horizontal="center", vertical="center")
    cell.border = thin_border

# 调整列宽以完整展示内容
for col in ws.columns:
    max_len = max(len(str(cell.value or '')) for cell in col)
    col_letter = openpyxl.utils.get_column_letter(col[0].column)
    ws.column_dimensions[col_letter].width = max(max_len * 2, 14)

wb.save("月度销售对账表.xlsx")
2. 文档生成与 PDF 整理:python-docx 与 pypdf
对于 Word 文档的批量生成,python-docx 是工业标准。常见的做法是准备一份排版完备的红头模板或合同范本,在文中保留如 {CLIENT_NAME} 或 {CONTRACT_DATE} 等特定占位符,通过脚本扫描段落与表格执行内容替换,实现数千份文档的一键排版。
而在需要处理发票切分、审批单拼接或归档加密时,pypdf(旧称 PyPDF2)提供了最纯粹的页面级操作,无需依赖 Ghostscript 等复杂的外部本地依赖即可在内存中提取或合并页面。
# 示例:使用 pypdf 合并多份季度审批归档文件
from pypdf import PdfMerger

merger = PdfMerger()
pdf_files = ["审批封面.pdf", "月度明细.pdf", "签批附页.pdf"]

for pdf in pdf_files:
    # 逐一追加页面流
    merger.append(pdf)

merger.write("2026年三季度完整归档报告.pdf")
merger.close()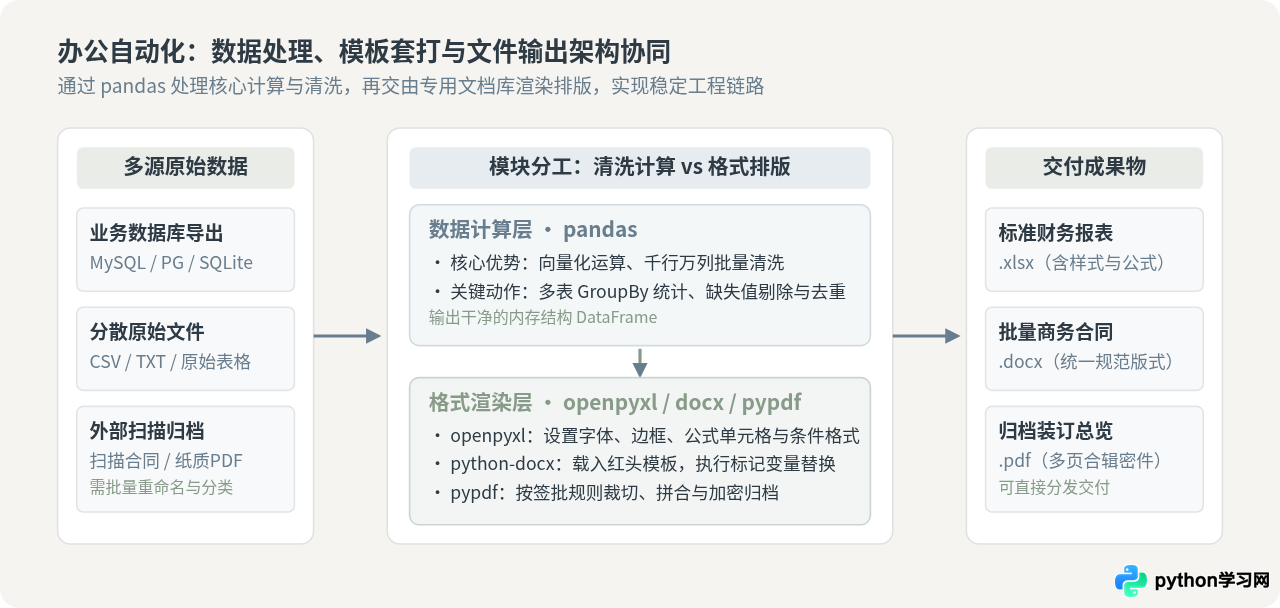
二、Web自动化常用模块:接口抓取与浏览器驱动
Web 自动化通常有两种截然不同的切入路径:一种是直接调用后端网络协议的 HTTP 接口层,另一种是直接接管前端渲染引擎的 真实浏览器仿真层。清晰地辨析两者的应用场景,能够帮助开发者省去数倍的调试与资源成本。
1. 轻量接口直接交互:requests 与 httpx
requests 是 Python 社区中最久经考验的 HTTP 库,以简洁优雅的 API 著称。如果目标系统具备 RESTful API,或者网页采用服务端直接渲染(SSR)输出 HTML,使用 requests 结合 BeautifulSoup 或 lxml 即可在几毫秒内提取到目标字段。
随着异步协程(asyncio)在爬虫与高并发场景中的普及,httpx 逐渐成为现代首选。它不仅保持了与 requests 高度一致的 API 习惯,还原生支持 HTTP/2 与 async/await 异步调用,能在单机上轻松维持数百个非阻塞网络通道。
# 示例:使用 requests 发送带鉴权与超时的工业级请求
import requests

def fetch_exchange_rates(api_key: str):
    url = "https://api.example.com/v1/rates/latest"
    headers = {
        "Authorization": f"Bearer {api_key}",
        "User-Agent": "AutomationAgent/1.0 (AuditBot)"
    }
    params = {"base": "CNY", "symbols": "USD,EUR,JPY"}

    try:
        # 始终明确指定超时(连接超时,读取超时),杜绝无响应挂起
        response = requests.get(url, headers=headers, params=params, timeout=(3.0, 10.0))
        response.raise_for_status()  # 非 200 响应直接抛出 HTTPError
        return response.json()
    except requests.exceptions.RequestException as err:
        print(f"数据拉取失败: {err}")
        return None
2. 现代浏览器自动化:Playwright 替代传统方案
当目标网站属于单页应用(SPA)、数据通过复杂的混淆前端 JavaScript 动态加载,或者需要点击悬浮菜单、拖拽滑动滑块验证码时,纯 HTTP 库就无能为力了。此时必须通过真实无头浏览器(Headless Browser)执行交互。
相比于早期的 Selenium,新一代的 Playwright 具有明显的工程优势:
- 开箱即用的驱动托管:通过
playwright install自动匹配并安装打包好的 Chromium、Firefox 与 WebKit 引擎,告别 ChromeDriver 与本地浏览器版本不兼容的噩梦。 - 智能自动等待(Auto-waiting):在执行点击(
click)或输入(fill)之前,Playwright 会自动等待元素挂载至 DOM、完成可见性校验并具备可操作性,彻底消除了 Selenium 中大量脆弱的time.sleep()。 - 轻量级隔离(BrowserContext):允许在一个浏览器实例内开启多个独立的上下文,互不干扰 Cookie 与缓存,大幅节约内存开销。
# 示例:使用 Playwright 自动登录并导出报表截图
from playwright.sync_api import sync_playwright

def capture_dashboard_report():
    with sync_playwright() as p:
        # 启动无头 Chromium 浏览器
        browser = p.chromium.launch(headless=True)
        # 创建独立上下文,模拟 1080P 视口
        context = browser.new_context(viewport={"width": 1920, "height": 1080})
        page = context.new_page()

        # 导航并自动等待网络空闲
        page.goto("https://admin.example.com/login", wait_until="networkidle")

        # 填写表单与提交
        page.fill('input[name="username"]', "audit_operator")
        page.fill('input[name="password"]', "SecureP@ss2026")
        page.click('button[type="submit"]')

        # 等待仪表盘关键指标卡片渲染完成
        page.wait_for_selector("#metric-summary-card", timeout=8000)

        # 截取仪表盘图表存证
        page.screenshot(path="每日运营数据监控.png", full_page=False)

        browser.close()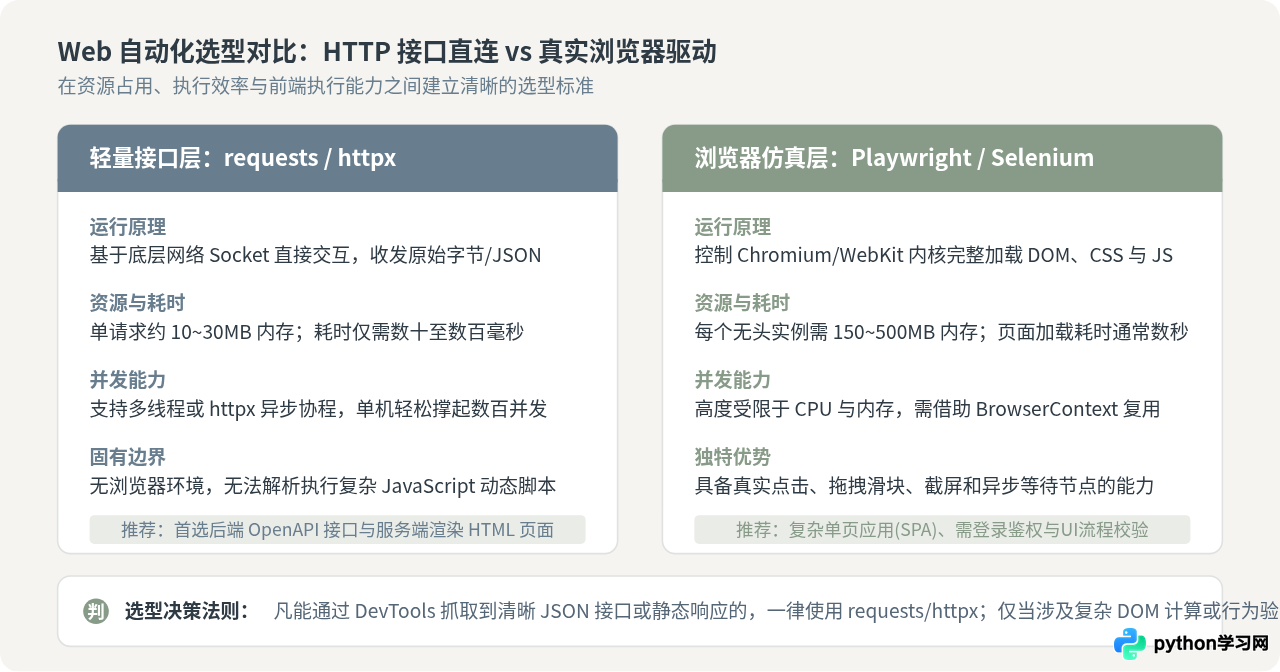
三、系统运维常用模块:监控、远程运维与任务编排
在跨服务器集群与本地服务器环境中,运维自动化的目标是减少人工登录敲命令的频率,实现系统指标的主动探测与批量操作的高可靠分发。
1. 本地主机状态监控:psutil
psutil(process and system utilities)是 Python 跨平台系统监控的基石。无论在 Linux、macOS 还是 Windows 上,它都能以统一的 Pythonic API 读取 CPU 负载、物理内存占用、磁盘空间利用率、网络吞吐以及具体进程树的健康状态。
# 示例:系统核心指标健康巡检告警
import psutil

def inspect_system_health(cpu_limit=85.0, mem_limit=90.0):
    # 阻塞采样 1 秒以获得平滑的 CPU 使用率
    cpu_percent = psutil.cpu_percent(interval=1)
    mem_info = psutil.virtual_memory()
    disk_info = psutil.disk_usage('/')

    warnings = []
    if cpu_percent > cpu_limit:
        warnings.append(f"CPU使用率达到危险阈值: {cpu_percent}%")
    if mem_info.percent > mem_limit:
        warnings.append(f"物理内存使用过高: {mem_info.percent}% (剩余 {mem_info.available // (1024**2)}MB)")
    if disk_info.percent > 90.0:
        warnings.append(f"系统根分区磁盘剩余不足 10%: 已用 {disk_info.percent}%")

    return {
        "healthy": len(warnings) == 0,
        "metrics": {
            "cpu_percent": cpu_percent,
            "memory_percent": mem_info.percent,
            "disk_percent": disk_info.percent
        },
        "alerts": warnings
    }
2. 跨主机远程管控:Paramiko 与 Fabric
若需要对局域网或云端数十台 Linux 主机进行批量配置更新或发布,无需在每台机器上安装复杂的重型客户端 Agent,基于 SSH 协议执行脚本即可。
- Paramiko:实现了 SSHv2 协议的底层通信细节。它处理密钥协商、SFTP 会话管道及套接字流,功能强大但 API 偏底层,编写批量指令时需要手动管理输出缓冲区与连接池。
- Fabric:构建在 Paramiko 之上的高级运维自动化工具。它将复杂的 SSH 管道封装为面向运维习惯的高级命令(如
c.run("systemctl restart nginx")、c.put("app.tar.gz", "/opt/app/")),支持多主机并发编排,极大提升了远程任务的编写效率。
# 示例:使用 Fabric 批量分发配置并优雅重载服务
from fabric import Connection
from invoke.exceptions import UnexpectedExit

def deploy_hotfix(host_ip: str, key_path: str):
    # 建立免密安全连接
    c = Connection(
        host=host_ip,
        user="deployer",
        connect_kwargs={"key_filename": key_path, "timeout": 5}
    )

    try:
        # 上传更新配置文件
        c.put("nginx.conf", remote="/etc/nginx/nginx.conf")
        # 远程测试配置有效性
        c.run("sudo nginx -t", pty=True)
        # 执行平滑重启
        c.run("sudo systemctl reload nginx", pty=True)
        print(f"主机 {host_ip} 部署完成")
    except UnexpectedExit as e:
        print(f"主机 {host_ip} 部署中断: 命令执行返回非零状态码 {e.result.exited}")
    finally:
        c.close()
3. 任务调度与定时触发:APScheduler
虽然操作系统的 crontab(Linux)和任务计划程序(Windows)也能触发 Python 脚本,但在复杂的工程中,我们往往需要将调度逻辑嵌入到应用程序生命周期内部。APScheduler(Advanced Python Scheduler)提供了强大的定时机制,支持基于指定时间点(Date)、固定间隔(Interval)以及 Cron 表达式的灵活触发,并且内置了持久化作业存储(JobStore),防止进程重启导致定时计划遗失。
四、工程落地与避坑指南
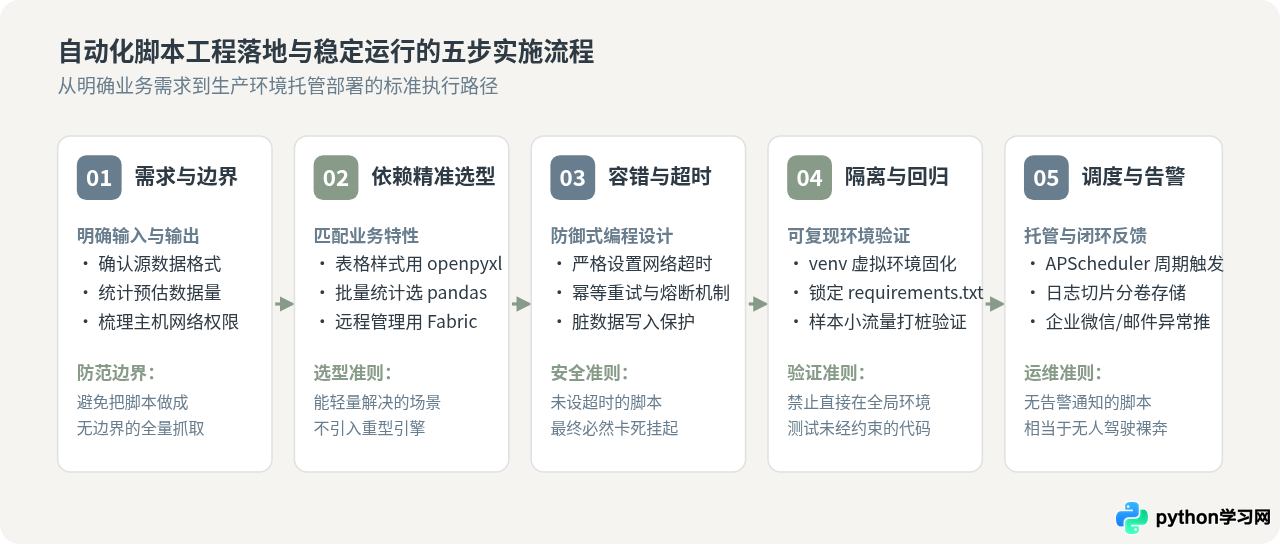
自动化脚本从“本地跑通”到“无人值守长期稳定运行”,中间往往横亘着网络抖动、异常未捕获、数据竞争等陷阱。以下是在编写自动化脚本时必须落实的工程规范:
在调用
requests.get()、playwright 页面导航或 subprocess.run() 时,Python 默认情况下部分接口会处于无限等待状态。一旦远端服务器出现连接假死,脚本进程将永远阻塞挂起,占满系统连接句柄。务必养成所有 I/O 显式传递超时的习惯。
自动化脚本极容易因为网络波动而中断重试。如果脚本逻辑不具备幂等性(例如:重试一次就重复创建一条数据库记录或多发一次邮件),自动化反而会变成灾难。在写入数据前应先校验唯一键或事务状态,确保“执行一次”与“重复执行多次”的最终结果完全一致。
切忌在操作系统的全局 Python 环境中杂乱安装第三方库。请使用
python -m venv .venv 为每个独立自动化项目创建隔离环境,并通过 pip freeze > requirements.txt 锁定版本号,防止上游库升级引入不可预期的破坏性变更(Breaking Changes)。
五、总结与模块选型推荐速查
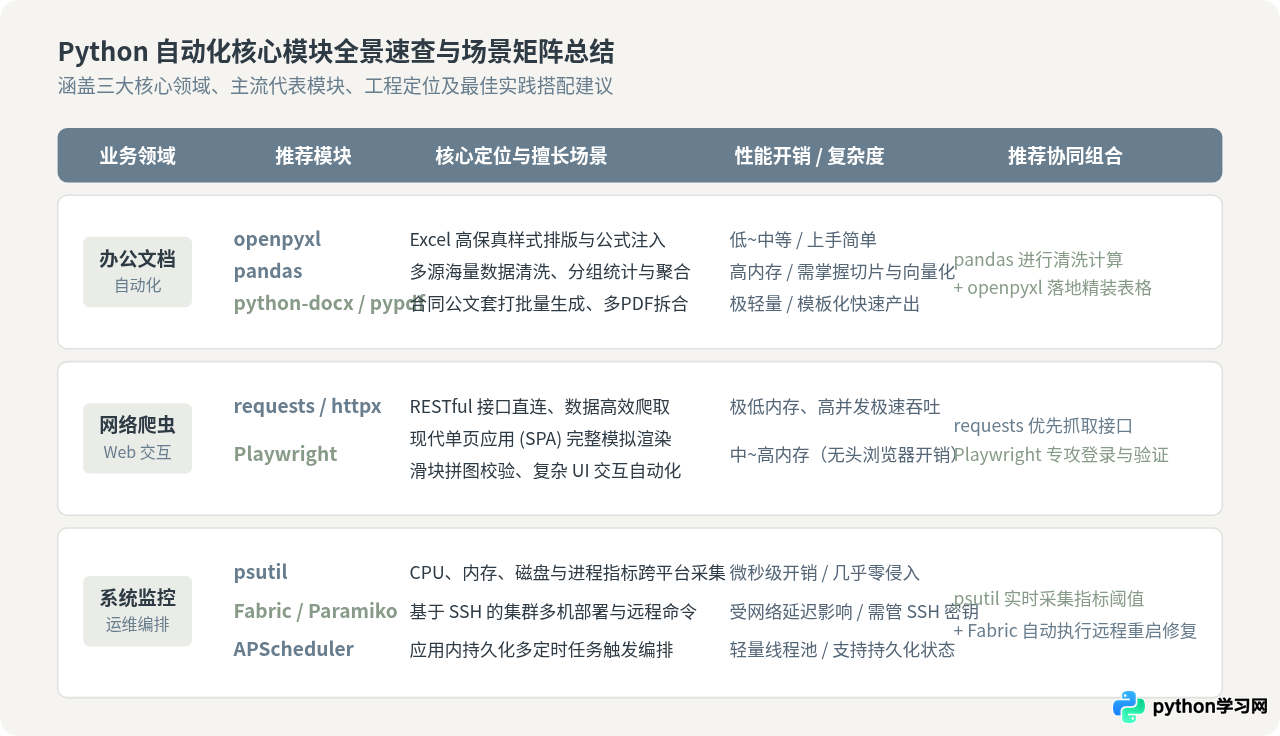
选用自动化工具的关键原则在于“克制与场景匹配”。不要为了追求新潮技术而将简单的任务复杂化:
- 面对规则明确、没有复杂前端交互的数据流转,优先使用
requests结合pandas打造高效批处理流水线; - 涉及复杂格式报表或合同样本套打时,引入
openpyxl与python-docx做精确模版控制; - 只有在强依赖前端动态渲染与复杂人机交互的场景下,才启动
Playwright无头浏览器; - 在多机运维与集群监控时,以
psutil配合Fabric搭建无代理(Agentless)的极简管理通道。
根据明确的业务输入输出,选用精简而匹配的模块组合,再结合完善的超时设计与日志告警,才能构建起真正省时、稳定且能够长期无人值守运行的 Python 自动化体系。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









