

Python csv模块基础:怎么使用reader和writer读写文件
系统讲解 Python 标准库 csv 模块中 reader 与 writer 的核心使用方法。涵盖规范读取、写入防空行配置(newline='')、参数调优、异常排查与最佳实践。
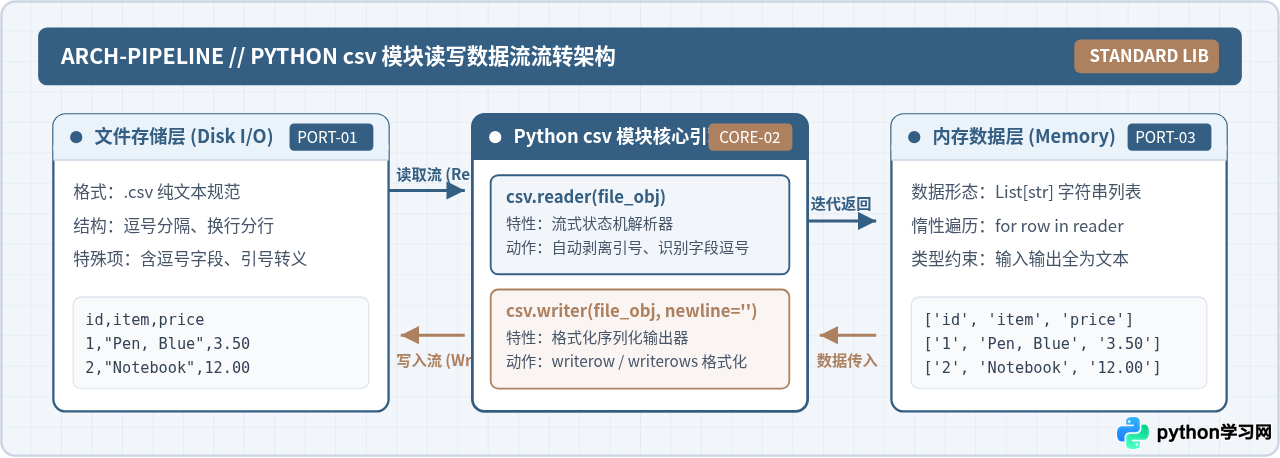
csv 模块专用于处理逗号分隔值(Comma-Separated Values)文件,其核心组件包括逐行解析文本流的 csv.reader 和格式化输出数据的 csv.writer。本文直接讲解如何使用这两个基础工具完成 CSV 文件的规范读取、数据写入、换行符控制及参数调优,帮助读者快速掌握文件流与行列表之间的双向转换,并彻底解决字段含逗号截断、Windows 平台额外空行以及编码冲突等常见问题。
一、为什么不直接用字符串操作处理 CSV
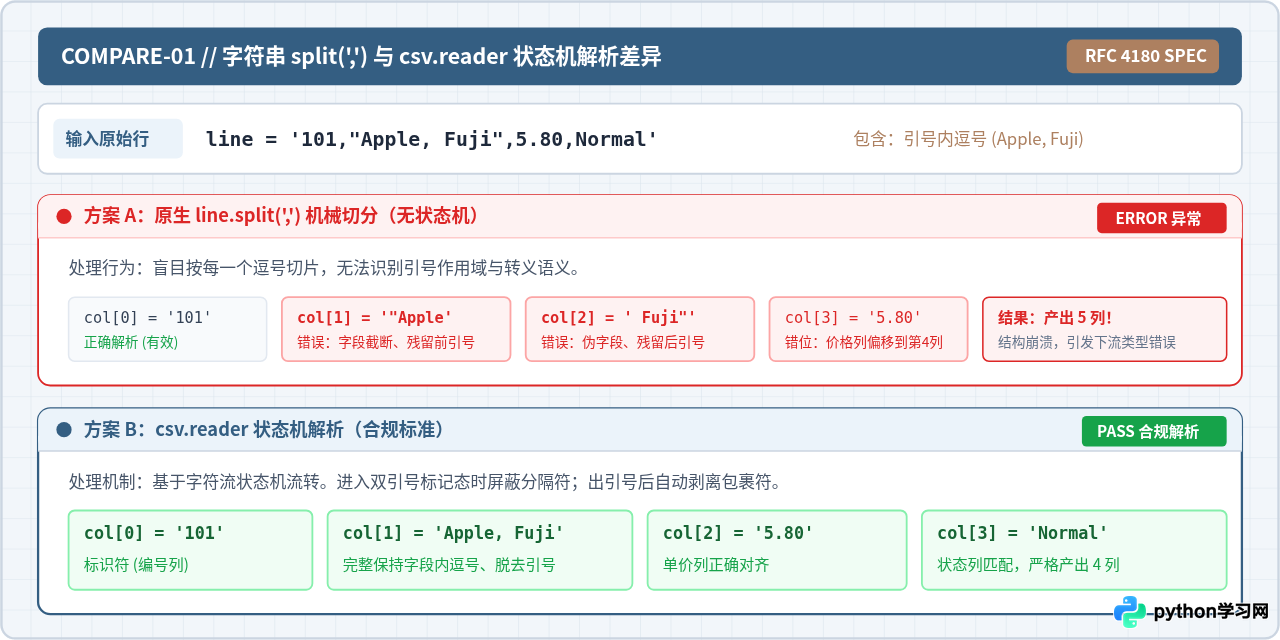
CSV 是一种以纯文本形式存储表格数据的轻量级格式。许多初学者在刚接触 CSV 时,容易直观地认为“只要按行读取文件,再调用 line.split(',') 切分字符串就能得到数据”。这种做法在字段非常简单且绝对不包含特殊字符的场景下看似可行,但在生产环境中极度脆弱。
依据 RFC 4180 规范,当单元格内部本身含有逗号(例如商品英文名称 "Apple, Fuji"、地址或复合描述)、换行符或双引号时,标准生成器会使用双引号将整个字段包裹起来。如果字段内自身包含双引号,则会通过两个连续的双引号 "" 进行转义。普通的 split(',') 只是机械地查找逗号并执行切片,无法识别引号作用域,这会导致原本属于同一个字段的内容被强行拆解为多个列,破坏整行的数据结构与对齐关系。
Python 标准库提供的 csv.reader 底层内置了严格的有限状态机。它在读取字符流时,能够实时维护当前字符是否处于引号闭合区间内的状态:处于引号内部的逗号会被原样保留为字段内容,外层引号会在解析后被自动剥离,转义引号也会被还原为单双引号。
二、使用 csv.reader 读取文件:从基础到精细控制
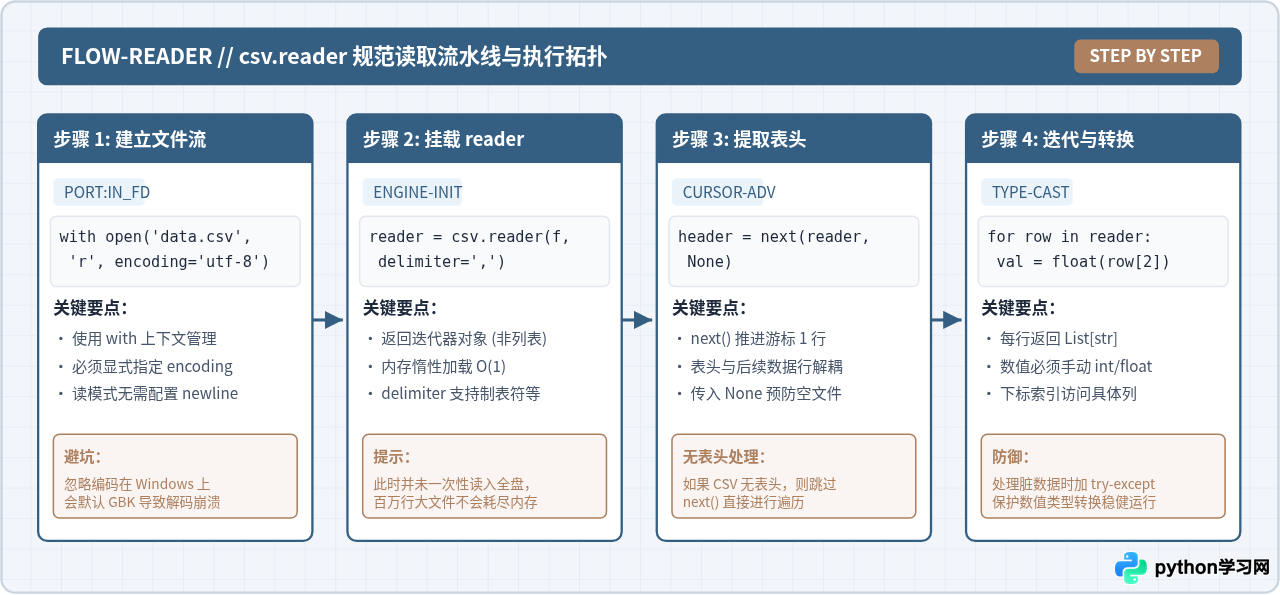
csv.reader 接收一个可迭代的文本文件对象,并返回一个行迭代器。每当遍历该迭代器时,它都会返回一个由字符串组成的列表(List[str]),列表中的每个元素对应 CSV 文件中的一列。
1. 标准读取代码范式
在打开待读取的 CSV 文件时,必须使用 with 语句管理文件上下文,并显式指定 encoding='utf-8'(或文件实际存储所用的字符编码)。代码示例如下:
import csv

# 1. 打开文件并指定字符编码
with open('data.csv', mode='r', encoding='utf-8') as f:
    # 2. 构造 reader 迭代器对象
    reader = csv.reader(f)

    # 3. 提取表头(若文件包含首行字段名)
    header = next(reader, None)
    print("表头字段:", header)

    # 4. 逐行迭代数据行
    for row_idx, row in enumerate(reader, start=1):
        # row 是一个字符串列表,例如 ['101', 'Apple, Fuji', '5.80']
        print(f"第 {row_idx} 行数据:", row)
代码执行输出示例:
表头字段: ['id', 'item', 'price']
第 1 行数据: ['101', 'Apple, Fuji', '5.80']
第 2 行数据: ['102', 'Notebook', '12.00']
2. 核心操作细节与类型转换
理解 csv.reader 的运作机制需要把握以下三个关键事实:
- 惰性迭代(Lazy Evaluation):
csv.reader(f)返回的是一个迭代器,而非把整个文件预先加载到内存中的大列表。这意味着即使面对数百兆或数吉字节的超大 CSV 文件,逐行遍历的内存开销始终保持在极低的常数级别O(1)。 - 表头提取:调用 Python 内置的
next(reader, None)会将游标向前推进一行并返回首行内容。如果不希望将列名当成普通业务数据参与循环计算,先调用一次next()是标准做法。若文件可能为空,设置默认值None可以防止抛出StopIteration异常。 - 所有元素皆为字符串:
csv.reader不会自动推断数据类型。无论原文中的内容是数字5.80还是布尔值,读入后均为str。如果需要进行数值计算,必须在业务逻辑中显式调用int(row[0])或float(row[2])。
3. 自定义分隔符与特殊参数
并非所有结构化文本都使用逗号作为分隔符。例如制表符分隔文件(TSV)使用 ,部分 European 区域设置的导出文件会使用分号 ;。此时可通过指定 delimiter 参数进行适配:
# 读取以分号分隔的 CSV 文件,并忽略字段前置空格
with open('custom.csv', mode='r', encoding='utf-8') as f:
    reader = csv.reader(f, delimiter=';', skipinitialspace=True)
    for row in reader:
        print(row)
三、使用 csv.writer 写入文件:结构输出与空行防范
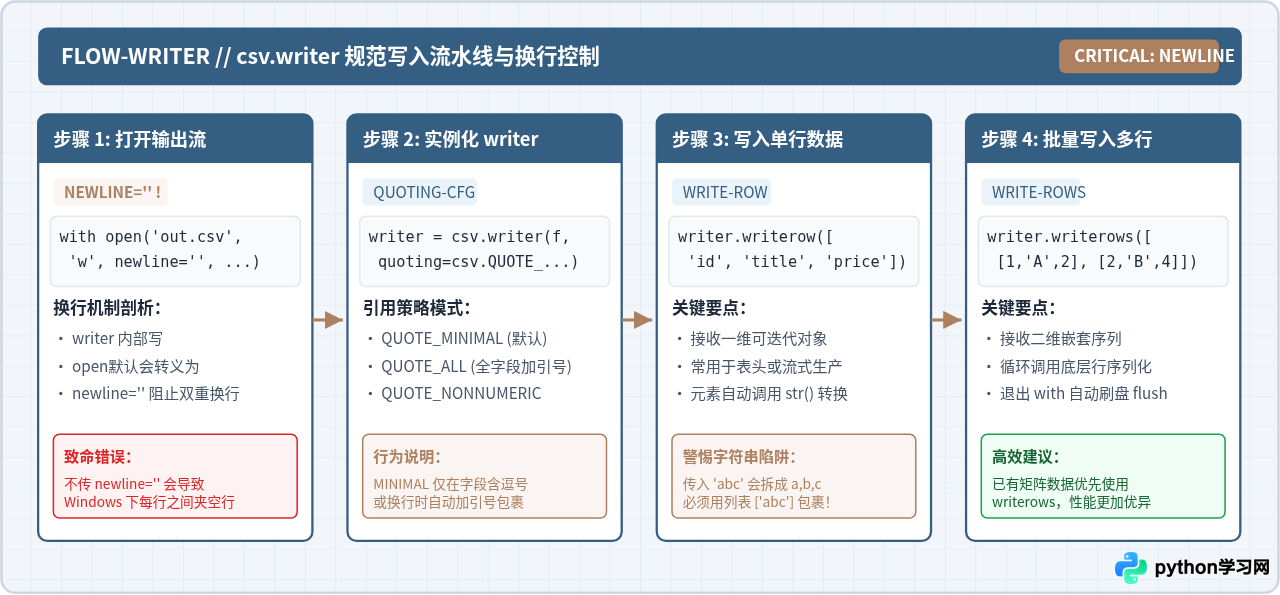
csv.writer 负责将 Python 中的序列数据序列化为符合 CSV 规范的文本行。使用 writer 时最关键的技术约束是在调用 open() 时必须传递 newline='' 参数。
1. 为什么写入时必须声明 newline=''
这是所有 Python 初学者最容易踩中的平台兼容性陷阱。在 Windows 操作系统中,文本文件的标准换行符是
(回车换行),而在 Linux 和 macOS 上是
。
根据 RFC 4180 规范,CSV 的标准行终止符统一为
。因此 csv.writer 在底层构造输出内容时,会在每一行末尾主动生成
。如果不显式传递 newline='',Python 的 open() 函数在 Windows 环境下默认处于文本转换模式,会把 csv.writer 产生的
再次转义为
。最终导致写入磁盘的换行符变成了
。当用文本编辑器或办公软件打开该文件时,每一行有效数据之间都会凭空夹杂一行完全空白的空行。
将 newline='' 传入 open(),意味着指示 Python 底层通用换行符转换机制“不要修改写入文本中的任何换行符,原样写出”,从而确保输出合规且跨平台行为一致。
避坑铁律:凡是调用 open(filename, 'w', ...) 准备交给 csv.writer 写入的流,必须始终带有 newline='',例如:open('output.csv', 'w', newline='', encoding='utf-8')。
2. 单行写入与批量写入代码范式
csv.writer 提供两个核心写入方法:
writerow(row):接收一个一维可迭代对象(如list或tuple),将其格式化并写入一行。writerows(rows):接收一个由多个可迭代对象组成的二维嵌套序列,循环遍历并批量写入多行。
import csv

# 准备要写入的数据结构
header = ['id', 'item_name', 'price', 'in_stock']
rows = [
    [101, 'Apple, Fuji', 5.80, True],
    [102, 'Notebook "A4"', 12.00, False],
    [103, 'Office Chair
Ergonomic', 450.00, True]
]

# 写入文件:务必指定 newline='' 与 encoding
with open('inventory.csv', mode='w', newline='', encoding='utf-8') as f:
    writer = csv.writer(f)

    # 1. 写入表头
    writer.writerow(header)

    # 2. 批量写入多行数据
    writer.writerows(rows)
生成的文件内容验证(inventory.csv):
id,item_name,price,in_stock
101,"Apple, Fuji",5.8,True
102,"Notebook ""A4""",12.0,False
103,"Office Chair
Ergonomic",450.0,True
观察结果:包含逗号的 "Apple, Fuji"、包含双引号的 "Notebook ""A4""" 以及包含换行的字段均被自动添加了合规的保护引号和转义符,完全无需手动编写转义逻辑。
3. 引用策略(quoting 参数)调优
csv.writer 支持通过 quoting 参数控制何时在字段两端添加引号。常见的引用常量包括:
| 常量名称 | 控制行为 | 典型适用场景 |
|---|---|---|
csv.QUOTE_MINIMAL |
默认模式。仅在字段包含分隔符、换行符或引号时才添加引号包裹。 | 绝大多数通用标准 CSV 导出。 |
csv.QUOTE_ALL |
对所有字段无条件添加引号,无论是文本还是数值。 | 下游消费系统要求所有字段必须为字符类型的严苛接口。 |
csv.QUOTE_NONNUMERIC |
对所有非数值字段添加引号,数值型字段保持原样。 | 供外部系统区分文本与数字(读取时还会将未加引号列自动转 float)。 |
csv.QUOTE_NONE |
从不添加引号。若遇到包含分隔符的字段,必须显式配合 escapechar 进行字符转义,否则报错。 |
特殊 UNIX 工具流水线。 |
四、生产环境常见问题与工程避坑指南
1. 字符串传入 writerow() 导致的“字符碎裂”
这是开发中非常隐蔽的一个笔误:writerow() 期待接收的是一个包含各个字段的容器列表。如果开发者误将一个普通字符串直接传给 writerow(),由于字符串在 Python 中本身也是可迭代对象,writer 会将字符串中的每一个字符视作一个独立的列:
# 错误示范:误将字符串直接传入
writer.writerow("101,Pen,3.5")
# 输出结果将被拆碎为:'1','0','1',',','P','e','n',',','3','.','5'

# 正确做法:必须用方括号包裹成列表
writer.writerow(["101,Pen,3.5"])       # 视为单个带逗号的整体字段
writer.writerow(["101", "Pen", "3.5"]) # 视为三个独立字段
2. Excel 中文乱码与 utf-8-sig
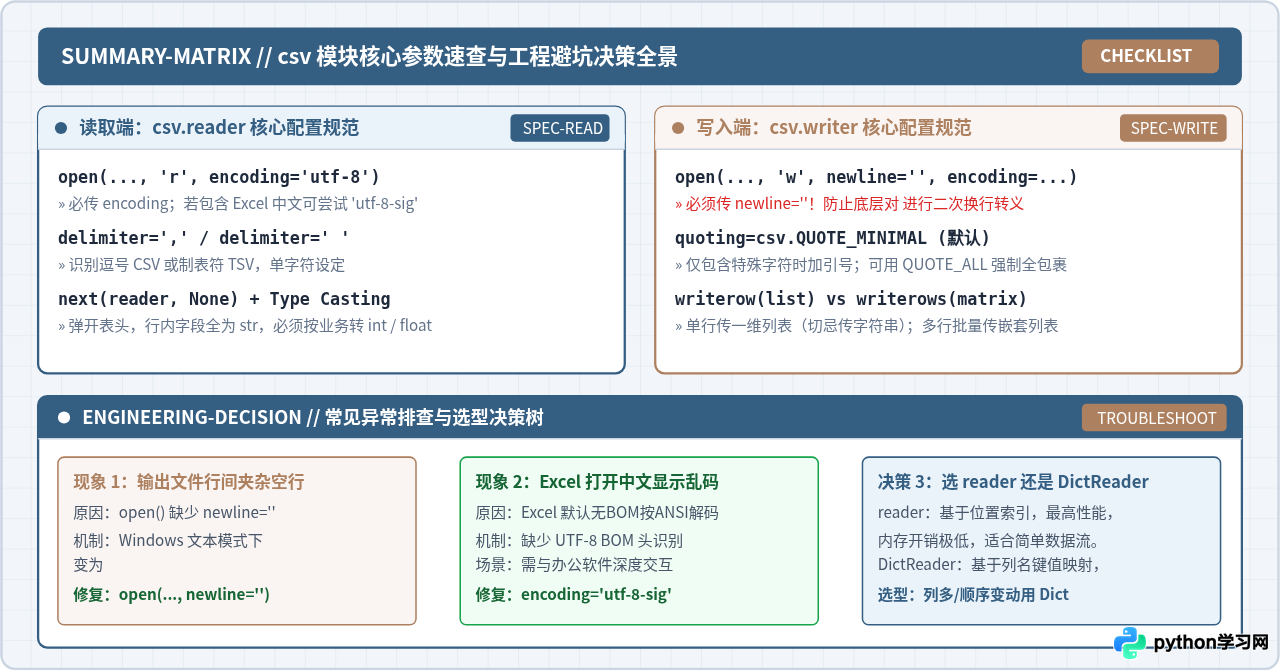
当使用 Python 生成的 UTF-8 编码 CSV 文件直接在微软 Microsoft Excel(尤其是 Windows 版本)中双击打开时,中文内容经常显示为“锘挎祴璇?之类的乱码。
其根源在于:标准 UTF-8 规范不建议添加字节顺序标记(BOM, Byte Order Mark)。但 Excel 在 Windows 上双击打开 CSV 时,若没有在文件开头检测到 0xEF, 0xBB, 0xBF 三个字节的 BOM 头,会默认退回到操作系统的本地 ANSI 编码(中文 Windows 下通常是 GBK)进行解码,从而发生乱码。
解决方案:如果导出的 CSV 明确需要供业务人员直接用 Excel 软件双击查阅,应在写入时将编码指定为 encoding='utf-8-sig'。Python 在写入时会自动在文件头部附带 BOM 标记,引导 Excel 自动识别为 UTF-8 编码。若该文件仅用于程序接口流转,则保持标准 encoding='utf-8' 即可。
3. reader/writer 与 DictReader/DictWriter 的选型边界
csv 模块还提供了基于字典操作的 DictReader 和 DictWriter。在技术选型时,开发者应当清晰了解其适用边界:
- 使用 reader / writer:数据按列的固定位置访问(如
row[0]、row[1])。对象开销最小、解析吞吐速度最快、内存占用最少。适合数据列稳定、没有复杂列重排需求,或追求高性能的大规模数据导入导出场景。 - 使用 DictReader / DictWriter:数据按表头名称映射为字典(如
row['price'])。当表格列数较多(例如数十列)、列的先后顺序不稳定、或者部分列可能缺失时,字典形式能显著提升代码的可读性与健壮性。
五、全篇总结
Python 标准库 csv 模块的 reader 与 writer 是处理 CSV 文件的基础工具。要写出稳健、规范的文件处理代码,核心要点可提炼为以下三条准则:
- 读取时建立迭代管道:始终使用
with open(..., 'r', encoding='utf-8')保护资源,借助csv.reader的状态机处理字段内逗号和转义,通过next()隔离表头,并主动完成必要的数据类型显式转换。 - 写入时严控换行参数:写入必须显式声明
newline='',从底层阻断 Windows 平台的重复换行转义,避免在数据行之间产生多余空行;单行写入使用writerow(列表),多行写入使用writerows(二维列表)。 - 兼顾编码与平台生态:根据下游使用场景精准指定编码,与程序对接优先使用标准
utf-8,面向 Excel 办公环境直接交互时选用utf-8-sig。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









