

Python爬虫实战案例:电商商品数据全字段抓取流程解析
深度解析基于Python的电商商品全字段采集技术方案,涵盖静态DOM解析、异步价格库存接口逆向、SKU规格矩阵对齐、反爬会话控制以及Pydantic结构化持久化落地的完整工程实践。
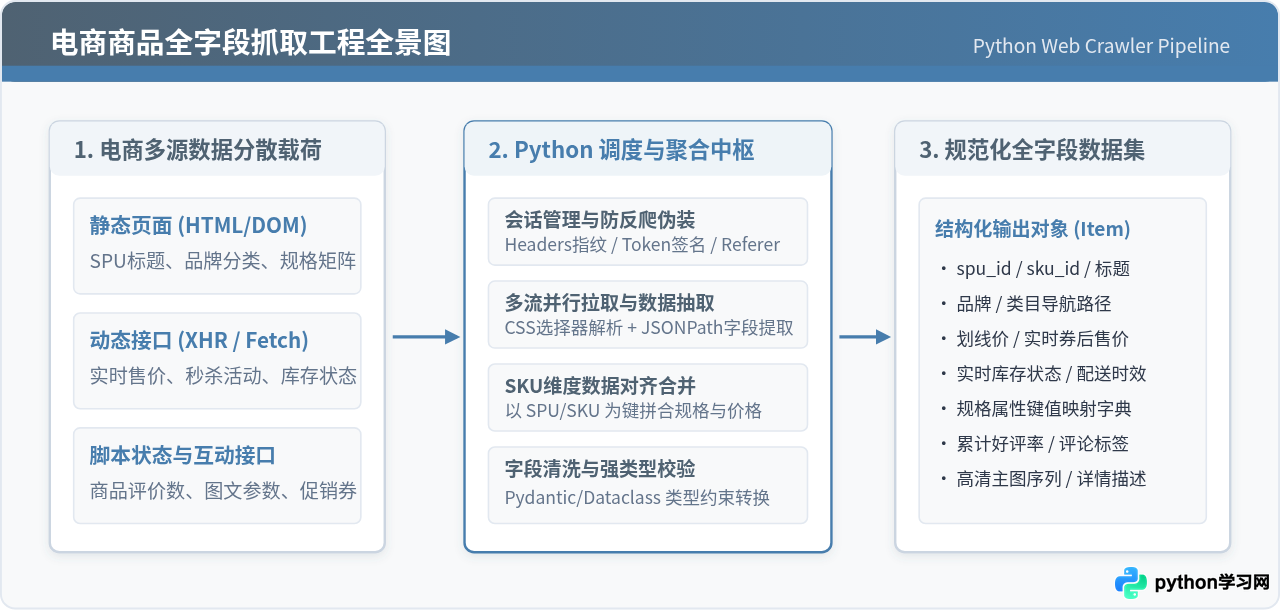
电商商品的全字段数据采集,绝非简单对单个商品详情页 URL 发起一次 GET 请求并解析 HTML。在主流电商平台架构中,商品数据呈现明显的“动静分离与多源分布”特征:商品标题、品牌和类目常驻于服务端直出 HTML 或静态脚本变量中,而实时价格、库存水位、满减券包和评价标签则由前端异步 XHR/Fetch 接口拉取。本文围绕“全字段”这一核心诉求,从数据源逆向拆解、异步接口参数补齐、SKU 规格矩阵与动态价格关联对齐,到 Pydantic 强类型清洗入库,给出一条稳定且可复用的标准化实施流程。
一、电商全字段矩阵拆解与数据源分布
进行爬虫开发前,首先需要理清电商平台“全字段”的具体边界。很多初学者容易将抓取目标局限在“标题、原价、主图”,但在实际商业分析、比价系统或选品研究中,缺少规格与实时库存的数据价值大打折扣。
商业级电商商品抓取所需的核心字段矩阵通常划分为四类维度:
- 基础元数据(SPU 层级):商品主标题、副标题卖点、品牌名称、所属多级类目路径、店铺名称、商家资质标识。
- 多规格销售单元(SKU 矩阵):SKU ID、规格组合映射(例如“颜色: 幻夜黑;版本: 16G+512G”)、各规格专属微缩预览图、商品货号。
- 实时交易状态(动态变动):划线参考价、实时促销售价、优惠券门槛与满减金额、分仓实时库存状态(现货、预售、无货)、配送履约时效。
- 用户反馈与详情图文:累计评价总数、好评率百分比、买家高频词标签、详情页富文本 CDN 图片列表、售后退换政策。
| 字段类别 | 代表性字段 | 典型数据载体 | 提取难点与技术手段 |
|---|---|---|---|
| 基础元数据 | 标题、品牌、多级类目、SPU ID | 初始页面 HTML DOM | 标签结构随改版变动,需维护 CSS/XPath 选择器 |
| 规格销售矩阵 | SKU 属性字典、对应主图 | 内嵌脚本 __INITIAL_STATE__ |
JSON 嵌套深、包含非标准 JS 变量,需正则精准截取 |
| 实时交易数据 | 活动价、优惠券、分仓库存 | 动态 XHR / Fetch JSON 接口 | 请求携带时间戳、会话 Cookie 及反爬签名 Token |
| 评价与交互 | 好评率、评价数、买家标签 | 专用评论分流 JSON API | 严格校验 Referer 防盗链,分页存在速率限制 |
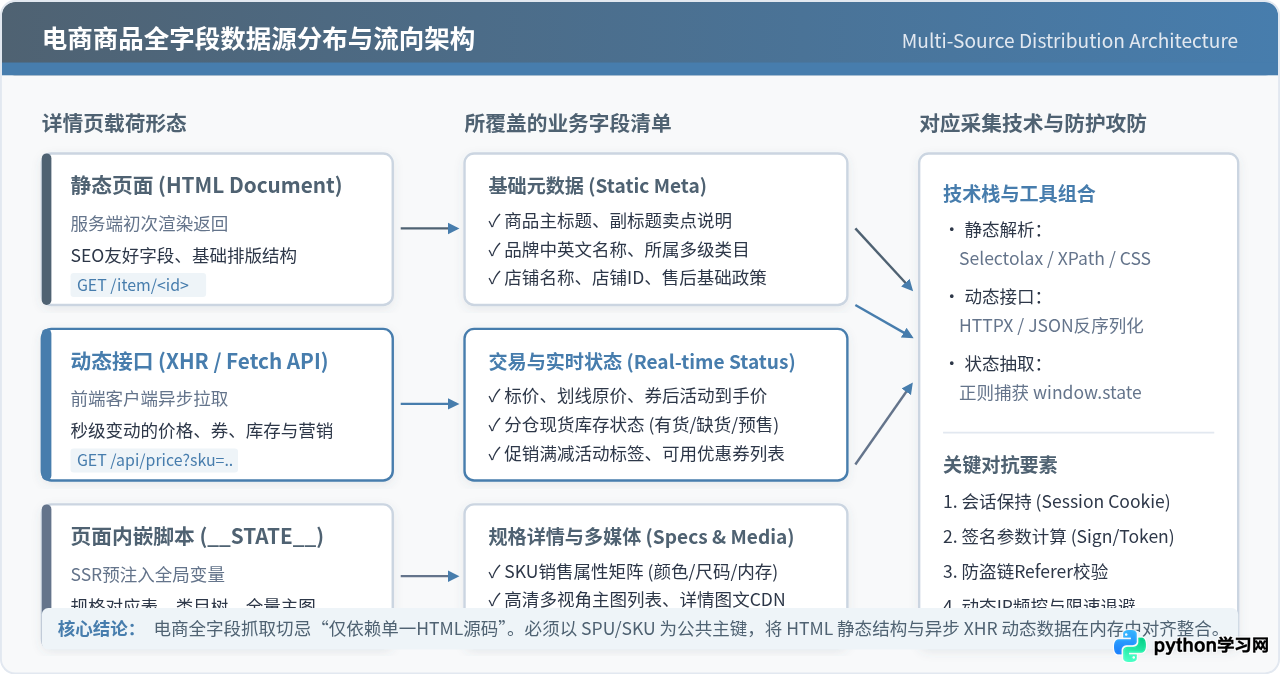
如上图所示,一个完整的商品详情页实际上是由多个独立的数据流在浏览器端拼装而成的。这意味着我们的 Python 爬虫程序也必须扮演“组装者”的角色:先通过主文档获取商品全局属性和所有可销售的 SKU 列表,再利用获得的标识符并发或有序请求价格与库存接口,最后在内存中按照业务关系缝合字段。
二、全字段逆向定位与会话构建
定位字段数据源的抓包顺序是逆向工作的关键。打开浏览器开发者工具(F12),切换到 Network 标签页,并勾选 Preserve log(保留日志):
- 在筛选框输入页面中展示的具体价格数字(如
4999.00),定位承载价格的 JSON 接口。如果价格以分或整数字符串存储(如499900),则尝试搜索 SKU ID。 - 观察该接口的请求类型。若为
XHR/Fetch,检查其 Request URL、Query 参数及 Headers。特别注意Referer、cookie以及是否存在由前端算法生成的签名参数(形如_token、sign或t)。 - 检查初始 HTML 源码中是否包含
<script>标签存储的全局变量。许多基于 Vue 或 React SSR 服务端渲染的电商站会将全量 SKU 矩阵放在window.__INITIAL_DATA__中,直接用正则提取该 JSON 往往比多次请求接口更加高效稳定。
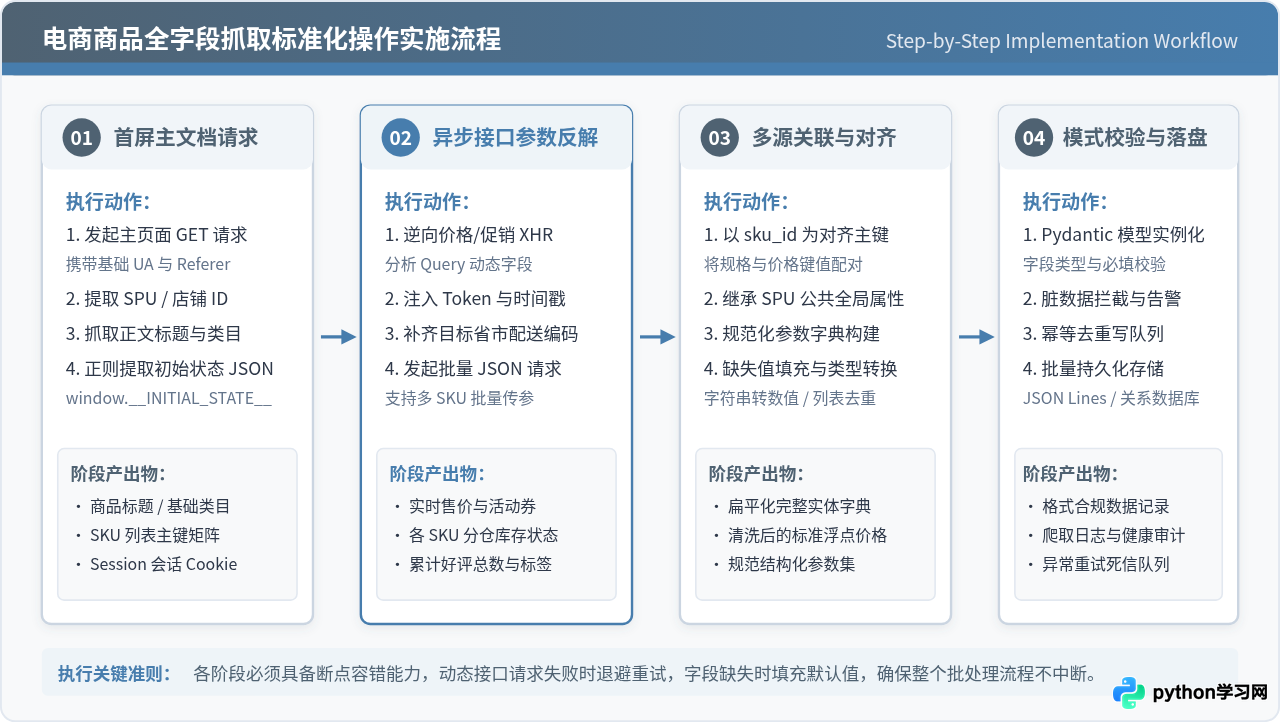
在 Python 代码层面,必须使用 requests.Session 或 httpx.Client 维护持久化的网络会话。这样做有两个决定性优势:第一,自动保持在请求主页面时服务器颁发的会话 Cookie(包含追踪 Token 或区域定位 Cookie);第二,复用底层 TCP/TLS 连接池,显著降低高频发起子接口请求时的网络握手延迟。
三、核心实现:多源字段聚合与代码落地
下面是一个工业化结构的 Python 电商全字段采集实现。代码使用 requests 建立会话,使用 BeautifulSoup 提取首屏静态数据,通过正则表达式截取规格矩阵,再调用动态价格与库存接口完成字段关联:
import re
import json
import time
import logging
from typing import Dict, List, Optional
from dataclasses import dataclass, asdict
import requests
from bs4 import BeautifulSoup

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

@dataclass
class SkuProductItem:
    # 电商单条标准 SKU 商品全字段数据模型
    spu_id: str
    sku_id: str
    title: str
    brand: str
    category_path: str
    spec_attributes: Dict[str, str]
    original_price: float
    sale_price: float
    stock_status: str
    is_in_stock: bool
    coupon_tags: List[str]
    review_count: int
    good_rate_pct: float
    image_url: str
    fetch_timestamp: int

class EcommerceFullFieldScraper:
    def __init__(self, timeout: int = 10):
        self.session = requests.Session()
        self.timeout = timeout
        # 构造真实浏览器请求头指纹
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
            "Connection": "keep-alive"
        })

    def fetch_page_context(self, spu_id: str) -> Optional[dict]:
        """第一步:请求主文档并提取 SPU 基础信息与内嵌 SKU 矩阵"""
        url = f"https://item.example-mall.com/{spu_id}.html"
        try:
            resp = self.session.get(url, timeout=self.timeout)
            if resp.status_code != 200:
                logging.error(f"主页面请求异常,状态码: {resp.status_code},SPU: {spu_id}")
                return None

            html = resp.text
            soup = BeautifulSoup(html, "html.parser")

            # 1. 静态 DOM 解析基础字段
            title_node = soup.select_one(".product-title, h1.title, .item-name")
            title = title_node.get_text(strip=True) if title_node else "未知商品"

            brand_node = soup.select_one("#parameter-brand li, .brand-name")
            brand = brand_node.get_text(strip=True).replace("品牌:", "") if brand_node else "通用品牌"

            crumbs = [node.get_text(strip=True) for node in soup.select(".breadcrumb a, .crumbs-item a")]
            category_path = " > ".join(crumbs) if crumbs else "未分类"

            # 2. 正则提取内嵌状态中的 SKU 规格配置
            sku_map = {}
            state_match = re.search(r"window\.__INITIAL_STATE__\s*=\s*({.+?});\s*</script>", html)
            if state_match:
                try:
                    state_data = json.loads(state_match.group(1))
                    sku_list = state_data.get("skuList", [])
                    for item in sku_list:
                        s_id = str(item.get("skuId"))
                        sku_map[s_id] = {
                            "spec": item.get("specs", {}),
                            "image": item.get("mainPic", "")
                        }
                except json.JSONDecodeError as err:
                    logging.warning(f"状态 JSON 反序列化失败: {err}")

            # 若内嵌状态提取为空,则通过 DOM 节点兜底
            if not sku_map:
                for opt in soup.select(".sku-selector .item"):
                    s_id = opt.get("data-sku")
                    if s_id:
                        sku_map[str(s_id)] = {
                            "spec": {"规格": opt.get_text(strip=True)},
                            "image": opt.get("data-img", "")
                        }

            return {
                "spu_id": spu_id,
                "title": title,
                "brand": brand,
                "category_path": category_path,
                "sku_map": sku_map
            }
        except requests.RequestException as e:
            logging.error(f"网络异常中断: {e}")
            return None

    def fetch_dynamic_pricing_and_stock(self, spu_id: str, sku_ids: List[str]) -> Dict[str, dict]:
        """第二步:批量请求动态定价与库存 API 接口"""
        if not sku_ids:
            return {}

        api_url = "https://api.example-mall.com/v2/item/batch_status"
        params = {
            "spuId": spu_id,
            "skuIds": ",".join(sku_ids),
            "_t": int(time.time() * 1000)
        }
        headers = {
            "Referer": f"https://item.example-mall.com/{spu_id}.html",
            "Accept": "application/json"
        }

        try:
            resp = self.session.get(api_url, params=params, headers=headers, timeout=self.timeout)
            if resp.status_code == 200:
                data = resp.json()
                # 规范化转换为以 sku_id 为索引的映射字典
                results = {}
                for item in data.get("data", []):
                    s_id = str(item.get("skuId"))
                    results[s_id] = {
                        "original_price": float(item.get("originPrice", 0.0)),
                        "sale_price": float(item.get("actPrice", item.get("price", 0.0))),
                        "stock_status": item.get("stockDesc", "未知"),
                        "is_in_stock": bool(item.get("stockCount", 0) > 0),
                        "coupons": item.get("couponList", [])
                    }
                return results
            logging.warning(f"动态接口响应异常: HTTP {resp.status_code}")
            return {}
        except Exception as e:
            logging.error(f"动态价格接口拉取失败: {e}")
            return {}

    def fetch_review_summary(self, spu_id: str) -> dict:
        """获取商品评价总揽与好评率"""
        review_url = "https://club.example-mall.com/comment/summary"
        try:
            resp = self.session.get(review_url, params={"spuId": spu_id}, timeout=self.timeout)
            if resp.status_code == 200:
                data = resp.json().get("summary", {})
                return {
                    "count": int(data.get("commentCount", 0)),
                    "good_rate": float(data.get("goodRate", 100.0))
                }
        except Exception:
            pass
        return {"count": 0, "good_rate": 100.0}

    def scrape_full_product(self, spu_id: str) -> List[SkuProductItem]:
        """第三步:主调度管线,执行多源对齐并输出标准全字段实体"""
        context = self.fetch_page_context(spu_id)
        if not context:
            return []

        sku_map = context["sku_map"]
        sku_ids = list(sku_map.keys())

        # 获取动态状态及评价信息
        pricing_data = self.fetch_dynamic_pricing_and_stock(spu_id, sku_ids)
        review_data = self.fetch_review_summary(spu_id)

        # 内存对齐:以 SKU 为最小颗粒度组装数据
        result_items: List[SkuProductItem] = []
        now = int(time.time())

        for sku_id, static_spec in sku_map.items():
            dynamic_status = pricing_data.get(sku_id, {})

            # 字段容错与类型安全处理
            item = SkuProductItem(
                spu_id=context["spu_id"],
                sku_id=sku_id,
                title=context["title"],
                brand=context["brand"],
                category_path=context["category_path"],
                spec_attributes=static_spec.get("spec", {}),
                original_price=dynamic_status.get("original_price", 0.0),
                sale_price=dynamic_status.get("sale_price", 0.0),
                stock_status=dynamic_status.get("stock_status", "待确认"),
                is_in_stock=dynamic_status.get("is_in_stock", False),
                coupon_tags=dynamic_status.get("coupons", []),
                review_count=review_data["count"],
                good_rate_pct=review_data["good_rate"],
                image_url=static_spec.get("image", ""),
                fetch_timestamp=now
            )
            result_items.append(item)

        logging.info(f"SPU: {spu_id} 全字段抓取完成,成功对齐 {len(result_items)} 个 SKU 规格记录。")
        return result_items
四、SKU规格矩阵与动态价格对齐机制
在电商数据爬取中,最容易产生逻辑错误的就是“价格与规格错位”。许多商品不同颜色或存储容量的价格并不相同(例如 256GB 与 512GB 差价数百元)。如果仅在页面上截取单个展示价格,就会导致抓取的商品记录出现“标题是高配、价格却是标配低配”的严重数据失真。
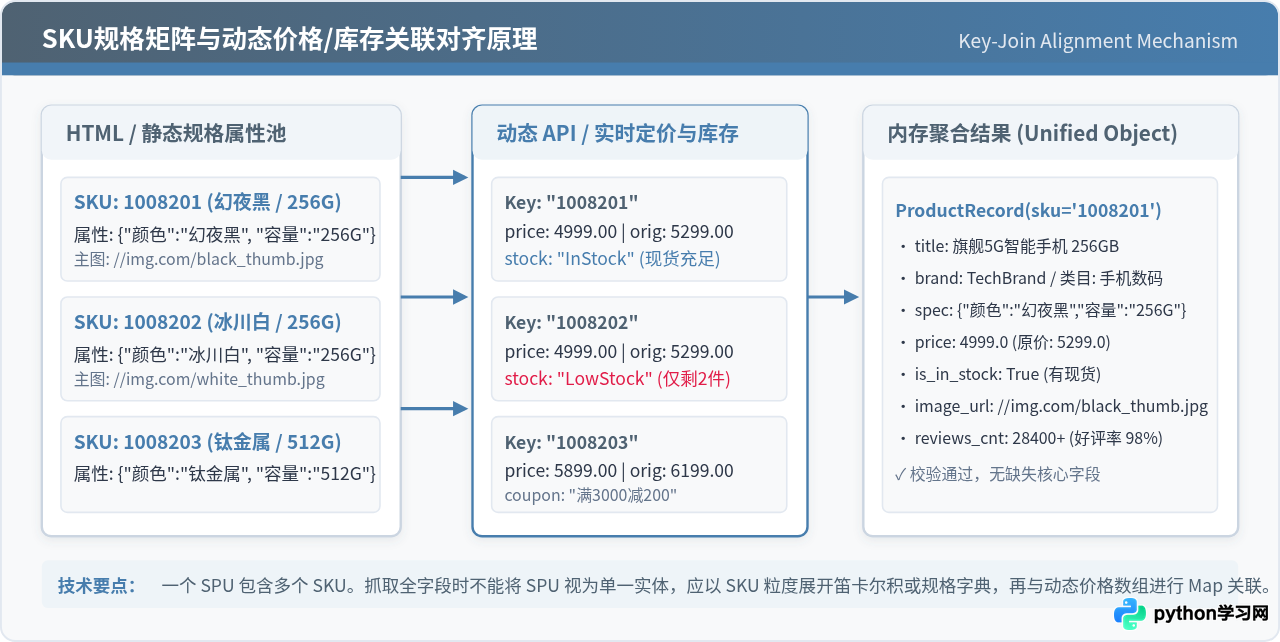
解决这一问题的唯一可靠方案就是 Key-Join 对齐机制:
- 建立 SKU 主键索引:解析页面静态脚本变量时,必须提取出平台赋予每个规格维度的唯一 SKU ID(通常为 7~12 位数字)。
- 批量或定向查询 API:将 SKU ID 列表作为入参传入动态价格接口。现代电商平台均支持以逗号分隔批量获取多个 SKU 的状态,减少 HTTP 往返开销。
- 字典哈希匹配:在内存中以
sku_id作为哈希表的主键,将静态的规格参数字典{"颜色": "幻夜黑", "容量": "256G"}与动态价格对象{"sale_price": 4999.0, "stock": True}进行一对一合流。
五、反爬防护对抗与稳定性工程保障
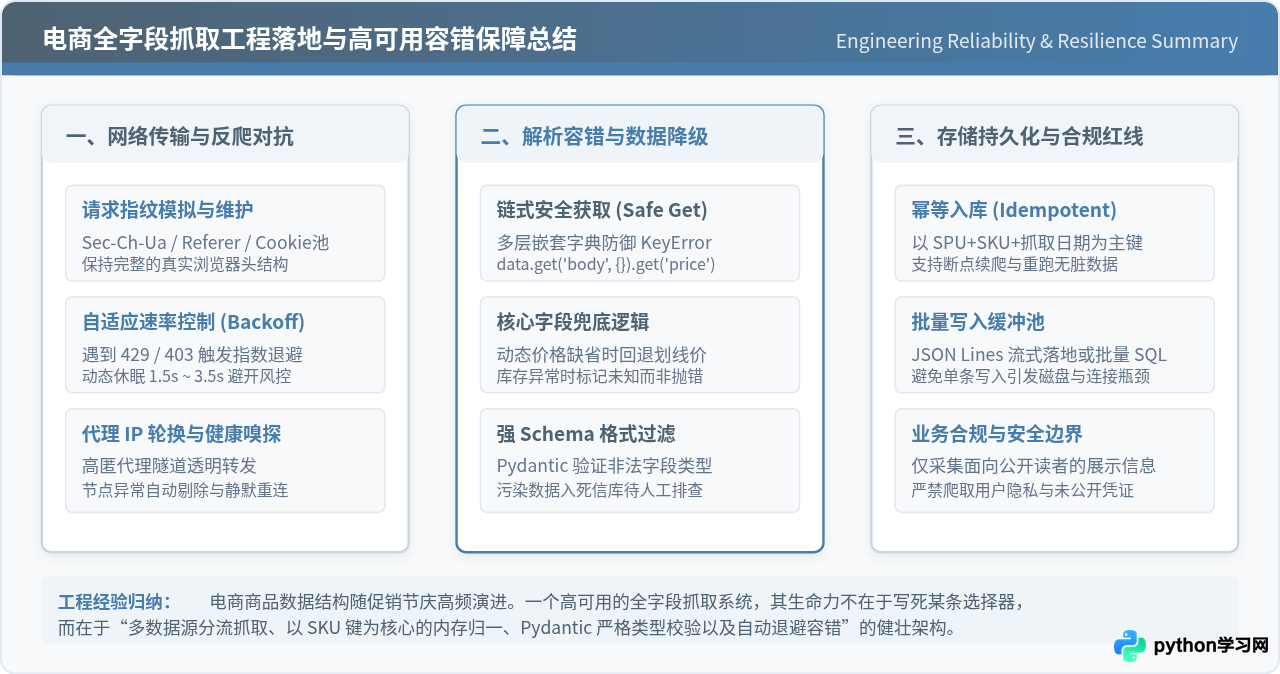
全字段抓取由于涉及同一个商品下的多次 HTTP 请求,天然比单纯抓取 HTML 更容易触发目标站点的风控防线。以下是保障生产环境连续抓取的核心对抗策略:
403 Forbidden 或 {"code": -101, "msg": "Invalid Token"})。
-
请求头完整度与 TLS 指纹:
仅配置
User-Agent已经无法通过现代化 WAF(Web Application Firewall)。必须补齐Accept-Encoding、Sec-Ch-Ua系列头,并且在请求子接口时务必将Referer设置为主详情页的完整 URL。 -
自适应指数退避(Exponential Backoff):
抓取高频电商数据时,不要使用固定间隔的
time.sleep()。建议引入随机抖动,当捕获到 HTTP429 Too Many Requests或代理连接超时时,触发退避倍增重试,避免被全段封禁 IP。 -
字段防御性提取(Defensive Parsing):
电商接口经常伴随大促活动改版,字段命名可能会临时调整。在取值时切忌使用深层裸索引
resp['data']['product']['price'],而应使用链式.get()并提供缺省类型默认值(如0.0或[])。
六、全流程规范化落地与数据持久化
数据抓取完成后,下一步是标准化持久化。对于包含丰富嵌套结构(如规格属性字典、促销列表、主图序列)的电商全字段数据,推荐使用 JSON Lines(.jsonl) 进行流式暂存,或直接入库至支持 JSON 列类型的关系型数据库(如 PostgreSQL / MySQL 8.0+)。
持久化时必须保证入库操作的幂等性(Idempotence):以 spu_id + sku_id + 抓取日期 作为唯一复合索引。当某次任务因网络中断重新执行时,通过 ON CONFLICT DO UPDATE 或覆盖写入避免在数据库中产生大量重复垃圾记录。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









