

Python读取Excel选哪个库?pandas、openpyxl与xlrd对比
全面对比Python读取Excel的三大主流库pandas、openpyxl与xlrd:格式支持差异、代码示例、性能与内存表现,以及清晰的选型决策树和避坑指南。
.xlsx 文件,首选 openpyxl;如果需要读取历史遗留的 .xls(Excel 97-2003 二进制格式)文件,则使用 xlrd(需注意 xlrd 2.0+ 已彻底移除对 .xlsx 的支持)。
一、底层定位与格式支持差异
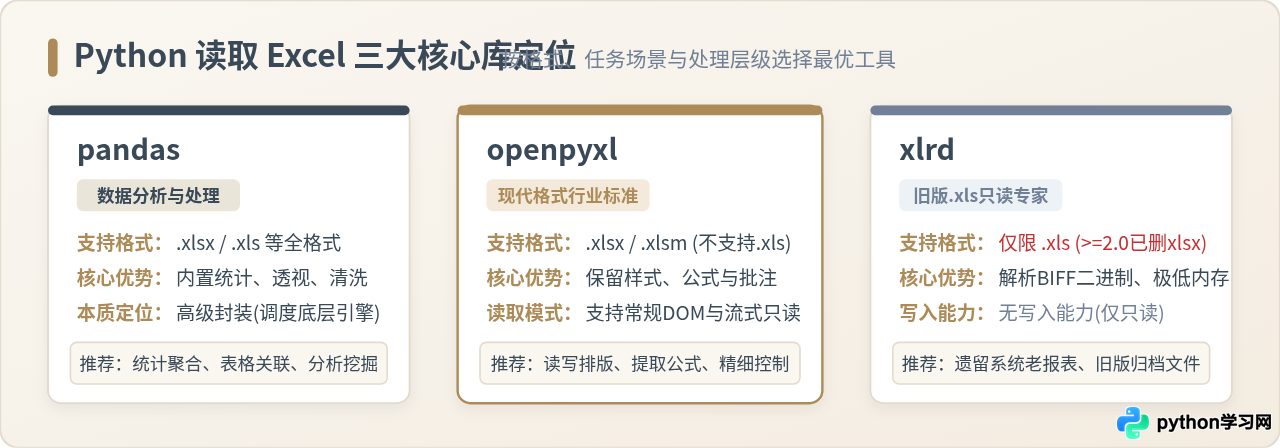
在探讨如何选择之前,必须先理清 Excel 常见文件格式的物理本质。平时接触的 Excel 文件主要有两类:一种是拓展名为 .xlsx 的现代工作簿,另一种是老旧的 .xls 格式。这两者在底层存储架构上存在根本差异:
- .xlsx 格式(Excel 2007 至今):本质是一个基于 OpenXML 标准的 ZIP 压缩包,内部包含多个记录工作表、单元格、样式和关系的 XML 文本文件。
- .xls 格式(Excel 97-2003):是微软早期的专有二进制文件格式,遵循 BIFF8(Binary Interchange File Format)规范。
正因为物理结构的根本不同,Python 社区针对不同格式和需求分化出了不同的库:
1. xlrd:专注于旧版 .xls 的轻量读取器
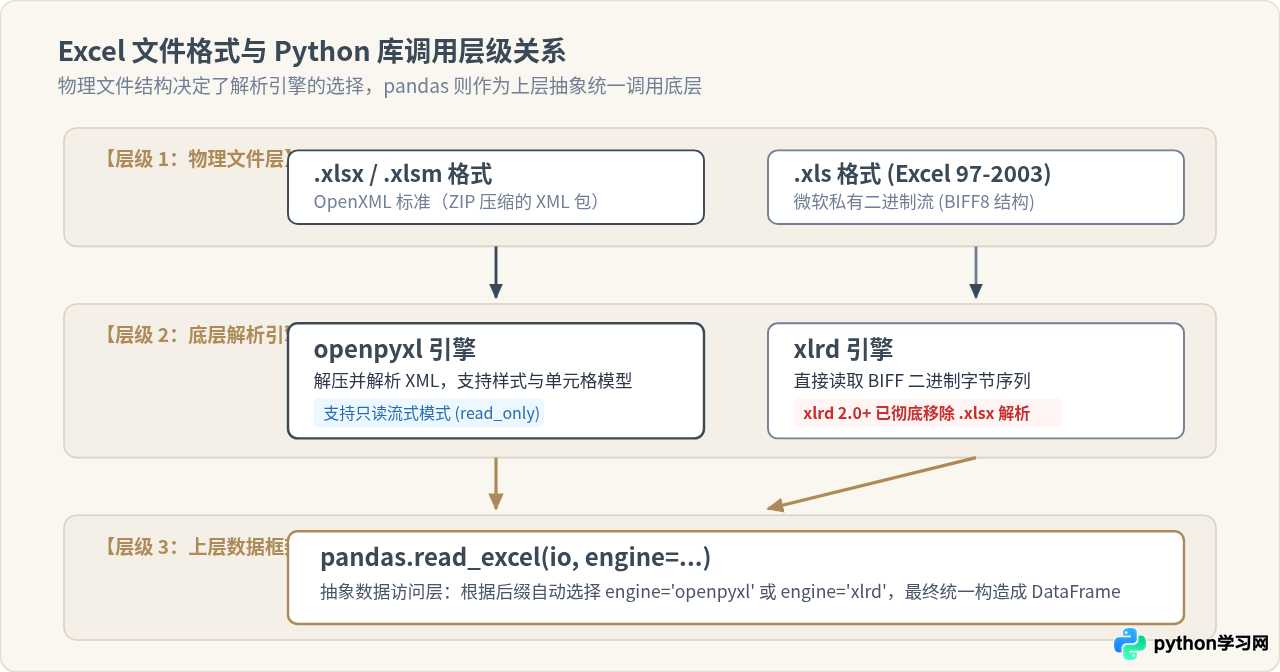
xlrd 是 Python 早期处理 Excel 最成熟的工具之一。它的优势在于解析底层 BIFF 二进制字节流非常迅速,且内存开销极小。但需要特别注意的是它的版本分水岭:
.xlsx 格式的支持。如果在现代 Python 环境中使用最新版 xlrd 打开 .xlsx 文件,会直接抛出 xlrd.biffh.XLRDError: Excel xlsx file; not supported 错误。因此,xlrd 目前仅且专门用于读取 .xls 格式。
2. openpyxl:现代 .xlsx 格式的事实标准
openpyxl 是目前 Python 生态中处理 .xlsx 和 .xlsm 最主流的纯 Python 库。它完整实现了 OpenXML 规范,不仅能读取表格里的纯文本和数值,还能完整读取单元格背景色、字体边框、数字格式(例如货币或日期)、公式原文以及图表元数据。同时,openpyxl 具备完整的读写能力,既可以读取也能在原表基础上修改并回存。
3. pandas:面向数据分析与处理的高级抽象
pandas 并不是一个底层的 Excel 解析器。当调用 pandas.read_excel() 时,pandas 实际上是在上层充当“指挥调度”的角色:它会根据文件后缀或显式指定的 engine 参数,去调用底层的解析引擎(默认对 .xlsx 调用 openpyxl,对 .xls 调用 xlrd)。读取完成后,pandas 将离散的单元格组织成高度结构化的 DataFrame,便于后续执行求和、筛选、透视和关联等操作。
二、读取代码示例与执行流程对比
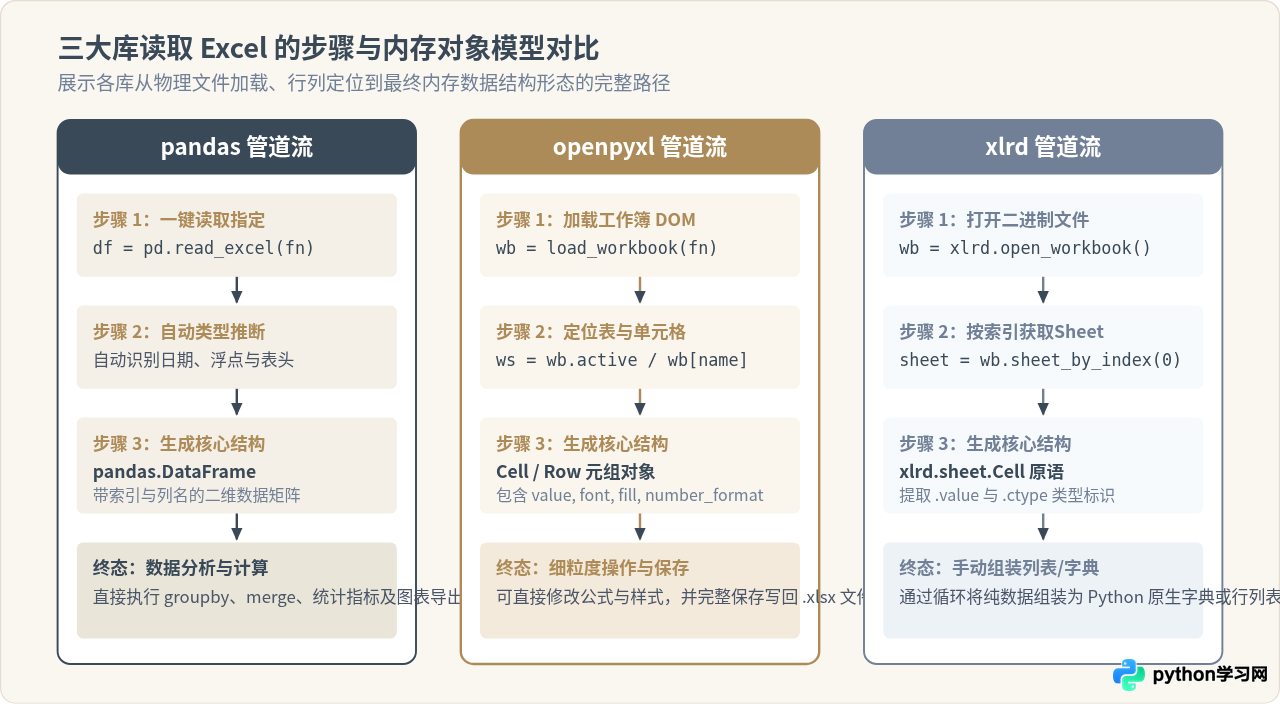
为了直观感受三个库在实际代码中的交互习惯与结果形态,下面分别演示读取同一个示例文件的具体实现。
1. 使用 openpyxl 读取 .xlsx 文件
openpyxl 面向的是工作簿(Workbook)、工作表(Worksheet)和单元格(Cell)的树状对象模型。如果需要遍历读取数据,通常使用 iter_rows() 方法:
from openpyxl import load_workbook

# 加载工作簿
wb = load_workbook(filename="sales_data.xlsx", data_only=True)
ws = wb.active  # 获取当前活跃的工作表

# 逐行读取单元格纯值 (values_only=True 直接返回数值而非 Cell 对象)
data_rows = []
for row in ws.iter_rows(values_only=True):
    data_rows.append(row)

print(f"读取到的表头: {data_rows[0]}")
print(f"数据总行数: {len(data_rows) - 1}")
数据总行数: 120
参数说明: data_only=True 表示遇到公式单元格时读取公式计算后的缓存值,若为 False 则读取公式字符串(如 =SUM(C2:C10))。
2. 使用 pandas 读取表格为 DataFrame
如果不需要单元格颜色和边框,只希望快速把表格转为数据分析格式,pandas 只需一行代码:
import pandas as pd

# 一键将 Excel 表格读入 DataFrame
df = pd.read_excel(
    io="sales_data.xlsx",
    sheet_name="Sheet1",
    engine="openpyxl"  # 明确指定底层解析引擎
)

# 直接查看数据前3行与基本统计
print(df.head(3))
print(f"平均单价: {df['单价'].mean():.2f}")
0 ORD1001 机械键盘 299.0 2 2026-03-01
1 ORD1002 无线鼠标 89.0 5 2026-03-01
2 ORD1003 显示器支架 159.0 1 2026-03-02
平均单价: 182.33
3. 使用 xlrd 读取历史 .xls 文件
对于老旧系统导出的 .xls 文件,xlrd 是最稳定高效的工具:
import xlrd

# 打开旧版二进制文件
book = xlrd.open_workbook("legacy_report.xls")
sheet = book.sheet_by_index(0)  # 按索引选取工作表

print(f"表格总行数: {sheet.nrows}, 总列数: {sheet.ncols}")
# 获取第0行(表头)
headers = [sheet.cell_value(0, col) for col in range(sheet.ncols)]
print(f"表头列名: {headers}")
表头列名: ['部门编号', '员工姓名', '入职日期', '基本薪资', '绩效评分', '所属城市']
三、核心特性与性能深度对比
面对具体业务时,往往还要综合衡量内存开销、数据处理能力以及格式保留能力。下表和图表总结了关键维度的横向评测结果:
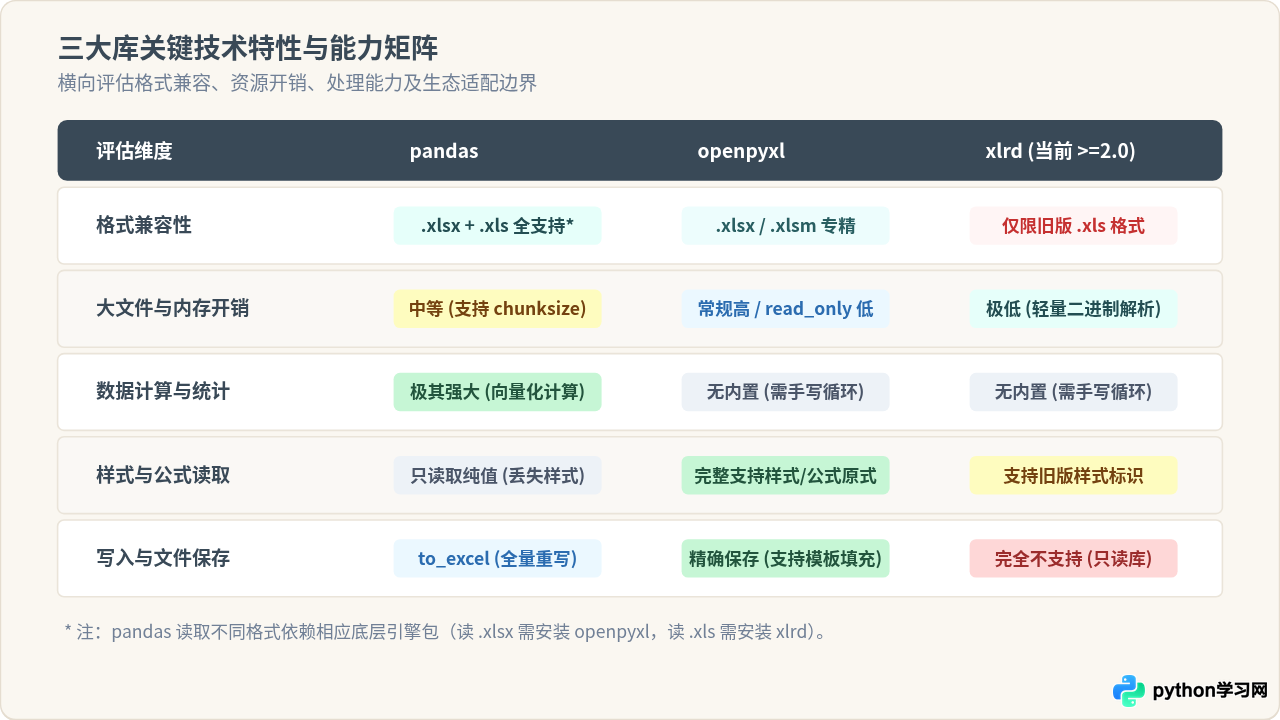
| 对比维度 | pandas | openpyxl | xlrd (>=2.0) |
|---|---|---|---|
| 支持的文件格式 | .xlsx, .xls 等(视底层引擎而定) | .xlsx, .xlsm, .xltx | 仅限 .xls (Excel 97-2003) |
| 内存占用机制 | 取决于 DataFrame 尺寸,支持分块读入 | 默认 DOM 模式内存较高;提供流式 read_only |
极低,直接流式解析 BIFF8 结构 |
| 单元格样式保留 | 完全丢弃样式,仅提取纯数值 | 完整读取/写入字体、填充色、边框等 | 仅支持提取旧版简单字体/格式代码 |
| 公式处理能力 | 仅读取公式计算后的缓存值 | 既可读取公式原文本,也可读缓存值 | 仅读取计算值或公式标识符 |
| 数据清洗与统计 | 极强(内置数百种分组、透视与矩阵算法) | 无内置计算功能,需自行组织循环 | 无内置计算功能,需自行组织循环 |
| 写回与修改支持 | 全量覆盖写入 (to_excel) | 支持局部修改单元格并精确回存 | 不支持写入(纯只读工具) |
关于内存开销的关键细节
很多人在读取数十兆甚至上百兆的 .xlsx 文件时会遭遇内存飙升。这是因为 .xlsx 本身经过了 ZIP 高度压缩,解压后其内部的 XML 体积通常会膨胀 5 至 10 倍。如果使用 openpyxl 的普通模式(load_workbook()),库会为每个单元格在内存中实例化一个包含样式、位置、属性的完整 Python 对象,导致内存暴涨数百兆甚至数吉字节。
load_workbook(filename, read_only=True)。该模式基于迭代生成器逐步解析 XML,只在遍历当前行时载入单元格,能将内存占用压缩至几兆以内。
四、选型决策指南与避坑排查
在了解了三者的特性后,可以通过以下决策路径快速确定最适合当前项目的库:
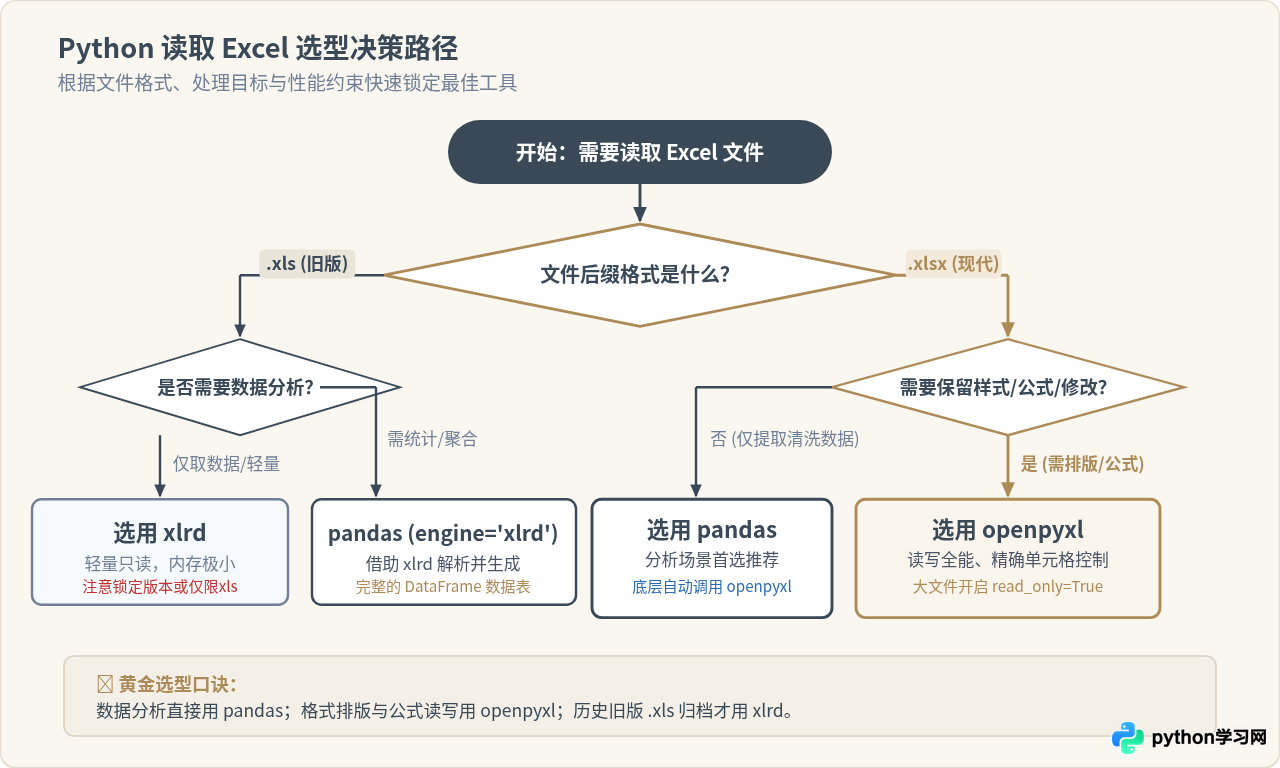
常见典型应用场景对照
- 场景 1:运营报表批量合并与指标计算。
手头有数十个分支机构上报的销售表格,需要提取其中的数值列并按地区汇总。明确选 pandas。借助
pd.concat和groupby可以在几行代码内搞定,无需繁琐的双层循环。 - 场景 2:模板化报表处理与样式生成。
需要在现有的 Excel 模板中填充指定数据,并为异常值标注红色背景,同时保留其他表格中的柱状图。明确选 openpyxl。pandas 会重写整个工作簿并洗掉所有格式,而 openpyxl 能够精准修改目标坐标的单元格。
- 场景 3:维护十年前遗留系统的备份数据。
从老旧 ERP 或银行接口下载的历史文件均为
.xls格式。明确选 xlrd,或者使用pandas.read_excel('file.xls', engine='xlrd')。
开发中常见的报错排查
在实际开发过程中,以下两类报错出现频率最高:
-
报错信息:
ImportError: Missing optional dependency 'openpyxl'. Use pip or conda to install openpyxl.
发生原因:在调用pd.read_excel('data.xlsx')时,虽然安装了 pandas,但当前虚拟环境中缺少默认的底层解析引擎。
解决方法:执行pip install openpyxl补齐依赖即可。 -
报错信息:
xlrd.biffh.XLRDError: Excel xlsx file; not supported
发生原因:代码中试图用 xlrd 打开.xlsx文件,或者在使用 pandas 读取.xlsx时误写了engine='xlrd'。
解决方法:对于.xlsx文件,将 engine 参数替换为engine='openpyxl'。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









