

Python语言特点的优缺点辩证:GIL限制与开发效率权衡
深入辩证分析Python语言特性:从CPython全局解释器锁(GIL)的历史成因与运作机制出发,剖析开发效率与执行性能的取舍关系,并提供多进程、异步IO与底层扩展等落地方案。
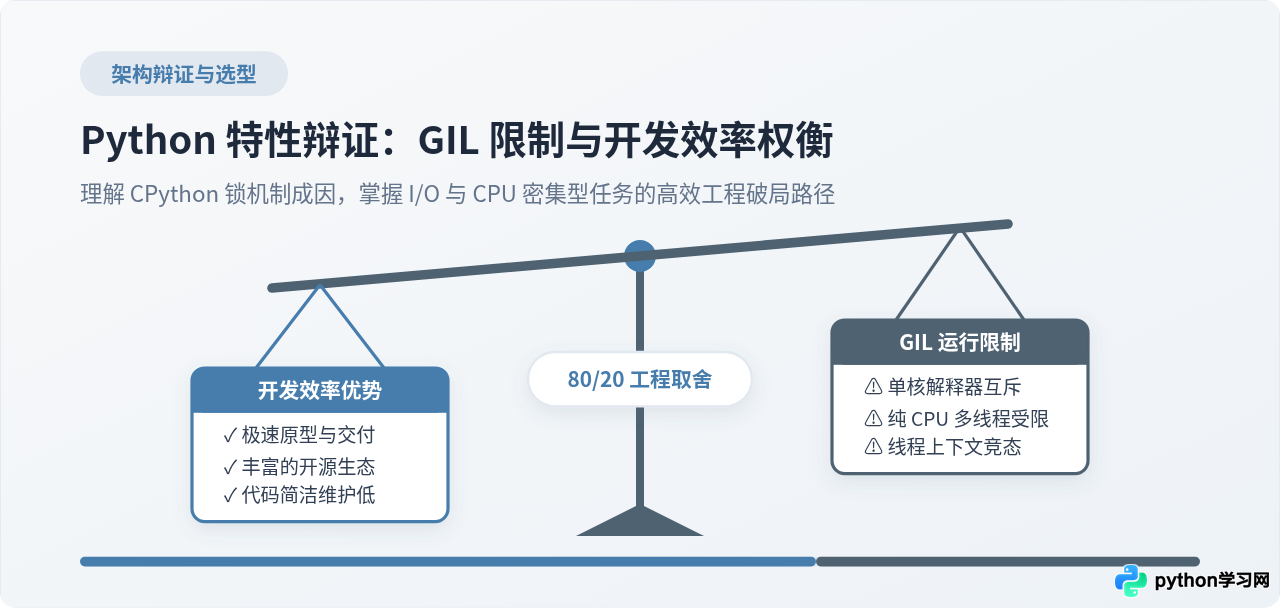
为什么极高的开发效率与 GIL 机制彼此共生
在评估 Python 的语言特性时,很多初学者常常将全局解释器锁(GIL)视为一种历史包袱。但从语言工程设计的演进视角来看,GIL 恰恰是 CPython 能够催生出今天繁荣生态的关键基石之一。
CPython 的内存管理基于对象引用计数(Reference Counting)与分代垃圾回收。如果没有全局锁,解释器为了维护多线程环境下每一个对象引用计数的线程安全,就必须为每个内存对象或内存分配器单独引入细粒度的互斥锁(Fine-grained Locks)。在单线程场景下,频繁获取和释放大量细粒度锁会造成极其严重的 CPU 开销,使原本就不以绝对执行速度见长的动态脚本进一步放缓。早期 CPython 引入 GIL,用一把全局大锁一次性接管解释器状态,不仅极大简化了内存管理逻辑,而且保证了单线程执行路径几乎零锁损耗。
更深远的影响在于 C/C++ 扩展接口。上世纪 90 年代初,Python 依靠对底层 C 库无与伦比的“胶水包装”能力迅速壮大。因为有了 GIL 的存在,第三方 C 扩展开发者在编写扩展模块时,无须为复杂的跨线程并发内存冲突处理耗费大量精力,这直接催生了 NumPy、SciPy 等一大批世界级科学计算库的诞生。可以说,正是这把锁降低了生态贡献的门槛,奠定了今天 Python 在数据科学、机器学习和人工智能领域的霸主地位。
场景辨析:I/O 密集型与 CPU 密集型的性能分水岭
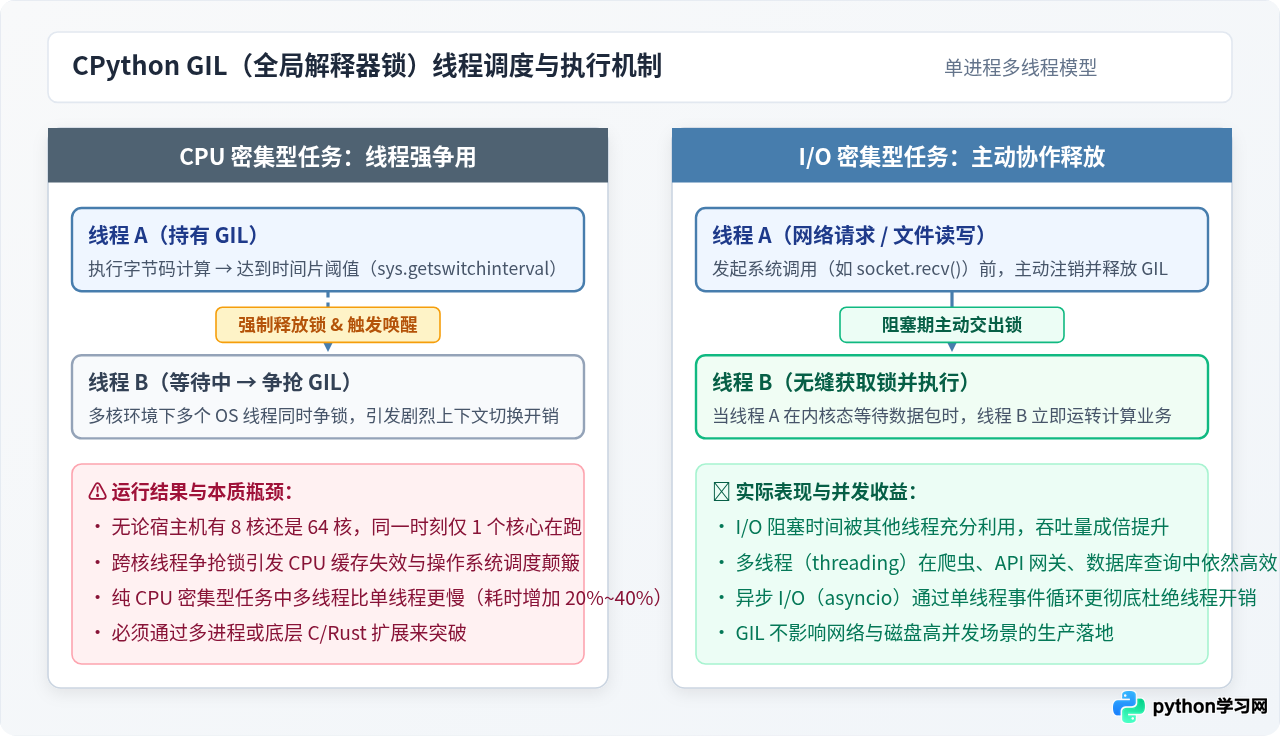
评估 GIL 的实际影响,必须把业务场景严格区分为 I/O 密集型(I/O-Bound) 与 CPU 密集型(CPU-Bound)。很多对 Python 性能的误解,根源在于脱离了具体的任务属性去泛泛谈论“Python 不支持多线程并发”。
在 Web 服务、API 请求网关、爬虫抓取以及数据库访问等典型 I/O 密集型业务中,程序大部分时间处于等待网络数据包返回或磁盘寻道的状态。CPython 在底层执行阻塞型系统调用(如网络套接字 socket.recv 或文件读写)之前,会主动调用 Py_BEGIN_ALLOW_THREADS 释放 GIL;当系统调用返回前再通过 Py_END_ALLOW_THREADS 重新获取 GIL。因此,在等待 I/O 的漫长微秒级或毫秒级窗口内,其他 Python 线程完全可以接管解释器继续运行。多线程对于 I/O 场景仍然具有立竿见影的并发提速效果。
但在执行纯数学矩阵运算、加密哈希、图像像素重采样等 CPU 密集型任务时,线程始终在执行纯粹的 Python 字节码。CPython 解释器通过周期检查机制(默认为 sys.getswitchinterval() 指定的 5 毫秒)强制持有锁的线程让出 GIL。在多核现代 CPU 上,这会导致多个操作系统原生线程在不同 CPU 核心之间频繁被唤醒、争夺锁并再度挂起,产生大量的操作系统上下文切换与 CPU 缓存行失效开销。
# 示例:CPU 密集型任务中多线程与单进程/多进程的对比基准
import time
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

def heavy_calculation(n):
    total = 0
    for i in range(n):
        total += i * i
    return total

if __name__ == '__main__':
    NUM_TASKS = 4
    N = 10_000_000

    # 1. 串行单线程执行
    t0 = time.perf_counter()
    for _ in range(NUM_TASKS):
        heavy_calculation(N)
    print(f"单线程串行耗时: {time.perf_counter() - t0:.2f} 秒")

    # 2. 多线程执行(受 GIL 约束与上下文竞争影响)
    t1 = time.perf_counter()
    with ThreadPoolExecutor(max_workers=NUM_TASKS) as executor:
        list(executor.map(heavy_calculation, [N] * NUM_TASKS))
    print(f"多线程并发耗时: {time.perf_counter() - t1:.2f} 秒(受 GIL 限制)")

    # 3. 多进程执行(独立进程避开 GIL,跨多核真正并行)
    t2 = time.perf_counter()
    with ProcessPoolExecutor(max_workers=NUM_TASKS) as executor:
        list(executor.map(heavy_calculation, [N] * NUM_TASKS))
    print(f"多进程并行耗时: {time.perf_counter() - t2:.2f} 秒(跑满多核)")
在常规 4 核或 8 核机器上运行上述代码,你会清晰地观察到:多线程耗时通常略长于单线程,而多进程模式则能够接近线性地跑满 4 个核心,耗时缩短到原来的四分之一左右。
工程破局:绕开与化解 GIL 限制的主流解法
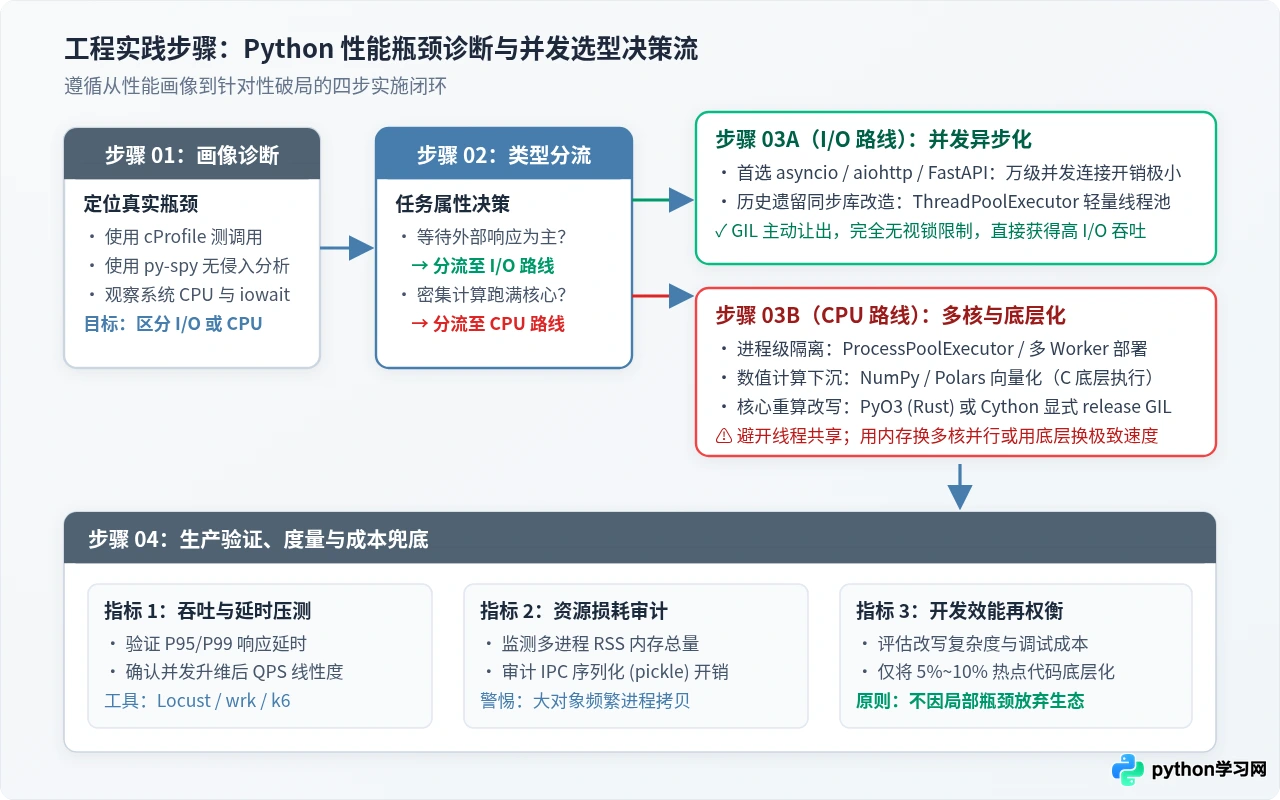
既然明确了瓶颈出现的条件,现代 Python 工程在处理并发和性能问题时,已经形成了一套成熟的工具链和架构方案,能够将 Python 的开发敏捷性与多核计算能力有机结合。
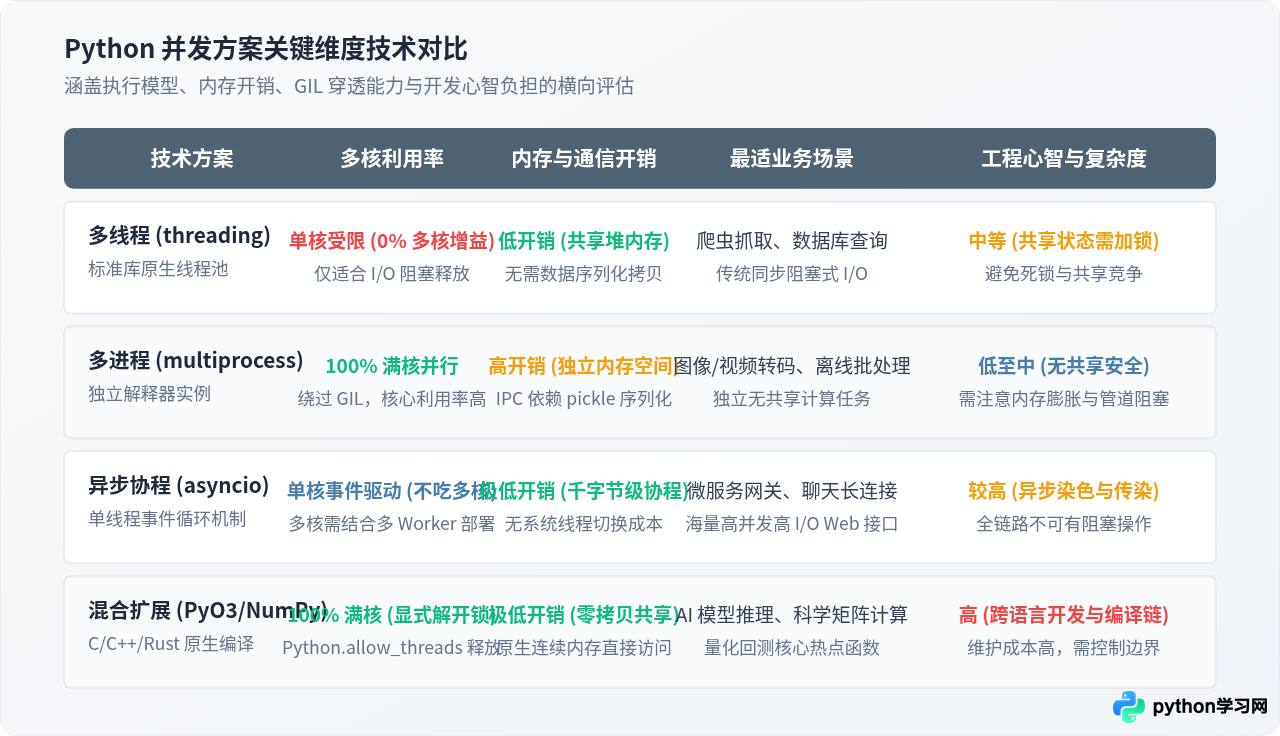
1. 多进程模型(Multiprocessing / Process Pools)
这是解决 Python 计算瓶颈最直接的标准库方案。每个 Python 进程都拥有自己独立的内存地址空间和独立的 CPython 解释器实例,因此每个进程都有独立的 GIL,互不干扰,能够直接利用操作系统的调度器均匀分配到多个物理核心。
- 适用场景:后台密集计算、离线批量数据清洗、机器学习特征工程。
- 工程注意事项:进程间传递数据必须经过
pickle序列化和反序列化,若跨进程传输超大体积对象,IPC 开销可能侵蚀并行带来的计算收益;可采用multiprocessing.shared_memory共享内存机制来化解数据搬运成本。
2. 异步协程模型(Asyncio / Event Loop)
在网络微服务和 API 网关领域,Python 3 引入的 asyncio 已经成为现代框架(如 FastAPI、aiohttp)的事实标准。异步编程在单个操作系统线程内通过非阻塞套接字和事件循环调度协程任务,彻底避免了操作系统线程上下文切换的沉重开销。
- 适用场景:高并发 Web API、长连接轮询推送、海量微服务聚合调用。
- 工程注意事项:必须恪守“全链路异步”原则,任何第三方阻塞库调用(例如传统同步数据库驱动或文件操作)都会阻塞整个事件循环,需用
loop.run_in_executor将其卸载到临时线程池中。
3. 底层混合语言扩展(NumPy / PyO3 / Cython)
Python 最强大的形态从来不是“纯 Python 独自跑天下”,而是作为顶层编排胶水。当计算核心被推导为底层 C、C++ 或 Rust 代码时,扩展模块内部可以显式解除 GIL,由 C/Rust 的原生线程管理机制去并发调度 CPU 资源。
例如,当你在 Python 中调用 numpy.dot() 矩阵乘法或 PyTorch 张量运算时,底层调用的是经过 SIMD 和多核 OpenMP 高度优化的 BLAS 库,此时 GIL 早已被完全释放,CPU 算力利用率可达 100%。近年来兴起的 PyO3 工具链更让工程师能够以现代 Rust 的内存安全特性编写 Python 原生模块,兼顾极速开发与极速执行。
4. 架构级无状态水平扩展与前沿无锁 Python
在云原生架构下,业界普遍采用“多进程 Pre-fork Worker + 容器水平伸缩”的部署范式。例如通过 gunicorn -w 8 -k uvicorn.workers.UvicornWorker 启动多进程监听同一端口,外层结合 Kubernetes Pod 横向扩容(HPA),在架构层面彻底把单进程的 GIL 影响降到了最低。
在语言自身演进方面,Python 3.13 已经合并了备受瞩目的 PEP 703(Making the Global Interpreter Lock Optional in CPython),提供了实验性的“自由线程(Free-threaded)”构建版本(--disable-gil),通过 Mimalloc 内存分配器和偏向引用计数(Biased Reference Counting)技术,正在稳步推进无 GIL 运行时的工业化成熟。
开发效率与运行性能的辩证权衡法则
软件工程是一门关于“取舍”的艺术。软件系统的总成本不仅由机器服务器费用构成,更由工程师的人力工时、需求交付周期以及后期故障维护成本决定。
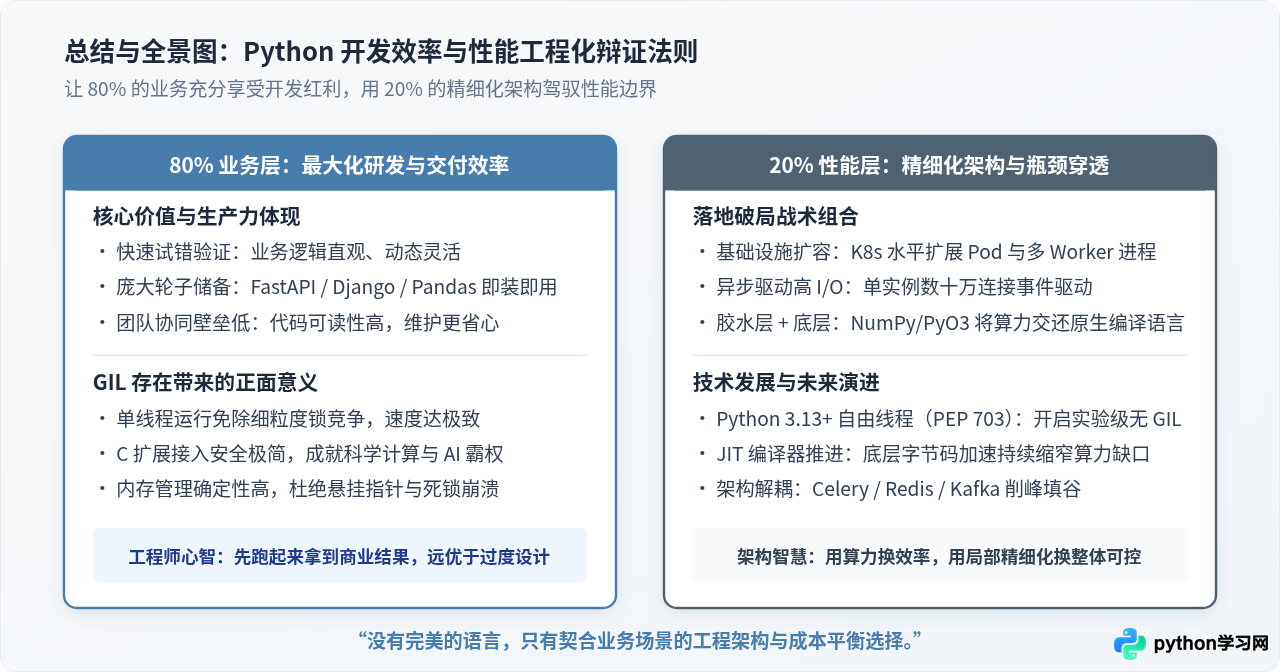
在真实商业项目中,经典的 80/20 原则 始终在起作用:一个复杂业务系统中,往往 80% 的模块属于业务流程串接、参数校验、状态流转和常规 I/O 查询,这些环节对 CPU 算力的要求极低,但对敏捷迭代和易读性要求极高;仅有不到 20% 的核心热点路径(如核心算法、加解密引擎、特征提取)真正成为 CPU 瓶颈。
面对性能挑战,理性的工程思维应遵循渐进式优化路径:
- 拒绝过早重构:不要在项目起步阶段就因为担忧 GIL 而放弃 Python 转投静态编译语言,导致研发周期翻倍。
- 依据指标定位瓶颈:通过专业的性能探针(如
py-spy或cProfile)捕获火焰图,用真实监控数据确认 CPU 是否成为核心短板。 - 分层治理:I/O 瓶颈用
asyncio升级,独立计算任务用ProcessPoolExecutor分发,高频热点函数抽离为 Rust/C 扩展,宏观流量用多 Worker 与容器集群平摊。
结语
Python 的 GIL 限制与开发效率从来不是非此即彼的对立关系。GIL 见证了 CPython 追求简单可靠的实用主义哲学,并在过去三十年中为生态繁荣提供了沃土;而现代软件架构中的多进程、异步化、底层语言互操作以及即将走向成熟的自由线程技术,则为性能敏感场景提供了丰富且有弹性的工程解题工具。掌握这层辩证关系,开发者才能在项目生命周期的不同阶段,做出成本最优、交付最快、性能稳健的技术选型决策。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









