

Python re.split用法:怎么同时按多个分隔符切割字符串
详细讲解在Python中使用re.split同时按多个分隔符切割字符串的实用方法,涵盖字符集方括号语法、多字符逻辑或、连续分隔符去重、捕获组与非捕获组的差异,以及空字符串与性能优化处理。
str.split() 只能传入一个固定的分隔符子串;若需同时按照逗号、分号、空格、竖线等多种字符甚至多字符单词对文本进行切分,标准库的 re.split() 是最直接高效的解决方案。只需在模式中通过正则字符集 [...] 或逻辑分支 | 组织多种分隔符,即可一次性完成复杂文本的拆分与数据提取。
为什么普通的 str.split 无法满足多分隔符需求?
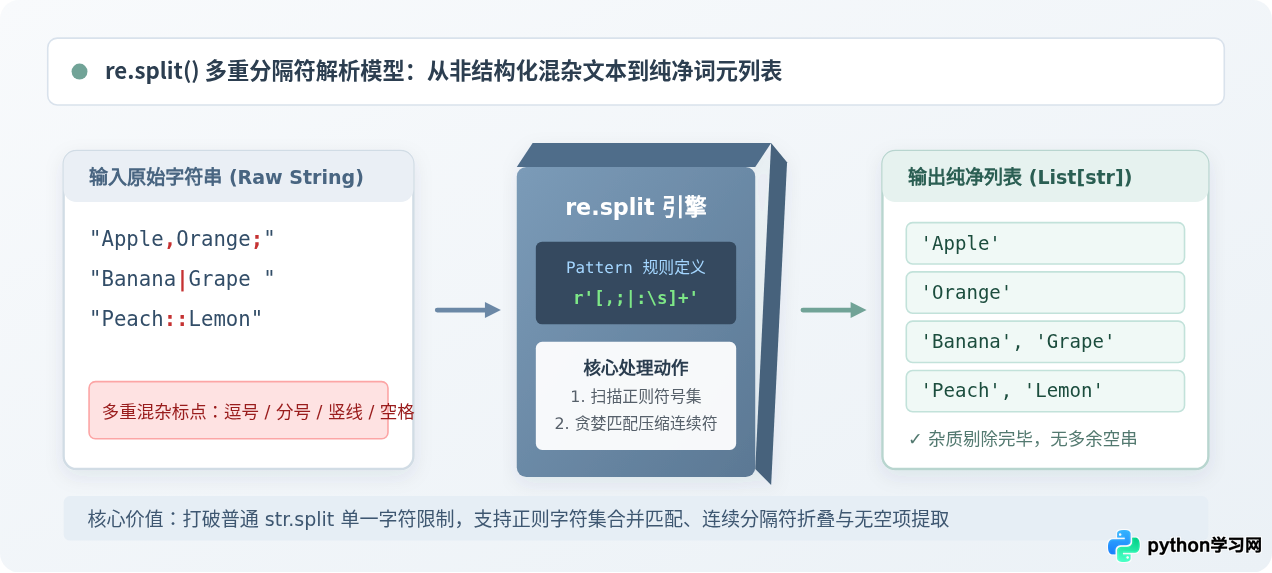
在日常数据清洗与文本处理过程中,原始文本的数据源格式往往不够规整。例如,一段用户输入的标签或日志中,可能同时混杂了中文逗号、英文逗号、分号、冒号以及数量不等的空格:
raw_text = "Python,Java;Go | Rust C++"
字符串自带的 str.split() 只能接收单个固定的子串作为分隔符。如果调用 raw_text.split(','),它只能切开英文逗号,分号和竖线依然会留在切分出的子串中;若通过多次调用 replace() 将所有符号强行替换为同一种符号再切分,代码不仅冗长低效,而且面对连续空格或未知数量的标点时容易产生大量残余的空字符串 ''。
因此,引入内置模块 re 的 re.split() 才是标准且优雅的处理途径。
基础用法:利用字符集 [...] 同时匹配多个单字符分隔符
当目标分隔符都是单字符(如标点符号、空格、换行符)时,最直接的方法是使用正则表达式的字符集语法——方括号 [...]。方括号内的任意单个字符都会被视作合法的分隔符。
1. 基本方括号语法
import re

text = "apple,banana;cherry orange|grape"

# 将逗号、分号、空格、竖线放入字符集
result = re.split(r'[,; |]', text)

print(result)
# 示例输出:
# ['apple', 'banana', 'cherry', 'orange', 'grape']
2. 添加量词 + 消除连续分隔符带来的空字符串
在真实文本中,分隔符往往会连续出现,例如逗号后面紧跟着一个空格 ", ",或者两个单词之间连续敲了多个空格。如果仅使用 r'[,; ]',每一个单独的分隔符都会触发一次切分,从而在两个相邻分隔符之间切出多余的空字符串:
text_with_spaces = "apple,  banana; ; cherry"

# 未加 + 号:连续符号之间产生空字符
wrong_result = re.split(r'[,; ]', text_with_spaces)
print(wrong_result)
# 示例输出: ['apple', '', ' ', 'banana', '', '', '', 'cherry']

# 正确做法:在字符集后添加量词 '+',表示一个或多个连续分隔符统一合并为单次切分
clean_result = re.split(r'[,;\s]+', text_with_spaces)
print(clean_result)
# 示例输出: ['apple', 'banana', 'cherry']
在上述规则中,\s 涵盖了普通空格、制表符 和换行符
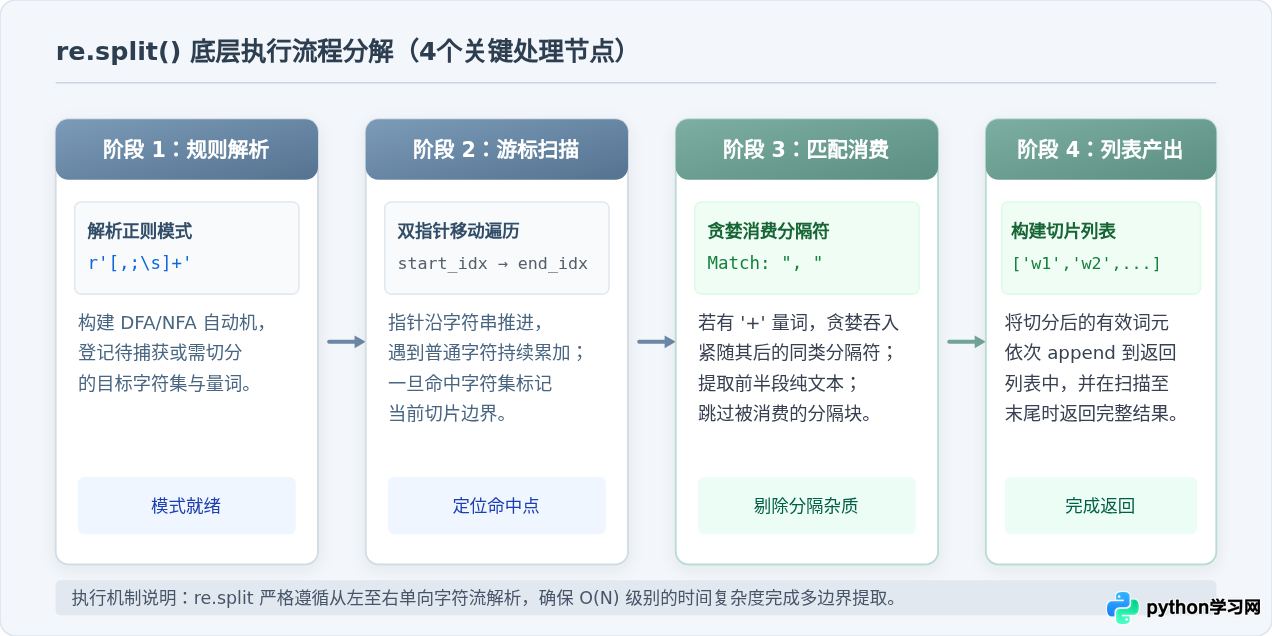
;末尾的 + 则实现了贪婪合并,把 ", " 和 "; ; " 当作一个整体分隔块消费掉,确保输出列表干净利落。
进阶场景:如何处理多字符或长度不等的分隔符?
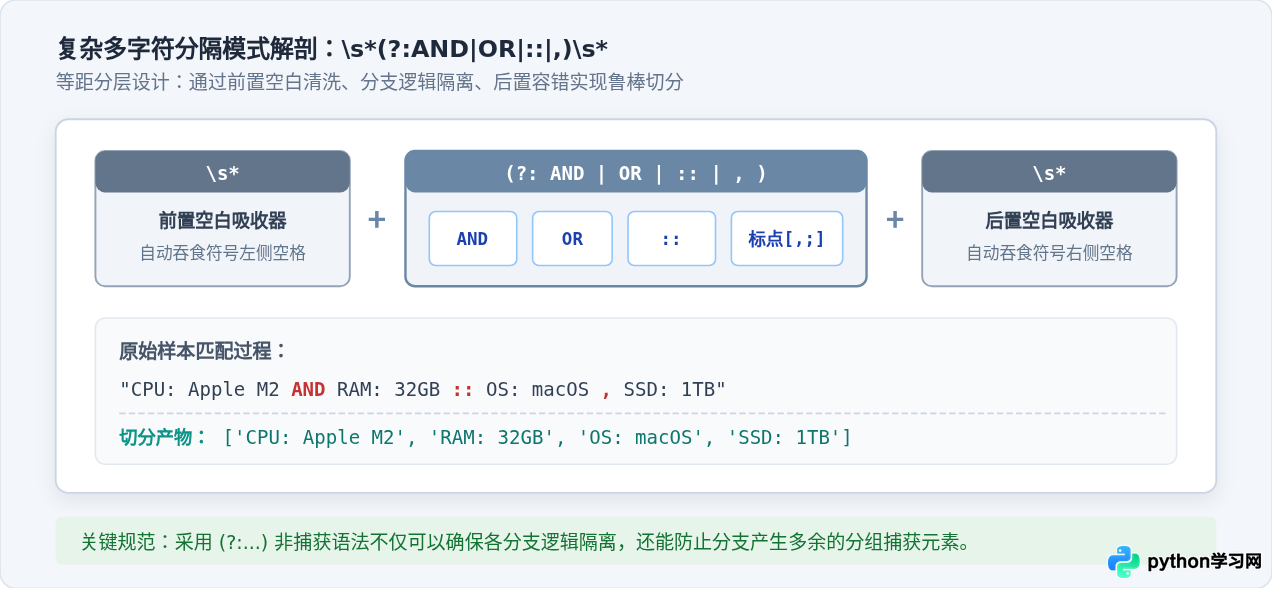
字符集 [...] 仅适用于单个字符。如果你的分隔符是多个字符组成的词或符号(例如 " AND "、" OR "、双冒号 "::",或是由多符号组成的自定义分界符),就必须使用管道符 | 构成逻辑或分支。
1. 逻辑或与非捕获组 (?:...) 的搭配使用
在正则表达式中,A|B|C 表示匹配 A、B 或 C 任一分支。为了让分支范围受控并不产生干扰,建议使用非捕获组 (?:...) 包裹候选分隔符。
import re

query_clause = "status = 1 AND age > 18 OR role = 'admin' -- custom_split: active"

# 分隔符包括:AND、OR、双中划线、逗号,且允许前后带有若干可选空格
pattern = r'\s*(?:AND|OR|--|,)\s*'

tokens = re.split(pattern, query_clause)
print(tokens)
# 示例输出:
# ["status = 1", "age > 18", "role = 'admin'", "custom_split: active"]__ 又有单下划线 _,或者既有 === 又有 =),在编写 | 时,必须把较长的模式写在前面,如 r'===|==' 或 r'__|_'。如果把短的写在前面,正则引擎匹配到短模式后就会立即切断,导致长符号被截半。
核心陷阱:捕获组与非捕获组对切割结果的决定性影响
许多初学者在使用 re.split() 时,经常会遇到一个奇怪的现象:原本应该被丢弃的分隔符,居然全都作为独立元素跑到了结果列表里!
产生这个现象的原因,在于正则表达式中普通圆括号 (...) 是捕获组。re.split() 在官方定义中有一条非常关键的特性:如果正则表达式中包含了捕获括号,那么所有匹配到的分隔符文本都会作为列表元素一同返回。
1. 捕获组与非捕获组行为对比代码
import re

text = "2026-11-01 12:30:45"

# 错误用法(如果不想保留分隔符):使用了普通圆括号 ([- :])
with_capture = re.split(r'([- :])', text)
print(with_capture)
# 示例输出(分隔符全都在列表中):
# ['2026', '-', '11', '-', '01', ' ', '12', ':', '30', ':', '45']

# 正确做法 A:直接使用方括号,不加外层小括号
no_parentheses = re.split(r'[- :]+', text)
print(no_parentheses)
# 示例输出: ['2026', '11', '01', '12', '30', '45']

# 正确做法 B:必须使用分组时,添加 '?:' 声明为非捕获组
non_capturing = re.split(r'(?:-| |\:)+', text)
print(non_capturing)
# 示例输出: ['2026', '11', '01', '12', '30', '45']
2. 什么时候应该故意保留分隔符?
虽然大部分清洗场景只需要内容而不要标点,但保留分隔符也有其特定价值。例如在编写简单的数学表达式分词器或文本还原标记时,操作符本身就是语法树的一部分:
expr = "100+25*3-8/2"

# 使用普通捕获括号保留加减乘除运算符
tokens = re.split(r'([\+\-\*/])', expr)
print(tokens)
# 示例输出: ['100', '+', '25', '*', '3', '-', '8', '/', '2']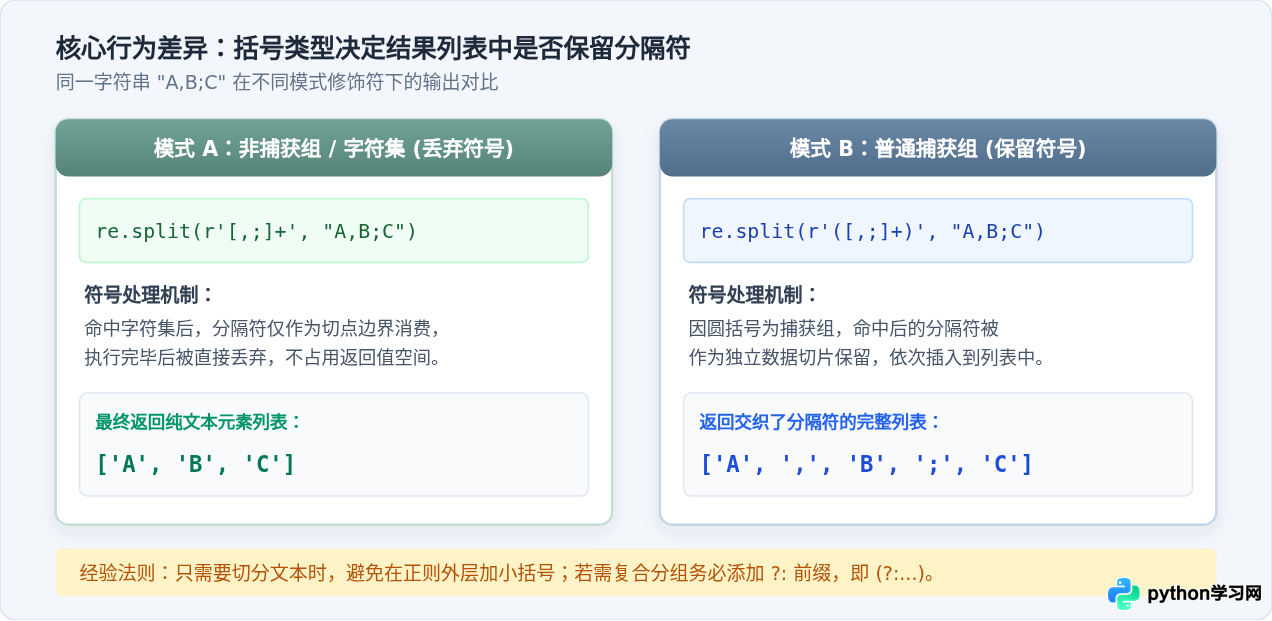
边界情况与实用技巧
1. 控制最大切割次数:maxsplit 参数
与 str.split() 类似,re.split() 也支持 maxsplit 参数。当文本非常长,而我们只需要切出前 N 个字段,剩余部分保持原样不动时(例如解析 HTTP 协议头或日志),可以指定该参数:
log_line = "2026-11-01 10:00:00 [INFO] System initialized successfully"

# 最多切分 3 次
parts = re.split(r'\s+', log_line, maxsplit=3)
print(parts)
# 示例输出:
# ['2026-11-01', '10:00:00', '[INFO]', 'System initialized successfully']
2. 首尾存在分隔符时产生的空字符串清洗
如果字符串的开头或结尾恰好也是分隔符,re.split() 会在首尾产生空字符串 ''。例如:
padded_text = ",apple,banana,cherry,"
result = re.split(r',+', padded_text)
print(result)
# 示例输出: ['', 'apple', 'banana', 'cherry', '']
解决该问题有两种常用策略:
- 切分前使用
strip()消除外围符号:re.split(r',+', padded_text.strip(',')) - 切分后通过列表推导式过滤:
[x for x in result if x]或list(filter(None, result))
3. 高频调用下的性能优化:re.compile
如果需要在循环体中对成千上万行字符串执行多分隔符切割,每次直接调用 re.split() 会反复进行模式的解析与缓存检索。建议预先调用 re.compile() 编译正则对象,复用切分逻辑:
# 预编译正则对象
splitter = re.compile(r'[,;|	]+')

data_list = ["a,b;c", "d|e	f", "g,h|i"]
parsed = [splitter.split(line) for line in data_list]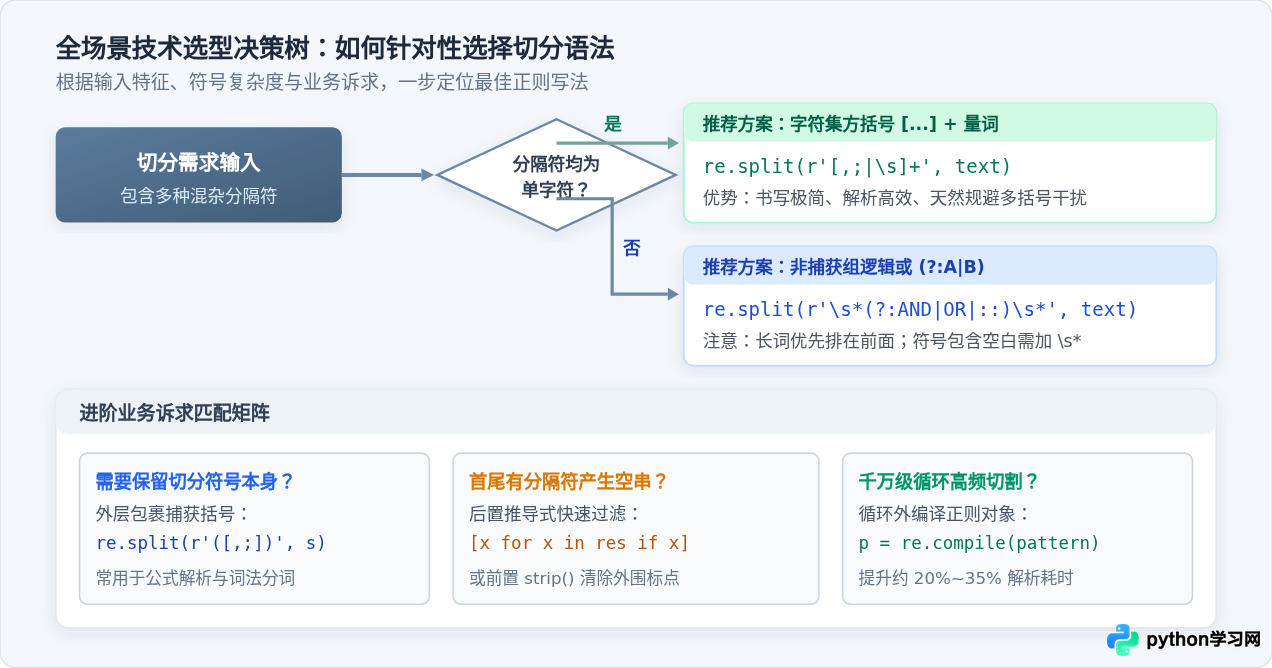
语法与常用模式速查表
为了方便在实际编码中快速查阅,下表汇总了最常见的切分场景及其推荐正则表达式写法:
| 目标切割场景 | 推荐正则表达式 | 说明与注意事项 |
|---|---|---|
| 中英文逗号与分号 | r'[,,;;]+' |
包含全角半角标点,末尾 + 消除连续空项 |
| 任意空白(空格/制表/换行)及标点 | r'[,;|\s]+' |
\s 可一次性覆盖多空格、 与
|
| 保留切分符自身 | r'([,;])' |
使用捕获组小括号,分隔符会作为独立列表项返回 |
| 多字符单词分隔符(如 AND / OR) | r'\s*(?:AND|OR)\s*' |
采用非捕获组 (?:...),前后加 \s* 吸收附带空格 |
| 特殊符号作为分隔符(如点号、竖线) | r'[\.\|\$]+' 或 r'\.\|\|' |
在正则元字符(如 . | *)前必须加反斜杠转义 |
| 仅切分前 N 次 | 设置参数 maxsplit=N |
剩余内容不切分,完整保存在列表最后一项中 |
总结与使用建议
在 Python 中处理多分隔符字符串时,不必再编写繁琐的链式 replace()。牢记以下三条核心法则:
- 优先使用字符集:单字符分隔符统一放到
r'[...]+'中,并在末尾加上+抑制多余空串; - 慎用外层圆括号:不需要保留分隔符时,千万不要随手在外面套
(),多条件分支务必写成(?:A|B); - 关注特殊字符与边界:若分隔符中包含正则保留符号(如点号
.、竖线|、星号*),记得添加反斜杠转义;若首尾可能带有符号,搭配strip()或列表过滤即可获得干净的最终数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









