

Python用pandas读取CSV文件并查看基本信息
详细讲解在Python中使用pandas库读取CSV文件并查看基本信息的操作步骤、核心参数解析、表结构探查方法与常见报错排查技巧。
pd.read_csv() 函数是读取CSV文件的行业标准工具;载入后通过 shape、head()、info() 和 describe() 等核心属性与方法,可以在数秒内快速掌握数据的行列规模、字段结构、缺失值分布及关键统计指标。本文将完整梳理从文件读取到多维度信息排查的具体操作步骤与注意事项。
一、基础准备与读取CSV文件
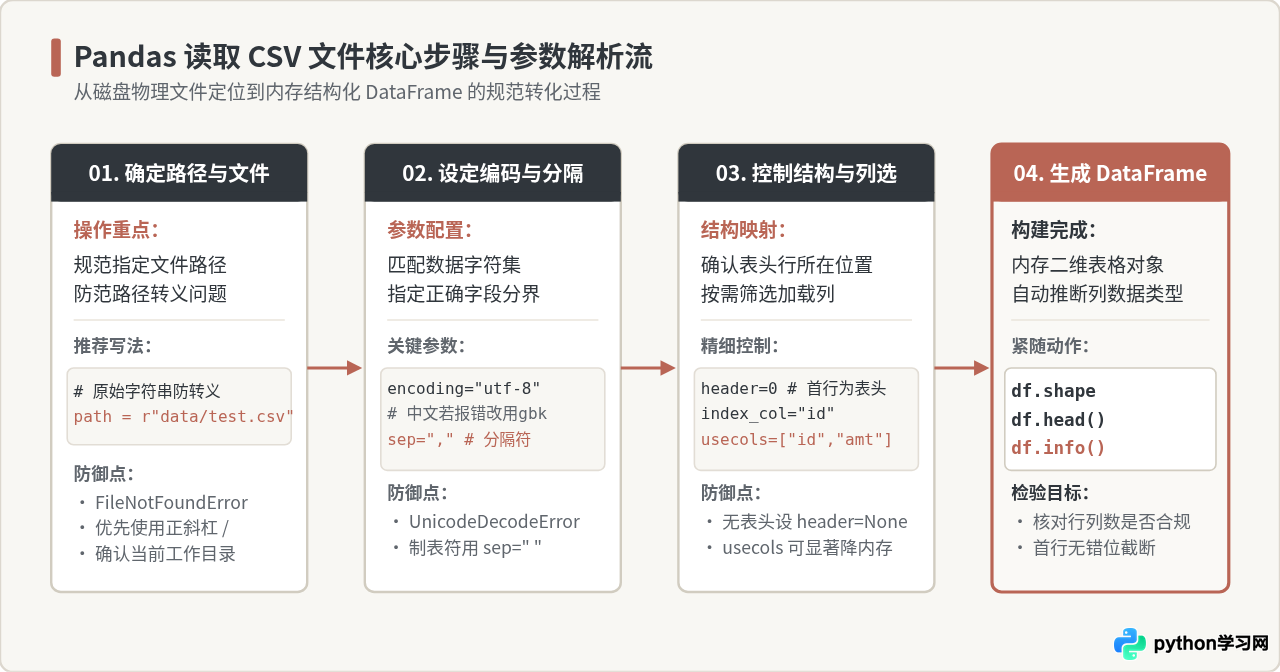
在开始操作前,请确保开发环境中已经安装了 pandas 库。若尚未安装,可以在终端或命令行工具中执行 pip install pandas 进行安装。在Python脚本或Jupyter Notebook中,惯例通过别名 pd 导入该模块:
import pandas as pd读取CSV文件的最简语法是调用 pd.read_csv() 并传入文件路径。为了避免跨操作系统(尤其是Windows系统)中反斜杠 \ 被识别为转义字符导致的文件找不到问题,推荐在路径前加上 r 标识为原始字符串,或统一使用正斜杠 /。
# 示例:通过相对路径读取当前工程目录下的数据文件
file_path = r"data/sales_records.csv"
df = pd.read_csv(file_path)
执行完成后,CSV文件中的文本内容已被解析并保存在内存变量 df 中,其类型为 pandas.core.frame.DataFrame(即二维表格数据对象)。
读取时的常用控制参数
实际业务中的CSV文件来源各异,往往存在非逗号分隔、特殊编码或无表头等情况。通过配置以下参数可以确保数据准确解析:
encoding:指定文件字符集。默认是"utf-8"。如果文件是在简体中文Windows环境下通过Excel导出的,常包含ANSI或GBK编码中文,应显式指定encoding="gbk"或encoding="utf-8-sig",避免触发编码报错。sep或delimiter:字段分隔符。默认为英文逗号,。若数据为Tab制表符分隔的TSV文件,需设定为sep=" "。header:表头行索引。默认为0(即将文件第1行作为列名)。如果CSV文件没有标题行、第一行直接是数据,必须设定header=None,否则首行数据会被误当做列名消耗掉。usecols:指定只加载特定的列。对于百兆以上的宽表文件,只读入需要的字段(例如usecols=["order_id", "amount", "order_date"])能显著减少内存开销并提升读取效率。index_col:指定某一列作为DataFrame的行索引(如index_col="order_id"),避免系统自动生成额外的默认整数索引。
二、查看数据集规模与局部样本
成功读取文件后,切勿直接对大型DataFrame执行 print(df),以免控制台被海量数据刷屏或发生卡顿。最先执行的两个轻量级操作是查看整体规模和抽样预览真实数据。
1. 获取行列规模:df.shape
df.shape 是DataFrame的一个核心属性(注意不是函数,末尾不带圆括号)。它返回一个元组 (行数, 列数),直接反映了数据集的规模边界:
# 查看数据集形状
print("数据规模 (行数, 列数):", df.shape)

# 获取具体行数与列数
n_rows, n_cols = df.shape
print(f"该文件包含 {n_rows} 条记录,共 {n_cols} 个字段。")通过校验 df.shape,可以立即验证文件行数是否与业务预估量级一致,若发现列数明显异常(例如只有1列),往往意味着 sep 分隔符设置错误,导致整行文本未被切分。
2. 查看字段名与行索引:df.columns 和 df.index
调用 df.columns 可以获取所有列名称组成的索引对象。常用于核对字段命名规范,排查列名中是否意外混入了前后空格或不可见字符:
# 查看所有列名列表
print("列名清单:", df.columns.tolist())3. 预览首尾样本:df.head() 与 df.tail()
head(n) 用于查看前 n 行,tail(n) 用于查看后 n 行。参数 n 缺省值均为 5。这一步的核心价值在于用肉眼印证字段名与具体数值是否严格对齐,并检查末尾是否存在非标准的汇总行或空行。
# 查看前 3 行数据
df.head(3)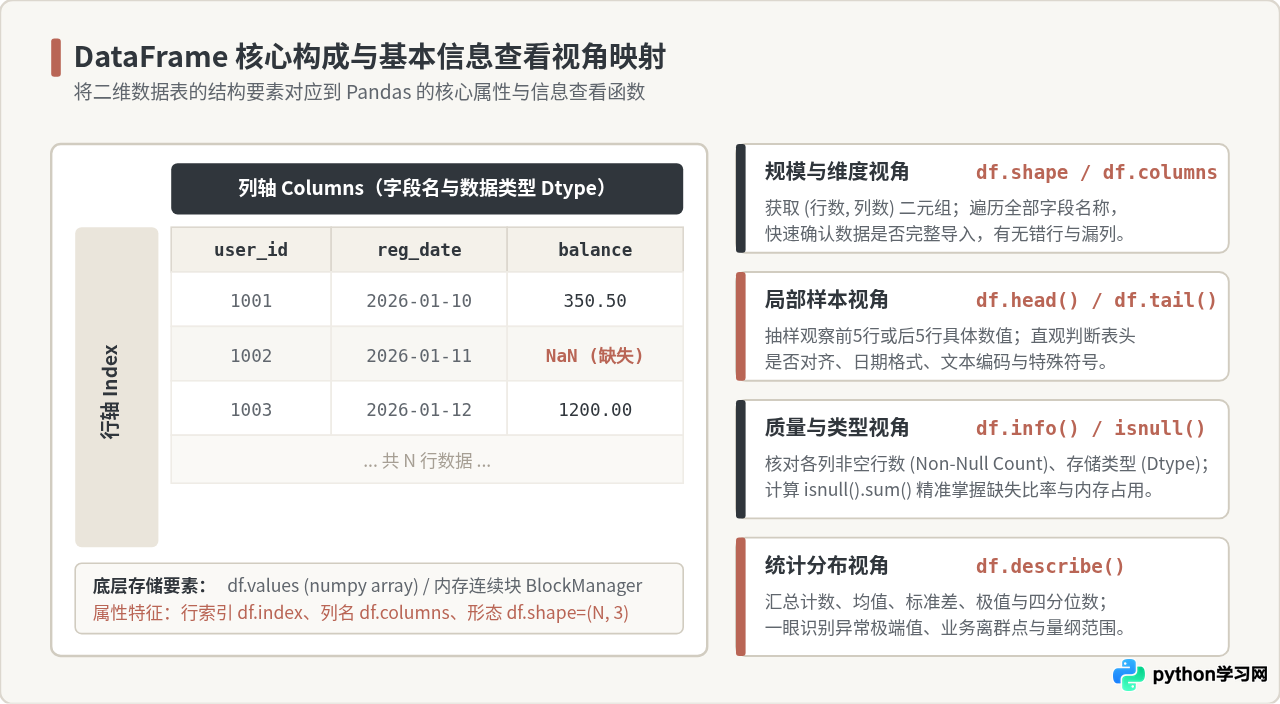
三、深入检查数据类型与缺失值概况
仅凭肉眼抽样无法发现隐藏在千行万列深处的类型不一致和缺失值。在pandas中,检查元数据最关键的入口是 df.info() 方法。
1. 综合诊断:df.info()
df.info() 会直接向控制台输出一份紧凑而全面的表格诊断摘要,涵盖以下核心指标:
- RangeIndex:行索引范围及总行数;
- Data columns:列总数;
- Column / Non-Null Count:每个字段对应的非空有效值数量;
- Dtype:每列被推断出的存储类型(如
int64、float64、object等); - memory usage:该DataFrame当前所消耗的内存空间。
# 查看结构与元数据信息
df.info()1.
discount 列仅有 4850 个非空值,说明存在 150 条记录缺失;
2.
notes 列仅有 1200 个非空值,缺失率高达 76%;
3.
order_date 此时为 object(即字符串类型),若后续需要按月度或周度聚合,应转换为标准时间类型 pd.to_datetime(df['order_date'])。
2. 精确统计缺失值:df.isnull().sum()
若需要定量提取各列的空值个数或百分比,可联合调用 isnull() 与统计函数:
# 统计每列缺失值的绝对数量
null_counts = df.isnull().sum()

# 计算每列缺失率 (%)
null_ratios = (df.isnull().sum() / len(df)) * 100

# 拼接为便于排查的对照表
missing_summary = pd.DataFrame({'缺失数': null_counts, '缺失率(%)': null_ratios.round(2)})
print(missing_summary[missing_summary['缺失数'] > 0])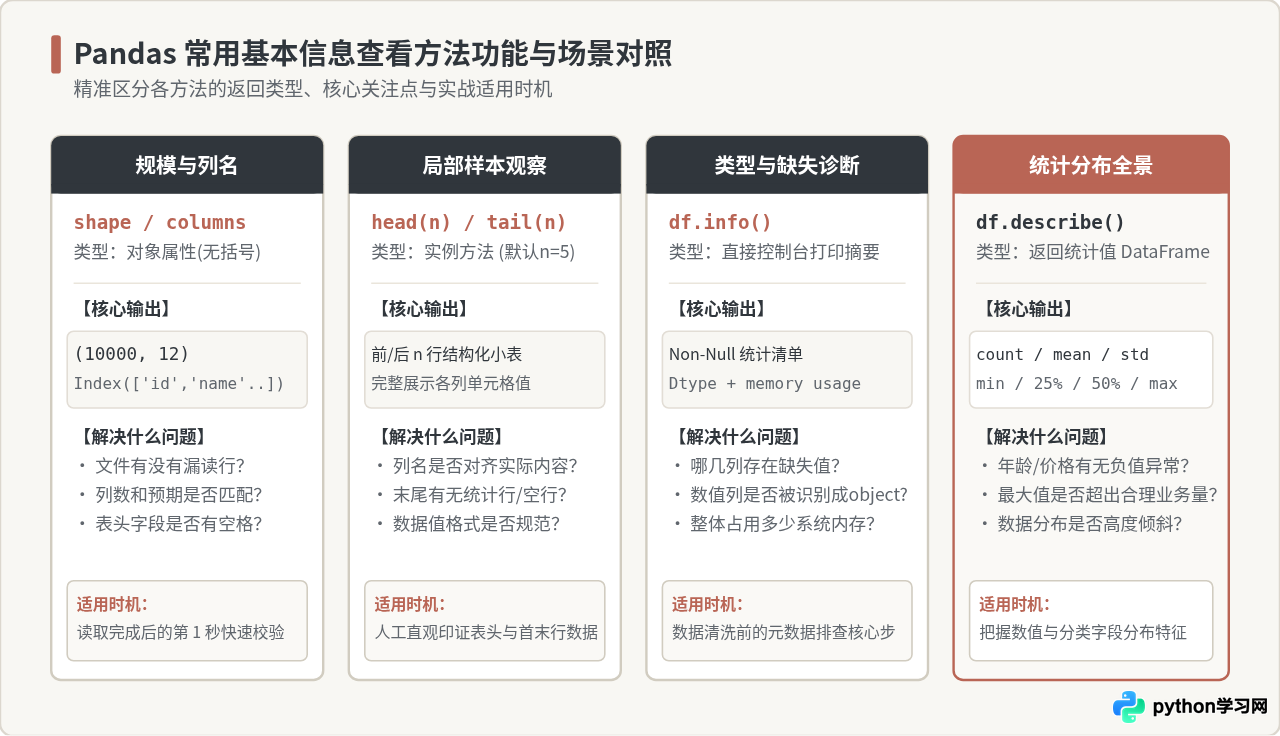
四、数值分布与描述性统计:df.describe()
在确认了数据结构与缺失概况后,接下来需要探查字段数值的合理性。df.describe() 用于生成描述性统计指标,能快速暴露出数据录入错误或极端异常值。
1. 默认数值列统计
默认情况下,df.describe() 会自动过滤出所有数值型字段(int、float),并计算 8 项基础统计指标:
# 快速查看数值列统计分布
df.describe()通过检查这组统计量,读者可以迅速提炼出重要的业务逻辑线索:
- 校验极小值(min):
unit_price的最小值为0.00,需要与业务确认是否存在免费赠品或脏数据录入错误; - 校验极大值(max):
unit_price最大值为9999.00,与75%分位数(150.00)差距悬殊,需警惕是否存在极大异常离群点; - 分位数分布(25%, 50%, 75%):观察中位数(50%)与均值(mean)的偏离程度,若均值明显高于中位数,说明数据呈现右偏长尾分布。
2. 包含非数值分类字段:include='all'
对于字符串、类别型(object / category)字段,可传入 include='all' 参数,pandas会补充输出唯一样本数(unique)、出现频次最高的元素(top)及最高频次(freq):
# 统计所有字段(包含文本分类列)
df.describe(include='all')
这能帮助排查分类标签是否有同义词拼写不统一(例如同时存在 "Office" 和 "office ")的情况。
五、常见问题排查与注意事项
| 常见报错 / 现象 | 可能原因 | 针对性解决办法 |
|---|---|---|
| UnicodeDecodeError | CSV包含GBK/ANSI等中文字符,默认utf-8解码失败 | 显式传入参数 pd.read_csv('test.csv', encoding='gbk') 或 'utf-8-sig' |
| FileNotFoundError | 相对路径基准与当前工作目录不一致,或反斜杠转义 | 检查 os.getcwd();使用原始字符串 r"..." 或正斜杠 / 规避转义 |
| ParserError: Error tokenizing | 某行包含多余的分隔符或双引号未闭合 | 指定 on_bad_lines='skip' 跳过异常行,或检查数据源引号格式 |
| DtypeWarning | 同一列混合存在多种类型,pandas推断产生歧义 | 显式设置 dtype={'phone': str} 或传入 low_memory=False |
| 大文件内存耗尽 (OOM) | CSV体积超出物理内存 | 使用 nrows=1000 快速探查,或使用 chunksize=10000 迭代分块读取 |
六、总结
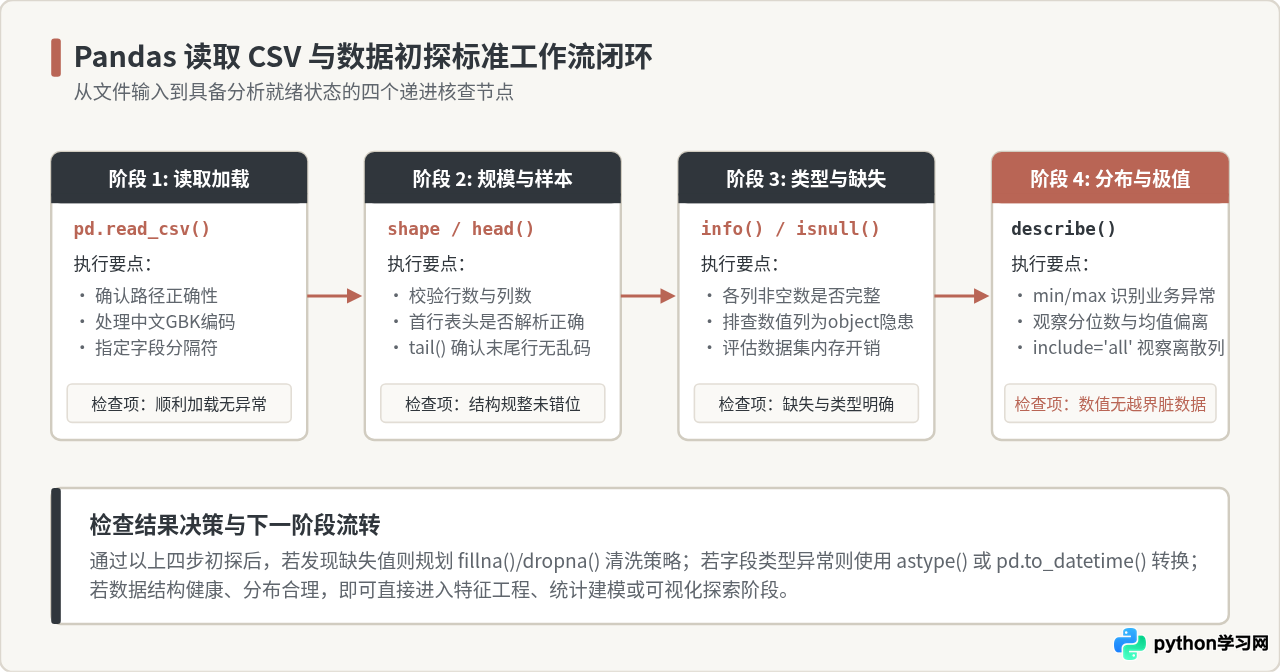
在Python数据处理工作中,“读取文件并查看基本信息”并非一次性的机械动作,而是贯穿数据理解的标准闭环:
- 使用
pd.read_csv()保证文件被正确解码与分割载入; - 借助
df.shape与df.columns确认数据骨架与字段边界; - 通过
df.head()/df.tail()获取直观具体的样本感知; - 利用
df.info()与df.isnull().sum()诊断数据类型是否匹配、量化缺失风险; - 运用
df.describe()洞察数值分布特征与极端异常值。
完成这五步检查后,读者便能精准判断手头数据的质量状态,从而有针对性地开展下一步的数据清洗、类型转换与统计建模工作。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









