

Python GIL是什么:全局解释器锁通俗原理解析

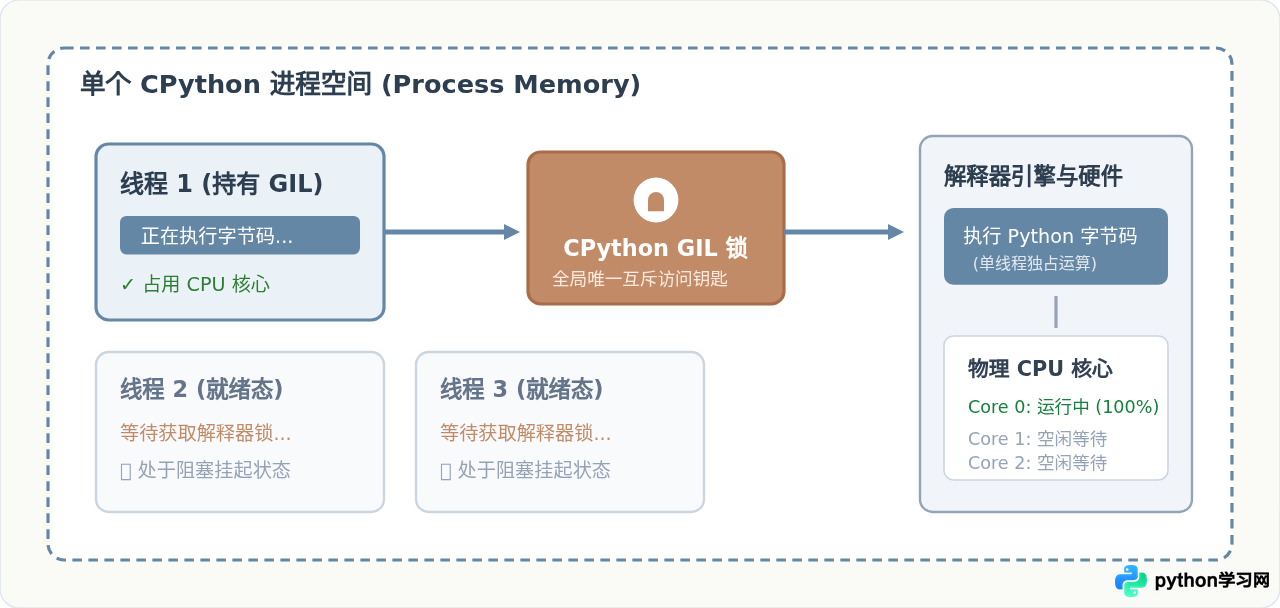
简单来说,GIL(Global Interpreter Lock,全局解释器锁)是 Python 官方标准解释器(CPython)内部的一道互斥排他锁。它规定:在任意给定的时刻,同一个 Python 进程中只允许一个线程执行 Python 字节码。这意味着,即便你的电脑拥有 8 核甚至 16 核 CPU,CPython 内部的多线程程序也无法在多个 CPU 核心上同时并行运行 Python 计算逻辑,而只能交替串行执行。
一、GIL 的核心定义与基本直观认知
很多初学者在编写多线程程序时,会自然地假设“开 4 个线程就能让 4 核 CPU 同时全速运转”。然而在 Python 官方默认的 CPython 实现中,这一直觉并不成立。
Python 的线程在操作系统底层是货真价实的原生操作系统线程(POSIX Threads 或 Windows 线程),操作系统会把它们当成独立的并发单位进行排队与调度。但问题出在解释器内部:CPython 在执行任何 Python 代码前,线程必须先抢到 GIL 这把“通行钥匙”。没有拿到钥匙的线程,哪怕已经被操作系统分配给了空闲的 CPU 核心,也只能处于挂起等待状态,无法执行 Python 代码。
二、为什么 CPython 要设计 GIL?
既然现代处理器早已普及多核心,为什么 Python 官方解释器会保留这样一个“限制性能”的设计?这并不是设计失误,而是当年权衡内存安全与单线程运行效率的历史必然。
1. 内存管理与引用计数机制(Reference Counting)
CPython 的内存回收主要依靠引用计数。Python 内存中的每一个对象(无论是数字、字符串、列表还是字典)都包含一个名为 ob_refcnt 的计数器。
- 当有新变量指向该对象时,计数器加 1;
- 当变量被销毁或离开作用域时,计数器减 1;
- 一旦计数器降为 0,这块内存就会被立即释放回收。
如果在没有锁保护的多线程环境下,多个线程同时对同一个对象进行读写或修改计数器,就会发生竞态条件(Race Condition)。一旦两个线程同时减计数,可能导致计数提早归零,将仍在使用的对象内存释放掉,引发悬垂指针和内存崩溃;反之,若丢失了减计数操作,内存将永远无法释放,造成内存泄漏。
2. 细粒度锁的代价 vs 粗粒度大锁(GIL)
要解决多线程操作引用计数的数据安全,理论上有两种思路:
- 细粒度锁(Fine-grained locking):为每个对象或每个数据结构都单独设置一把锁。每次访问或修改任何变量时加锁、解锁。
- 粗粒度锁(GIL):用一把覆盖整个解释器的全局大锁,同一时间只允许一个线程运行。
在 Python 发展早期,核心团队曾经做过移除 GIL 并引入细粒度锁的实验。实验结果表明:由于普通程序中充斥着成千上万次的对象读写,每次细粒度锁的申请与释放带来了极大的开销,导致单线程执行速度下降了 30% 到 50%,并且多锁环境下极易引发死锁风险。相比之下,采用一把全局大锁,在单线程环境下开销微乎其微,保证了极高的执行效率。
3. 简化 C 扩展模块的集成
Python 能够迅速风靡科学计算与数据分析领域,离不开其与 C/C++ 生态无缝集成的能力。许多 C 库最初都不是线程安全的,而有了 GIL 的存在,C 扩展编写者无需为复杂的线程同步耗费精力,极大地降低了编写高性能 Python 扩展模块的门槛。
三、GIL 的运作机制:线程是如何切换的?
既然只有一个线程能拿到锁,那其他线程岂不是会被“饿死”?并不会。CPython 内部有一套明确的锁释放与调度规则。
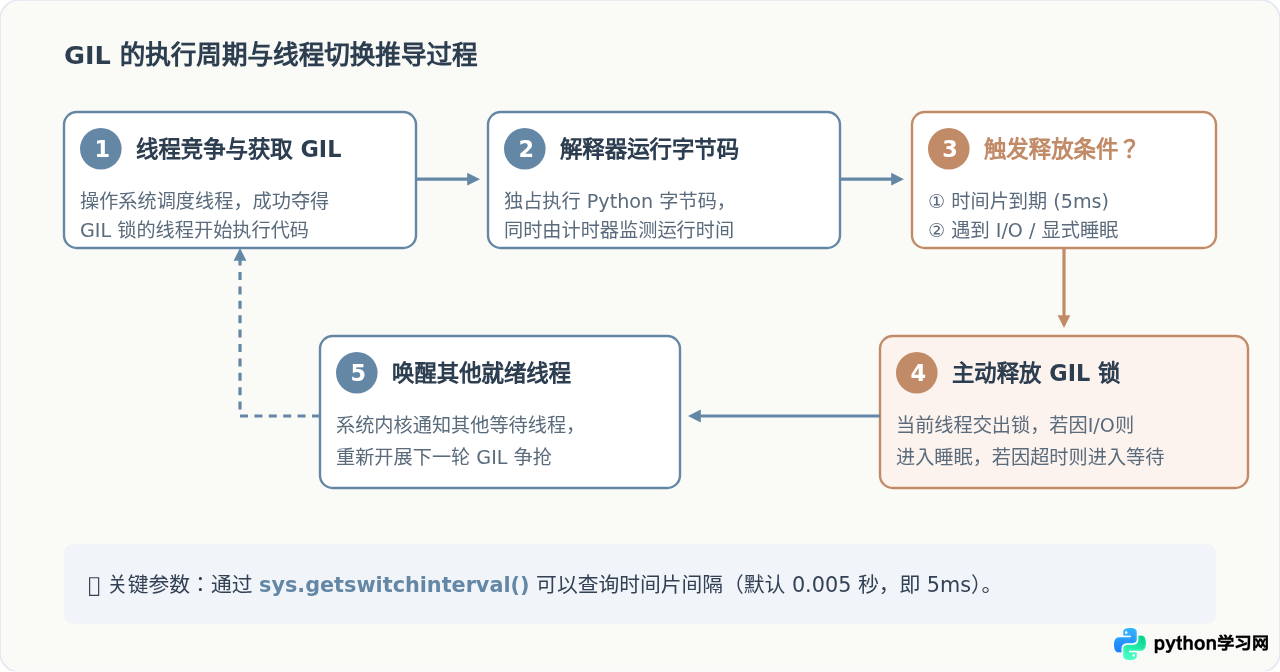
释放 GIL 的主要时机包括两类:
-
时钟中断(时间片到期):在 Python 3 中,解释器默认每隔 5 毫秒(可以通过
sys.getswitchinterval()查询)就会检查是否有其他线程在等待。若有等待线程,当前线程就会主动释放 GIL,并等待系统下一次调度。这避免了某一个耗时线程独占解释器。 -
I/O 操作与系统阻塞:当线程进行磁盘读写(
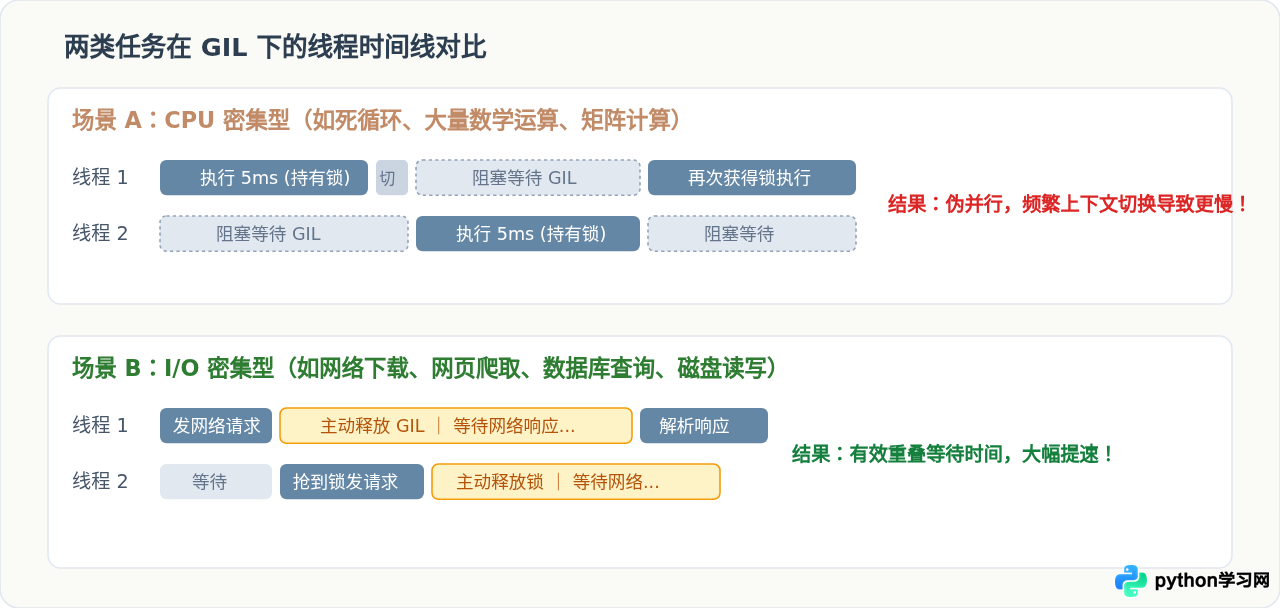
file.read())、网络收发(socket.recv())、调用time.sleep(),或调用底层原生计算 C 扩展时,CPython 会在发起系统调用前主动交出 GIL。在等待网络或磁盘返回的过程中,其他线程可以顺畅取得 GIL 继续工作。
四、核心对比:CPU 密集型 vs I/O 密集型
了解了上述机制后,我们就能清晰解释 Python 多线程在面对两类不同任务时的两极分化表现。
代码实测:感受 CPU 密集型任务下的负优化
下面是一个典型的纯计算任务测试。分别使用“单线程顺序执行两次”与“开启两个多线程同时计算”进行耗时对比:
import time
import threading

def cpu_bound_task(count):
    while count > 0:
        count -= 1

total_iterations = 50_000_000

# 1. 单线程顺序执行
start = time.perf_counter()
cpu_bound_task(total_iterations)
cpu_bound_task(total_iterations)
single_thread_time = time.perf_counter() - start
print(f"单线程串行执行耗时: {single_thread_time:.2f} 秒")

# 2. 多线程并行执行
t1 = threading.Thread(target=cpu_bound_task, args=(total_iterations,))
t2 = threading.Thread(target=cpu_bound_task, args=(total_iterations,))

start = time.perf_counter()
t1.start()
t2.start()
t1.join()
t2.join()
multi_thread_time = time.perf_counter() - start
print(f"多线程并行执行耗时: {multi_thread_time:.2f} 秒")
实测典型结果参考:
单线程串行执行耗时: 3.12 秒
多线程并行执行耗时: 3.38 秒
在多核 CPU 机器上运行上面的程序,多线程不仅没有缩短一半时间,反而比单线程慢了约 8%~15%!
这是因为两个线程都在疯狂进行计算,谁也不愿主动释放锁。每隔 5ms,系统强制进行线程切换,线程 1 和线程 2 频繁争抢 GIL,导致了大量的 CPU 缓存失效与线程上下文切换损耗,整体效率反而下降。
五、如何突破或规避 GIL 的限制?
在实际生产中,为了真正榨干现代服务器的多核算力,业界已经沉淀出几套非常成熟的解决路径。
1. 使用 multiprocessing 多进程模块
这是纯 Python 项目处理 CPU 密集型任务最直接、推荐的方案。每个 Python 进程都启动一个独立的 CPython 解释器,拥有独立的内存空间和各自的 GIL,互不影响。这样能够轻松将任务分配到所有 CPU 核心上。
from concurrent.futures import ProcessPoolExecutor

def compute_chunk(data):
    # 执行纯算力计算
    return sum(x * x for x in data)

if __name__ == '__main__':
    data_list = [range(1000000), range(1000000, 2000000)]
    # 利用系统核心数创建进程池
    with ProcessPoolExecutor() as executor:
        results = list(executor.map(compute_chunk, data_list))
    print("计算完成:", len(results))
2. 使用能在底层释放 GIL 的科学计算库
像 NumPy、SciPy、PyTorch 等底层用 C、C++ 或 Fortran 实现的库,在执行密集数组运算或矩阵相乘时,会在 C 代码内部显式调用宏 Py_BEGIN_ALLOW_THREADS 释放 GIL。
此时,底层代码会使用 OpenMP 或原生 C 线程池在多个 CPU 核心上并行运算,运算结束后再通过 Py_END_ALLOW_THREADS 重新获取 GIL。这种方式既保留了 Python 调用的简洁,又享受了多核底层的极致性能。
3. 选用其他没有 GIL 的 Python 解释器
GIL 只是 CPython 这一种特定解释器实现的产物,而不是 Python 语言规范本身的要求。如果你所依赖的库兼容其他实现,可以考虑:
- Jython:运行在 Java 虚拟机(JVM)上的 Python,利用 Java 的线程机制,没有 GIL。
- IronPython:运行在 .NET 平台上的实现,同样没有 GIL。
4. Python 3.13 与自由线程(Free-threaded / No-GIL)的最新进展
Python 社区从未停止移除 GIL 的努力。PEP 703 提案正式被指导委员会接受,并在 Python 3.13 中引入了实验性的自由线程构建模式(通过安装特定版本或编译选项 --disable-gil 开启)。
在自由线程模式下,CPython 解释器移除了全局解释器锁,改为采用偏向引用计数(Mimalloc 结合无锁设计)等新技术来保障内存安全。随着三方扩展库(如 NumPy 等)逐步完成适配,未来 Python 程序员将能够原生享受零阻碍的多核多线程红利。
六、关于 GIL 的常见误区与总结
| 常见观点 | 真实情况 | 编程建议 |
|---|---|---|
| “Python 没有真正的多线程” | 错误。Python 的线程是真实的原生操作系统线程,受内核统一调度。 | I/O 密集型场景(爬虫、网络请求)请放心使用多线程,能显著减少等待时间。 |
| “有了 GIL,写多线程就不需要自己加锁了” | 极其危险的误区!GIL 只保护解释器内部安全(如引用计数),不能保证用户代码的业务原子性。 | 即使有 GIL,例如 count += 1 这类包含“读取-增加-赋值”多个字节码的操作仍然会产生竞态条件,必须手动使用 threading.Lock。 |
| “所有 Python 任务多线程都没用” | 错误。只有 CPU 密集型任务受制于 GIL,I/O 密集型任务下多线程极其有效。 | 根据任务属性选择:计算密集用多进程(multiprocessing),I/O密集用多线程(threading)或异步(asyncio)。 |
七、核心总结
掌握 Python GIL 可以用三句话概括:
- 是什么:GIL 是 CPython 为了保护引用计数和内存安全而设计的全局互斥锁,保证任意时刻只有一个线程在运行 Python 字节码。
- 为什么有:历史原因所致。它以最简单的方式消除了内存竞争,让单线程性能保持高效,并极大地促进了 C 扩展模块的繁荣。
- 怎么用:面对 I/O 密集型任务(网络通信、文件读写),毫不犹豫使用多线程或异步编程;面对 CPU 密集型任务(大规模计算、图像处理),果断选用多进程、底层释放 GIL 的 C 库(如 NumPy),或关注 Python 3.13+ 的 Free-threaded 最新版本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









